06 Expériences
Votre dataset est chargé dans Langfuse. scripts/run-dataset.ts se trouve déjà dans le dépôt.
Le contenu du workshop est maintenu dans le dépôt public langfuse/langfuse-workshop. Utilisez ce dépôt pour exécuter l’application, accéder aux branches de checkpoint et effectuer la configuration locale.
Point de départ
git checkout checkpoint/06-experimentsVotre dataset est chargé dans Langfuse. scripts/run-dataset.ts se trouve déjà dans le dépôt.
Pourquoi utiliser des expériences
Un trace décrit un tour. Une expérience décrit le comportement sur tout le dataset. Chaque exécution effectue les trois mêmes opérations :
- Récupérer chaque élément du dataset.
- Faire passer son entrée dans l’agent — le même
runSupportConversation(...)que l’application web, donc avec la même structure de trace qu’en production. - Noter la sortie réelle par rapport à la sortie attendue avec un ou plusieurs évaluateurs.
Les évaluateurs répondent à des questions différentes. Pour découvrir les types et savoir quand les utiliser, consultez la leçon Langfuse Academy sur l’évaluation. Nous en utilisons deux pour une première lecture rapide :
keyword_overlap(déterministe) — la réponse couvre-t-elle les étapes attendues ? Rapide, peu coûteux et calculé directement dans le script.correctness(LLM-as-a-judge) — la réponse est-elle réellement correcte ? Plus expressif lorsque la formulation varie mais que le sens doit correspondre à la référence.
Le chapitre utilise volontairement une configuration mixte : le contrôle déterministe reste dans le code près du runner, tandis que le juge sémantique réside dans Langfuse.
Objectif
À la fin :
- Vous pouvez exécuter tout le dataset sur l’agent à la demande.
- Chaque élément reçoit un score
keyword_overlapet un scorecorrectness. - Les deux scores et les traces par élément sont visibles dans Langfuse, prêts à être comparés aux futures exécutions.
Étape 1 — Comprendre le script d’exécution
Ouvrez scripts/run-dataset.ts. Le fichier comporte des commentaires numérotés (// --- 1. Boot the OpenTelemetry SDK ..., // --- 3. The deterministic evaluator ..., etc.) pour le lire section par section. Globalement, il :
- charge depuis Langfuse le dataset hébergé identifié par
DATASET_NAME; - appelle pour chaque élément le même
runSupportConversation(...)que l’application web ; - utilise
dataset.runExperiment(...)pour regrouper tous les traces dans une ligne d’exécution ; - attache un score
keyword_overlappar élément en comparantexpectedKeywordsà la réponse.
Les traces ont la même structure qu’en production : racine dad-it-support-chat-turn, generation OpenAI et spans d’outils. Le score déterministe ne nécessite aucune configuration d’interface puisqu’il réside déjà dans le script.
dataset.runExperiment(...) — les éléments
Toute l’exécution tient dans un appel à runExperiment de cette forme :
await dataset.runExperiment({
  name: "Dad IT Support Agent experiment",
  runName,           // unique label for this run; shows up in the Runs tab
  description: "...",
  metadata: { model: env.openaiModel },
  maxConcurrency: 1, // run items one at a time

  task: async (item) => {
    const response = await runSupportConversation({ /* item.input */ });
    return response.answer;
  },

  evaluators: [
    async ({ output, expectedOutput }) => ({
      name: "keyword_overlap",
      value: keywordOverlap(output as string, (expectedOutput as any).expectedKeywords),
      comment: "..."
    })
  ]
});
Trois points à comprendre :
taskest la logique de votre application. Nous appelons directementrunSupportConversation(...), donc chaque trace est identique à un trace de production.evaluatorsest une liste. Chaque évaluateur s’exécute aprèstasket attache un score à l’élément. Nous en utilisons un déterministe, mais vous pourrez en ajouter.runNameregroupe les traces dans une ligne de la vue Runs. Choisissez un nom différent par exécution — nous incluons l’horodatage — pour éviter les collisions.
Étape 2 — Examiner l’évaluateur déterministe keyword_overlap
Dans scripts/run-dataset.ts, la fonction auxiliaire recherche les expectedKeywords de l’élément dans la réponse et renvoie la proportion trouvée.
Pourquoi la conserver dans le script ?
- Elle se lit facilement avec le reste du code de l’expérience.
- Elle suit le même processus de versionnement et de révision que l’application.
- Elle est déterministe ; inutile de dépenser un appel LLM.
C’est un bon modèle pour les équipes qui souhaitent conserver la logique d’expérience dans le dépôt.
Alternative : ce même contrôle pourrait devenir un code evaluator Langfuse si vous préférez le gérer dans la plateforme. Consultez la documentation des code evaluators et la documentation des expériences via le SDK.
Étape 3 — Configurer l’évaluateur correctness dans Langfuse
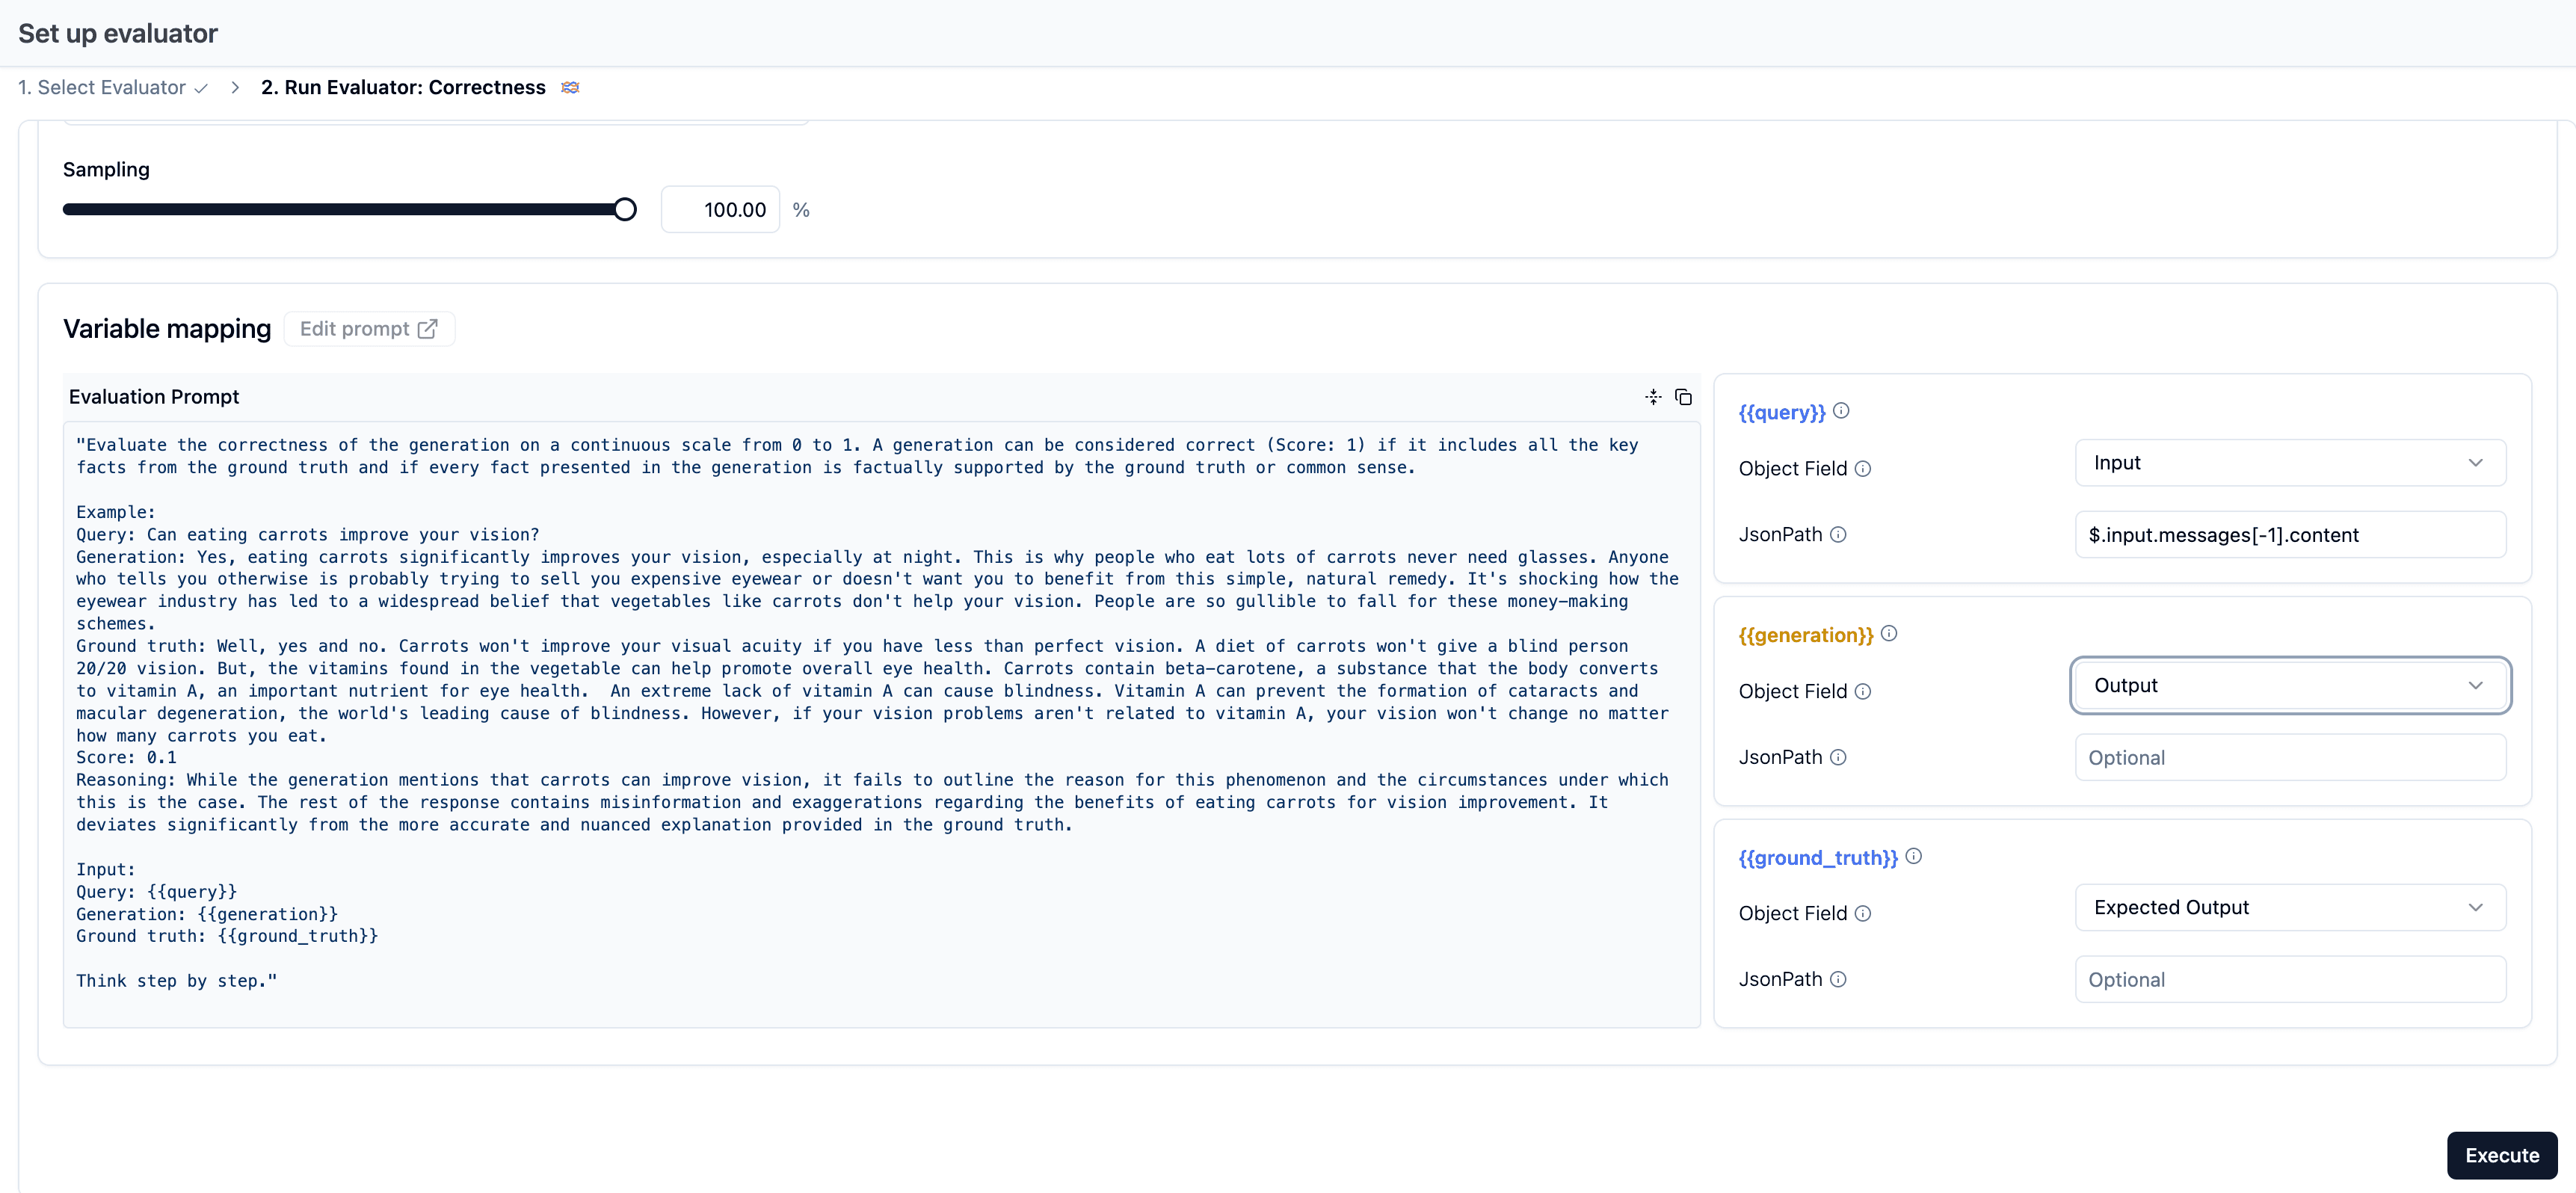
Langfuse fournit un modèle Correctness LLM-as-a-judge qui compare une réponse réelle à une réponse idéale et renvoie un score. Nous le relions aux exécutions afin que chaque élément reçoive à la fois le score déterministe local et le score de correction attribué par le modèle dans la vue de comparaison.
Projet neuf : Correctness est un évaluateur LLM-as-a-judge. Si vous n’avez pas configuré le modèle par défaut à la session 4, ouvrez Project Settings → LLM Connections et ajoutez votre clé OpenAI. Pendant la création, l’assistant Set up evaluator demande un modèle à l’étape Set up LLM connection ; choisissez-en un compatible avec les sorties structurées, comme
openai / gpt-4.1. Il apparaît ensuite comme Default model dans Evaluators. Conservez la clé uniquement dans le champ secret Langfuse.
-
Ouvrez Evaluators → Set up evaluator et choisissez Correctness dans Use existing (Langfuse managed evaluators).
-
Ciblez les exécutions de ce dataset :
- Run on: Experiments (l’interface s’ouvre souvent sur observations ; changez cela d’abord)
- Filter where: Dataset is 'dad-it-support-workshop'
-
Mappez les variables. Choisissez d’abord Source, puis ajoutez un JsonPath uniquement si nécessaire :
Variable Champ de l’objet JsonPath queryInput $.messages[-1].contentgenerationOutput Laisser vide ground_truthExpected Output $.idealAnswerUne erreur courante consiste à laisser les trois variables sur Input, car ce menu apparaît en premier. Si
generationouground_truthpointent vers Input, l’évaluateur lit des données incorrectes pour chaque exécution. -
Utilisez le modèle par défaut de la session 4 ou configuré ci-dessus, ou un autre modèle compatible, puis enregistrez.
-
Activez l’évaluateur.
S’il s’agit de votre première expérience, la table ou l’aperçu peut afficher No results ou No trace data found. C’est normal : aucune exécution n’existe à prévisualiser. Enregistrez ; après la création de la première exécution à l’Étape 4, l’évaluateur notera les éléments de façon asynchrone.
Pourquoi Experiments ? Nous voulons afficher correctness dans les lignes et la comparaison des exécutions.
Étape 4 — Exécuter le dataset
npm run dataset:runLe script termine en affichant un résumé formaté dans la console. Les traces et scores apparaissent dans Langfuse pendant l’exécution, et Correctness peut continuer à compléter les scores un peu plus tard puisqu’il est asynchrone.
Le script attache lui-même keyword_overlap. L’évaluateur Correctness de l’Étape 3 s’exécute peu après dans Langfuse sur les nouvelles lignes.
Ce qu’il faut examiner dans Langfuse
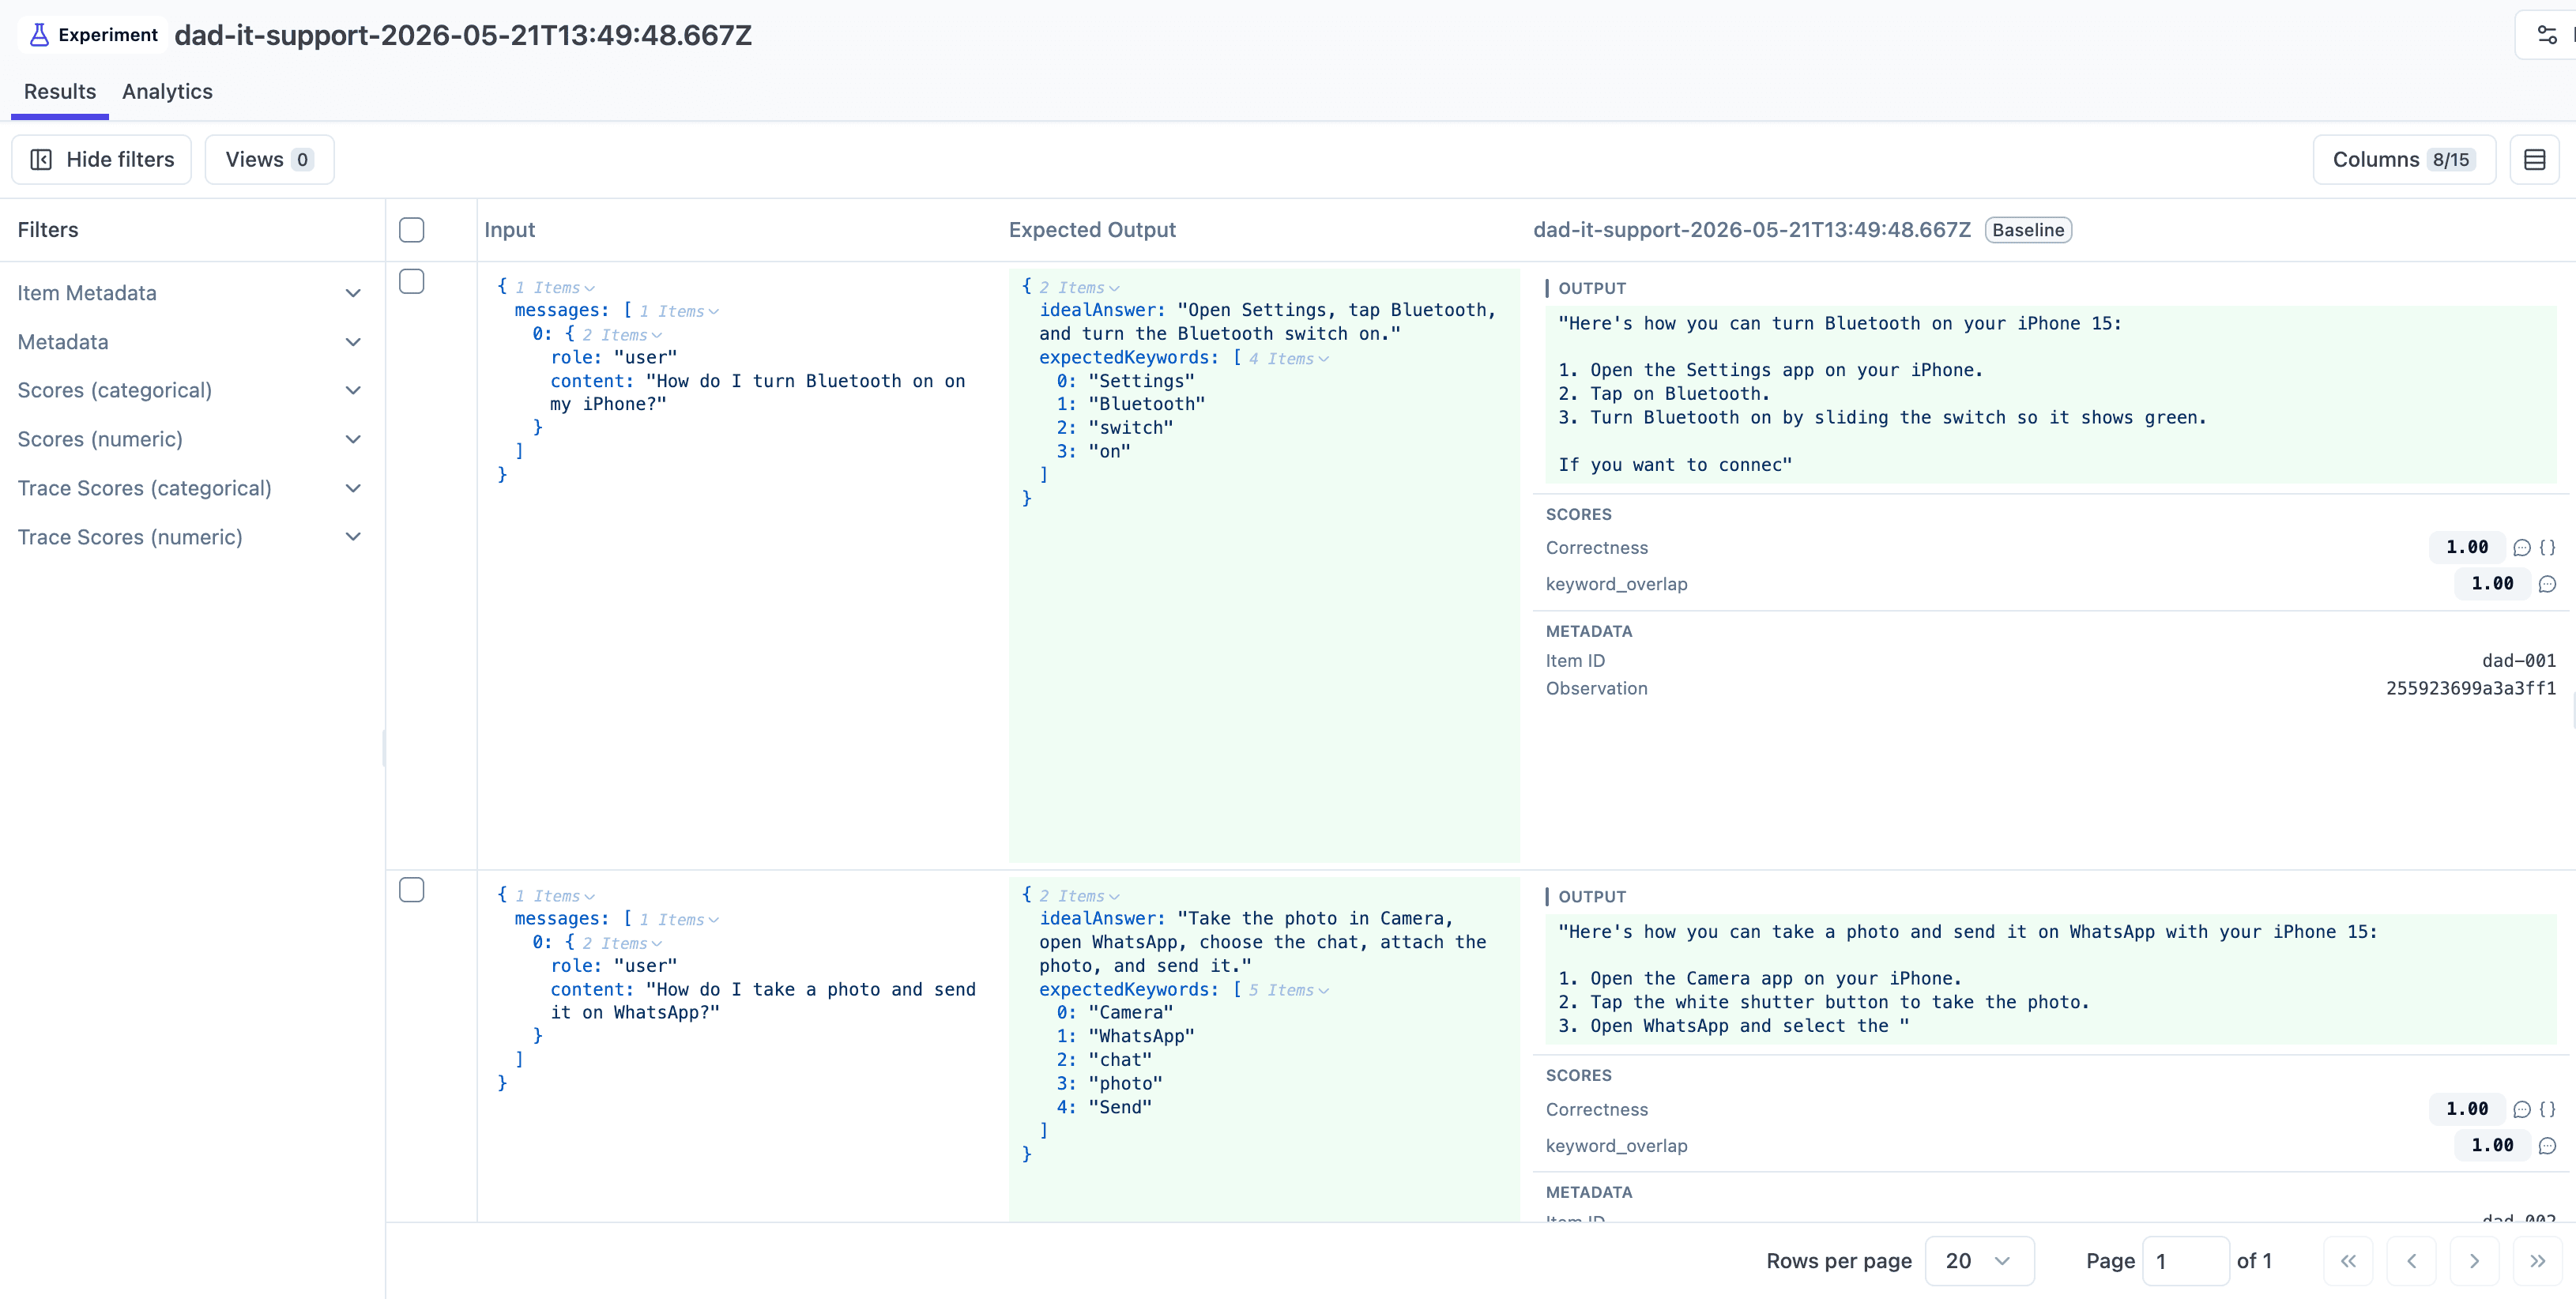
- Le nouveau Run du dataset → une ligne par élément avec deux scores,
keyword_overlapetcorrectness, plus un lien vers le trace. - Les traces par élément — identiques aux traces de production.
- La chart view du dataset → les moyennes des deux scores par exécution, prêtes pour les comparaisons futures.
Comment vérifier que vous avez terminé
- Une ligne d’exécution apparaît sous le dataset.
- Chaque élément possède un trace et les deux scores.
- La structure du trace correspond à celle d’un trace de production normal.
Conclusion
Les deux approches donnent deux angles sur la même exécution : keyword match répond « avons-nous couvert les étapes ? » et correctness répond « la réponse est-elle correcte ? ». Les programmes d’évaluation réels combinent souvent des contrôles déterministes et des juges.
Si votre équipe préfère davantage de logique dans l’interface, le contrôle déterministe pourra ensuite migrer vers un code evaluator. La documentation des code evaluators décrit cette voie, et la documentation des expériences via le SDK montre comment s’intègre la configuration côté code.
La skill Langfuse (/langfuse) connaît les structures et modèles recommandés. Ce parcours explique ce qu’elle fait en coulisses. Pour en savoir plus, consultez la leçon Langfuse Academy.
État final
C’est le point de départ de 07-evaluation.
05 Dataset
Vous avez une application tracée, attribuée et surveillée. data/seed-dataset.json et scripts/seed-dataset.ts se trouvent déjà dans le dépôt à ce checkpoint.
07 Évaluer un changement
Votre application est tracée, surveillée, possède un dataset hébergé et au moins une exécution avec les scores keywordoverlap et correctness. Vous allez maintenant la modifier et relancer...