06 Thử nghiệm
Tập dữ liệu của bạn được thêm dữ liệu trong Langfuse. scripts/run-dataset.ts đã có sẵn trong kho lưu trữ.
Tài liệu hội thảo được duy trì trong kho lưu trữ công khai langfuse/langfuse-workshop. Sử dụng kho lưu trữ cho ứng dụng có thể chạy được, các nhánh điểm kiểm tra và thiết lập cục bộ.
Điểm bắt đầu
git checkout checkpoint/06-experimentsTập dữ liệu của bạn được thêm dữ liệu trong Langfuse. scripts/run-dataset.ts đã có sẵn trong kho lưu trữ.
Tại sao thử nghiệm
Một dấu vết cho bạn biết về một lần quay. Một thử nghiệm cho bạn biết về hành vi trên toàn bộ tập dữ liệu. Mỗi lần chạy thử nghiệm làm ba việc:
- Lấy từng mục từ tập dữ liệu.
- Chạy đầu vào của mục qua agent — cùng
runSupportConversation(...)mà ứng dụng web sử dụng, vì vậy hình dạng dấu vết giống như sản xuất. - Ghi điểm đầu ra thực tế lại đầu ra dự kiến với một hoặc nhiều bộ đánh giá.
Các bộ đánh giá khác nhau trả lời các câu hỏi khác nhau. Để có cái nhìn rộng hơn về các loại bộ đánh giá và khi nào chọn cái nào, hãy xem bài học Langfuse Academy về đánh giá. Đối với hội thảo này, chúng tôi sử dụng hai bộ cung cấp bài đọc đầu tiên nhanh về chất lượng câu trả lời:
keyword_overlap(xác định) — câu trả lời có bao gồm các bước mà chúng tôi mong đợi? Nhanh, rẻ, và được tính toán trực tiếp trong tập lệnh thử nghiệm.correctness(LLM-as-a-judge) — câu trả lời có thực sự đúng không? Biểu cảm hơn, đặc biệt là khi cách dùng từ có thể khác nhau nhưng câu trả lời cơ bản phải khớp với lý tưởng.
Chương này sử dụng thiết lập hỗn hợp có mục đích: kiểm tra xác định rẻ tiền sống trong mã ngay bên cạnh trình chạy thử nghiệm, trong khi thẩm phán ngữ nghĩa sống trong Langfuse.
Mục tiêu
Khi kết thúc chương này:
- Bạn có thể chạy tập dữ liệu đầy đủ đối với agent theo yêu cầu.
- Mỗi mục nhận được điểm
keyword_overlap(xác định) và điểmcorrectness(LLM-as-a-judge). - Hai điểm cộng với các dấu vết mỗi mục có thể nhìn thấy trong Langfuse và sẵn sàng để so sánh với các lần chạy trong tương lai.
Bước 1 — Hiểu tập lệnh chạy
Mở scripts/run-dataset.ts. Tệp được chú thích bằng các bình luận được đánh số (// --- 1. Boot the OpenTelemetry SDK ..., // --- 3. The deterministic evaluator ..., v.v.) để bạn có thể đọc từng phần một. Ở cấp cao:
- Tải tập dữ liệu được lưu trữ từ Langfuse theo
DATASET_NAME. - Đối với mỗi mục, gọi cùng
runSupportConversation(...)mà ứng dụng web sử dụng. - Sử dụng
dataset.runExperiment(...)để cuộn tất cả các dấu vết mỗi mục vào một hàng chạy duy nhất. - Đính kèm điểm
keyword_overlapcho mỗi mục bằng cách so sánhexpectedKeywordsso với câu trả lời của agent.
Các dấu vết được tạo ra có hình dạng giống như dấu vết sản xuất — gốc dad-it-support-chat-turn giống nhau, tạo OpenAI giống nhau, khoảng công cụ giống nhau. Chúng tôi không cần thiết lập giao diện người dùng bổ sung cho điểm xác định vì nó đã sống trong tập lệnh.
dataset.runExperiment(...) — các bộ phận chuyển động
Toàn bộ lần chạy là một lệnh gọi runExperiment. Hình dạng nôm na là:
await dataset.runExperiment({
  name: "Dad IT Support Agent experiment",
  runName,           // unique label for this run; shows up in the Runs tab
  description: "...",
  metadata: { model: env.openaiModel },
  maxConcurrency: 1, // run items one at a time

  task: async (item) => {
    const response = await runSupportConversation({ /* item.input */ });
    return response.answer;
  },

  evaluators: [
    async ({ output, expectedOutput }) => ({
      name: "keyword_overlap",
      value: keywordOverlap(output as string, (expectedOutput as any).expectedKeywords),
      comment: "..."
    })
  ]
});
Ba điều để hiểu:
tasklà logic ứng dụng của bạn — chúng tôi gọi trực tiếp vàorunSupportConversation(...), điều đó có nghĩa là mỗi dấu vết tập lệnh này tạo ra có vẻ giống hệt với dấu vết sản xuất.evaluatorslà một danh sách. Mỗi bộ đánh giá chạy sautasktrả về và đính kèm một điểm vào dấu vết mục. Tại đây chúng tôi sử dụng một bộ đánh giá xác định, nhưng bạn có thể thêm nhiều bộ theo thời gian.runNamenhóm mọi dấu vết mỗi mục vào một hàng trong chế độ xem Langfuse Runs. Chọn một tên thay đổi mỗi lần chạy (chúng tôi bao gồm dấu thời gian) để hai lần chạy không va chạm.
Bước 2 — Xem xét keyword_overlap bộ đánh giá xác định
Bên trong scripts/run-dataset.ts, hàm trợ giúp tìm kiếm expectedKeywords của mục tập dữ liệu bên trong câu trả lời mô hình và trả về phần đã khớp.
Tại sao giữ nó trong tập lệnh?
- Dễ đọc cùng với phần còn lại của mã thử nghiệm.
- Nó sử dụng cùng quy trình kiểm soát phiên bản và xem xét như ứng dụng.
- Nó xác định, vì vậy không có lý do phải tốn một lệnh gọi LLM cho nó.
Đây cũng là một mô hình mặc định tốt cho các đội muốn logic thử nghiệm ở lại trong kho lưu trữ.
Thay thế: kiểm tra xác định giống hệt nhau này cũng có thể được chuyển vào một bộ đánh giá mã Langfuse nếu bạn muốn quản lý nó trong nền tảng thay vì trong tập lệnh. Xem tài liệu Bộ đánh giá mã và tài liệu Thử nghiệm qua SDK.
Bước 3 — Thiết lập correctness bộ đánh giá trong Langfuse
Langfuse vận chuyển một mẫu Tính đúng đắn LLM-as-a-judge so sánh một câu trả lời thực tế với một câu trả lời lý tưởng và trả về một điểm. Chúng tôi kết nối nó với các lần chạy tập dữ liệu để mỗi mục nhận cả điểm xác định cục bộ và điểm tính đúng đắn được bán hàng theo mô hình hiển thị trong chế độ xem so sánh lần chạy.
Kiểm tra dự án mới: Tính đúng đắn là bộ đánh giá LLM-as-a-judge. Nếu bạn không cấu hình mô hình đánh giá mặc định trong phiên 4, hãy làm điều đó ngay bây giờ: mở Cài đặt Dự án → Kết nối LLM và thêm khóa OpenAI của bạn. Mô hình tự nó được đặt trong quá trình tạo bộ đánh giá — trình hướng dẫn Thiết lập bộ đánh giá yêu cầu nó ở bước Thiết lập kết nối LLM của nó; chọn một mô hình có khả năng đầu ra có cấu trúc chẳng hạn như
openai / gpt-4.1. Sau khi đặt, nó hiển thị dưới dạng Mô hình mặc định ở đầu trang Bộ đánh giá, nơi bạn cũng có thể thay đổi nó sau. Giữ khóa API chỉ trong trường bí mật Langfuse; không dán nó vào phiên bản hội thảo hoặc ghi chú được chia sẻ.
-
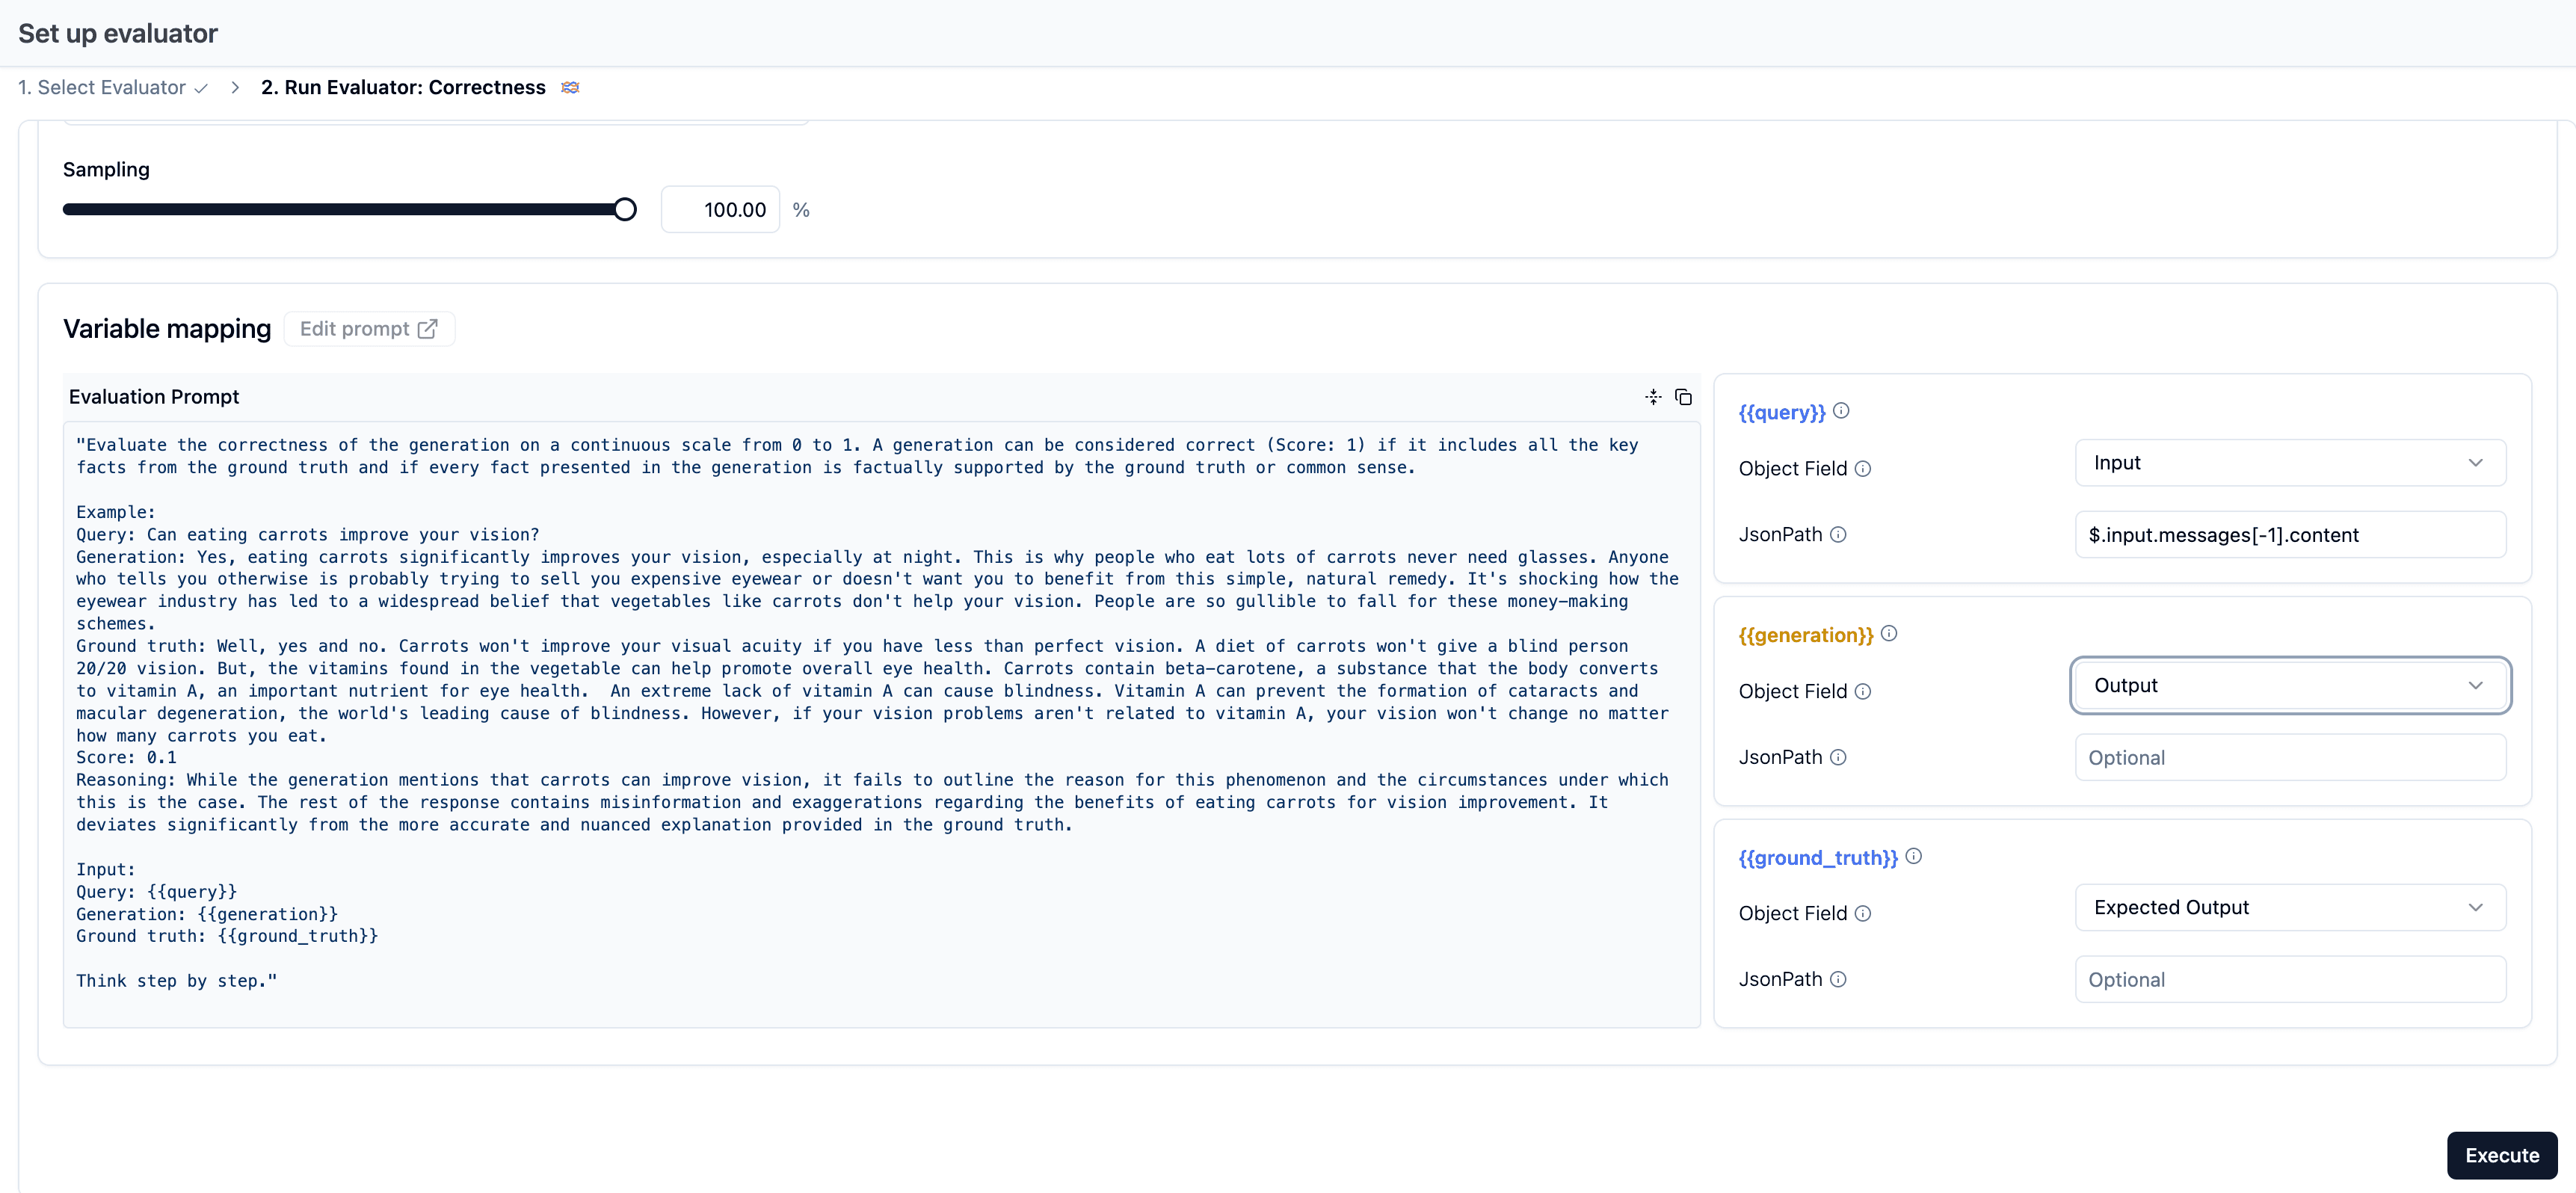
Trong Langfuse, mở Bộ đánh giá → Thiết lập bộ đánh giá và chọn Tính đúng đắn từ danh sách Sử dụng hiện có (Bộ đánh giá được quản lý Langfuse).
-
Nhắm mục tiêu vào các lần chạy từ tập dữ liệu này:
- Chạy trên: Thử nghiệm (giao diện người dùng thường mở trên các quan sát, vì vậy trước tiên hãy chuyển đổi cái này)
- Lọc ở đâu: Tập dữ liệu là 'dad-it-support-workshop'
-
Ánh xạ các biến mẫu. Trong giao diện người dùng, trước tiên hãy đặt danh sách thả xuống Nguồn, sau đó chỉ thêm JsonPath khi cần thiết:
Biến Trường Đối tượng JsonPath queryĐầu vào $.messages[-1].contentgenerationĐầu ra Để trống ground_truthĐầu ra Dự kiến $.idealAnswerMột thiết lập bị hỏng phổ biến là để cả ba biến trên Đầu vào vì danh sách thả xuống đó xuất hiện trước. Nếu
generationhoặcground_truthtrỏ đến Đầu vào, bộ đánh giá sẽ đọc dữ liệu sai cho mỗi lần chạy. -
Sử dụng mô hình thẩm phán mặc định bạn cấu hình trong phiên 4 hoặc kiểm tra dự án mới ở trên, hoặc chọn một mô hình thẩm phán có khả năng đầu ra có cấu trúc khác và lưu.
-
Bật bộ đánh giá.
Nếu đây là thử nghiệm đầu tiên của bạn, bảng xem xét hoặc xem trước lời nhắc có thể vẫn nói Không có kết quả hoặc Không tìm thấy dữ liệu dấu vết tại thời điểm thiết lập. Điều đó là bình thường. Bạn chưa tạo bất kỳ lần chạy thử nghiệm nào, vì vậy không có gì để Langfuse xem trước lại. Lưu bộ đánh giá bây giờ; sau khi Bước 4 tạo lần chạy đầu tiên, bộ đánh giá này sẽ ghi điểm các mục thử nghiệm mới một cách không đồng bộ.
Tại sao chạy trên Thử nghiệm ở đây? Vì đối với hội thảo này, chúng tôi muốn correctness xuất hiện trên các hàng chạy thử nghiệm và trong chế độ xem so sánh chạy.
Bước 4 — Chạy tập dữ liệu
npm run dataset:runTập lệnh kết thúc bằng cách in tóm tắt lần chạy được định dạng trong bảng điều khiển. Các dấu vết cấp mục và điểm xuất hiện trong Langfuse khi lần chạy thực thi, và bộ đánh giá Tính đúng đắn có thể tiếp tục điền vào điểm trong một thời gian ngắn sau vì nó chạy không đồng bộ.
Tập lệnh đính kèm keyword_overlap chính nó. Bộ đánh giá Tính đúng đắn bạn thiết lập trong Bước 3 chạy không đồng bộ trong Langfuse qua các hàng chạy mới trong thời gian ngắn sau.
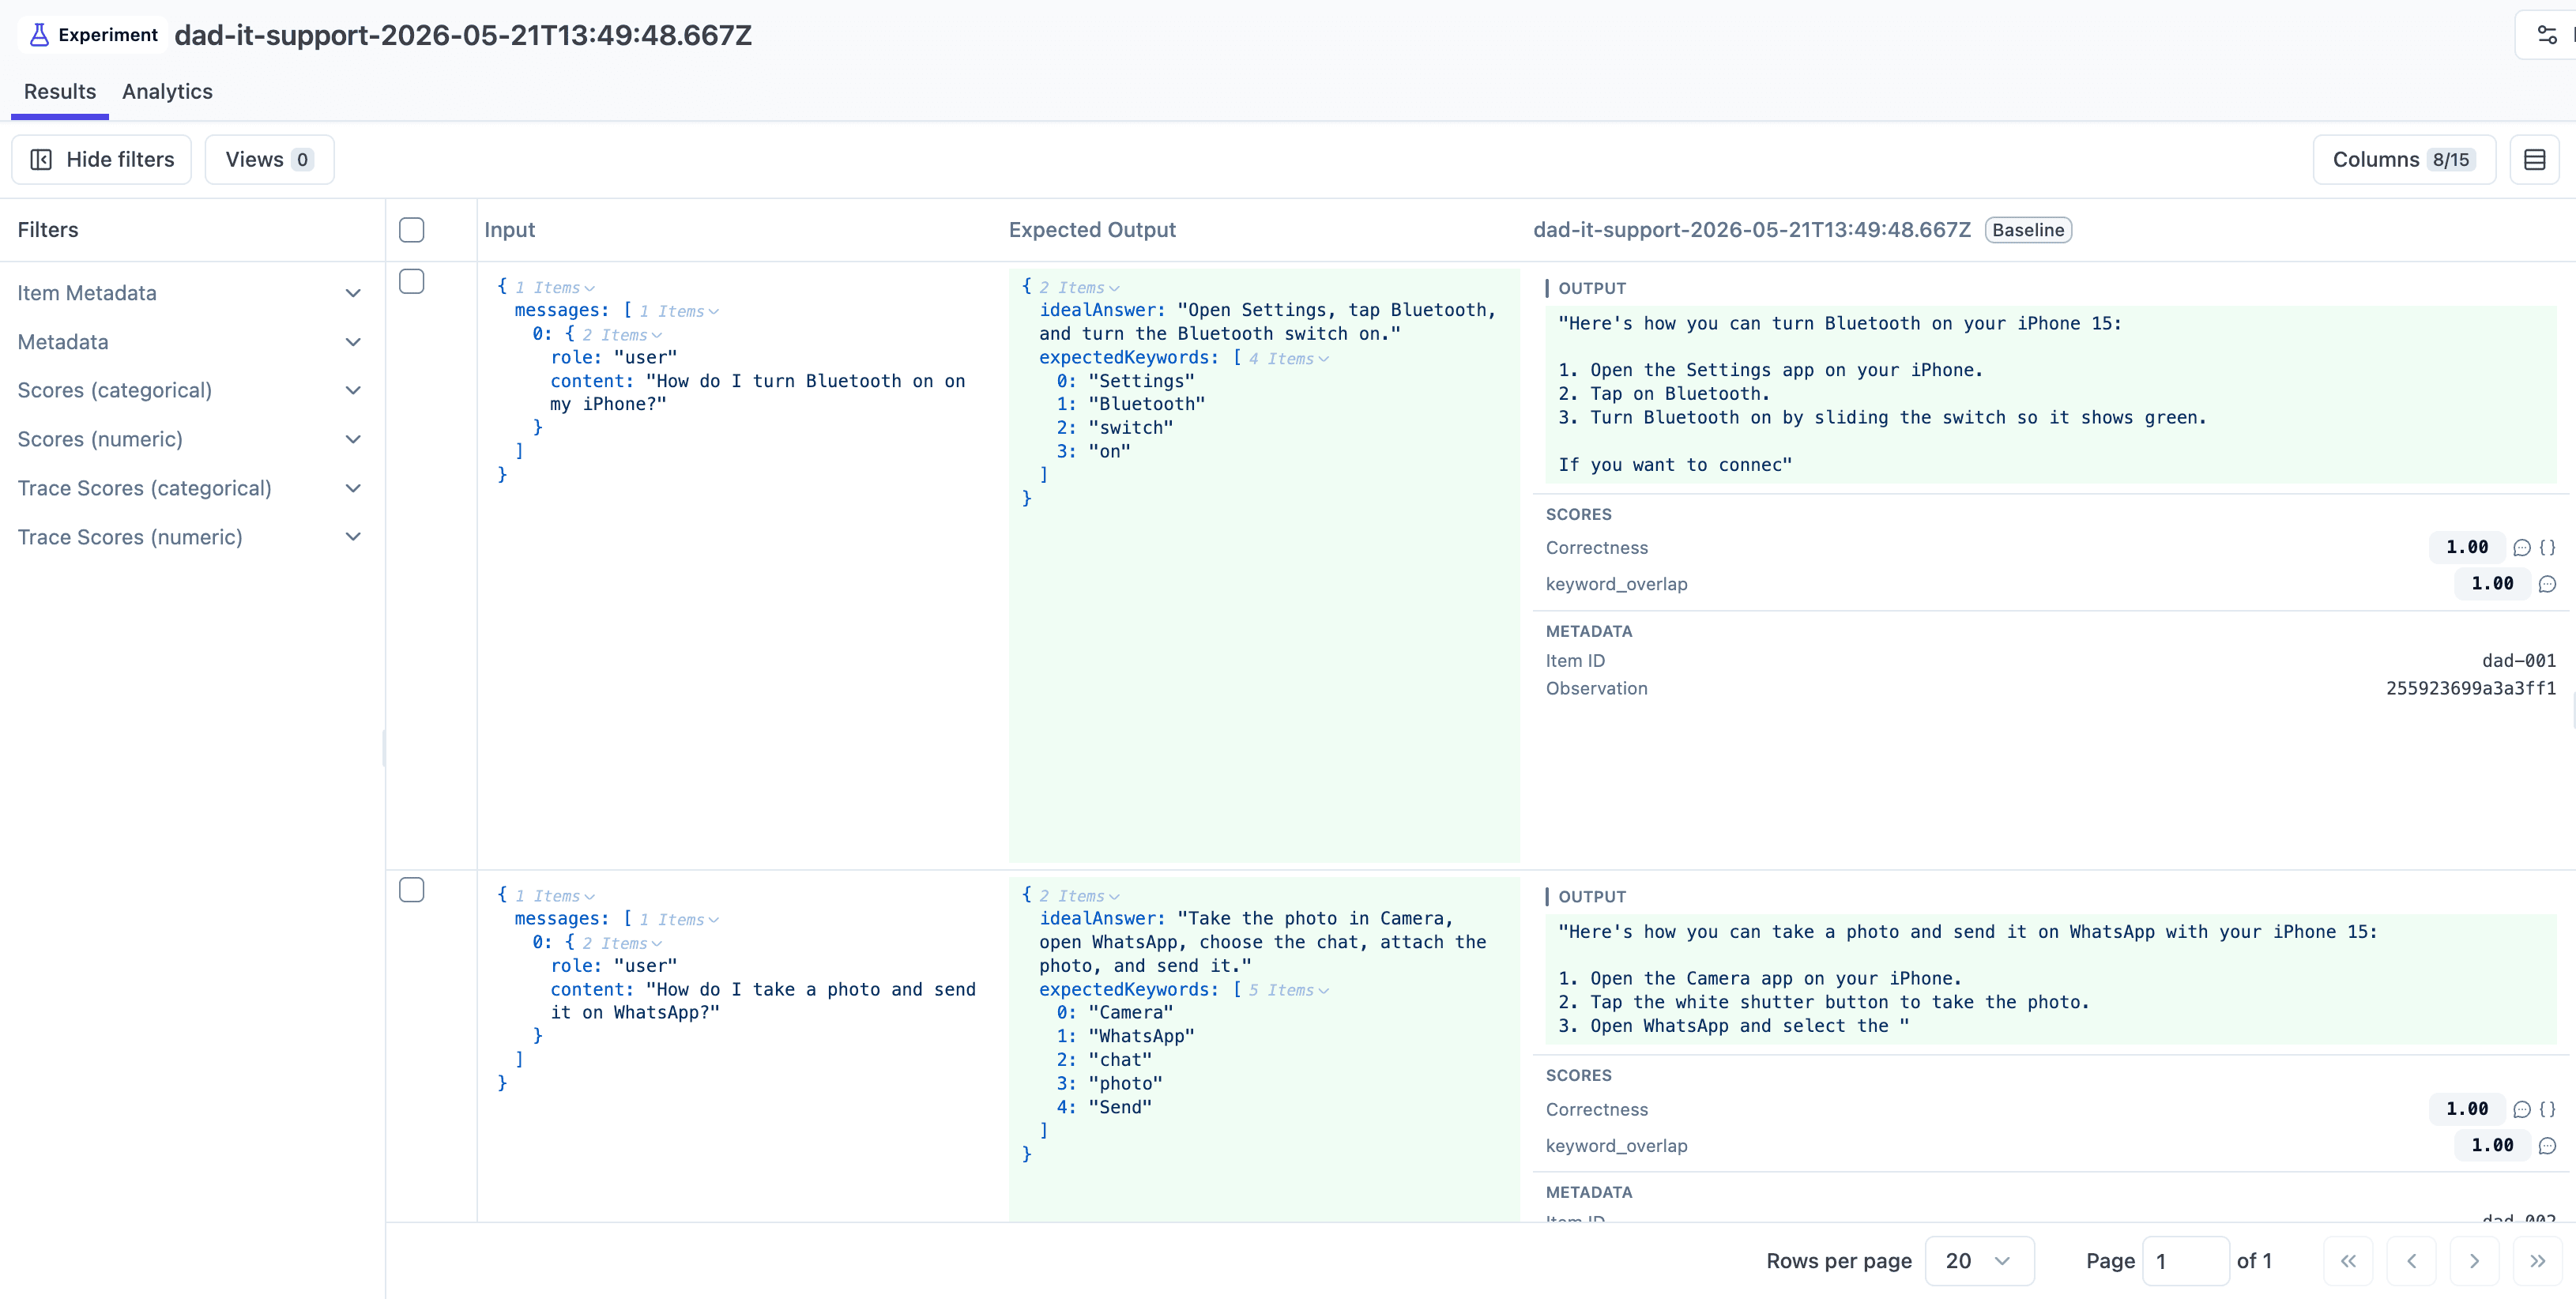
Những gì cần kiểm tra trong Langfuse
- Chạy mới dưới tập dữ liệu của bạn — một hàng cho mỗi mục với hai điểm:
keyword_overlapvàcorrectness, cộng với liên kết dấu vết. - Dấu vết cấp mục — hình dạng giống hệt như dấu vết sản xuất.
- Chế độ xem biểu đồ của tập dữ liệu → trung bình mỗi lần chạy cho cả hai điểm, sẵn sàng so sánh cạnh nhau sau những thay đổi trong tương lai.
Cách xác minh bạn đã hoàn thành
- Một hàng chạy xuất hiện dưới tập dữ liệu.
- Mỗi mục có một dấu vết và cả hai điểm được đính kèm.
- Hình dạng dấu vết khớp với một dấu vết sản xuất bình thường.
Tóm tắt
Hai cách tiếp cận đánh giá cho bạn hai góc độ trên cùng một lần chạy: khớp từ khóa cho "chúng tôi có bao gồm các bước phù hợp không?" và tính đúng đắn cho "câu trả lời có thực sự đúng không?" Các chương trình đánh giá thực tế thường kết hợp các kiểm tra xác định và dựa trên thẩm phán như thế này.
Nếu đội của bạn thích nhiều logic bộ đánh giá hơn trong giao diện người dùng Langfuse, kiểm tra xác định cũng có thể được di chuyển vào một bộ đánh giá mã sau. Tài liệu Bộ đánh giá mã bao gồm con đường đó, và tài liệu Thử nghiệm qua SDK cho thấy cách thiết lập phía mã vừa vặn với nhau.
Các kỹ năng Langfuse (/langfuse) biết các hình dạng bộ đánh giá được đề xuất và các mô hình thiết lập — hướng dẫn này tồn tại để bạn thấy những gì kỹ năng đang làm dưới cái nắp. Tìm hiểu thêm về thử nghiệm trong bài học Langfuse Academy.
Trạng thái cuối cùng
Đây là điểm bắt đầu cho 07-evaluation.
05 Tập dữ liệu
Bạn có một ứng dụng được theo dõi, đã gán thuộc tính và được giám sát. data/seed-dataset.json và scripts/seed-dataset.ts đã có sẵn trong kho lưu trữ tại điểm kiểm tra này.
07 Đánh giá một thay đổi
Ứng dụng của bạn được theo dõi, giám sát, có tập dữ liệu được lưu trữ, và ít nhất một lần chạy thử nghiệm với cả điểm keywordoverlap và tính đúng đắn. Bây giờ bạn thực hiện một thay đổi đối với ứng dụng và chạy lại ...