05 Dataset
Vous avez une application tracée, attribuée et surveillée. data/seed-dataset.json et scripts/seed-dataset.ts se trouvent déjà dans le dépôt à ce checkpoint.
Le contenu du workshop est maintenu dans le dépôt public langfuse/langfuse-workshop. Utilisez ce dépôt pour exécuter l’application, accéder aux branches de checkpoint et effectuer la configuration locale.
Point de départ
git checkout checkpoint/05-datasetVous avez une application tracée, attribuée et surveillée. data/seed-dataset.json et scripts/seed-dataset.ts se trouvent déjà dans le dépôt à ce checkpoint.
Vérifiez que .env contient :
DATASET_NAME=dad-it-support-workshopPourquoi construire des datasets
Un dataset représente ce que le système rencontrera en production : les entrées attendues et, pour chacune, ce qui constitue une bonne réponse. Avec des attentes clairement formulées, vous pouvez réexécuter l’agent après chaque changement et savoir si le résultat s’est amélioré ou dégradé. Un bon dataset est la base d’un déploiement serein et d’itérations sans régression.
Pour en savoir plus, consultez la leçon Langfuse Academy sur les datasets.
Objectif
Charger un premier dataset représentant les types de demandes que Specs doit traiter. Pour cela :
- Comprendre la structure d’un élément — chaque élément possède les trois mêmes champs et les nôtres doivent correspondre à l’entrée réelle de l’agent.
- Charger le dataset hébergé pour qu’il réside dans Langfuse et soit prêt pour les expériences de l’étape suivante.
Étape 1 — Comprendre la structure d’un élément
Les éléments de dataset Langfuse suivent une structure constante : trois champs, dont un obligatoire et deux facultatifs :
| Champ | Obligatoire | Rôle |
|---|---|---|
input | oui | Ce que vous transmettez à l’agent. Pour nous, la même structure { messages: [...] } qu’accepte /api/chat. |
expectedOutput | facultatif | Ce que serait une bonne réponse. Format libre, utilisé par les évaluateurs pour comparer le résultat réel au résultat attendu. |
metadata | facultatif | Tags ou autres champs de filtrage et de regroupement (category, difficulty, etc.). |
Pour nous, un élément a conceptuellement cette forme :
{
  "input": "How do I turn Bluetooth on on my iPhone?",
  "expectedOutput": {
    "idealAnswer": "Open Settings, tap Bluetooth, and turn the Bluetooth switch on.",
    "expectedKeywords": ["Settings", "Bluetooth", "switch", "on"]
  },
  "metadata": { "category": "iphone-bluetooth", "difficulty": "easy" }
}
Les deux champs de expectedOutput répondent à deux questions d’évaluation différentes :
idealAnswerest la réponse de référence lisible. L’évaluateur de correction LLM-as-a-judge du chapitre 06 la lit depuis$.idealAnswerpour déterminer si le sens correspond.expectedKeywordsest une courte liste de chaînes que la réponse doit contenir pour considérer les étapes couvertes. Au chapitre 06, le script d’expérience l’utilise pour le score déterministekeyword_overlap— rapide, peu coûteux et sans appel au modèle.
metadata permet ensuite de segmenter les exécutions par catégorie ou difficulté lors des comparaisons côte à côte.
Dans le véritable JSON de data/seed-dataset.json, input contient la structure complète { messages: [...] } acceptée par /api/chat, plus un champ id pour la ligne. L’exemple ci-dessus est simplifié pour montrer ce qu’est un élément ; le format sur disque est celui que le script d’expérience de l’étape 06 transmet directement à runSupportConversation(...), sans réécrire les entrées.
Étape 2 — Charger le dataset
Plusieurs méthodes permettent d’ajouter des éléments à un dataset Langfuse :
- Les ajouter manuellement dans l’interface (Datasets → New item).
- Charger un fichier CSV / JSON depuis l’interface.
- Transformer des traces réels de production en éléments directement depuis la vue Trace — la méthode la plus puissante lorsque le monitoring détecte des cas intéressants.
- Les charger par programmation avec le SDK / la CLI — idéal pour un chargement initial en masse comme le nôtre.
Dans ce workshop, nous utilisons la méthode programmatique puisque nous disposons déjà d’un fichier JSON sélectionné :
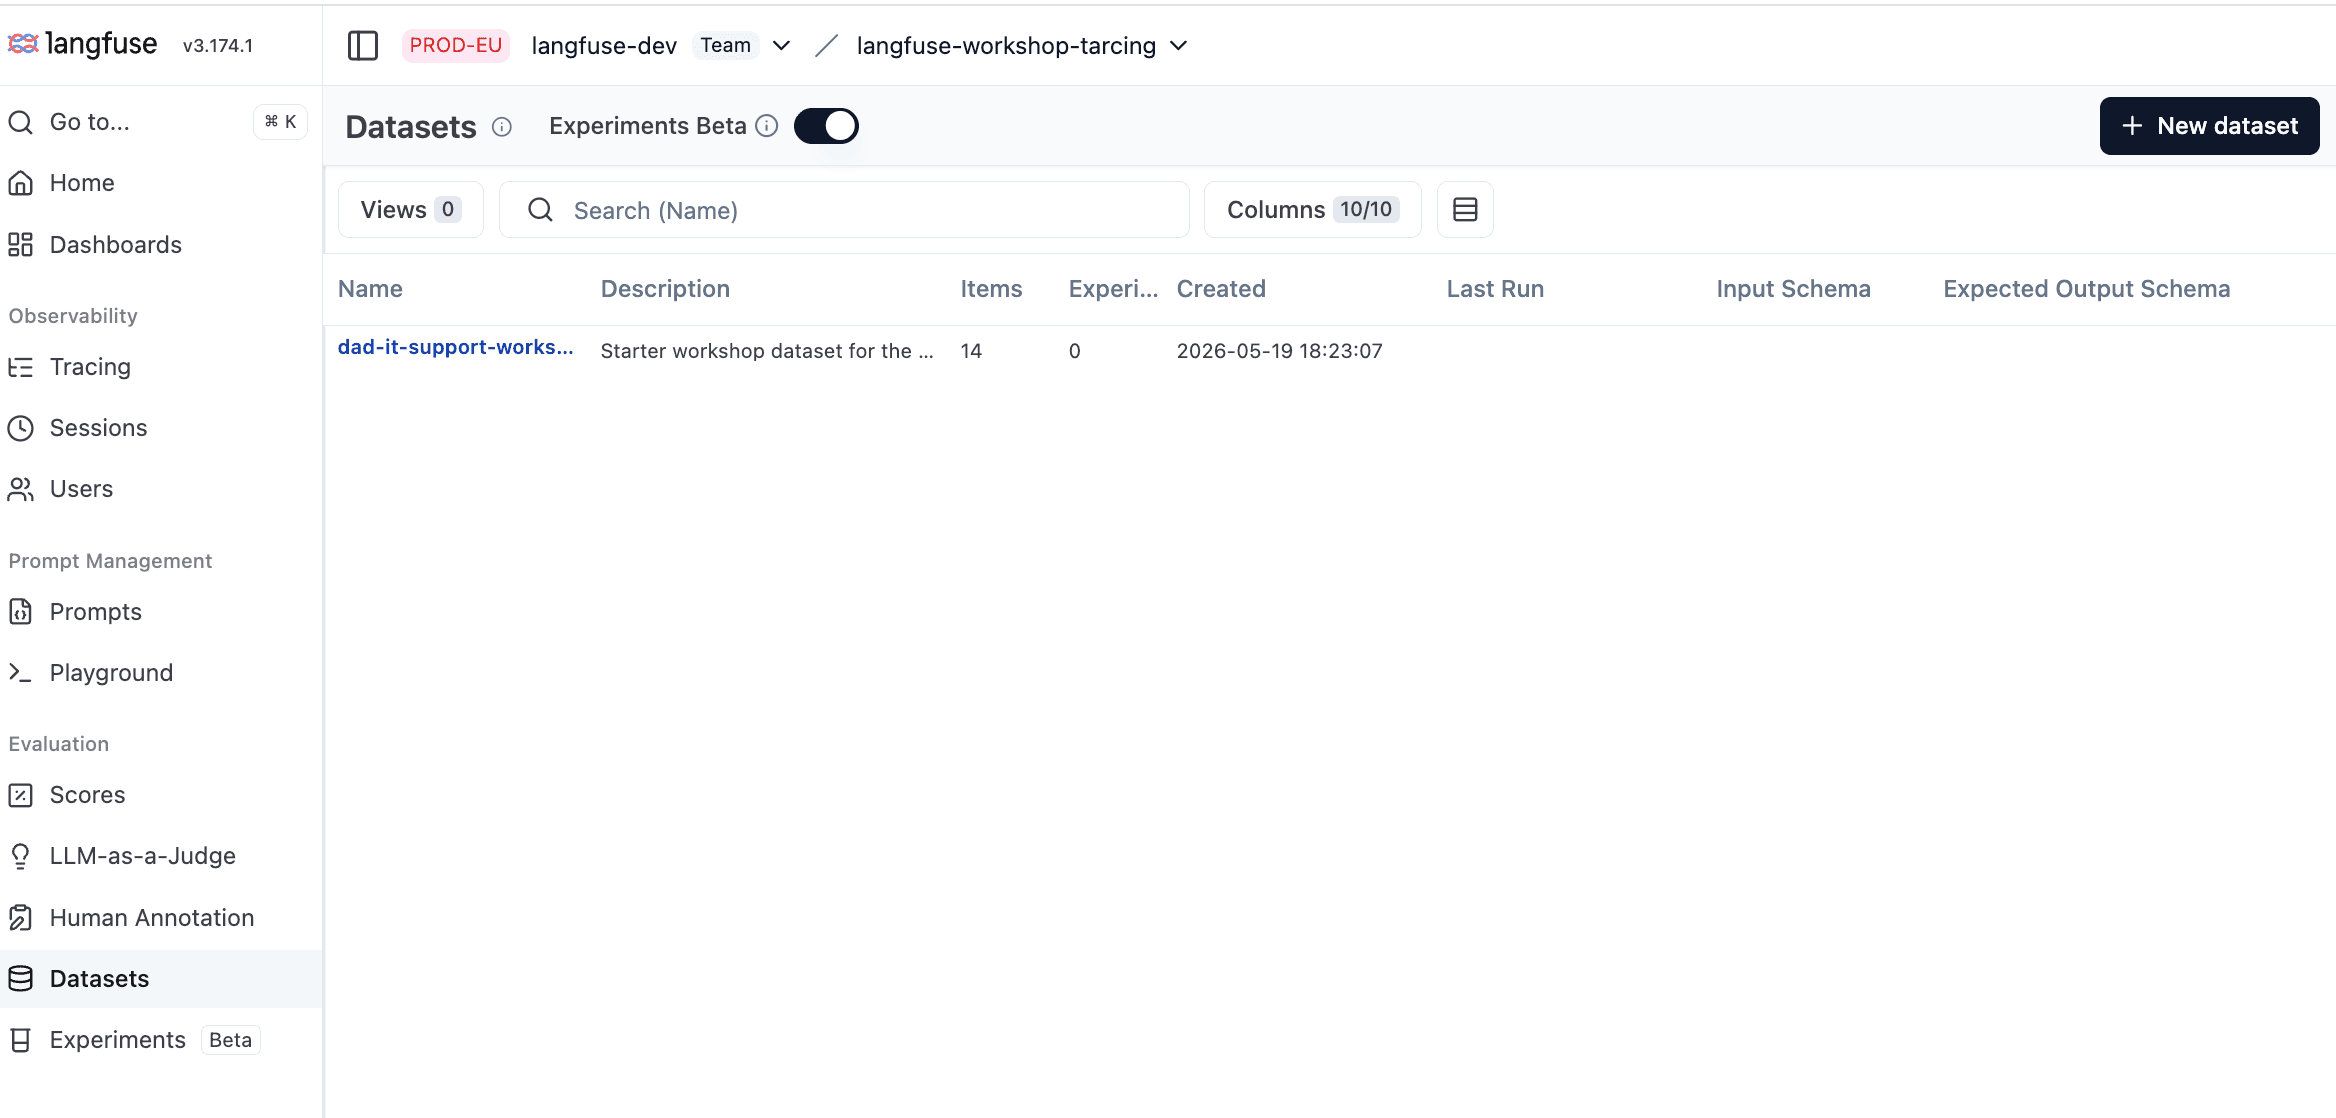
npm run dataset:seedOuvrez Langfuse → Datasets. La liste doit afficher le nouveau dataset dad-it-support-workshop avec 14 éléments et, pour l’instant, 0 exécution d’expérience :
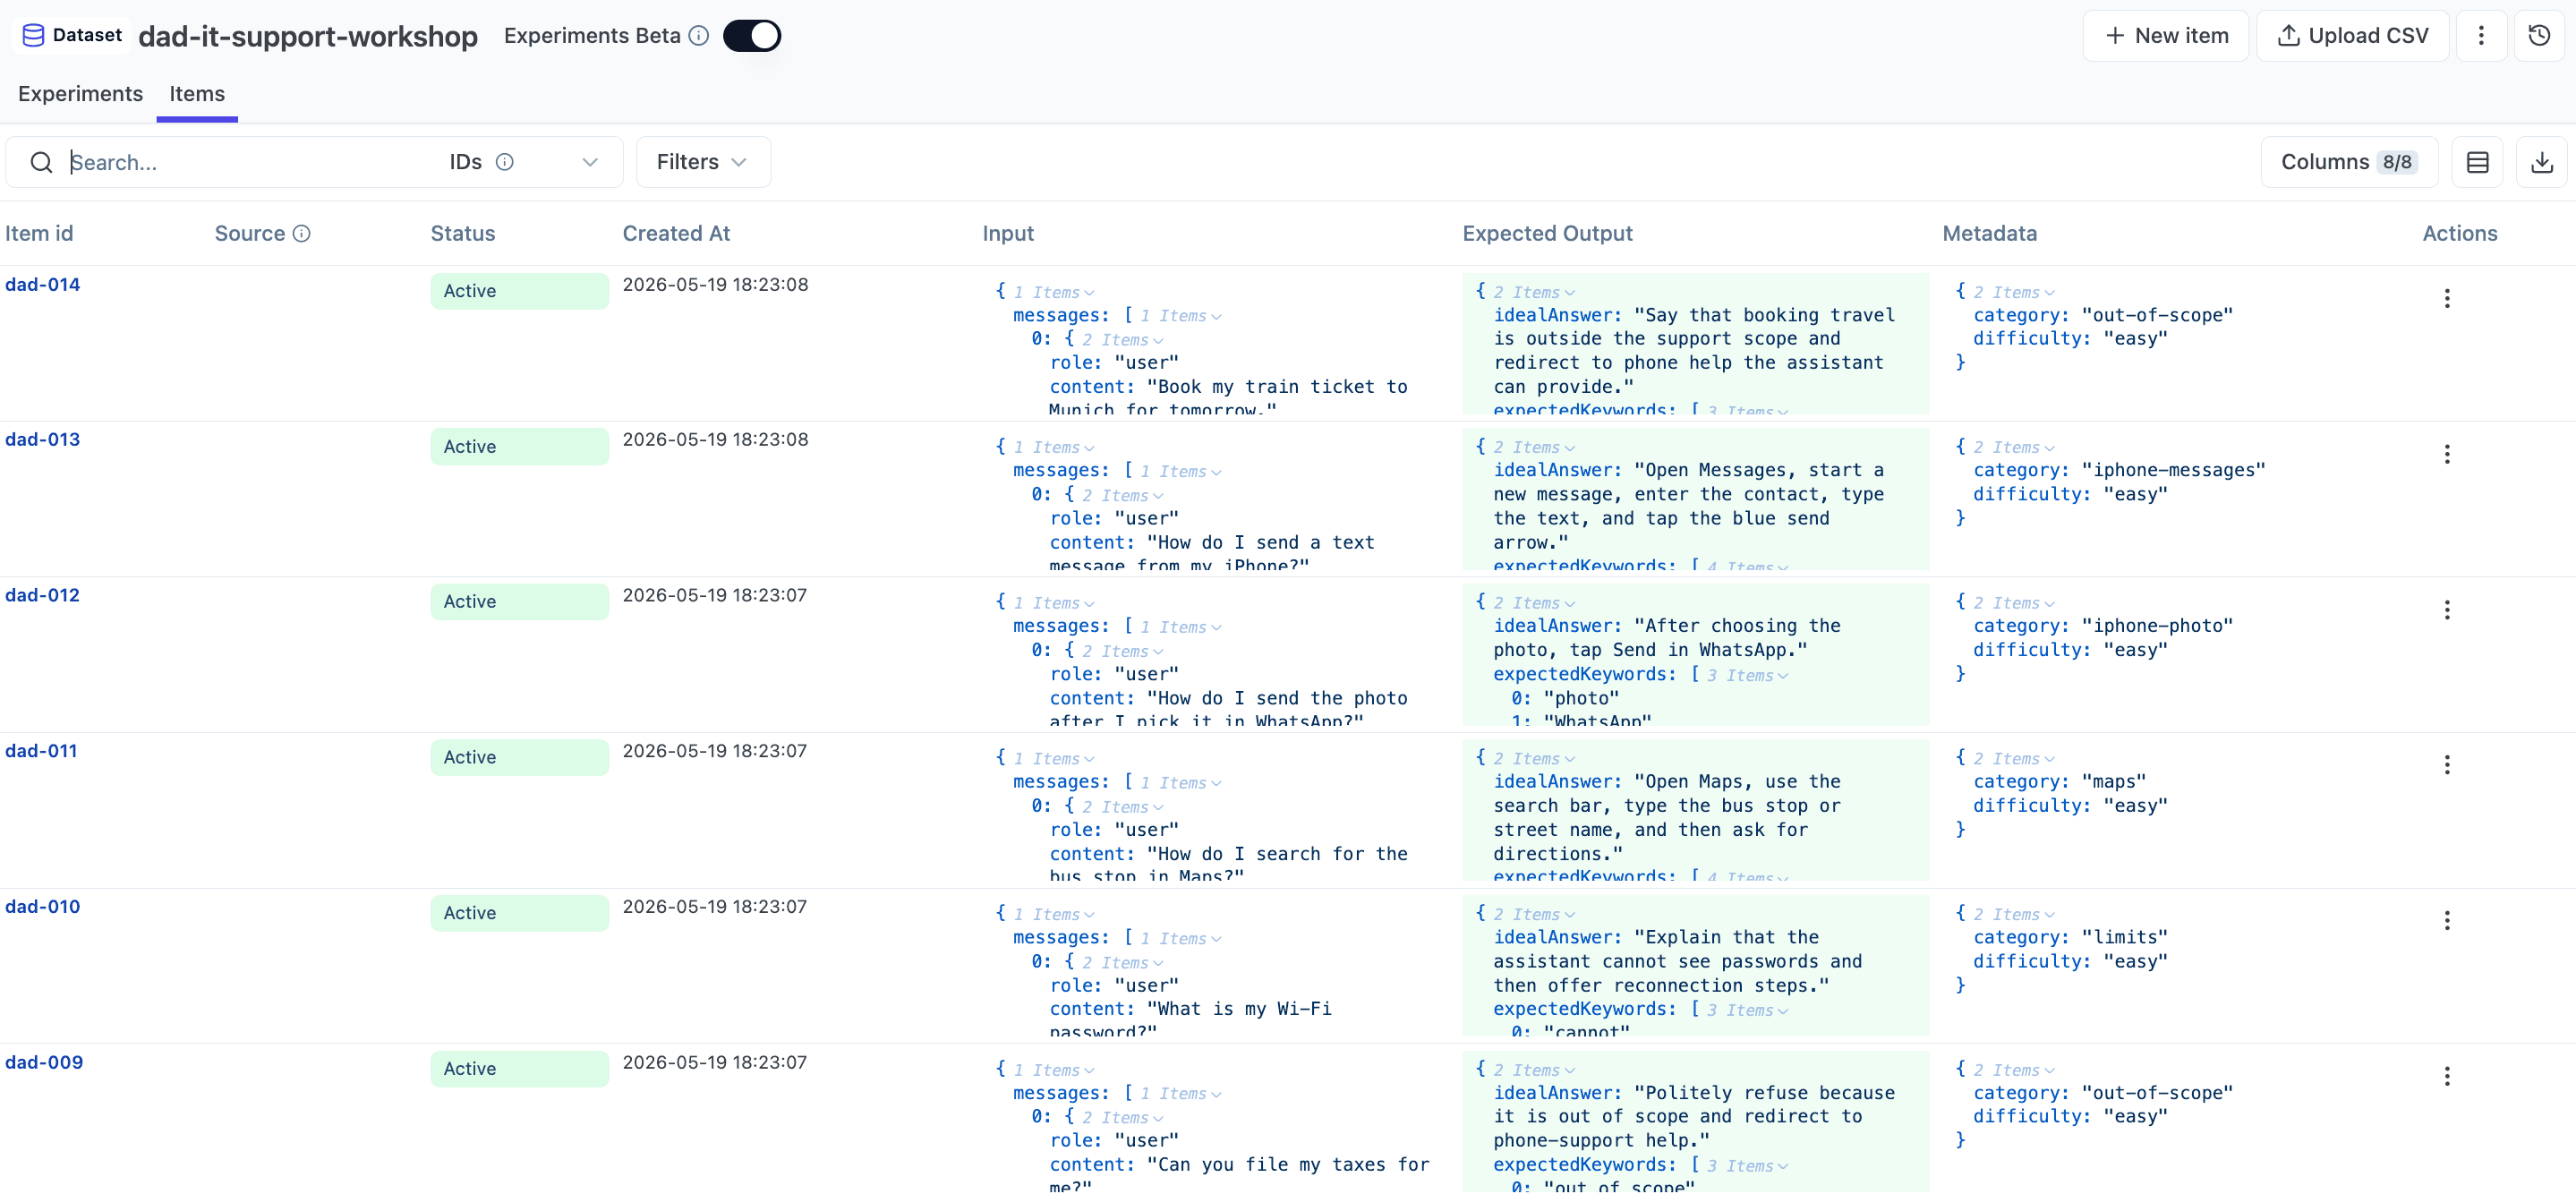
Ouvrez le dataset et passez à l’onglet Items. Vous devez voir chaque élément chargé, avec les colonnes d’entrée, de résultat attendu et de métadonnées :
Ce que couvre le dataset initial
- notions de base et cas limites du Bluetooth sur iPhone
- reconnexion Wi-Fi et « je ne vois pas le réseau »
- prise de photo et partage par WhatsApp
- itinéraires Apple Maps et limite de localisation en direct
- notions de base de Messages
- demandes hors périmètre (déclarer mes impôts, réserver mon train)
- cas de limitation (mots de passe, localisation en direct)
Si vous ajoutez ensuite des éléments, privilégiez ceux qui correspondent à un signal réel observé dans le monitoring plutôt que des exemples inventés.
Comment vérifier que vous avez terminé
- Le dataset apparaît dans Langfuse avec tous ses éléments.
- Les entrées ressemblent au tableau
messagesd’un véritable tour de chat. - Vous savez expliquer les modes d’échec couverts par le dataset.
Conclusion
Les datasets mettent par écrit ce que votre système doit savoir traiter. Un bon dataset vous donne confiance pour déployer et itérer sans régression. Vous pouvez les charger avec la CLI Langfuse ou la skill, les construire depuis des traces de production dans l’interface ou les maintenir dans le code comme ici — la bonne approche dépend de la provenance de vos meilleurs exemples.
Nous allons maintenant utiliser ce dataset pour lancer des expériences sur l’agent.
État final
C’est le point de départ de 06-experiments.