06 실험
Langfuse에 데이터셋이 시드됩니다. scripts/run-dataset.ts은 이미 저장소에 있습니다.
워크숍 자료는 공개 langfuse/langfuse-workshop 저장소에서 유지됩니다. 실행 가능한 앱, 체크포인트 브랜치, 로컬 설정을 위해 저장소를 사용하세요.
시작점
git checkout checkpoint/06-experimentsLangfuse에 데이터셋이 시드됩니다. scripts/run-dataset.ts는 이미 저장소에 있습니다.
왜 실험을 할까
트레이스는 한 번의 턴에 대해 알려줍니다. 실험은 데이터셋 전반에 걸친 동작을 알려줍니다. 모든 실험 실행은 동일한 세 가지를 수행합니다:
- 데이터셋의 각 항목을 가져옵니다.
- 항목의 입력을 에이전트를 통해 실행합니다 — 웹 앱이 사용하는 동일한
runSupportConversation(...), 따라서 트레이스 형태는 프로덕션 것과 동일합니다. - 실제 출력을 예상 출력과 비교하여 평가합니다 하나 이상의 평가자로.
다른 평가자는 다른 질문에 답합니다. 평가자 유형을 더 광범위하게 보고 어느 평가자를 선택할 시기를 알려면 Langfuse Academy의 평가 강의를 참조하세요. 이 워크숍에서는 빠른 첫 번째 읽기를 제공하는 두 가지를 사용합니다:
keyword_overlap(결정론적) — 답변이 예상된 단계를 다루었나요? 빠르고, 저렴하며, 실험 스크립트에서 직접 계산됩니다.correctness(LLM-as-a-judge) — 답변이 실제로 올바른가요? 더 표현력이 풍부합니다. 특히 표현이 달라도 기본 답변과 일치해야 합니다.
이 장은 의도적으로 혼합 설정을 사용합니다: 저렴한 결정론적 확인은 실험 실행자와 함께 코드에 있고, 의미론적 판사는 Langfuse에 있습니다.
목표
이 장이 끝날 때까지:
- 요청할 때마다 전체 데이터셋을 에이전트에 대해 실행할 수 있습니다.
- 모든 항목이
keyword_overlap점수(결정론적)와correctness점수(LLM-as-a-judge)를 얻습니다. - 두 점수와 항목별 트레이스는 Langfuse에 표시되고 향후 실행과 비교할 준비가 되었습니다.
단계 1 — 실행 스크립트 이해
scripts/run-dataset.ts을 엽니다. 파일은 번호가 지정된 주석(// --- 1. Boot the OpenTelemetry SDK ..., // --- 3. The deterministic evaluator ..., 등)으로 주석이 달려 있어 섹션별로 읽을 수 있습니다. 높은 수준에서:
DATASET_NAME별로 Langfuse에서 호스트된 데이터셋을 로드합니다.- 각 항목에 대해, 웹 앱이 사용하는 동일한
runSupportConversation(...)를 호출합니다. dataset.runExperiment(...)를 사용하여 모든 항목별 트레이스를 단일 실행 행으로 롤업합니다.expectedKeywords을 에이전트의 답변과 비교하여 항목별로keyword_overlap점수를 추가합니다.
생성되는 트레이스는 프로덕션 트레이스와 동일한 형태입니다 — 동일한 dad-it-support-chat-turn 루트, 동일한 OpenAI 생성, 동일한 도구 범위. 결정론적 점수에 대해 추가 UI 설정이 필요하지 않습니다. 이미 스크립트에 있기 때문입니다.
dataset.runExperiment(...) — 움직이는 부분
전체 실행은 runExperiment에 대한 하나의 호출입니다. 형태는 다음과 같이 단순화됩니다:
await dataset.runExperiment({
  name: "Dad IT Support Agent experiment",
  runName,           // unique label for this run; shows up in the Runs tab
  description: "...",
  metadata: { model: env.openaiModel },
  maxConcurrency: 1, // run items one at a time

  task: async (item) => {
    const response = await runSupportConversation({ /* item.input */ });
    return response.answer;
  },

  evaluators: [
    async ({ output, expectedOutput }) => ({
      name: "keyword_overlap",
      value: keywordOverlap(output as string, (expectedOutput as any).expectedKeywords),
      comment: "..."
    })
  ]
});
세 가지를 이해해야 합니다:
- **
task**은 응용 프로그램 로직입니다 — 우리는runSupportConversation(...)로 직접 호출합니다. 이는 이 스크립트가 생성하는 모든 트레이스가 프로덕션 트레이스와 동일해 보인다는 의미입니다. - **
evaluators**은 목록입니다. 각 평가자는task가 반환된 후 실행되고 항목 트레이스에 점수를 추가합니다. 여기서는 하나의 결정론적 평가자를 사용하지만 시간이 지남에 따라 더 추가할 수 있습니다. - **
runName**은 모든 항목별 트레이스를 Langfuse 실행 보기의 한 행으로 그룹화합니다. 두 실행이 충돌하지 않도록 실행마다 변경되는 이름을 선택합니다(타임스탬프 포함).
단계 2 — 결정론적 keyword_overlap 평가자 검토
scripts/run-dataset.ts 내에서, 헬퍼 함수는 데이터셋 항목의 expectedKeywords을 모델 답변에서 찾고 일치한 분수를 반환합니다.
왜 스크립트에 보관할까?
- 나머지 실험 코드와 함께 읽기가 쉽습니다.
- 앱과 동일한 버전 제어 및 검토 흐름을 사용합니다.
- 결정론적이므로 LLM 호출을 하는 이유가 없습니다.
이것은 또한 실험 로직이 저장소에 남아 있기를 원하는 팀을 위한 좋은 기본 패턴입니다.
대안: 이 동일한 결정론적 확인을 대신 Langfuse 코드 평가자로 이동할 수 있습니다. 플랫폼에서 관리하려면. 코드 평가자 문서와 SDK를 통한 실험 문서를 참조하세요.
단계 3 — Langfuse에서 correctness 평가자 설정
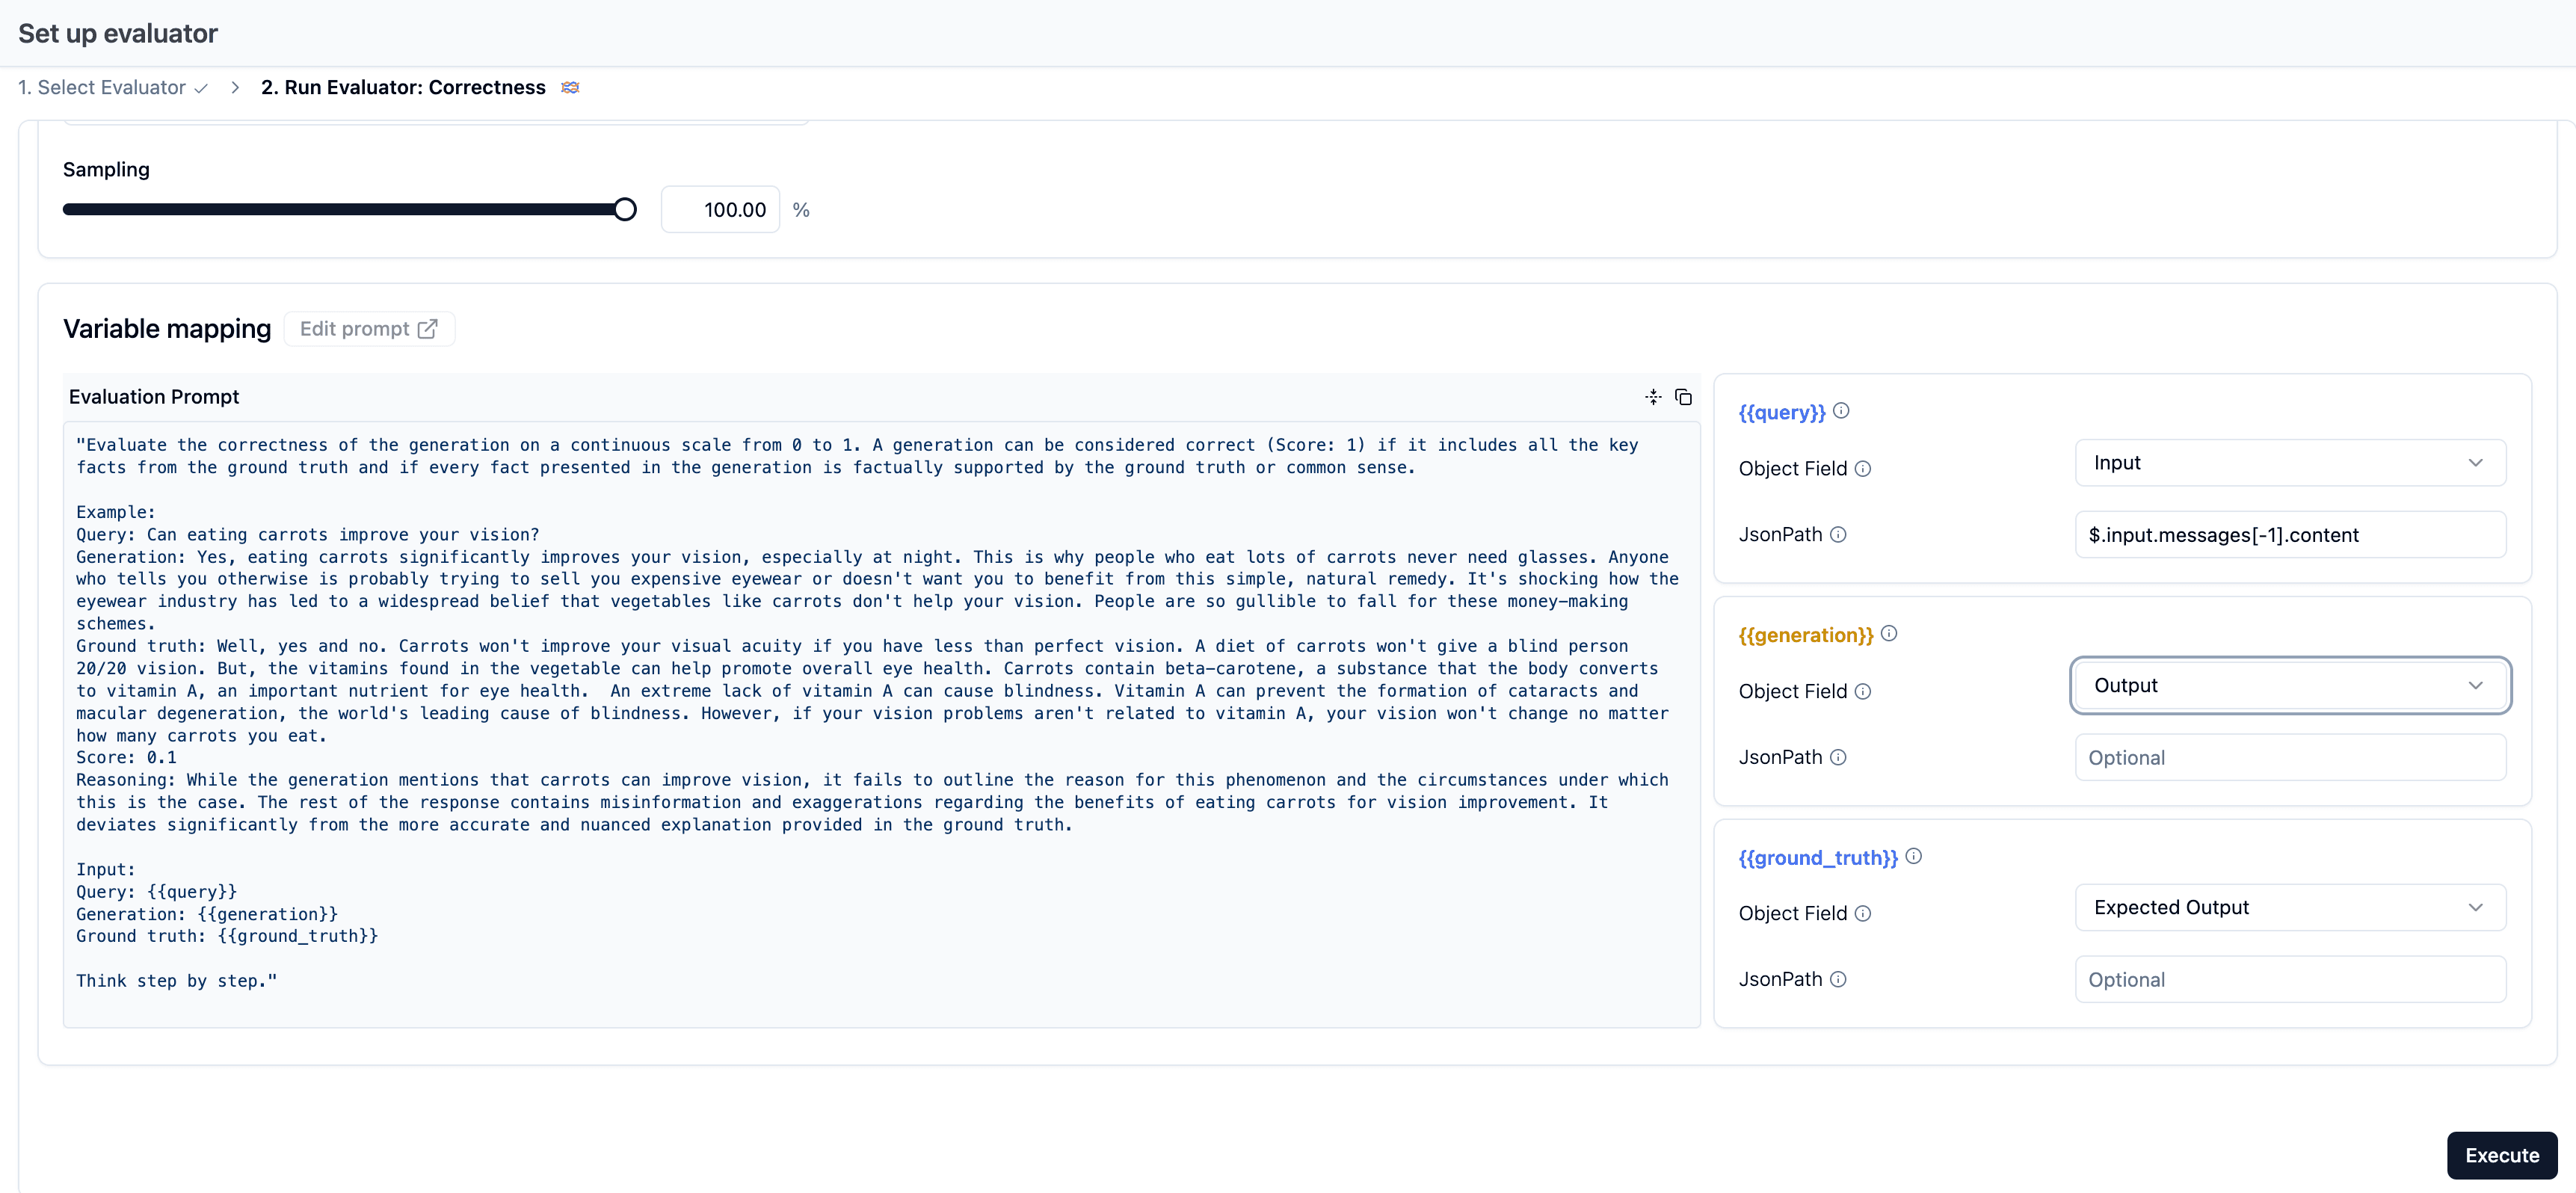
Langfuse는 실제 답변을 이상적인 답변과 비교하고 점수를 반환하는 정확성 LLM-as-a-judge 템플릿을 배포합니다. 데이터셋 실행에 대해 이를 연결하므로 모든 항목이 로컬 결정론적 점수와 실행 비교 보기에 나타나는 모델-판정 정확성 점수 모두를 얻습니다.
신규 프로젝트 확인: 정확성은 LLM-as-a-judge 평가자입니다. 4단계 세션에서 기본 평가 모델을 구성하지 않았다면 지금 하세요: 프로젝트 설정 → LLM 연결을 열고 OpenAI 키를 추가합니다. 모델 자체는 평가자 생성 중에 설정됩니다 — 평가자 설정 마법사는 LLM 연결 설정 단계에서 이를 요청합니다;
openai / gpt-4.1과 같은 구조화된 출력 가능 모델을 선택합니다. 설정되면, 평가자 페이지 상단에 기본 모델로 표시되며, 나중에 변경할 수도 있습니다. API 키를 Langfuse 비밀 필드에만 보관하십시오; 워크숍 트랜스크립트나 공유 노트에 붙여넣기 하지 마세요.
-
Langfuse에서 평가자 → 평가자 설정을 열고 기존 사용 목록에서(Langfuse 관리 평가자) 정확성을 선택합니다.
-
이 데이터셋의 실행을 대상으로 합니다:
- 실행 대상: 실험(UI는 종종 관찰에서 열리므로 이를 먼저 전환)
- 필터 위치: 데이터셋이 'dad-it-support-workshop'입니다
-
템플릿 변수를 매핑합니다. UI에서 먼저 소스 드롭다운을 설정한 다음 필요한 곳에만 JsonPath를 추가합니다:
변수 개체 필드 JsonPath query입력 $.messages[-1].contentgeneration출력 공백 둡니다 ground_truth예상 출력 $.idealAnswer일반적인 깨진 설정은 해당 드롭다운이 먼저 표시되기 때문에 세 변수 모두를 입력에 두는 것입니다.
generation또는ground_truth이 입력을 가리키면, 평가자는 모든 실행마다 잘못된 데이터를 읽습니다. -
4단계 세션에서 구성한 기본 판사 모델을 사용하거나, 위의 신규 프로젝트 확인에서 또는 다른 구조화된 출력 가능 판사 모델을 선택합니다.
-
평가자를 활성화합니다.
이것이 첫 번째 실험이라면, 설정 시간의 검토 테이블 또는 프롬프트 미리보기는 여전히 결과 없음 또는 트레이스 데이터를 찾을 수 없음이라고 말할 수 있습니다. 예상입니다. 아직 생성된 실험 실행이 없으므로 Langfuse가 미리보기할 것이 없습니다. 지금 평가자를 저장합니다; 4단계에서 첫 번째 실행을 생성한 후, 이 평가자는 새로운 실험 항목을 비동기적으로 평가합니다.
왜 여기서 실험을 실행할까요? 이 워크숍에서 correctness이 실험 실행 행과 실행 비교 보기에 나타나기를 원하기 때문입니다.
단계 4 — 데이터셋 실행
npm run dataset:run스크립트는 콘솔에서 형식화된 실행 요약을 인쇄하여 완료합니다. 항목 수준 트레이스와 점수는 실행이 진행되는 동안 Langfuse에 나타나고, 정확성 평가자는 비동기적으로 실행되므로 새 실행 행 후 잠시 계속 점수를 채울 수 있습니다.
스크립트는 keyword_overlap 자체를 첨부합니다. 3단계에서 설정한 정확성 평가자는 새 실행 행에 대해 곧 Langfuse에서 비동기적으로 실행됩니다.
Langfuse에서 검사할 것
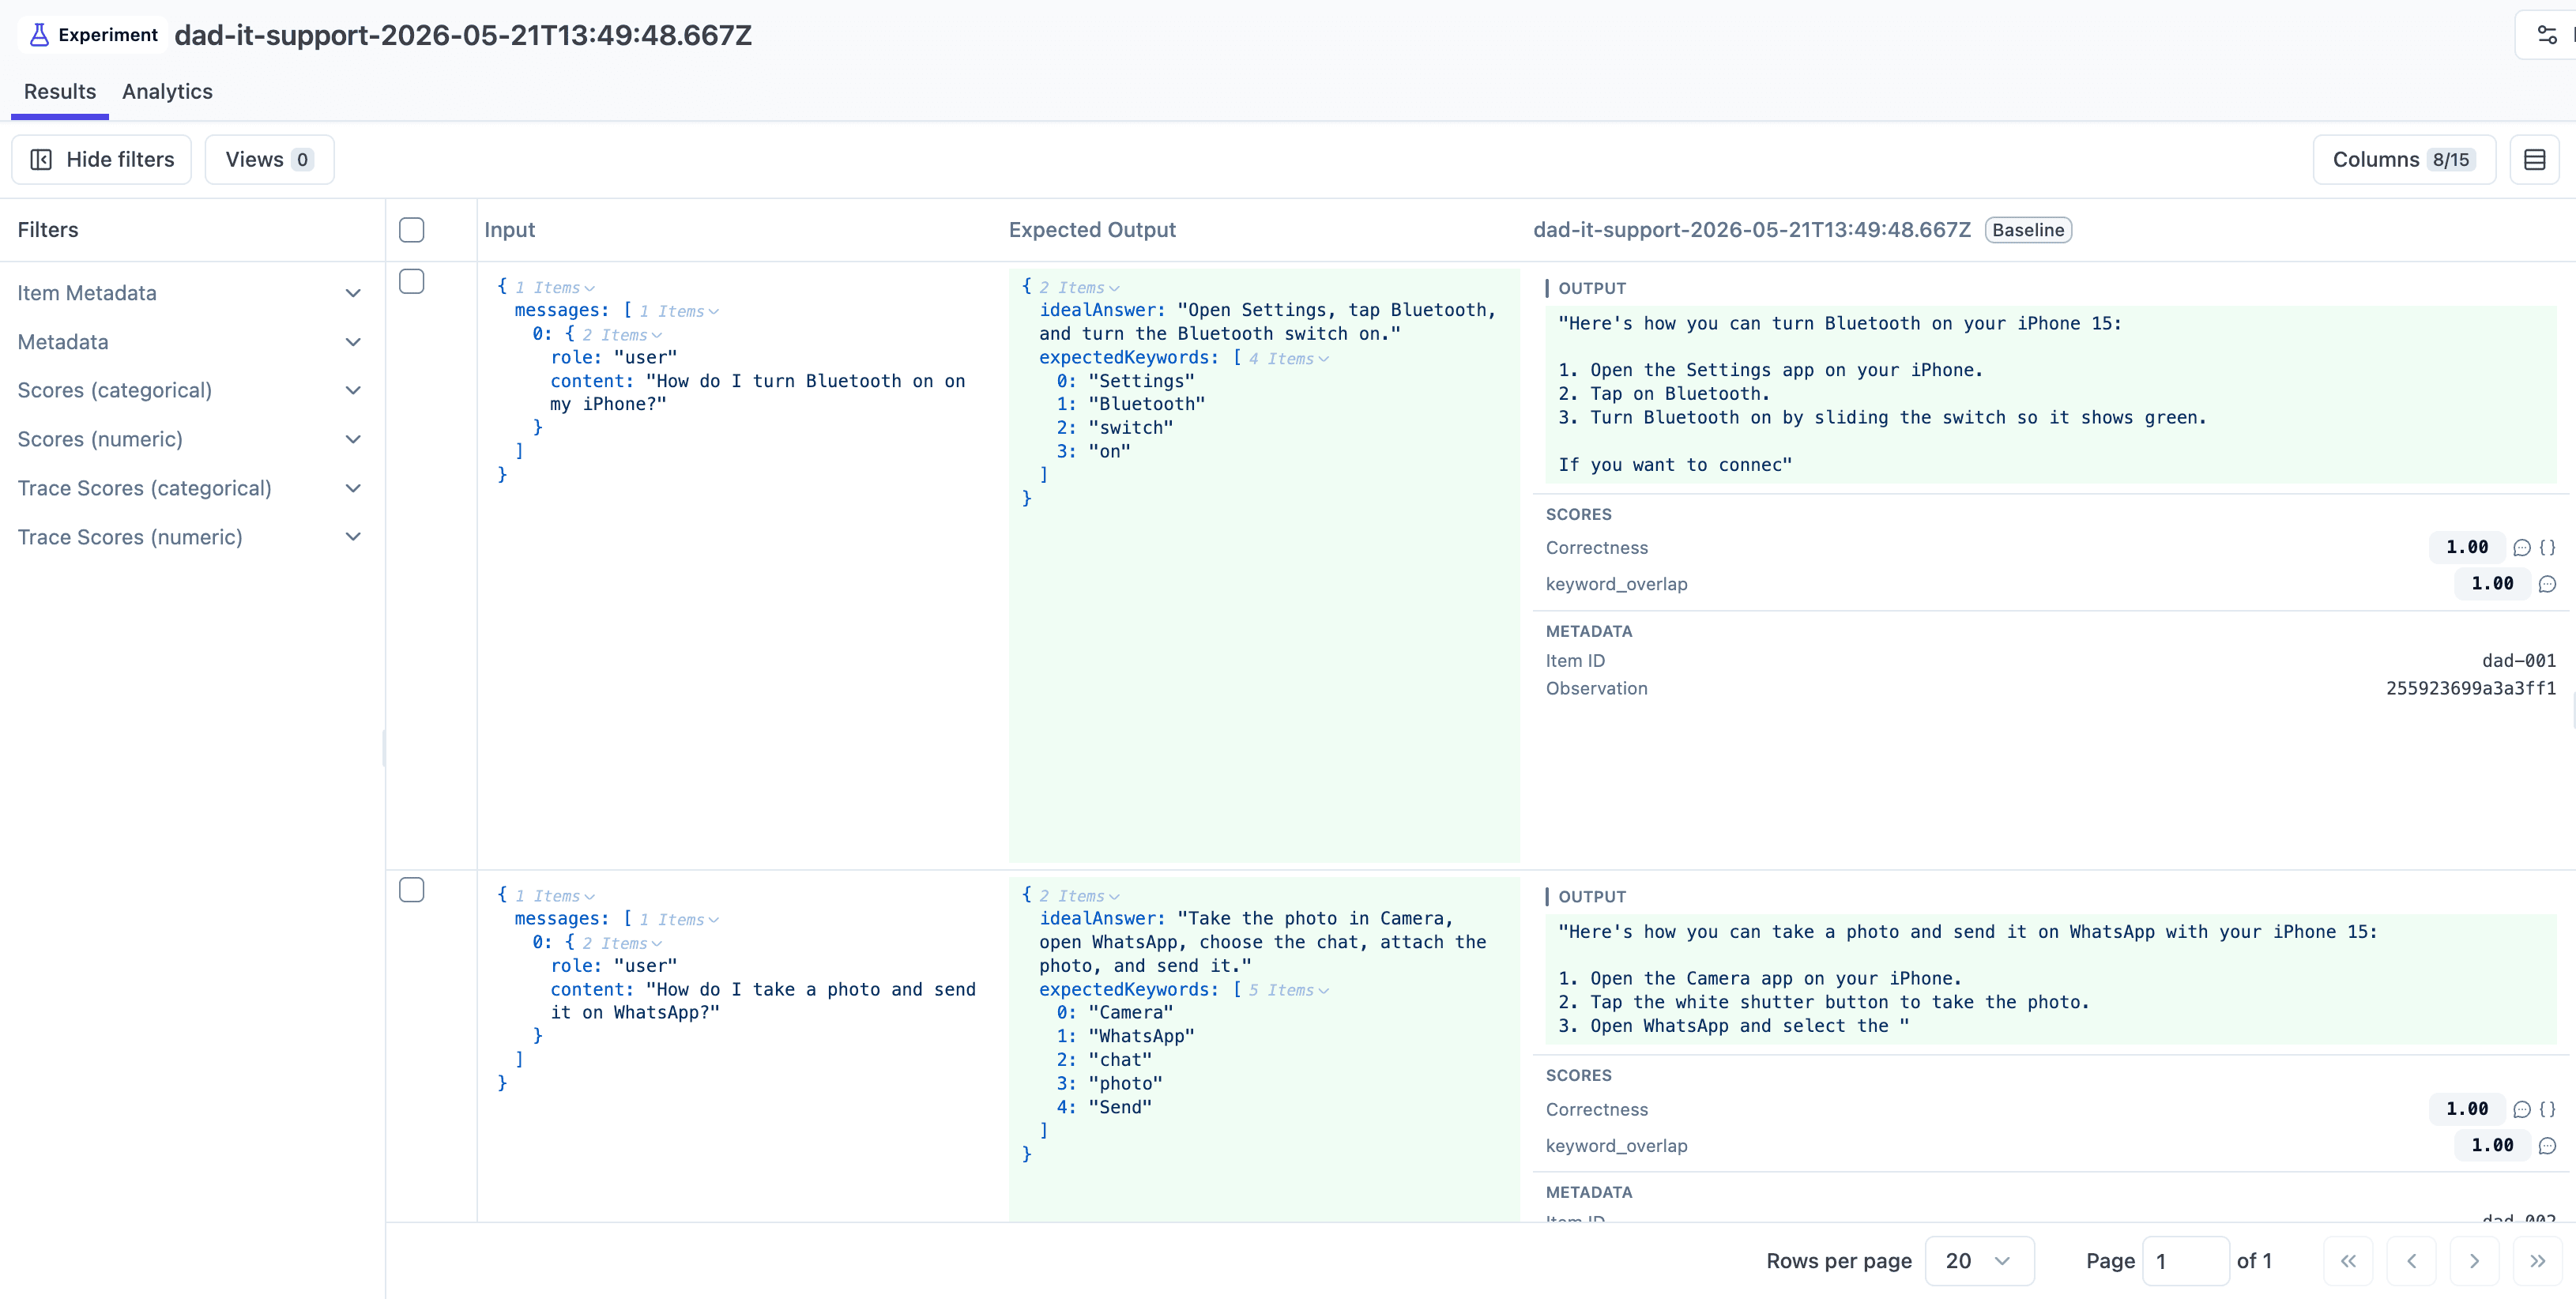
- 데이터셋 아래의 새로운 실행 — 항목당 한 행이며 두 점수:
keyword_overlap과correctness, 그리고 트레이스 링크가 있습니다. - 항목 수준 트레이스 — 프로덕션 트레이스와 동일한 형태입니다.
- 데이터셋의 차트 보기 → 실행별 평균(둘 다), 향후 변경 후 비교할 준비가 됨.
완료했는지 확인하는 방법
- 데이터셋 아래에 하나의 실행 행이 나타납니다.
- 모든 항목에 트레이스와 두 점수가 첨부되어 있습니다.
- 트레이스 형태는 정상적인 프로덕션 트레이스와 일치합니다.
마무리
두 채점 접근 방식은 동일한 실행에 대해 두 가지 각도를 제공합니다: 키워드 일치 "올바른 단계를 다루었나요?"와 정확성 "답변이 실제로 올바른가요?" 실제 평가 프로그램은 종종 이렇게 결정론적 확인과 판사 기반 확인을 결합합니다.
팀이 Langfuse UI에서 평가자 로직을 선호한다면, 나중에 결정론적 확인을 코드 평가자로 마이그레이션할 수도 있습니다. 코드 평가자 문서가 해당 경로를 다루고, SDK를 통한 실험 문서는 코드 측 설정이 어떻게 맞는지 보여줍니다.
Langfuse 스킬(/langfuse)는 권장 평가자 형태와 설정 패턴을 알고 있습니다 — 이 연습은 스킬이 무엇을 하고 있는지 보기 위해 존재합니다. Langfuse Academy 강의에서 실험에 대해 더 알아보세요.
최종 상태
이는 07-evaluation의 시작점입니다.