06 การทดลอง
ชุดข้อมูลของคุณปลูกไว้ใน Langfuse scripts/run-dataset.ts มีอยู่ในที่เก็บแล้ว
วัสดุการอบรมได้รับการบำรุงรักษาในที่เก็บ langfuse/langfuse-workshop สาธารณะ ใช้ที่เก็บสำหรับแอปที่สามารถรันได้ สาขาจุดเช็คพอยต์ และการตั้งค่าระดับท้องถิ่น
จุดเริ่มต้น
git checkout checkpoint/06-experimentsชุดข้อมูลของคุณปลูกไว้ใน Langfuse scripts/run-dataset.ts มีอยู่ในที่เก็บแล้ว
เหตุใดถึงการทดลอง
ร่องรอยบอกคุณเกี่ยวกับพฤติกรรม หนึ่ง การเปลี่ยนแปลง การทดลองบอกคุณเกี่ยวกับพฤติกรรม ข้ามชุดข้อมูล การรันการทดลองทุกครั้งทำสามสิ่งเดียวกัน:
- ดึงรายการแต่ละรายการจากชุดข้อมูล
- รันอินพุตของรายการผ่านเอเจนต์ —
runSupportConversation(...)เดียวกันที่เว็บแอปใช้ เพื่อให้รูปแบบร่องรอยเหมือนกับการใช้งานจริง - ให้คะแนนเอาต์พุตจริงกับเอาต์พุตที่คาดหวัง ด้วยตัวประเมินผลหนึ่งตัวหรือมากกว่า
ตัวประเมินผลที่แตกต่างกันตอบคำถามที่แตกต่างกัน สำหรับทัวร์ที่กว้างขึ้นเกี่ยวกับประเภทตัวประเมินผลและเวลาในการเลือกประเภทใด ให้ดูบทเรียน Langfuse Academy เกี่ยวกับการประเมิน สำหรับการอบรมนี้เราใช้สองอย่างที่ให้การอ่านครั้งแรกอย่างรวดเร็ว:
keyword_overlap(กำหนด) — คำตอบครอบคลุมขั้นตอนที่เราคาดหวังหรือไม่? เร็ว ราคาถูก และคำนวณโดยตรงในสคริปต์การทดลองcorrectness(LLM-as-a-judge) — คำตอบนั้นถูกต้องจริง ๆ หรือไม่? ชัดเจนยิ่งขึ้น โดยเฉพาะอย่างยิ่งเมื่อการเขียนสามารถแตกต่างกันได้ แต่คำตอบพื้นฐานต้องตรงกับอุดมคติ
บทนี้ใช้การตั้งค่าแบบผสมตั้งแต่แรก: การตรวจสอบแบบกำหนดราคาถูกอยู่ในโค้ดถัดจากการรันการทดลอง ในขณะที่ผู้พิพากษาทางความหมายอยู่ใน Langfuse
เป้าหมาย
เมื่อสิ้นสุดบทนี้:
- คุณสามารถรันชุดข้อมูลเต็มกับเอเจนต์ตามต้องการ
- รายการทุกรายการได้รับคะแนน
keyword_overlap(กำหนด) และคะแนนcorrectness(LLM-as-a-judge) - คะแนนทั้งสองพร้อมร่องรอยต่อรายการมองเห็นได้ใน Langfuse และพร้อมสำหรับการเปรียบเทียบกับการรันในอนาคต
ขั้นตอนที่ 1 — ทำความเข้าใจสคริปต์การรัน
เปิด scripts/run-dataset.ts ไฟล์ถูกอธิบายด้วยความเห็นที่มีหมายเลข (// --- 1. Boot the OpenTelemetry SDK ..., // --- 3. The deterministic evaluator ... เป็นต้น) เพื่อให้คุณสามารถอ่านมันทีละส่วน ในระดับสูง:
- โหลดชุดข้อมูลที่โฮสต์จาก Langfuse โดย
DATASET_NAME - สำหรับรายการแต่ละรายการ เรียก
runSupportConversation(...)เดียวกันที่เว็บแอปใช้ - ใช้
dataset.runExperiment(...)เพื่อม้วนร่องรอยต่อรายการทั้งหมดเป็นแถวการรันเดียว - แนบคะแนน
keyword_overlapต่อรายการโดยเปรียบเทียบexpectedKeywordsกับคำตอบของเอเจนต์
ร่องรอยที่ผลิตมีรูปแบบเดียวกับร่องรอยการใช้งานจริง — ราก dad-it-support-chat-turn เดียวกัน รุ่น OpenAI ช่วง เครื่องมือ ช่วง เราไม่ต้องการการตั้งค่า UI พิเศษสำหรับคะแนนที่กำหนดเพราะมันอยู่ในสคริปต์แล้ว
dataset.runExperiment(...) — ชิ้นส่วนที่เคลื่อนที่
การรันทั้งหมดคือการเรียกใหม่ runExperiment ก็เท่านั้น รูปแบบลดลงไป:
await dataset.runExperiment({
  name: "Dad IT Support Agent experiment",
  runName,           // unique label for this run; shows up in the Runs tab
  description: "...",
  metadata: { model: env.openaiModel },
  maxConcurrency: 1, // run items one at a time

  task: async (item) => {
    const response = await runSupportConversation({ /* item.input */ });
    return response.answer;
  },

  evaluators: [
    async ({ output, expectedOutput }) => ({
      name: "keyword_overlap",
      value: keywordOverlap(output as string, (expectedOutput as any).expectedKeywords),
      comment: "..."
    })
  ]
});
สามสิ่งที่ต้องเข้าใจ:
taskคือ ตรรมชาติของแอปพลิเคชันของคุณ — เราเรียกตรงเข้าrunSupportConversation(...)ซึ่งหมายความว่ารายการร่องรอยทุกรายการที่สคริปต์นี้ผลิตเหมือนกับร่องรอยการใช้งานจริงevaluatorsคือรายการ ตัวประเมินผลแต่ละรายการทำงานหลังจากtaskส่งคืนและแนบคะแนนไปยังร่องรอยรายการ ที่นี่เราใช้ตัวประเมินผลที่กำหนดรายการเดียว แต่คุณสามารถเพิ่มเติมเมื่อเวลาผ่านไปrunNameจัดกลุ่มร่องรอยต่อรายการทั้งหมดเป็นแถวเดียวในมุมมองการรัน Langfuse เลือกชื่อที่เปลี่ยนต่อการรัน (เราใส่ตราเวลา) เพื่อไม่ให้การรันสองครั้งชนกัน
ขั้นตอนที่ 2 — ตรวจสอบตัวประเมินผล keyword_overlap ที่กำหนด
ภายใน scripts/run-dataset.ts ฟังก์ชันตัวช่วยค้นหา expectedKeywords ของรายการชุดข้อมูลภายในคำตอบรุ่นและส่งกลับเศษส่วนที่ตรงกัน
ทำไมต้องเก็บไว้ในสคริปต์?
- ง่ายต่อการอ่านที่มีรหัสการทดลองที่เหลือ
- ใช้การควบคุมเวอร์ชันและการไหลการตรวจสอบเดียวกับแอป
- เป็นกำหนด ดังนั้นจึงไม่มีเหตุผลที่จะใช้การเรียก LLM บนนั้น
นี่ยังเป็นรูปแบบค่าเริ่มต้นที่ดีสำหรับทีมที่ต้องการให้ตรรมชาติการทดลองอยู่ในที่เก็บ
ทางเลือก: การตรวจสอบแบบกำหนดเดียวกันนี้ยังสามารถย้ายเข้าไปในตัวประเมินผลรหัส Langfuse หากคุณต้องการจัดการมันในแพลตฟอร์มแทนที่จะอยู่ในสคริปต์ ดูเอกสาร ตัวประเมินผลรหัส และ การทดลองผ่าน SDK
ขั้นตอนที่ 3 — ตั้งค่าตัวประเมินผล correctness ใน Langfuse
Langfuse ส่งมีเทมเพลต ความถูกต้อง LLM-as-a-judge ที่เปรียบเทียบคำตอบจริงกับคำตอบในอุดมคติและส่งกลับคะแนน เราเชื่อมมันกับการรันชุดข้อมูลเพื่อให้รายการแต่ละรายการได้รับคะแนนกำหนดในท้องถิ่นและคะแนนตัดสินความถูกต้องในรูปแบบจำลองที่ปรากฏในมุมมองการเปรียบเทียบการรัน
ตรวจสอบโครงการสดใหม่: ความถูกต้องคือตัวประเมินผล LLM-as-a-judge หากคุณไม่ได้กำหนดค่าแบบจำลองการประเมินค่าเริ่มต้นในเซสชัน 4 ให้ทำเดี๋ยวนี้: เปิด การตั้งค่าโครงการ → การเชื่อมต่อ LLM และเพิ่มคีย OpenAI ของคุณ รูปแบบนั้นเองตั้งค่าระหว่างการสร้างตัวประเมินผล — วิซาร์ด ตั้งค่าตัวประเมินผล ขอสำหรับมันในขั้นตอน การเชื่อมต่อ LLM การตั้งค่า เลือกแบบจำลองที่มีความสามารถในการส่งออกโครงสร้างเช่น
openai / gpt-4.1เมื่อตั้งค่าแล้ว มันจะปรากฏเป็น แบบจำลองเริ่มต้น ที่ด้านบนของหน้าตัวประเมินผล ที่มีคุณยังสามารถเปลี่ยนแปลงได้ในภายหลัง เก็บคีย API ในเขตข้อมูลลับ Langfuse เท่านั้น อย่าวางมันในวิถีการอบรมที่ใช้ร่วมกันหรือบันทึกย่อ
-
ใน Langfuse เปิด ตัวประเมินผล → ตั้งค่าตัวประเมินผล และเลือก ความถูกต้อง จากรายการ ใช้ที่มีอยู่ (ตัวประเมินผลที่จัดการโดย Langfuse)
-
กำหนดเป้าหมายการรันจากชุดข้อมูลนี้:
- รันบน: การทดลอง (UI มักเปิดการสังเกต ดังนั้นให้สลับไปตรวจสอบก่อน)
- ตัวกรองที่: ชุดข้อมูลเป็น 'dad-it-support-workshop'
-
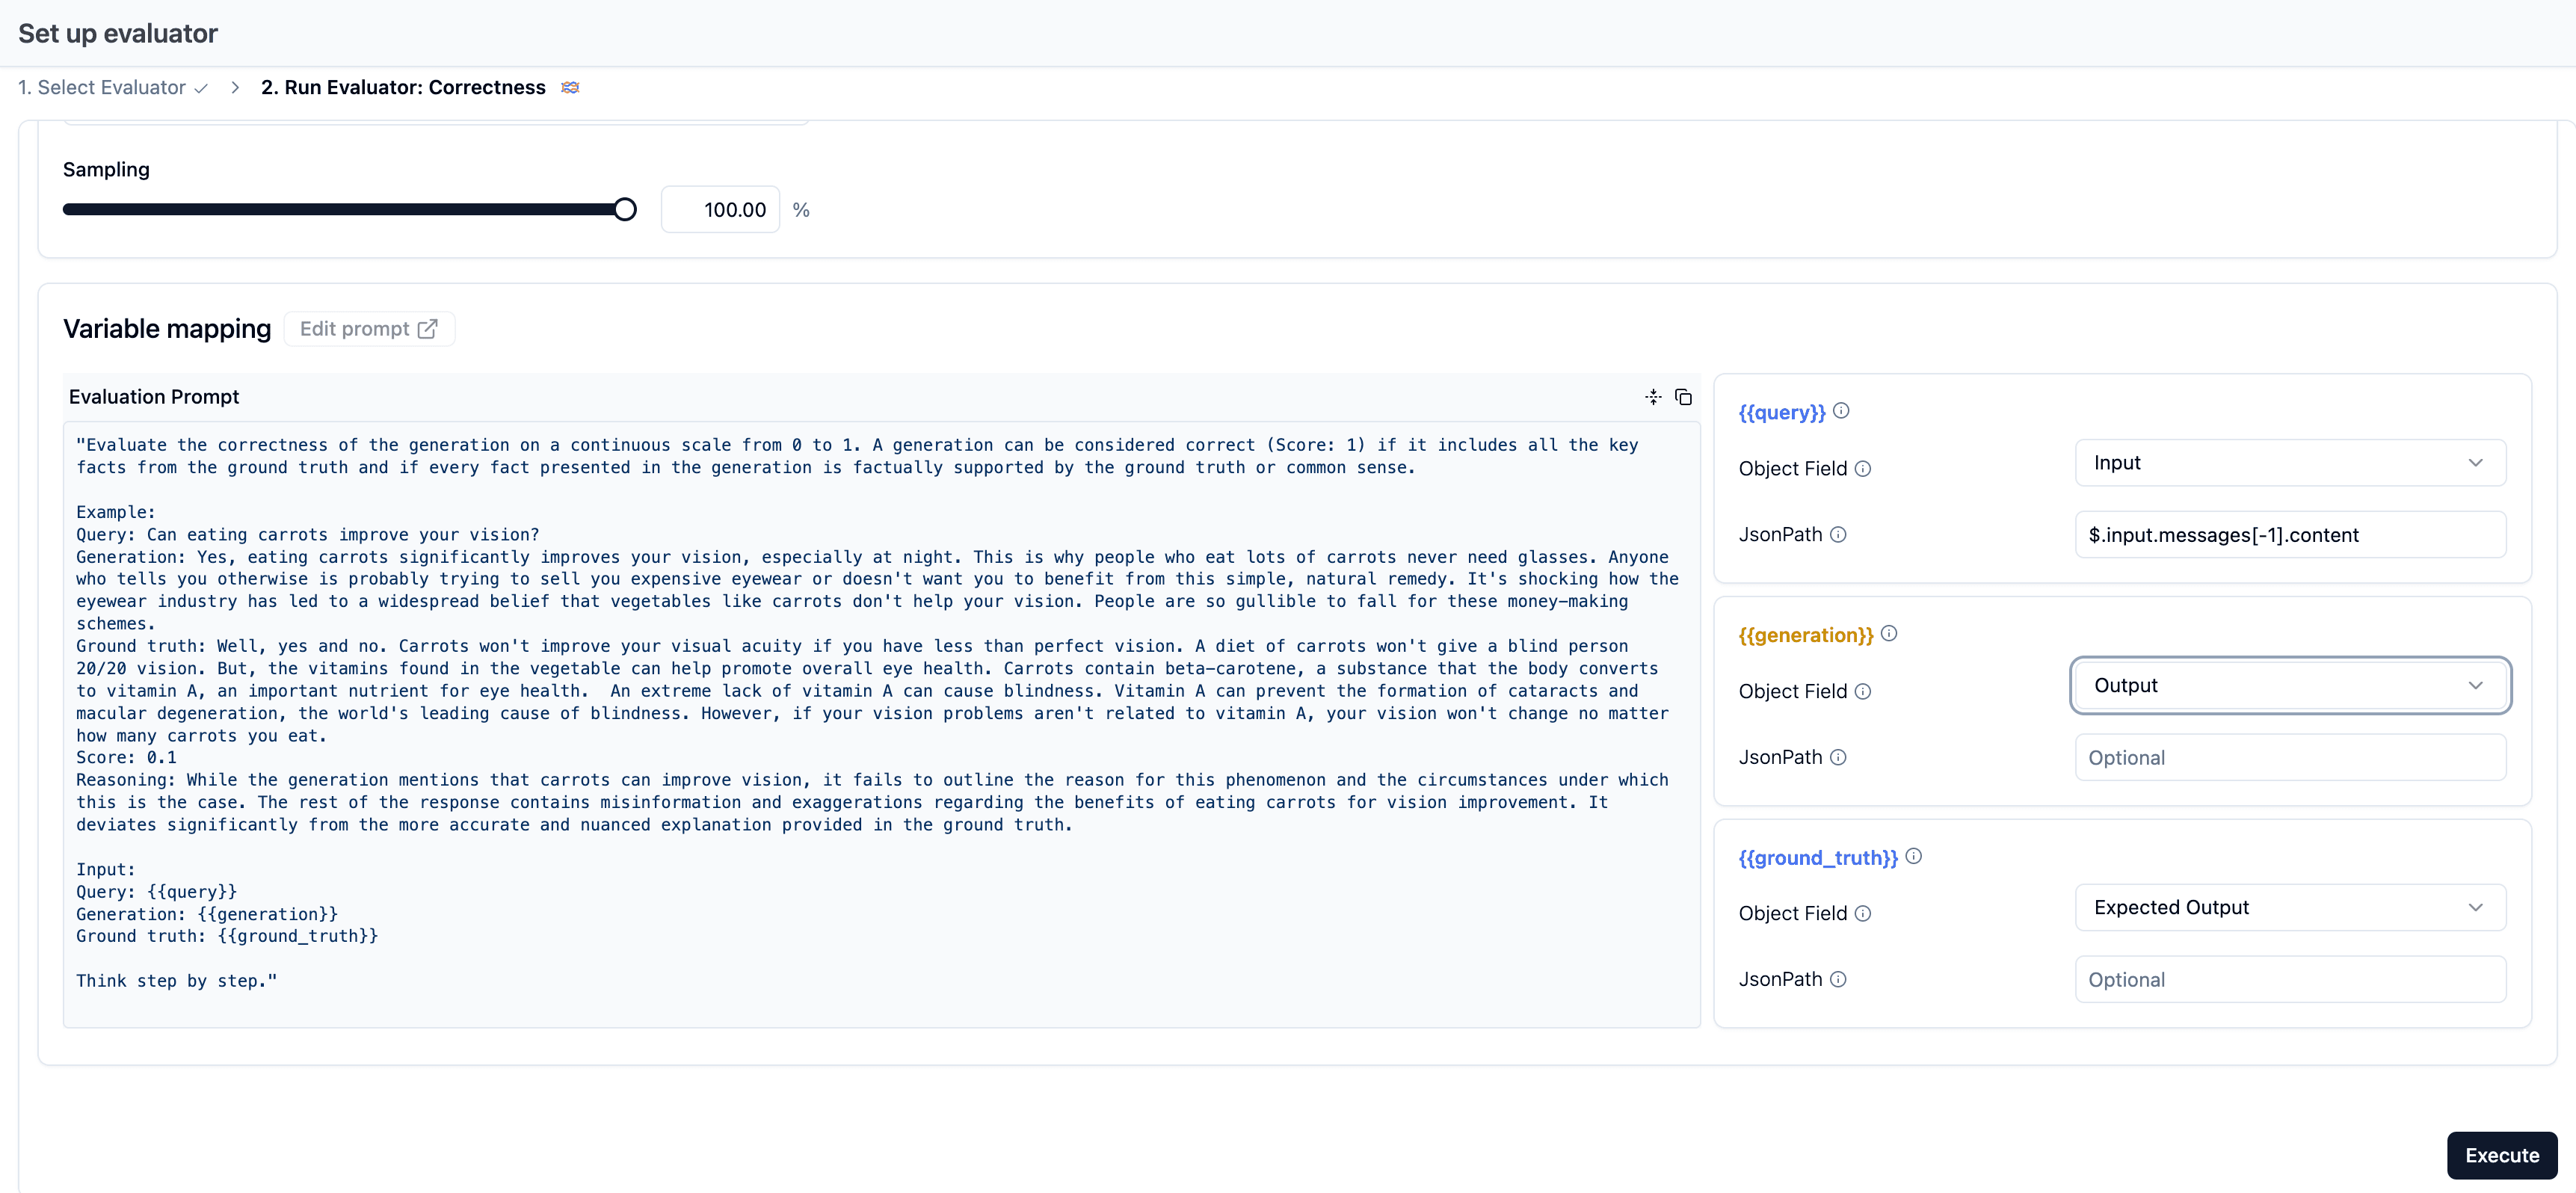
แม็ปตัวแปรเทมเพลต ใน UI ตั้งค่าดรอปดาวน์ แหล่ง ก่อน จากนั้นเพิ่มเฉพาะ JsonPath ที่จำเป็น:
ตัวแปร ฟิลด์วัตถุ JsonPath queryอินพุต $.messages[-1].contentgenerationเอาต์พุต ปล่อยว่าง ground_truthเอาต์พุตที่คาดหวัง $.idealAnswerการตั้งค่าที่ทำลายทั่วไปคือการปล่อยทั้งสามตัวแปรบน อินพุต เพราะดรอปดาวน์นั้นปรากฏขึ้นก่อน ถ้า
generationหรือground_truthชี้ไป อินพุต ตัวประเมินผลอ่านข้อมูลที่ผิดสำหรับการรันทุกครั้ง -
ใช้แบบจำลองผู้พิพากษ์ที่คุณกำหนดค่าในเซสชัน 4 หรือในตรวจสอบโครงการสดใหม่ข้างบน หรือเลือกแบบจำลองผู้พิพากษ์ที่มีความสามารถในการส่งออกโครงสร้างอื่น และบันทึก
-
เปิดใช้งานตัวประเมินผล
หากนี่คือการทดลองครั้งแรกของคุณ ตารางการตรวจสอบหรือแสดงตัวอย่างพรอมต์อาจยังคงพูด ไม่มีผลลัพธ์ หรือ ไม่พบข้อมูลร่องรอย ในเวลาตั้งค่า ที่คาดไว้ คุณยังไม่ได้สร้างการรันการทดลองใด ๆ ดังนั้นจึงไม่มีอะไรสำหรับ Langfuse ที่จะแสดงตัวอย่างกับ บันทึกตัวประเมินผลเดี๋ยวนี้ หลังจากขั้นตอนที่ 4 สร้างการรันครั้งแรก ตัวประเมินผลความถูกต้องจะให้คะแนนรายการการทดลองใหม่อย่างอะซิงโครนัสในไม่ช้า
ทำไมต้องรันบน การทดลอง ที่นี่? เพราะสำหรับการอบรมนี้เราต้องการให้ correctness ปรากฏบนแถวการรันการทดลองและในมุมมองการเปรียบเทียบการรัน
ขั้นตอนที่ 4 — รันชุดข้อมูล
npm run dataset:runสคริปต์สิ้นสุดโดยพิมพ์บทสรุปการรันที่จัดรูปแบบในคอนโซล ร่องรอยระดับรายการและคะแนนปรากฏใน Langfuse เมื่อการรันดำเนินการ และตัวประเมินผลความถูกต้องอาจยังคงเติมคะแนนสำหรับเวลาสั้น ๆ เพราะมันทำงานอย่างอะซิงโครนัส
สคริปต์แนบ keyword_overlap ตัวเอง ตัวประเมินผลความถูกต้องที่คุณตั้งค่าในขั้นตอนที่ 3 ทำงานอย่างอะซิงโครนัสใน Langfuse บนแถวการรันใหม่เร็ว ๆ นี้
สิ่งที่ต้องตรวจสอบใน Langfuse
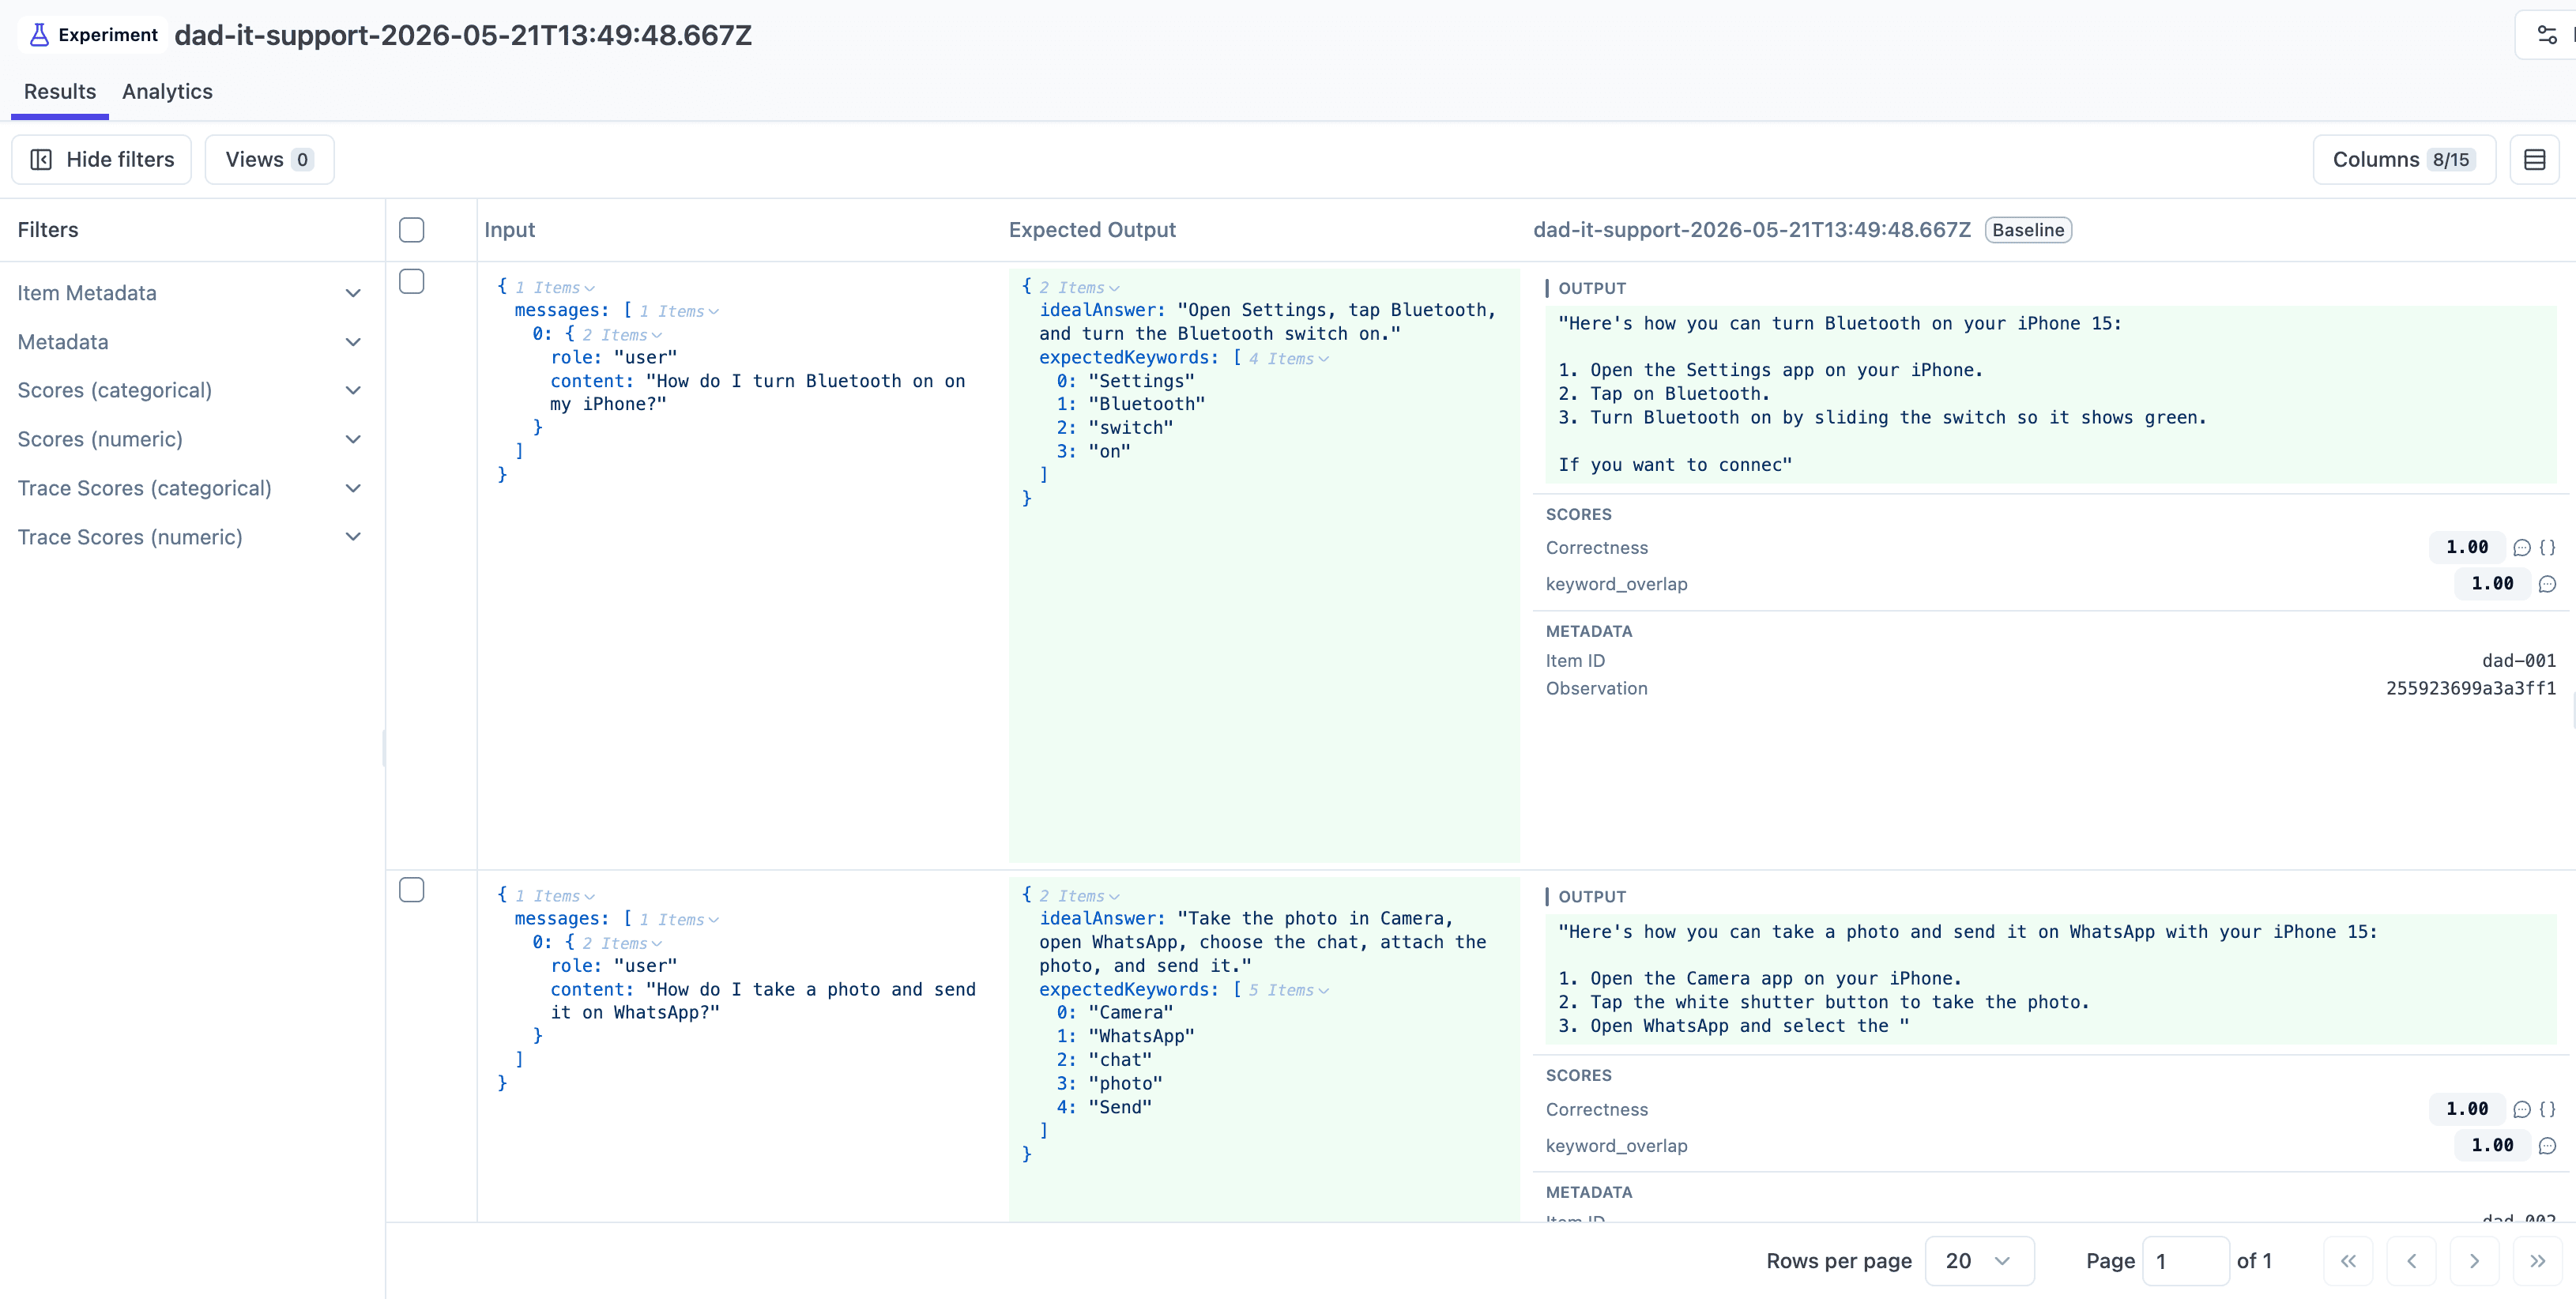
- การรัน ใหม่ ภายใต้ชุดข้อมูลของคุณ — แถวหนึ่งต่อรายการที่มี สอง คะแนน:
keyword_overlapและcorrectnessบวกลิงก์ร่องรอย - ร่องรอยระดับรายการ — รูปแบบเดียวกับร่องรอยการใช้งานจริง
- มุมมองแผนภูมิ ของชุดข้อมูล → เฉลี่ยต่อการรันสำหรับคะแนนทั้งสอง พร้อมสำหรับการเปรียบเทียบแบบเคียงข้างหลังการเปลี่ยนแปลงในอนาคต
วิธีตรวจสอบว่าคุณเสร็จสิ้นแล้ว
- แถวการรันหนึ่งแถวปรากฏภายใต้ชุดข้อมูล
- รายการแต่ละรายการมีร่องรอยและคะแนนทั้งสองแนบ
- รูปแบบร่องรอยตรงกับร่องรอยการใช้งานจริงปกติ
ห่อ
สองแนวทางการให้คะแนนให้คุณสองมุมมองบนการรันเดียวกัน: การจับคู่คำสำคัญ สำหรับ "เราครอบคลุมขั้นตอนที่ถูกต้องหรือไม่?" และ ความถูกต้อง สำหรับ "คำตอบนั้นถูกต้องจริง ๆ หรือไม่?" โปรแกรมการประเมินค่าจริงมักรวมการตรวจสอบแบบกำหนดและอิงตามผู้พิพากษาเช่นนี้
หากทีมของคุณชอบตรรมชาติการทดลองที่เพิ่มขึ้นใน UI Langfuse การตรวจสอบแบบกำหนดยังสามารถย้ายเข้าไปในตัวประเมินผลรหัสในภายหลัง เอกสาร ตัวประเมินผลรหัส ครอบคลุมเส้นทางนั้น และ การทดลองผ่าน SDK แสดงวิธีการตั้งค่าด้านรหัสพอดี
ทักษะ Langfuse (/langfuse) รู้รูปแบบตัวประเมินผลที่แนะนำและรูปแบบการตั้งค่า — การเดินนี้มีอยู่เพื่อให้คุณเห็นว่าทักษะทำอะไรอยู่เบื้องหลัง เรียนรู้เพิ่มเติมเกี่ยวกับการทดลองในบทเรียน Langfuse Academy
สถานะการสิ้นสุด
นี่คือจุดเริ่มต้นสำหรับ 07-evaluation
05 ชุดข้อมูล
คุณมีแอปที่ติดตาม กำหนดคุณลักษณะ และมีการตรวจสอบได้ data/seed-dataset.json และ scripts/seed-dataset.ts มีอยู่ในที่เก็บที่จุดเช็คพอยต์นี้แล้ว
07 ประเมินการเปลี่ยนแปลง
แอปของคุณติดตาม มีการตรวจสอบ มีชุดข้อมูลที่โฮสต์ และมีการรันการทดลองอย่างน้อยหนึ่งครั้งพร้อมคะแนนความพึงพอใจและความถูกต้องทั้งสองคะแนน ตอนนี้คุณสร้างการเปลี่ยนแปลงในแอปและรันการทดลองอีกครั้ง ...