06 Eksperimen
Dataset Anda ditabur di Langfuse. scripts/run-dataset.ts sudah ada di repo.
Materi workshop dikelola di repositori publik langfuse/langfuse-workshop. Gunakan repositori untuk aplikasi yang dapat dijalankan, cabang checkpoint, dan setup lokal.
Titik awal
git checkout checkpoint/06-experimentsDataset Anda ditabur di Langfuse. scripts/run-dataset.ts sudah ada di repo.
Mengapa eksperimen
Jejak memberi tahu Anda tentang satu giliran. Eksperimen memberi tahu Anda tentang perilaku di seluruh dataset. Setiap jalankan eksperimen melakukan tiga hal yang sama:
- Menarik setiap item dari dataset.
- Menjalankan masukan item melalui agen —
runSupportConversation(...)yang sama yang digunakan aplikasi web, jadi bentuk jejak sama dengan produksi. - Mencetak keluaran aktual terhadap keluaran yang diharapkan dengan satu atau lebih evaluator.
Evaluator yang berbeda menjawab pertanyaan berbeda. Untuk tur evaluator yang lebih luas dan kapan memilih mana, lihat pelajaran Akademi Langfuse tentang evaluasi. Untuk workshop ini kami menggunakan dua yang memberikan bacaan cepat pertama pada kualitas jawaban:
keyword_overlap(deterministik) — apakah jawaban mencakup langkah-langkah yang kami harapkan? Cepat, murah, dan dihitung langsung dalam skrip eksperimen.correctness(judge berbasis LLM) — apakah jawaban benar-benar benar? Lebih ekspresif, terutama ketika redaksian dapat bervariasi tetapi jawaban mendasar harus cocok dengan ideal.
Bab ini menggunakan pengaturan campuran dengan sengaja: pemeriksaan deterministik murah hidup dalam kode tepat di sebelah pelari eksperimen, sementara judge semantik hidup di Langfuse.
Tujuan
Dengan akhir bab ini:
- Anda dapat menjalankan dataset lengkap melawan agen sesuai permintaan.
- Setiap item mendapat skor
keyword_overlap(deterministik) dan skorcorrectness(judge berbasis LLM). - Dua skor ditambah jejak per-item terlihat di Langfuse dan siap dibandingkan dengan jalankan di masa depan.
Langkah 1 — Pahami skrip jalankan
Buka scripts/run-dataset.ts. File ini dijelaskan dengan komentar bernomor (// --- 1. Boot the OpenTelemetry SDK ..., // --- 3. The deterministic evaluator ..., dll.) sehingga Anda dapat membacanya bagian demi bagian. Pada tingkat tinggi:
- Memuat dataset yang dihosting dari Langfuse oleh
DATASET_NAME. - Untuk setiap item, memanggil
runSupportConversation(...)yang sama yang digunakan aplikasi web. - Menggunakan
dataset.runExperiment(...)untuk menggulung semua jejak per-item ke dalam satu baris jalankan. - Melampirkan skor
keyword_overlapper item dengan membandingkanexpectedKeywordsterhadap jawaban agen.
Jejak yang dihasilkan adalah bentuk yang sama dengan jejak produksi — akar dad-it-support-chat-turn yang sama, generasi OpenAI yang sama, span alat yang sama. Kami tidak memerlukan pengaturan UI ekstra untuk skor deterministik karena itu sudah hidup dalam skrip.
dataset.runExperiment(...) — bagian yang bergerak
Seluruh jalankan adalah satu panggilan ke runExperiment. Bentuknya menyusut menjadi:
await dataset.runExperiment({
  name: "Dad IT Support Agent experiment",
  runName,           // unique label for this run; shows up in the Runs tab
  description: "...",
  metadata: { model: env.openaiModel },
  maxConcurrency: 1, // run items one at a time

  task: async (item) => {
    const response = await runSupportConversation({ /* item.input */ });
    return response.answer;
  },

  evaluators: [
    async ({ output, expectedOutput }) => ({
      name: "keyword_overlap",
      value: keywordOverlap(output as string, (expectedOutput as any).expectedKeywords),
      comment: "..."
    })
  ]
});
Tiga hal untuk dipahami:
taskadalah logika aplikasi Anda — kami memanggil langsung kerunSupportConversation(...), yang berarti setiap jejak yang dihasilkan skrip ini terlihat identik dengan jejak produksi.evaluatorsadalah daftar. Setiap evaluator berjalan setelahtaskkembali dan melampirkan skor ke jejak item. Di sini kami menggunakan satu evaluator deterministik, tetapi Anda dapat menambahkan lebih banyak seiring waktu.runNamemengelompokkan setiap jejak per-item ke dalam satu baris dalam tampilan Langfuse Runs. Pilih nama yang berubah per jalankan (kami sertakan stempel waktu) sehingga dua jalankan tidak bertabrakan.
Langkah 2 — Tinjau evaluator keyword_overlap deterministik
Di dalam scripts/run-dataset.ts, fungsi pembantu mencari expectedKeywords item dataset di dalam jawaban model dan mengembalikan fraksi yang cocok.
Mengapa menyimpannya dalam skrip?
- Mudah dibaca bersama sisa kode eksperimen.
- Menggunakan aliran review dan kontrol versi yang sama dengan aplikasi.
- Itu deterministik, jadi tidak ada alasan menghabiskan panggilan LLM di atasnya.
Ini juga merupakan pola default yang baik untuk tim yang ingin logika eksperimen tetap di repositori.
Alternatif: pemeriksaan deterministik yang sama ini juga dapat dipindahkan ke evaluator kode Langfuse jika Anda ingin mengelolanya di platform sebagai gantinya dari dalam skrip. Lihat dokumen evaluator Kode dan dokumen Eksperimen via SDK.
Langkah 3 — Atur evaluator correctness di Langfuse
Langfuse mengirim template judge berbasis LLM Correctness yang membandingkan jawaban aktual dengan jawaban ideal dan mengembalikan skor. Kami menyatukannya terhadap jalankan dataset sehingga setiap item mendapat skor deterministik lokal dan skor kebenaran yang dievaluasi model yang muncul dalam tampilan perbandingan jalankan.
Pemeriksaan proyek segar: Correctness adalah evaluator judge berbasis LLM. Jika Anda tidak mengonfigurasi model evaluasi default di sesi 4, lakukan sekarang: buka Project Settings → LLM Connections dan tambahkan kunci OpenAI Anda. Model itu sendiri diatur selama pembuatan evaluator — wizard Set up evaluator meminta langkah Set up LLM connection; pilih model yang mampu output terstruktur seperti
openai / gpt-4.1. Setelah diatur, itu ditampilkan sebagai Default model di bagian atas halaman Evaluators, di mana Anda juga dapat mengubahnya nanti. Simpan kunci API dalam bidang rahasia Langfuse saja; jangan tempel ke dalam transkrip workshop atau catatan bersama.
-
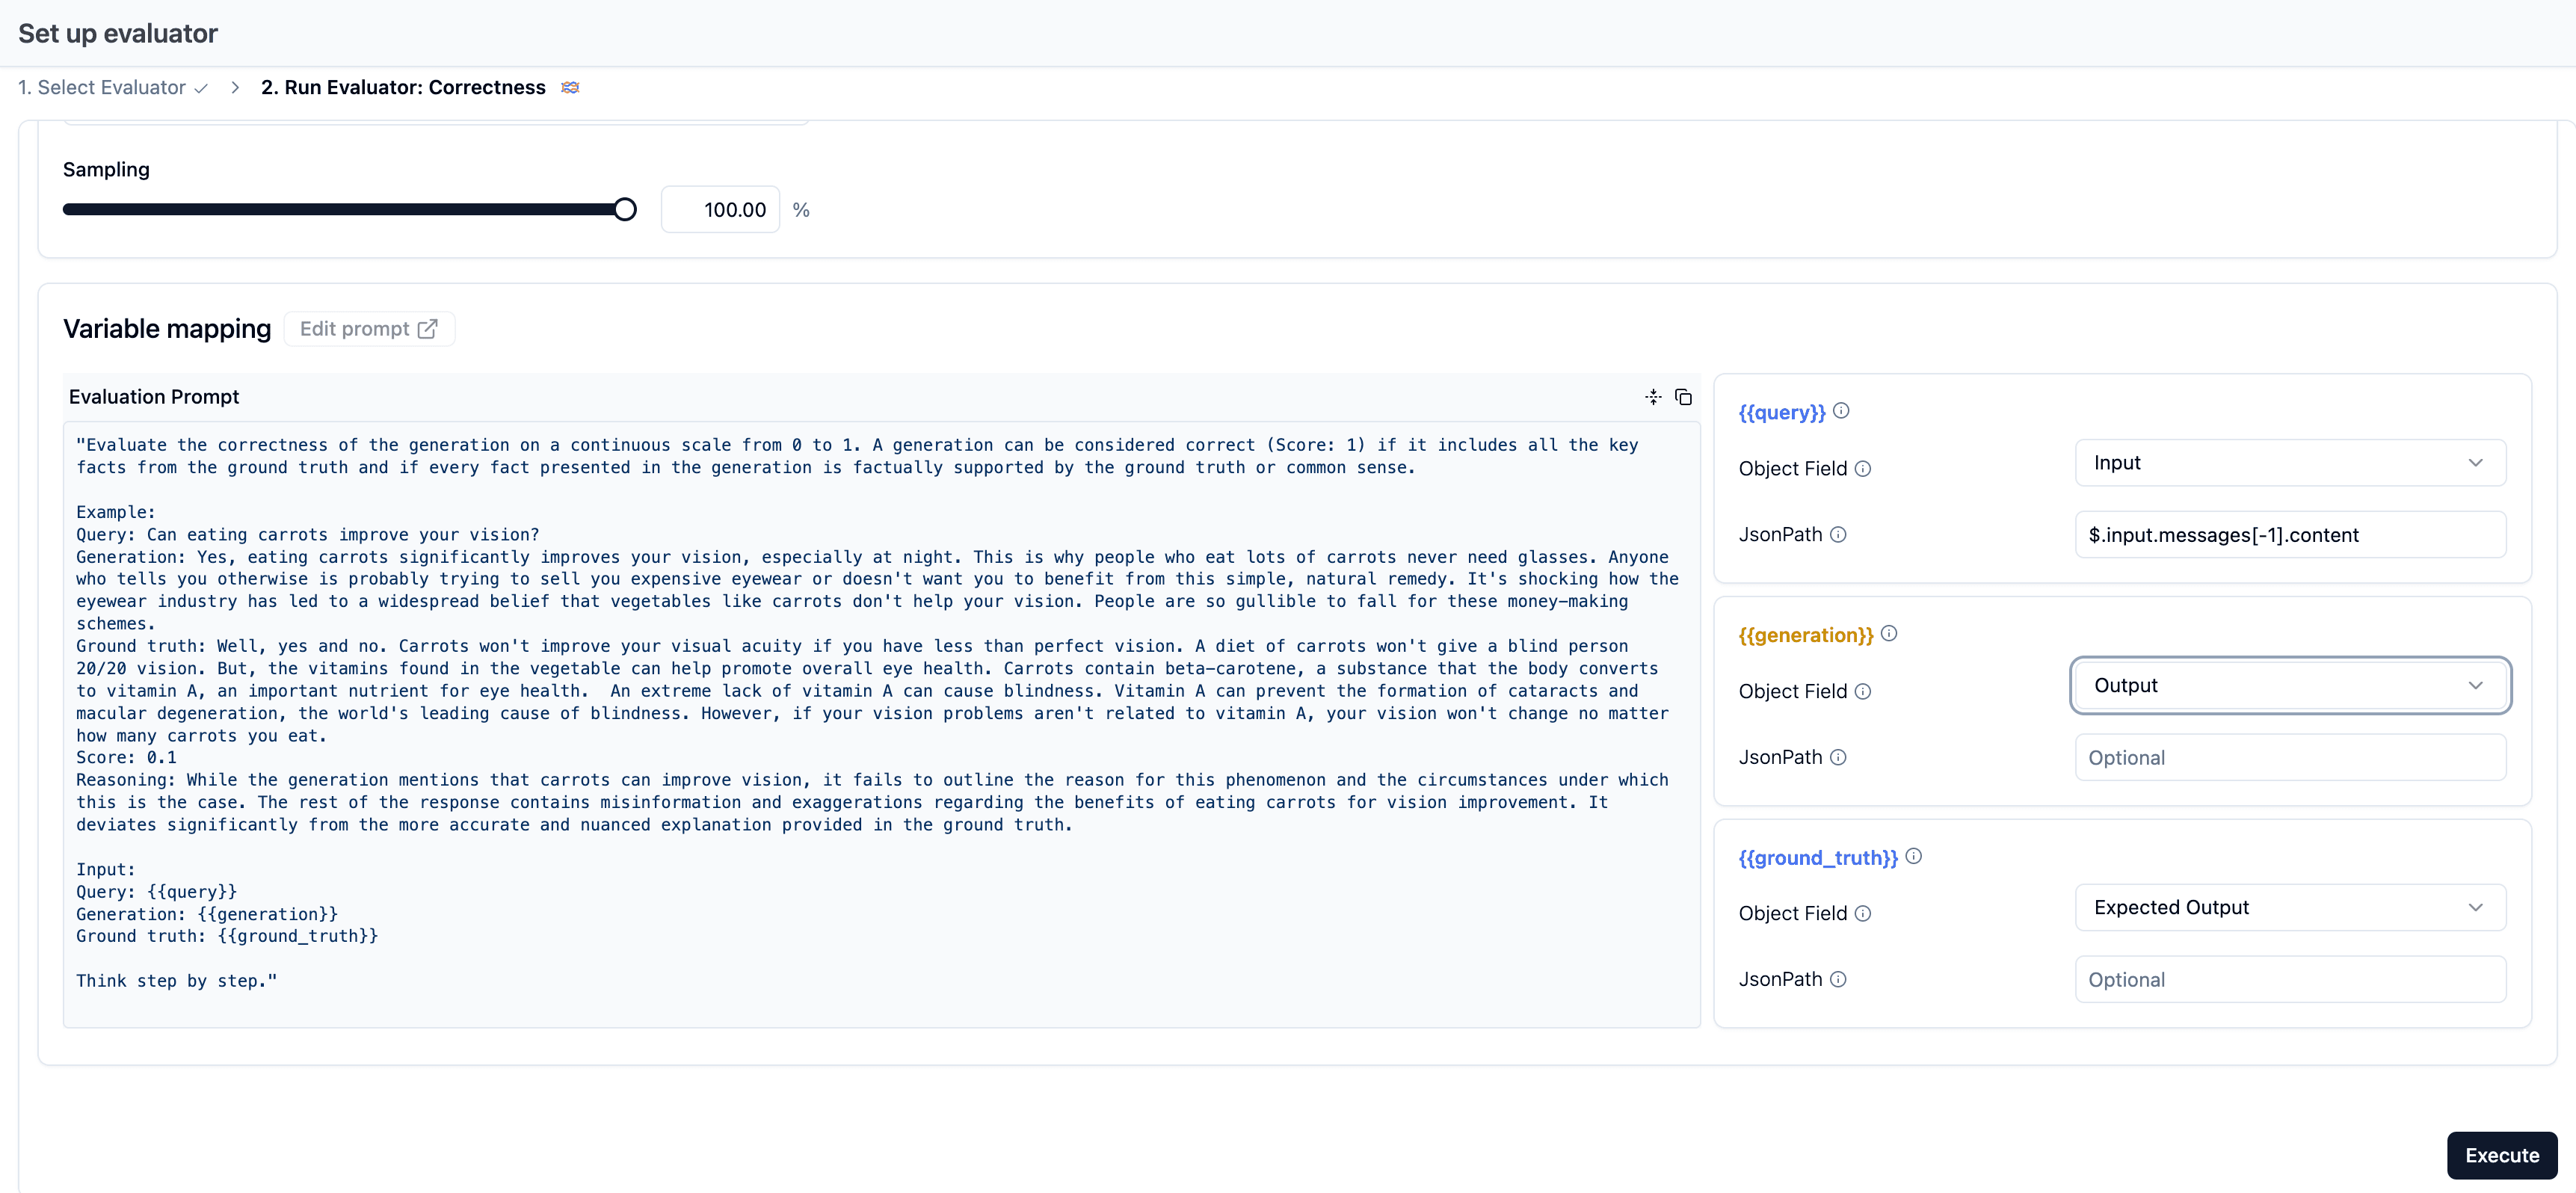
Di Langfuse, buka Evaluators → Set up evaluator dan pilih Correctness dari daftar Use existing (Managed evaluators Langfuse).
-
Target jalankan dari dataset ini:
- Jalankan pada: Experiments (UI sering membuka pada pengamatan, jadi alihkan ini terlebih dahulu)
- Filter di mana: Dataset adalah 'dad-it-support-workshop'
-
Peta variabel template. Di UI, atur dropdown Source terlebih dahulu, kemudian tambahkan JsonPath hanya jika diperlukan:
Variabel Bidang Objek JsonPath queryInput $.messages[-1].contentgenerationOutput Biarkan kosong ground_truthExpected Output $.idealAnswerPengaturan rusak yang umum adalah membiarkan ketiga variabel di Input karena dropdown itu muncul terlebih dahulu. Jika
generationatauground_truthmenunjuk ke Input, evaluator membaca data yang salah untuk setiap jalankan. -
Gunakan model judge default yang Anda konfigurasi di sesi 4 atau dalam pemeriksaan proyek segar di atas, atau pilih model judge mampu output terstruktur lainnya, dan simpan.
-
Aktifkan evaluator.
Jika ini adalah eksperimen pertama Anda, tabel tinjauan atau pratinjau prompt mungkin masih mengatakan No results atau No trace data found pada waktu pengaturan. Itu diharapkan. Anda belum membuat jalankan eksperimen apa pun, jadi tidak ada yang dapat digunakan Langfuse untuk pratinjau. Simpan evaluator sekarang; setelah Langkah 4 membuat jalankan pertama, evaluator ini akan mencetak item eksperimen baru secara asinkron.
Mengapa berjalan di Experiments di sini? Karena untuk workshop ini kami ingin correctness muncul pada baris jalankan eksperimen dan dalam tampilan perbandingan jalankan.
Langkah 4 — Jalankan dataset
npm run dataset:runSkrip selesai dengan mencetak ringkasan jalankan yang diformat dalam konsol. Jejak tingkat item dan skor muncul di Langfuse saat jalankan dijalankan, dan evaluator Correctness dapat melanjutkan mengisi skor untuk waktu yang singkat setelahnya karena berjalan asinkron.
Skrip melampirkan keyword_overlap sendiri. Evaluator Correctness yang Anda atur di Langkah 3 berjalan secara asinkron di Langfuse di atas baris jalankan baru segera setelahnya.
Apa yang harus diperiksa di Langfuse
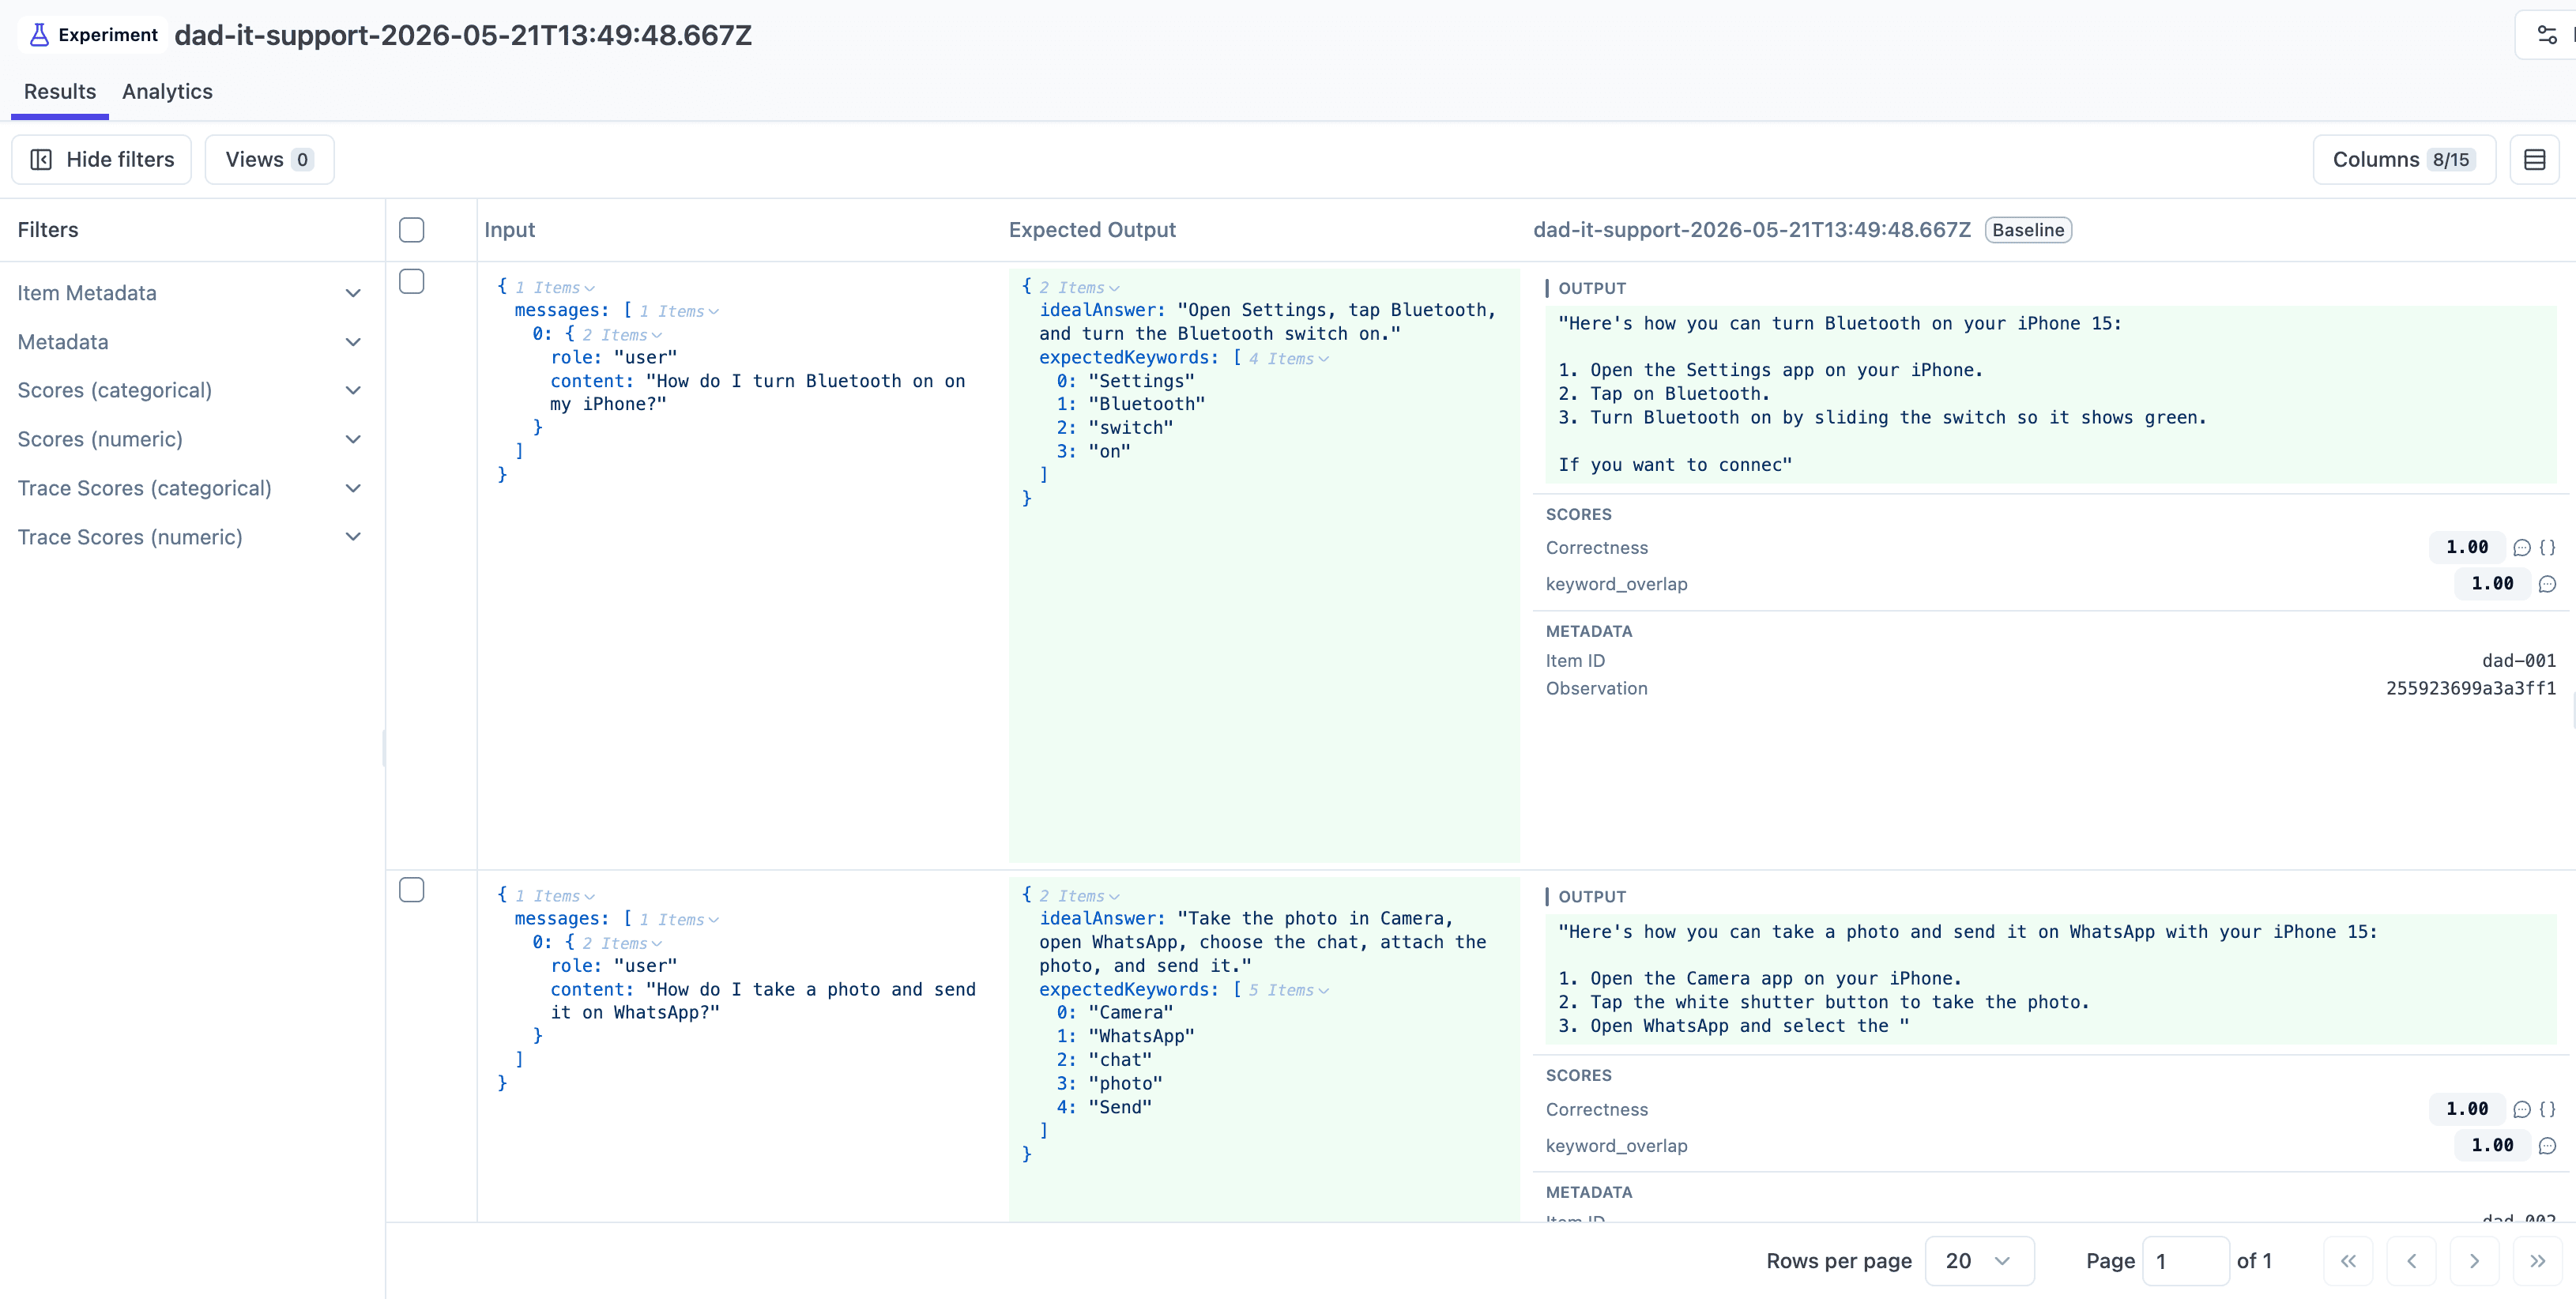
- Run baru di bawah dataset Anda — satu baris per item dengan dua skor:
keyword_overlapdancorrectness, ditambah tautan jejak. - Jejak tingkat item — bentuk identik dengan jejak produksi.
- Tampilan bagan dataset → rata-rata per-jalankan untuk kedua skor, siap untuk perbandingan berdampingan setelah perubahan di masa depan.
Cara memverifikasi Anda selesai
- Satu baris jalankan muncul di bawah dataset.
- Setiap item memiliki jejak dan kedua skor terlampir.
- Bentuk jejak cocok dengan jejak produksi normal.
Kesimpulan
Dua pendekatan penilaian memberi Anda dua sudut di jalankan yang sama: keyword match untuk "apakah kami mencakup langkah-langkah yang tepat?" dan correctness untuk "apakah jawaban benar-benar benar?" Program evaluasi nyata sering menggabungkan pemeriksaan deterministik dan berbasis judge seperti ini.
Jika tim Anda lebih suka lebih banyak logika evaluator di Langfuse UI, pemeriksaan deterministik juga dapat ditransfer ke evaluator kode nanti. Dokumen evaluator Kode mencakup jalur itu, dan dokumen Eksperimen via SDK menunjukkan bagaimana pengaturan sisi kode cocok.
Keterampilan Langfuse (/langfuse) tahu bentuk evaluator yang direkomendasikan dan pola pengaturan — panduan ini ada sehingga Anda melihat apa yang dilakukan keterampilan di bawah tenda. Pelajari lebih lanjut tentang eksperimen di pelajaran Akademi Langfuse.
Status akhir
Ini adalah titik awal untuk 07-evaluation.
05 Kumpulan Data
Anda memiliki aplikasi terlacak, beratribut, dan dipantau. data/seed-dataset.json dan scripts/seed-dataset.ts sudah ada di repo di checkpoint ini.
07 Mengevaluasi Perubahan
Aplikasi Anda terlacak, dipantau, memiliki dataset yang dihosting, dan setidaknya satu jalankan eksperimen dengan skor keywordoverlap dan kebenaran. Sekarang Anda membuat perubahan pada aplikasi dan menjalankan kembali...