06 实验
您的数据集已在 Langfuse 中准备就绪。scripts/run-dataset.ts 已在仓库中。
Workshop 材料维护在公开的 langfuse/langfuse-workshop 仓库中。使用此仓库获取可运行的应用、检查点分支和本地设置。
起始点
git checkout checkpoint/06-experiments您的数据集已在 Langfuse 中准备就绪。scripts/run-dataset.ts 已在仓库中。
为什么要进行实验
一个追踪(trace)告诉您一个回合的情况。一个实验告诉您整个数据集中的行为。每次实验运行执行相同的三件事:
- 从数据集中提取每个项目。
- 通过代理运行项目的输入 — 与 web 应用使用的
runSupportConversation(...)相同,因此追踪形状与生产环境相同。 - 使用一个或多个评估器对实际输出与预期输出进行评分。
不同的评估器回答不同的问题。有关评估器类型的更广泛讲解以及何时选择哪种类型,请参阅 Langfuse Academy 关于评估的课程。对于此 workshop,我们使用两个能快速初步了解答案质量的评估器:
keyword_overlap(确定性) — 答案是否涵盖了我们期望的步骤? 快速、成本低廉,直接在实验脚本中计算。correctness(LLM-as-a-judge) — 答案是否真的正确? 表达能力更强,特别是当措辞可以变化但基础答案必须与理想答案匹配时。
本章故意使用混合设置:廉价的确定性检查与实验运行器一起存在于代码中,而语义判断器存在于 Langfuse 中。
目标
本章结束时:
- 您可以根据需要针对代理运行完整数据集。
- 每个项目都获得一个
keyword_overlap分数(确定性)和一个correctness分数(LLM-as-a-judge)。 - 两个分数加上每个项目的追踪在 Langfuse 中可见,并准备好与未来的运行进行比较。
步骤 1 — 理解运行脚本
打开 scripts/run-dataset.ts。该文件用编号注释(// --- 1. Boot the OpenTelemetry SDK ...、// --- 3. The deterministic evaluator ... 等)进行了标注,以便您可以逐节阅读。概括而言:
- 通过
DATASET_NAME从 Langfuse 加载托管数据集。 - 对于每个项目,调用与 web 应用使用的相同
runSupportConversation(...)。 - 使用
dataset.runExperiment(...)将所有每个项目的追踪汇总为单个运行行。 - 通过将
expectedKeywords与代理的答案进行比较,为每个项目附加一个keyword_overlap分数。
生成的追踪形状与生产追踪相同 — 相同的 dad-it-support-chat-turn 根、相同的 OpenAI 生成、相同的工具跨度。我们不需要为确定性分数进行额外的 UI 设置,因为它已经存在于脚本中。
dataset.runExperiment(...) — 移动部分
整个运行是对 runExperiment 的一次调用。形状归结为:
await dataset.runExperiment({
  name: "Dad IT Support Agent experiment",
  runName,           // unique label for this run; shows up in the Runs tab
  description: "...",
  metadata: { model: env.openaiModel },
  maxConcurrency: 1, // run items one at a time

  task: async (item) => {
    const response = await runSupportConversation({ /* item.input */ });
    return response.answer;
  },

  evaluators: [
    async ({ output, expectedOutput }) => ({
      name: "keyword_overlap",
      value: keywordOverlap(output as string, (expectedOutput as any).expectedKeywords),
      comment: "..."
    })
  ]
});
要理解的三件事:
task是您的应用逻辑 — 我们直接调用runSupportConversation(...),这意味着此脚本生成的每个追踪看起来都与生产追踪相同。evaluators是一个列表。每个评估器在task返回后运行,并为项目追踪附加分数。这里我们使用一个确定性评估器,但您可以随时间添加更多。runName将每个项目的追踪分组为 Langfuse Runs 视图中的一行。选择一个每次运行都会改变的名称(我们包括时间戳),以便两个运行不会发生冲突。
步骤 2 — 审查确定性 keyword_overlap 评估器
在 scripts/run-dataset.ts 内部,helper 函数在模型答案内查找数据集项目的 expectedKeywords,并返回匹配的分数。
为什么要在脚本中保留它?
- 它易于与实验代码的其余部分一起阅读。
- 它使用与应用相同的版本控制和审查流程。
- 它是确定性的,所以没有理由花费 LLM 调用。
对于想要实验逻辑保留在仓库中的团队,这也是一个很好的默认模式。
替代方案:如果您想在平台中而不是在脚本中管理它,可以将相同的确定性检查也移到 Langfuse 代码评估器中。请参阅 代码评估器文档 和 通过 SDK 进行实验的文档。
步骤 3 — 在 Langfuse 中设置 correctness 评估器
Langfuse 提供了一个 Correctness LLM-as-a-judge 模板,用于将实际答案与理想答案进行比较并返回分数。我们将其连接到数据集运行,以便每个项目都同时获得本地确定性分数和在运行比较视图中显示的模型判断正确性分数。
新项目检查:Correctness 是一个 LLM-as-a-judge 评估器。如果您在会话 4 中没有配置默认评估模型,现在就配置:打开 项目设置 → LLM 连接并添加您的 OpenAI 密钥。模型本身在评估器创建期间设置 — 设置评估器向导在其 设置 LLM 连接步骤中要求它;选择支持结构化输出的模型,例如
openai / gpt-4.1。设置后,它在评估器页面顶部显示为 默认模型,您也可以稍后在那里更改它。仅将 API 密钥保留在 Langfuse 秘密字段中;不要将其粘贴到 workshop 录音或共享笔记中。
-
在 Langfuse 中,打开 评估器 → 设置评估器,从 使用现有 列表(Langfuse 托管评估器)中选择 Correctness。
-
目标是来自此数据集的运行:
- 运行在:实验(UI 通常在观察上打开,所以先切换)
- 筛选条件:Dataset 是 'dad-it-support-workshop'
-
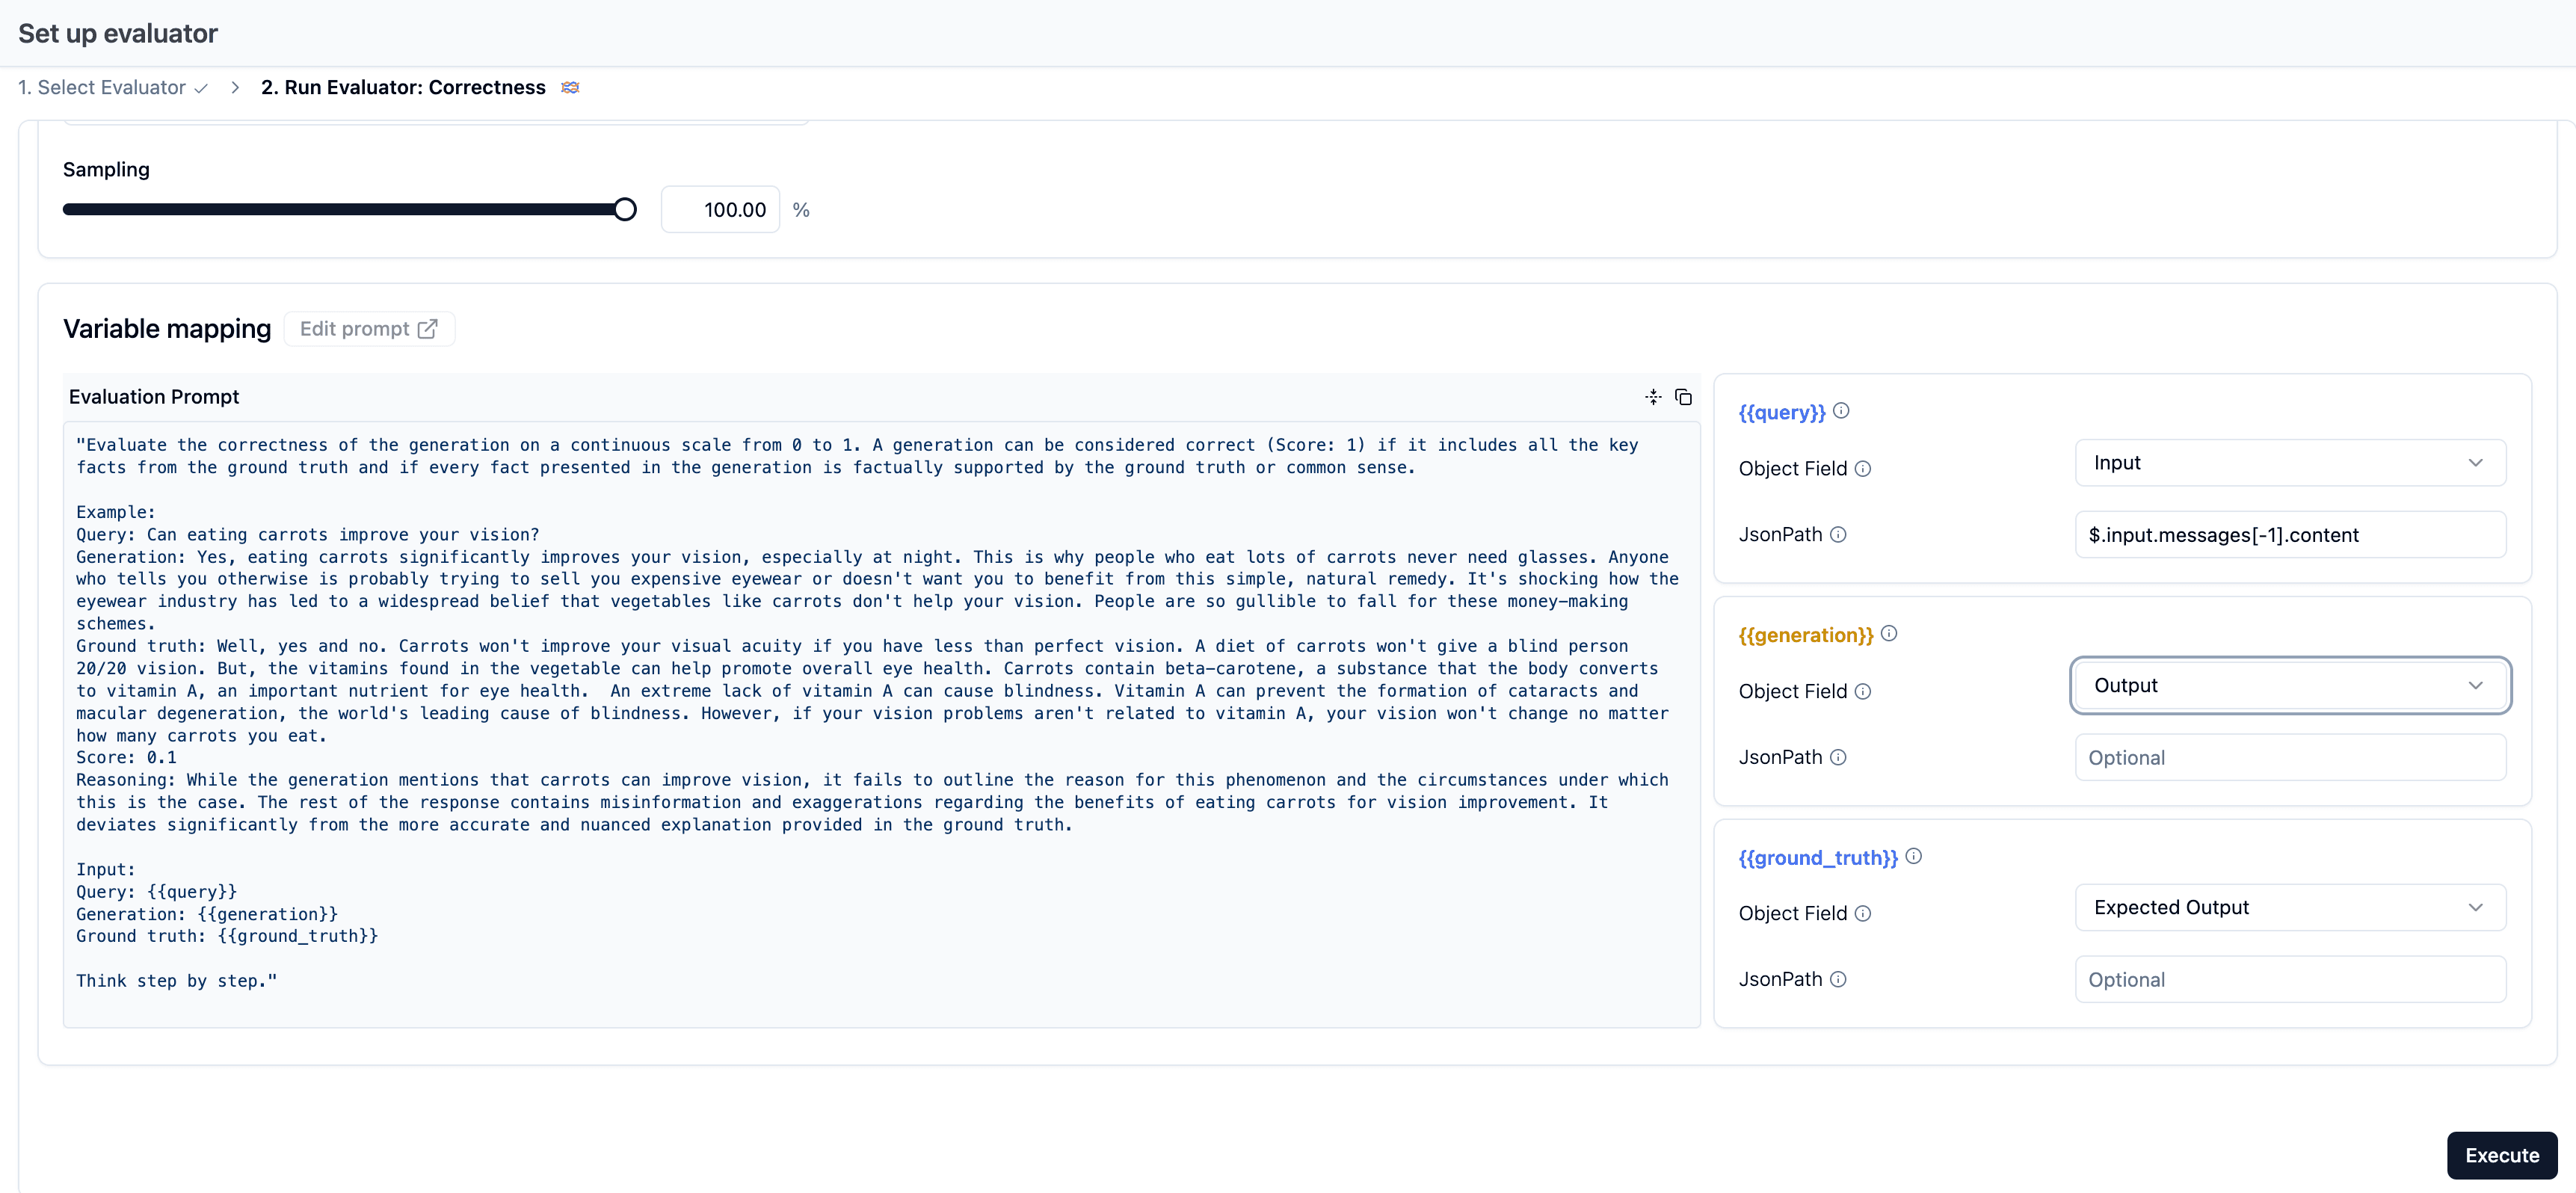
映射模板变量。在 UI 中,首先设置 Source 下拉菜单,然后仅在需要时添加 JsonPath:
Variable Object Field JsonPath queryInput $.messages[-1].contentgenerationOutput 留空 ground_truthExpected Output $.idealAnswer一个常见的破损设置是将所有三个变量都留在 Input 上,因为该下拉菜单首先出现。如果
generation或ground_truth指向 Input,评估器将为每次运行读取错误的数据。 -
使用您在会话 4 或上面的新项目检查中配置的默认判断模型,或选择另一个支持结构化输出的判断模型,然后保存。
-
启用评估器。
如果这是您的第一个实验,审查表或提示预览在设置时可能仍然显示 无结果 或 未找到追踪数据。这是预期的。您还没有创建任何实验运行,所以 Langfuse 无法预览。现在保存评估器;在步骤 4 创建第一次运行后,此评估器将异步评分新的实验项目。
为什么在这里运行 实验?因为对于此 workshop,我们希望 correctness 出现在实验运行行和运行比较视图中。
步骤 4 — 运行数据集
npm run dataset:run脚本通过在控制台中打印格式化的运行摘要来完成。项目级别的追踪和分数在运行执行时显示在 Langfuse 中,Correctness 评估器可能会在之后的短时间内继续填充分数,因为它异步运行。
脚本本身附加 keyword_overlap。您在步骤 3 中设置的 Correctness 评估器很快就会在 Langfuse 中异步运行新的运行行。
在 Langfuse 中检查的内容
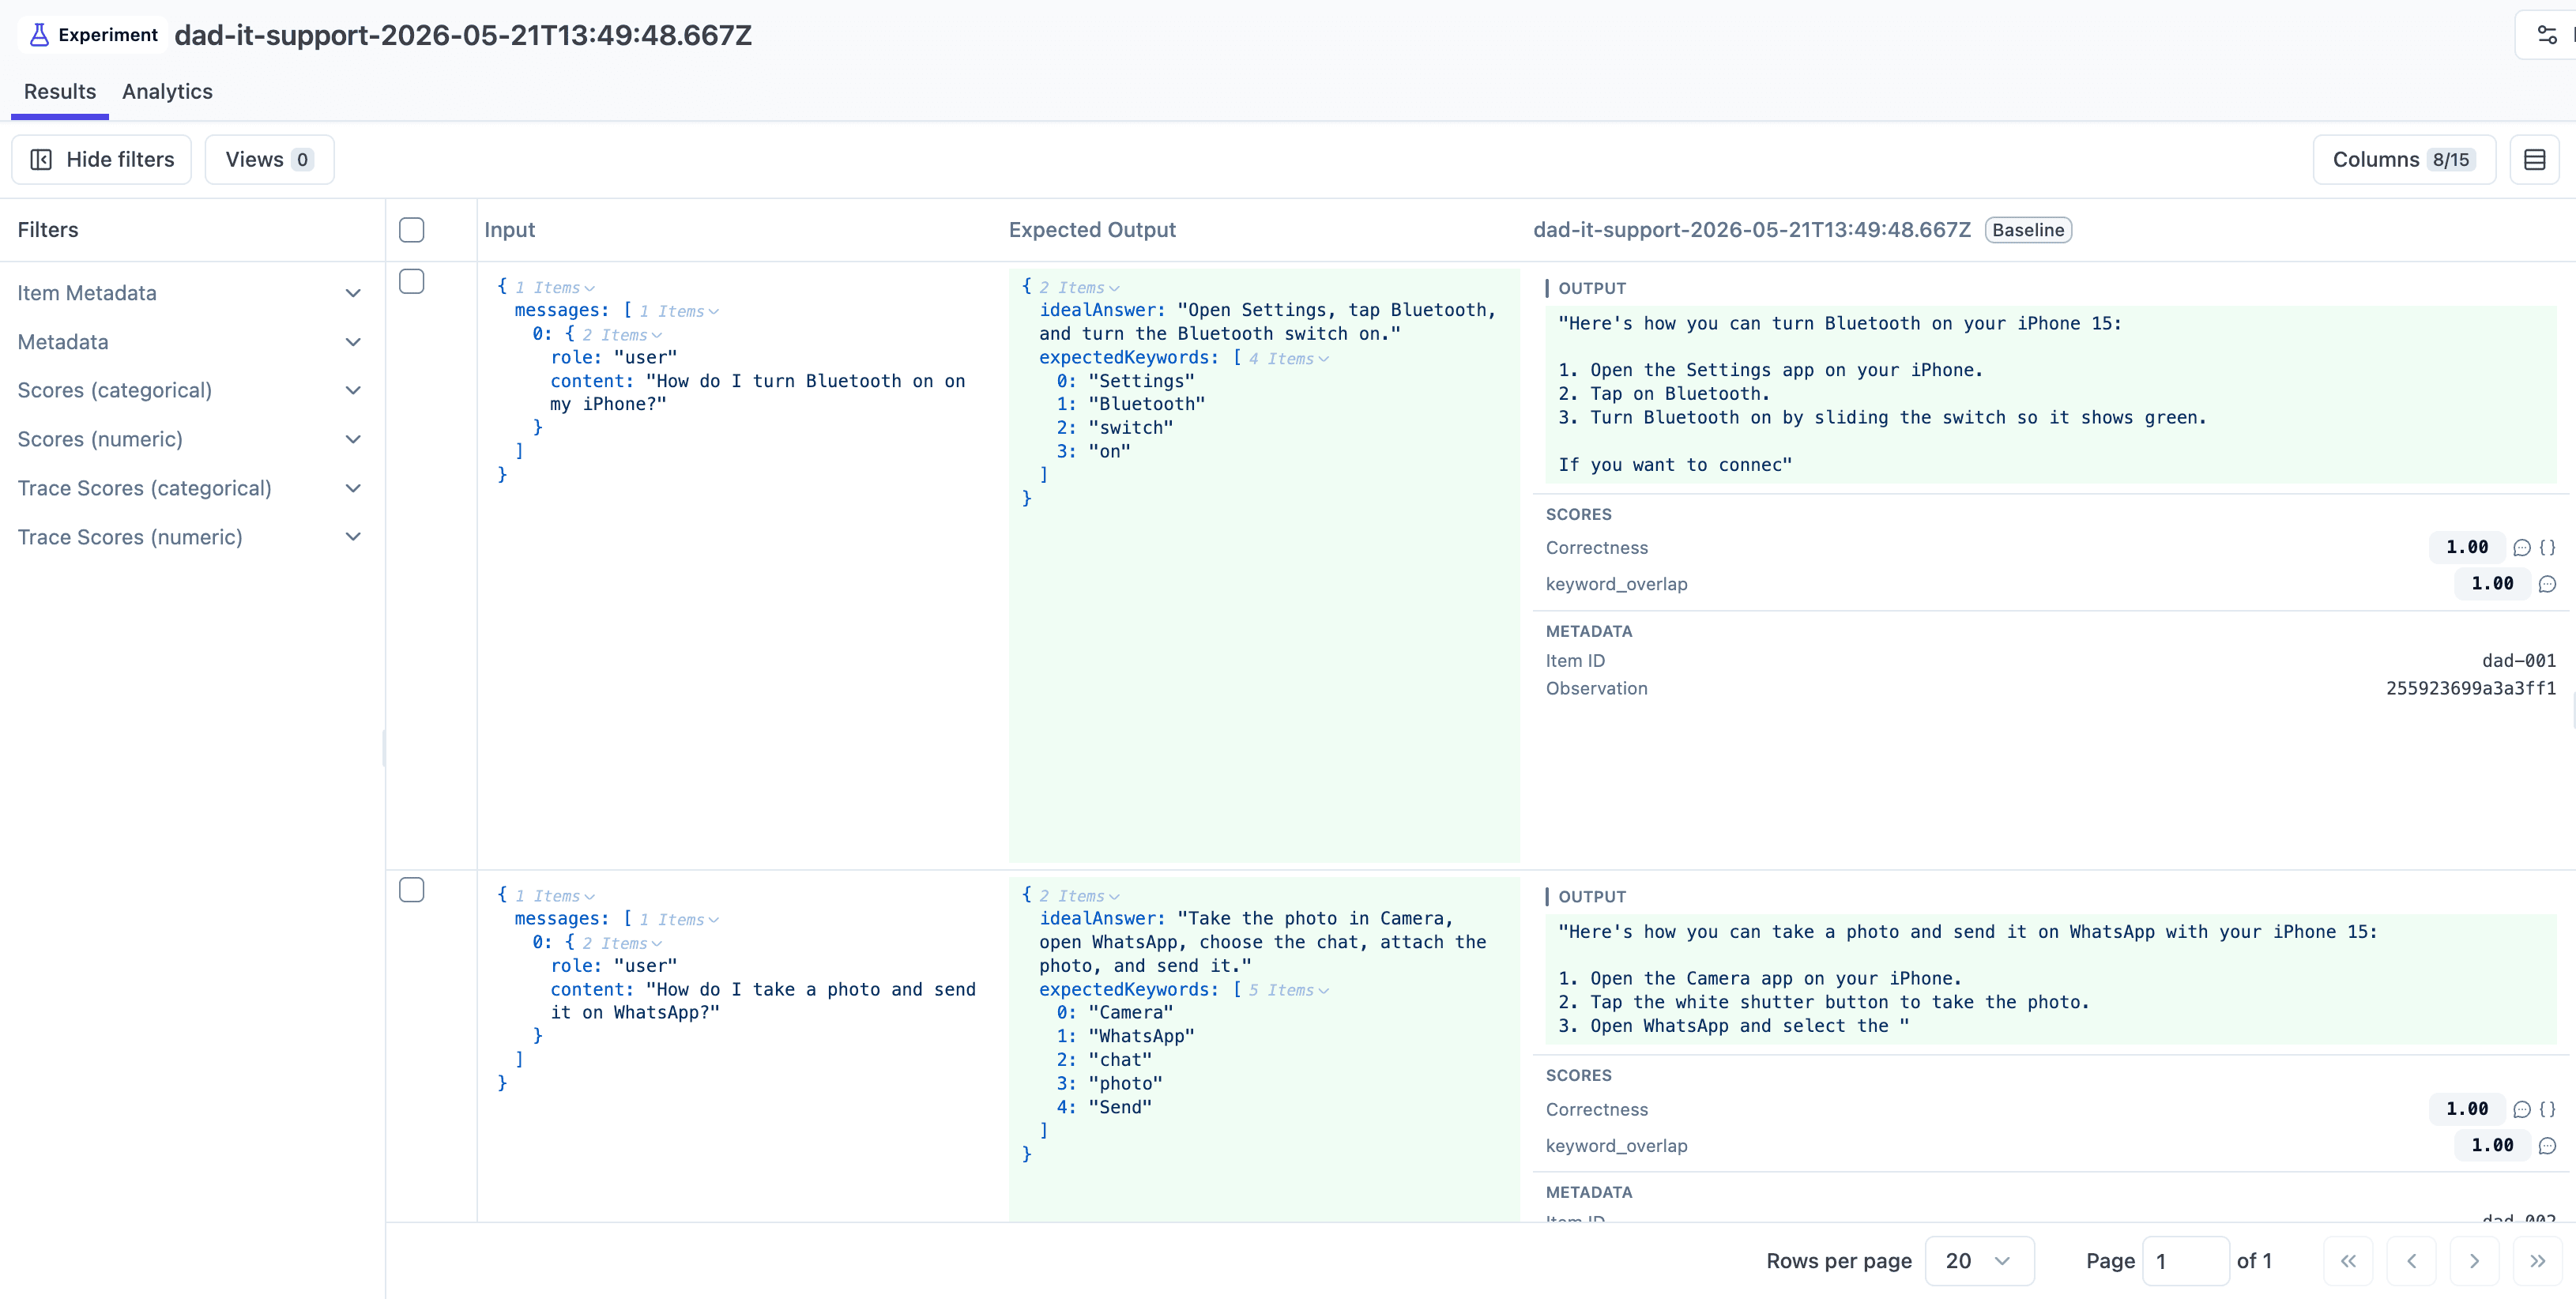
- 数据集下的新 Run → 每个项目一行,包含 两个 分数:
keyword_overlap和correctness,加上一个追踪链接。 - 项目级别的追踪 — 形状与生产追踪相同。
- 数据集的 图表视图 → 两个分数的每次运行平均值,准备好在未来更改后进行并排比较。
如何验证您已完成
- 数据集下出现一个运行行。
- 每个项目都附加有追踪和两个分数。
- 追踪形状与正常生产追踪匹配。
总结
这两种计分方法为您提供了对同一运行的两个角度:关键字匹配 用于"我们是否覆盖了正确的步骤?",正确性 用于"答案是否真的正确?"真实的评估程序通常会像这样结合确定性和基于判断的检查。
如果您的团队倾向于在 Langfuse UI 中使用更多的评估器逻辑,确定性检查稍后也可以迁移到代码评估器。代码评估器文档 涵盖该路径,通过 SDK 进行实验的文档 展示代码端设置如何组合在一起。
Langfuse skill(/langfuse)了解推荐的评估器形状和设置模式 — 本演练的存在是为了让您看到 skill 在幕后做什么。在 Langfuse Academy 课程中了解更多关于实验的信息。
最终状态
这是 07-evaluation 的起始点。