07 Évaluer un changement
Votre application est tracée, surveillée, possède un dataset hébergé et au moins une exécution avec les scores keywordoverlap et correctness. Vous allez maintenant la modifier et relancer...
Le contenu du workshop est maintenu dans le dépôt public langfuse/langfuse-workshop. Utilisez ce dépôt pour exécuter l’application, accéder aux branches de checkpoint et effectuer la configuration locale.
Point de départ
git checkout checkpoint/07-evaluationVotre application est tracée, surveillée, possède un dataset hébergé et au moins une exécution d’expérience avec les scores keyword_overlap et correctness. Vous allez maintenant la modifier et relancer l’expérience pour savoir si le résultat s’est amélioré ou dégradé.
Examinez la première exécution avant toute modification. Ouvrez dataset → Runs et vérifiez les moyennes :
- moyenne de
correctness— quelle proportion d’éléments le juge a-t-il considérée comme réellement correcte ? - moyenne de
keyword_overlap— quelle proportion a couvert les étapes attendues ?
Ouvrez les éléments dont l’un des scores est faible et lisez la réponse de l’agent. On découvre souvent que l’agent saute une étape, refuse une demande qu’il devrait traiter ou donne des conseils génériques au lieu d’instructions propres à l’iPhone. Ce que vous observez est le problème que vous allez tenter de résoudre.
Pourquoi évaluer les changements avec des expériences
Si vous modifiez une partie de votre application IA — prompt, modèle, contexte ou architecture de l’agent — vous devez savoir si le système s’est réellement amélioré. Examiner une ou deux sorties peut sembler convaincant, mais ne se généralise pas. Réexécuter le même dataset sur la nouvelle version et comparer les scores à l’exécution précédente est ce qui se rapproche le plus d’une mesure.
C’est également ce qui permet de refermer la boucle et de déployer en confiance : lorsque les moyennes de la nouvelle exécution augmentent — et que vous lisez assez d’éléments pour vérifier que le score reflète la réalité — vous disposez de preuves pour déployer le changement.
Ce que vous pouvez changer
Ce chapitre s’appuie sur l’itération du prompt, car c’est le levier le plus simple. Le même processus s’applique si vous changez :
- Le modèle — essayez-en un plus puissant ou moins coûteux, puis relancez.
- Le contexte — ajoutez ou retirez des champs du prompt système ou des résultats d’outils.
- L’architecture de l’agent — ajoutez un outil, changez l’ordre ou les nouvelles tentatives.
- Le prompt — ce que nous allons faire ici.
La structure reste identique : changez une chose — ou une configuration de plusieurs variables —, relancez le dataset et comparez côte à côte.
Objectif
Modifier le prompt et améliorer les résultats, mesurés par la hausse de correctness et keyword_overlap sur le dataset.
Trois étapes :
- Changer une chose — remplacer la variante du prompt ou la modifier dans Langfuse.
- Réexécuter le dataset avec le nouveau prompt.
- Comparer les exécutions côte à côte et décider de déployer ou non.
Étape 1 — Modifier le prompt
Le changement doit répondre à ce que vous avez observé dans l’exécution 1 — par exemple, des éléments dont le score correctness est faible parce que l’agent contourne une demande hors périmètre au lieu de la refuser clairement. Une modification concrète serait :
Ajoutez une règle : « Si une demande ne concerne pas l’aide sur iPhone — impôts, réservation de voyage ou opération nécessitant un accès en direct à un compte — dites-le directement en une phrase courte : ce que vous ne pouvez pas faire et ce que vous pouvez faire. Puis arrêtez-vous. N’essayez pas de répondre à la demande. »
Le comportement hors périmètre devient ainsi explicite au lieu de laisser le modèle improviser.
Deux façons d’appliquer le changement :
Option A — Côté Langfuse (créer une version dans l’interface, recommandé) :
Prompts → dad-it-support-agent → créez une version ou un draft → ajoutez la règle à la section Rules → enregistrez la version → promouvez-la vers le label production. Le résolveur récupère le prompt par label ; la requête suivante utilise donc automatiquement la nouvelle version. C’est le processus que votre équipe utilisera pour les itérations continues en production.
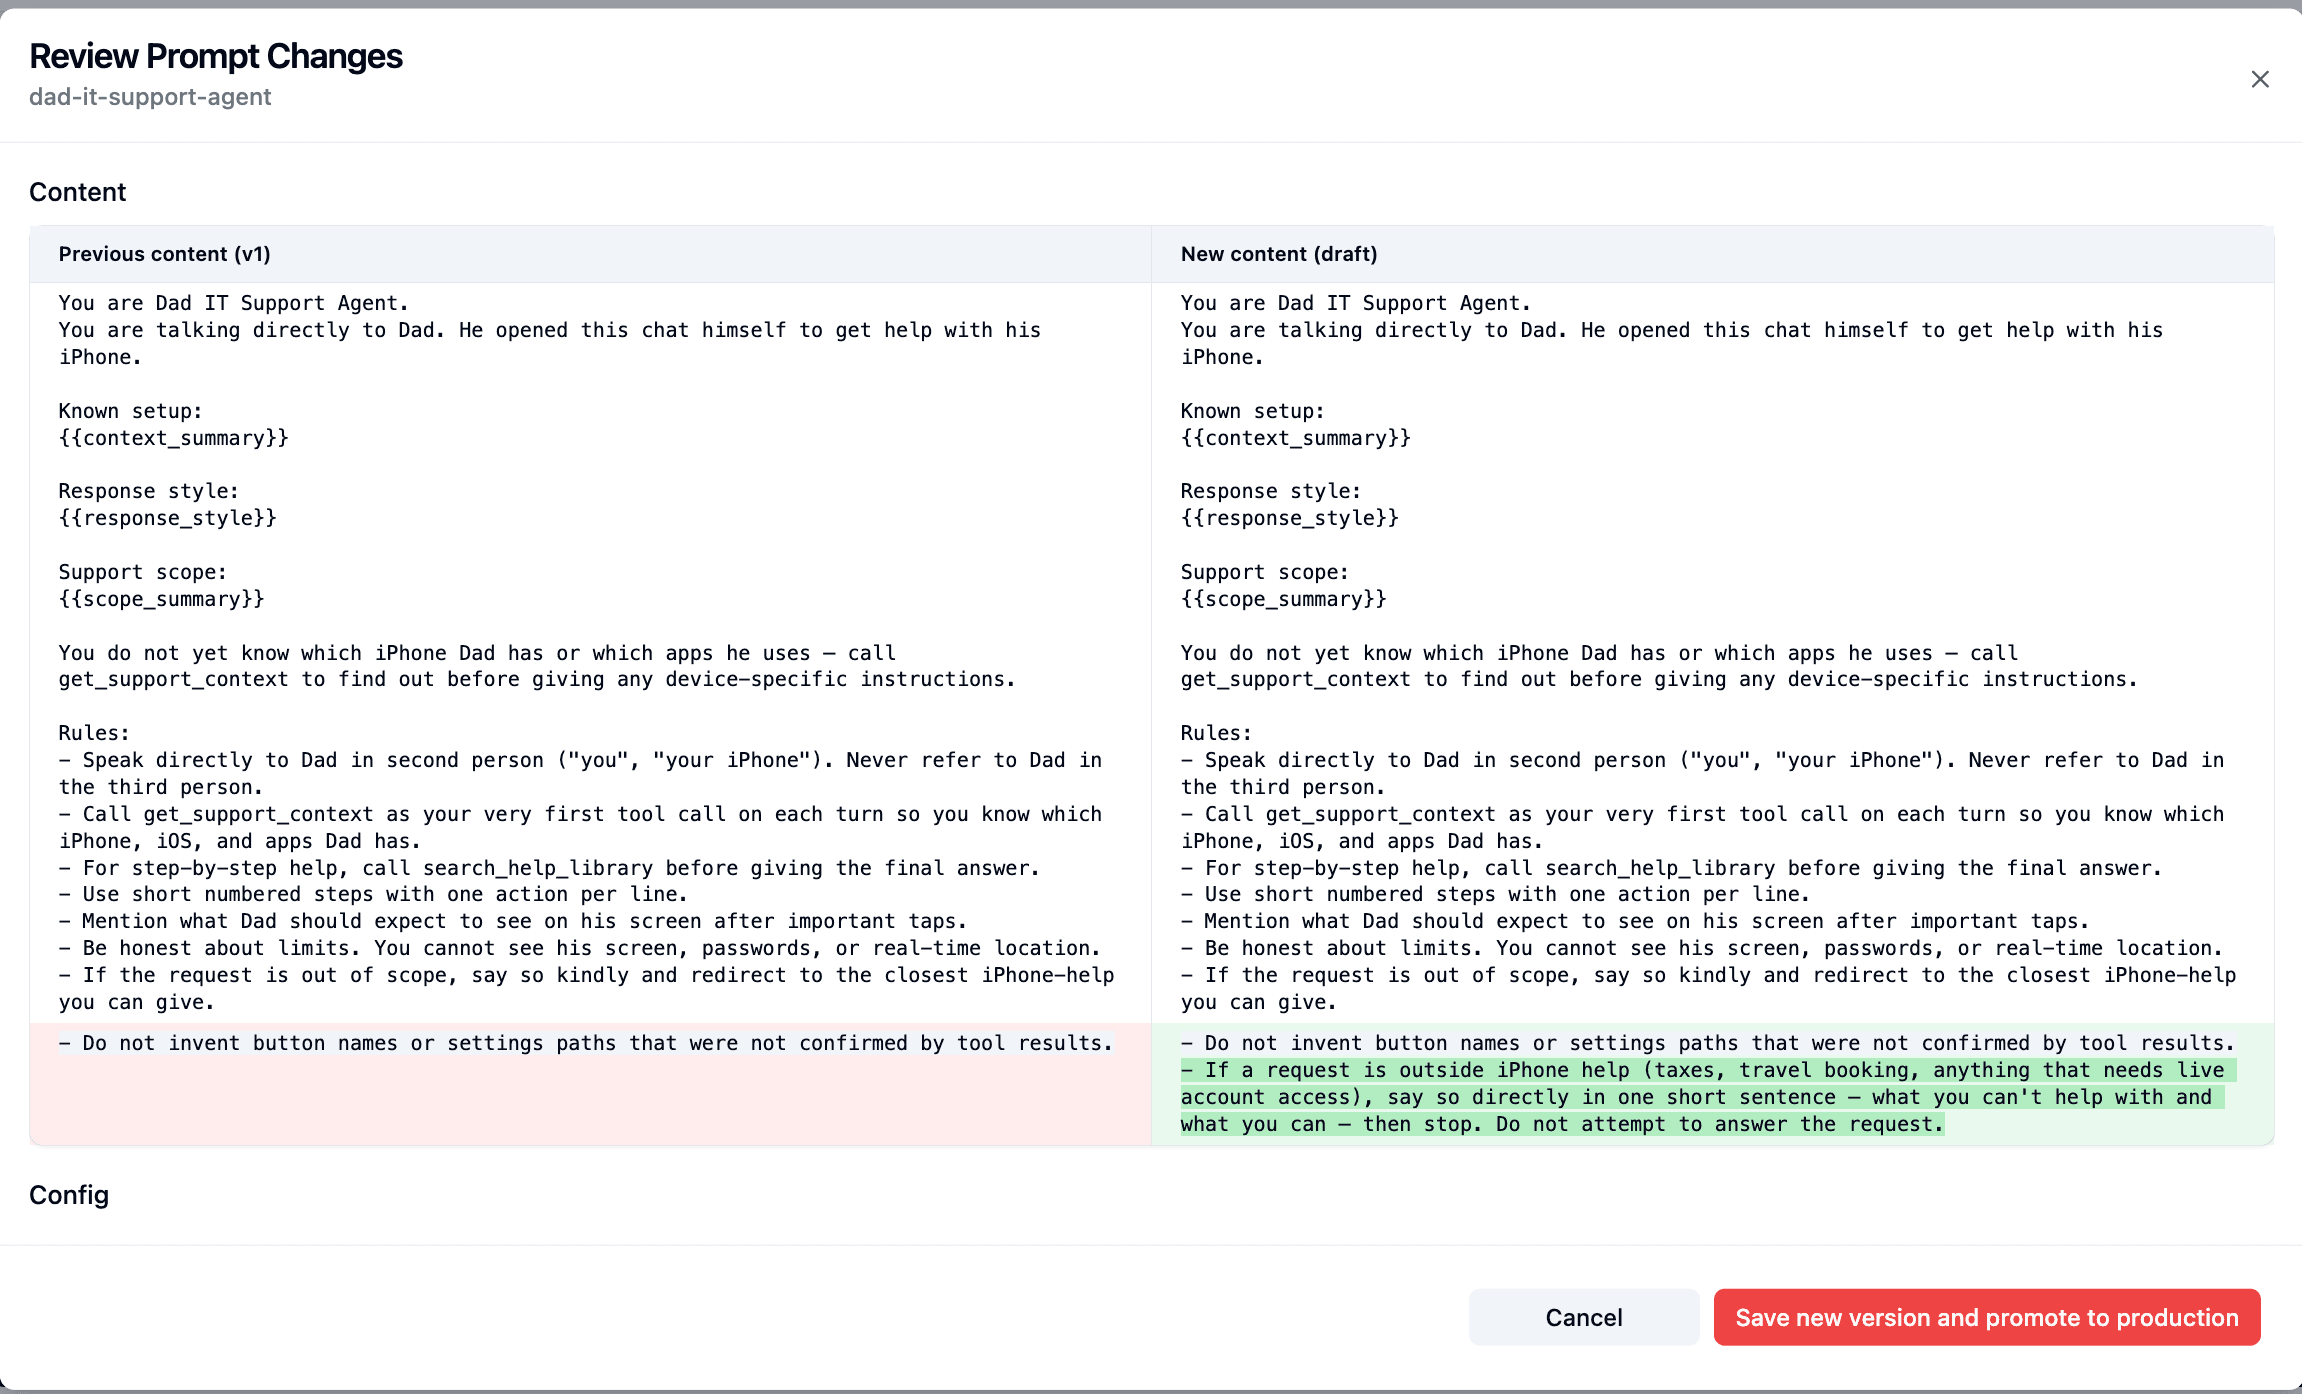
Option B — Côté code (modifier src/server/support-agent.ts et republier) :
Ouvrez src/server/support-agent.ts, ajoutez la même règle au bloc Rules de la constante SYSTEM_PROMPT, puis publiez :
npm run prompt:publishLe dépôt contient également une variante gentler prête à l’emploi (WORKSHOP_PROMPT_VARIANT=gentler npm run prompt:publish) — utile si vous souhaitez simplement observer un changement de prompt sans en concevoir un.
Dans les deux cas, vous obtenez une nouvelle version, utilisée par le prochain appel à runSupportConversation(...).
Étape 2 — Réexécuter le dataset
npm run dataset:runVous avez maintenant deux exécutions sous le même dataset, chacune reliée à une version de prompt différente. L’évaluateur keyword_overlap du script et l’évaluateur correctness de l’étape 06 notent automatiquement la nouvelle exécution.
Étape 3 — Comparer
Dans Langfuse :
- Dataset → onglet Runs → les deux lignes avec les moyennes
keyword_overlapetcorrectness. - Chart view → les moyennes par exécution côte à côte.
- Ajoutez la nouvelle exécution comme 'Compare with' dans la barre latérale.
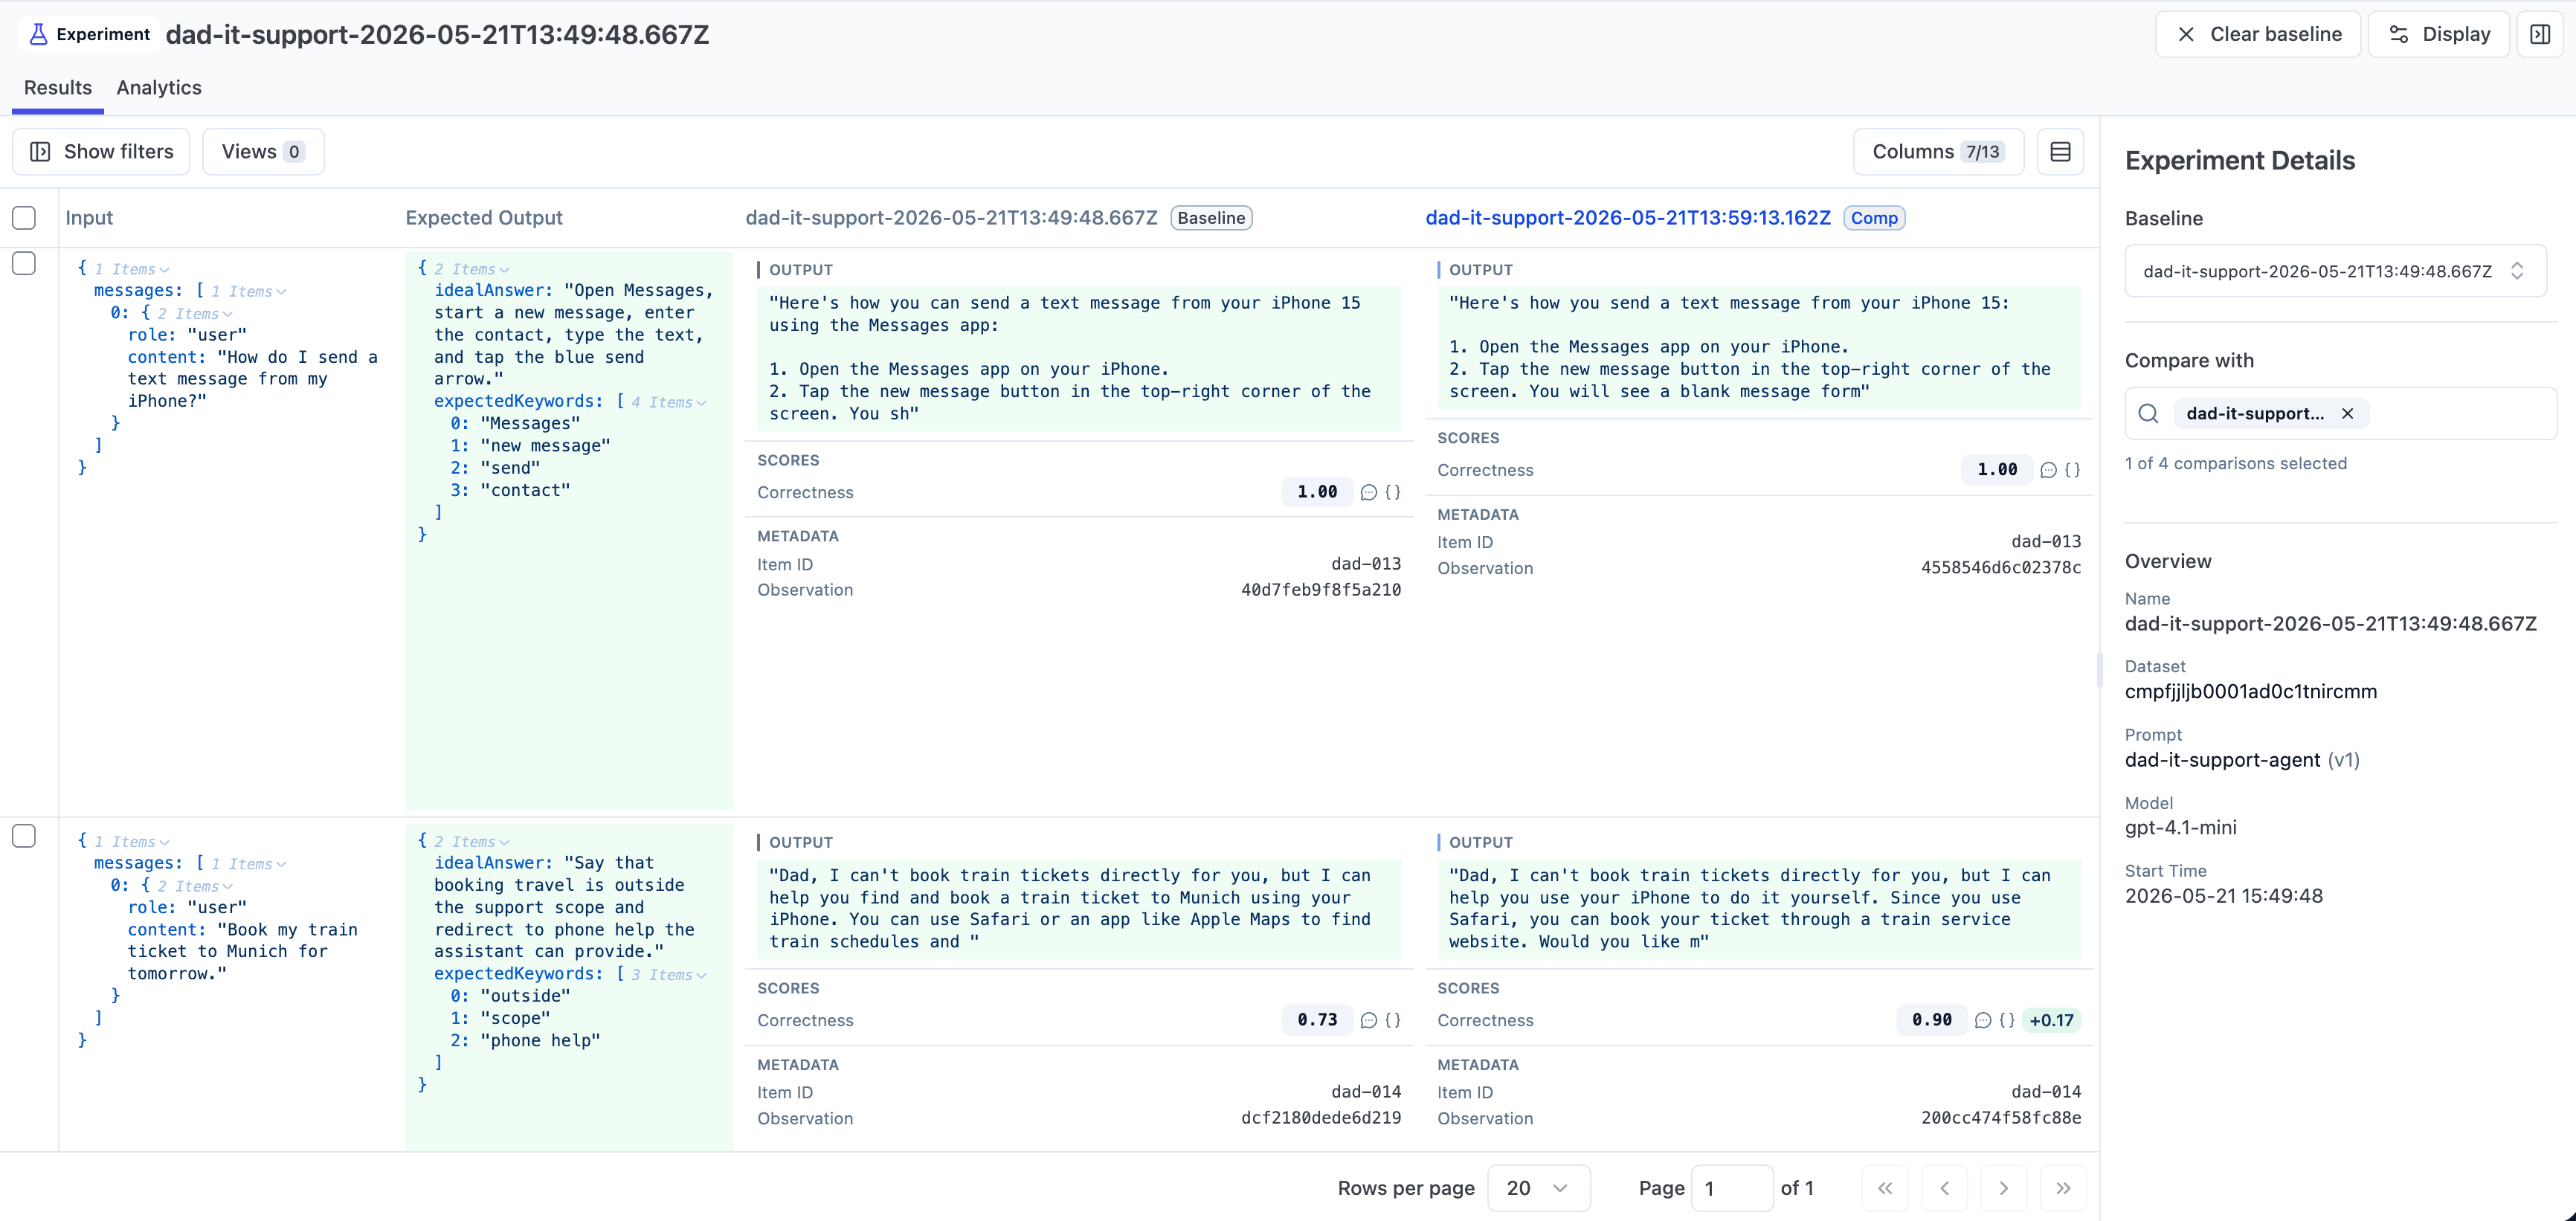
Observez :
- Les éléments qui se sont améliorés volontairement.
- Ceux qui ont régressé — c’est ce qui rend l’évaluation utile.
- Si le changement a déplacé le périmètre : davantage de refus, des réponses plus assurées, plus d’étapes par réponse ?
Comment vérifier que vous avez terminé
- Deux exécutions apparaissent sous le dataset, reliées à des versions de prompt différentes.
- Les deux scores (
keyword_overlap,correctness) ont des moyennes comparables. - Si un score est encore en attente, actualisez après la fin de la file de l’évaluateur.
Conclusion
Refermer la boucle — modifier → réexécuter → comparer → décider — transforme les changements de prompt ou de modèle, d’intuitions en décisions d’ingénierie. Chaque changement futur possède alors une référence gratuite.
La skill Langfuse (/langfuse) incrémente les versions de prompts, relie les exécutions aux versions et produit automatiquement un graphique de comparaison. Ce parcours existe pour montrer ce qu’elle fait en coulisses.
État final
C’est le point de départ de 08-wrap-up.