06 Experimentos
Seu dataset foi carregado no Langfuse. scripts/run-dataset.ts já está no repositório.
O material do workshop é mantido no repositório público langfuse/langfuse-workshop. Use o repositório para executar a aplicação, acessar os branches de checkpoint e fazer a configuração local.
Ponto de partida
git checkout checkpoint/06-experimentsSeu dataset foi carregado no Langfuse. scripts/run-dataset.ts já está no repositório.
Por que usar experimentos
Um trace fala sobre um turno. Um experimento mostra o comportamento em todo o dataset. Cada execução faz três coisas:
- Busca cada item do dataset.
- Passa a entrada do item pelo agente — o mesmo
runSupportConversation(...)da aplicação web, produzindo o mesmo formato de trace da produção. - Pontua a saída real contra a esperada usando um ou mais avaliadores.
Avaliadores diferentes respondem a perguntas diferentes. Para conhecer os tipos e quando usar cada um, consulte a lição da Langfuse Academy sobre avaliação. Aqui usaremos dois que oferecem uma leitura inicial rápida:
keyword_overlap(determinístico) — a resposta cobriu as etapas esperadas? Rápido, barato e calculado no script.correctness(LLM-as-a-judge) — a resposta está realmente correta? Mais expressivo quando a redação varia, mas o significado deve corresponder à referência.
O capítulo usa uma configuração mista de propósito: a verificação determinística fica no código junto ao executor, enquanto o juiz semântico fica no Langfuse.
Objetivo
Ao final:
- Você consegue executar o dataset completo contra o agente quando quiser.
- Cada item recebe uma pontuação
keyword_overlape outracorrectness. - As duas pontuações e os traces por item ficam visíveis no Langfuse, prontos para comparar com execuções futuras.
Etapa 1 — Entender o script de execução
Abra scripts/run-dataset.ts. O arquivo tem comentários numerados (// --- 1. Boot the OpenTelemetry SDK ..., // --- 3. The deterministic evaluator ... etc.) para leitura por seções. Em alto nível, ele:
- carrega do Langfuse o dataset hospedado identificado por
DATASET_NAME; - chama, para cada item, o mesmo
runSupportConversation(...)da aplicação web; - usa
dataset.runExperiment(...)para agrupar todos os traces em uma linha de execução; - anexa uma pontuação
keyword_overlappor item, comparandoexpectedKeywordsà resposta do agente.
Os traces têm o mesmo formato da produção: raiz dad-it-support-chat-turn, generation da OpenAI e spans das ferramentas. A pontuação determinística não exige configuração adicional na interface, pois já está no script.
dataset.runExperiment(...) — as partes móveis
Toda a execução é uma chamada a runExperiment, neste formato:
await dataset.runExperiment({
  name: "Dad IT Support Agent experiment",
  runName,           // unique label for this run; shows up in the Runs tab
  description: "...",
  metadata: { model: env.openaiModel },
  maxConcurrency: 1, // run items one at a time

  task: async (item) => {
    const response = await runSupportConversation({ /* item.input */ });
    return response.answer;
  },

  evaluators: [
    async ({ output, expectedOutput }) => ({
      name: "keyword_overlap",
      value: keywordOverlap(output as string, (expectedOutput as any).expectedKeywords),
      comment: "..."
    })
  ]
});
Três pontos importantes:
taské a lógica da sua aplicação. Chamamos diretamenterunSupportConversation(...), então cada trace é idêntico a um trace de produção.evaluatorsé uma lista. Cada avaliador roda depois detaske anexa uma pontuação ao item. Usamos um avaliador determinístico, mas você pode acrescentar outros.runNameagrupa os traces em uma linha na visualização Runs. Escolha um nome diferente por execução — incluímos o timestamp — para não haver colisões.
Etapa 2 — Revisar o avaliador determinístico keyword_overlap
Em scripts/run-dataset.ts, a função auxiliar procura os expectedKeywords do item na resposta e retorna a fração encontrada.
Por que mantê-la no script?
- É fácil lê-la junto ao código do experimento.
- Usa o mesmo controle de versão e revisão da aplicação.
- É determinística, então não há motivo para gastar uma chamada LLM.
É um bom padrão para equipes que preferem manter a lógica de experimentos no repositório.
Alternativa: a mesma verificação poderia ser um code evaluator do Langfuse, caso você queira gerenciá-la na plataforma. Consulte a documentação de code evaluators e a documentação de experimentos pelo SDK.
Etapa 3 — Configurar o avaliador correctness no Langfuse
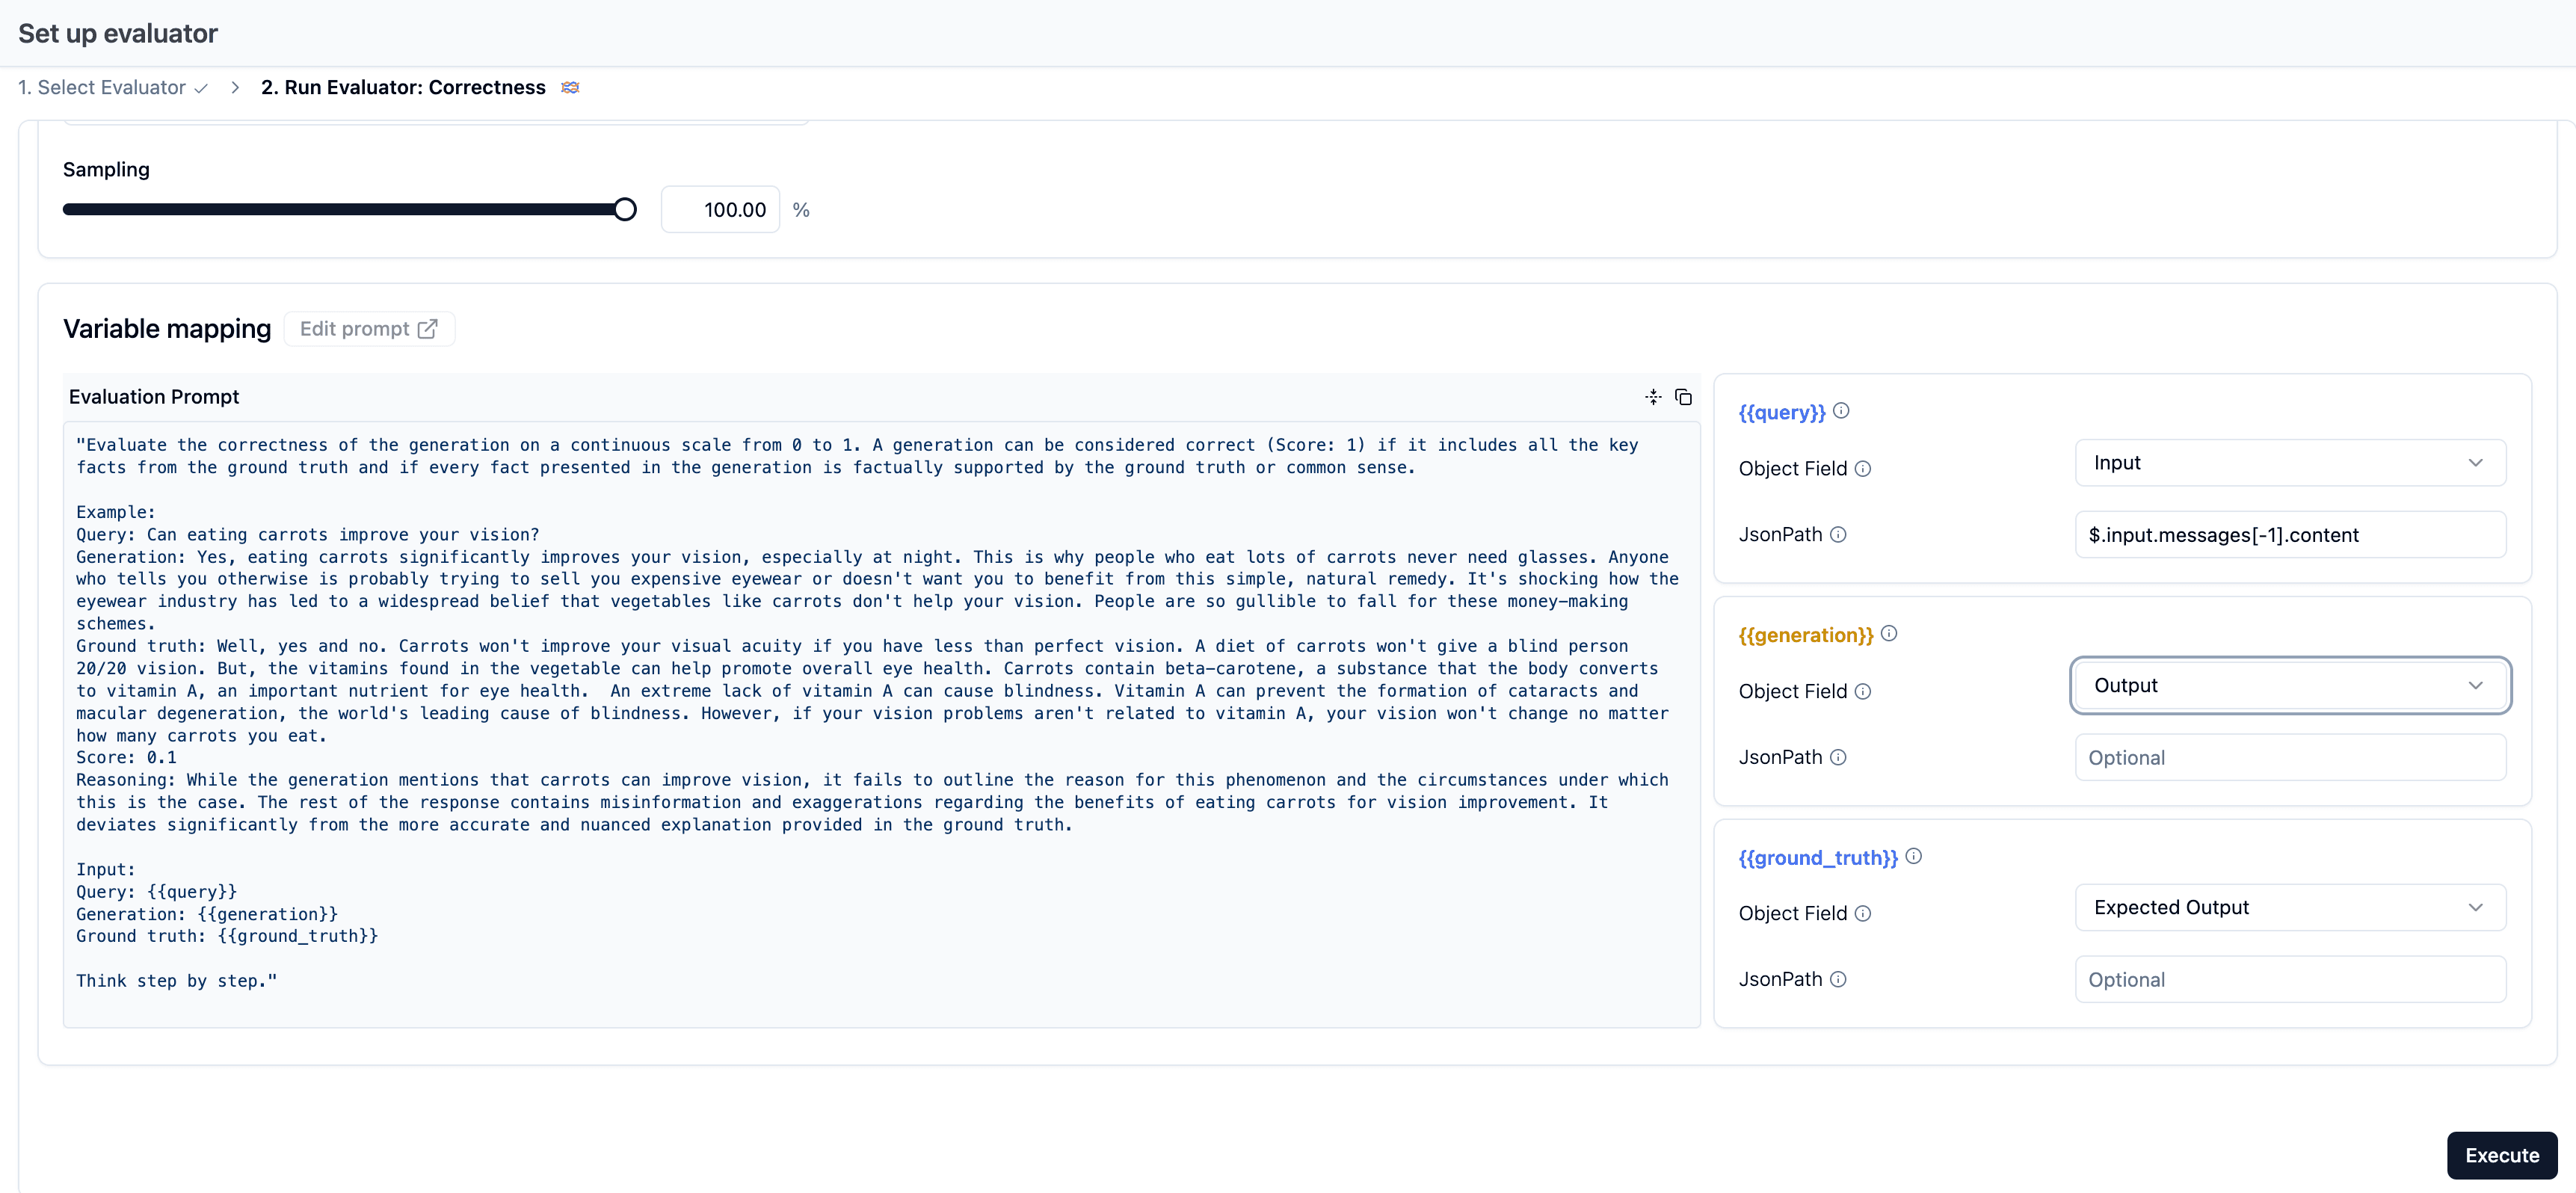
O Langfuse oferece um template Correctness LLM-as-a-judge que compara a resposta real à ideal e retorna uma pontuação. Vamos aplicá-lo às execuções para que cada item receba a pontuação determinística local e a avaliação de correção feita pelo modelo na visualização de comparação.
Projeto novo: Correctness é LLM-as-a-judge. Se você não configurou o modelo padrão na sessão 4, abra Project Settings → LLM Connections e adicione a chave OpenAI. Durante a criação, o assistente Set up evaluator pedirá um modelo em Set up LLM connection; escolha um modelo com saída estruturada, como
openai / gpt-4.1. Depois, ele aparece como Default model em Evaluators. Mantenha a chave apenas no campo secreto do Langfuse.
-
Abra Evaluators → Set up evaluator e escolha Correctness em Use existing (Langfuse managed evaluators).
-
Aponte para as execuções deste dataset:
- Run on: Experiments (a interface costuma abrir em observations; troque isso primeiro)
- Filter where: Dataset is 'dad-it-support-workshop'
-
Mapeie as variáveis. Selecione primeiro Source e adicione JsonPath somente quando necessário:
Variável Campo do objeto JsonPath queryInput $.messages[-1].contentgenerationOutput Deixe em branco ground_truthExpected Output $.idealAnswerUm erro comum é deixar as três variáveis em Input porque esse dropdown aparece primeiro. Se
generationouground_truthapontarem para Input, o avaliador lerá dados errados em todas as execuções. -
Use o modelo padrão configurado na sessão 4 ou acima, ou escolha outro compatível, e salve.
-
Habilite o avaliador.
Se este for o primeiro experimento, a tabela de revisão ou a prévia poderá mostrar No results ou No trace data found. Isso é esperado: ainda não há execuções para pré-visualizar. Salve; depois que a Etapa 4 criar a primeira execução, o avaliador pontuará os itens de forma assíncrona.
Por que Experiments? Queremos correctness nas linhas de execução e na visualização de comparação.
Etapa 4 — Executar o dataset
npm run dataset:runO script termina exibindo um resumo formatado no console. Os traces e pontuações aparecem no Langfuse durante a execução, e Correctness pode continuar preenchendo resultados por algum tempo, pois é assíncrono.
O próprio script anexa keyword_overlap. O avaliador Correctness da Etapa 3 roda no Langfuse sobre as novas linhas logo depois.
O que examinar no Langfuse
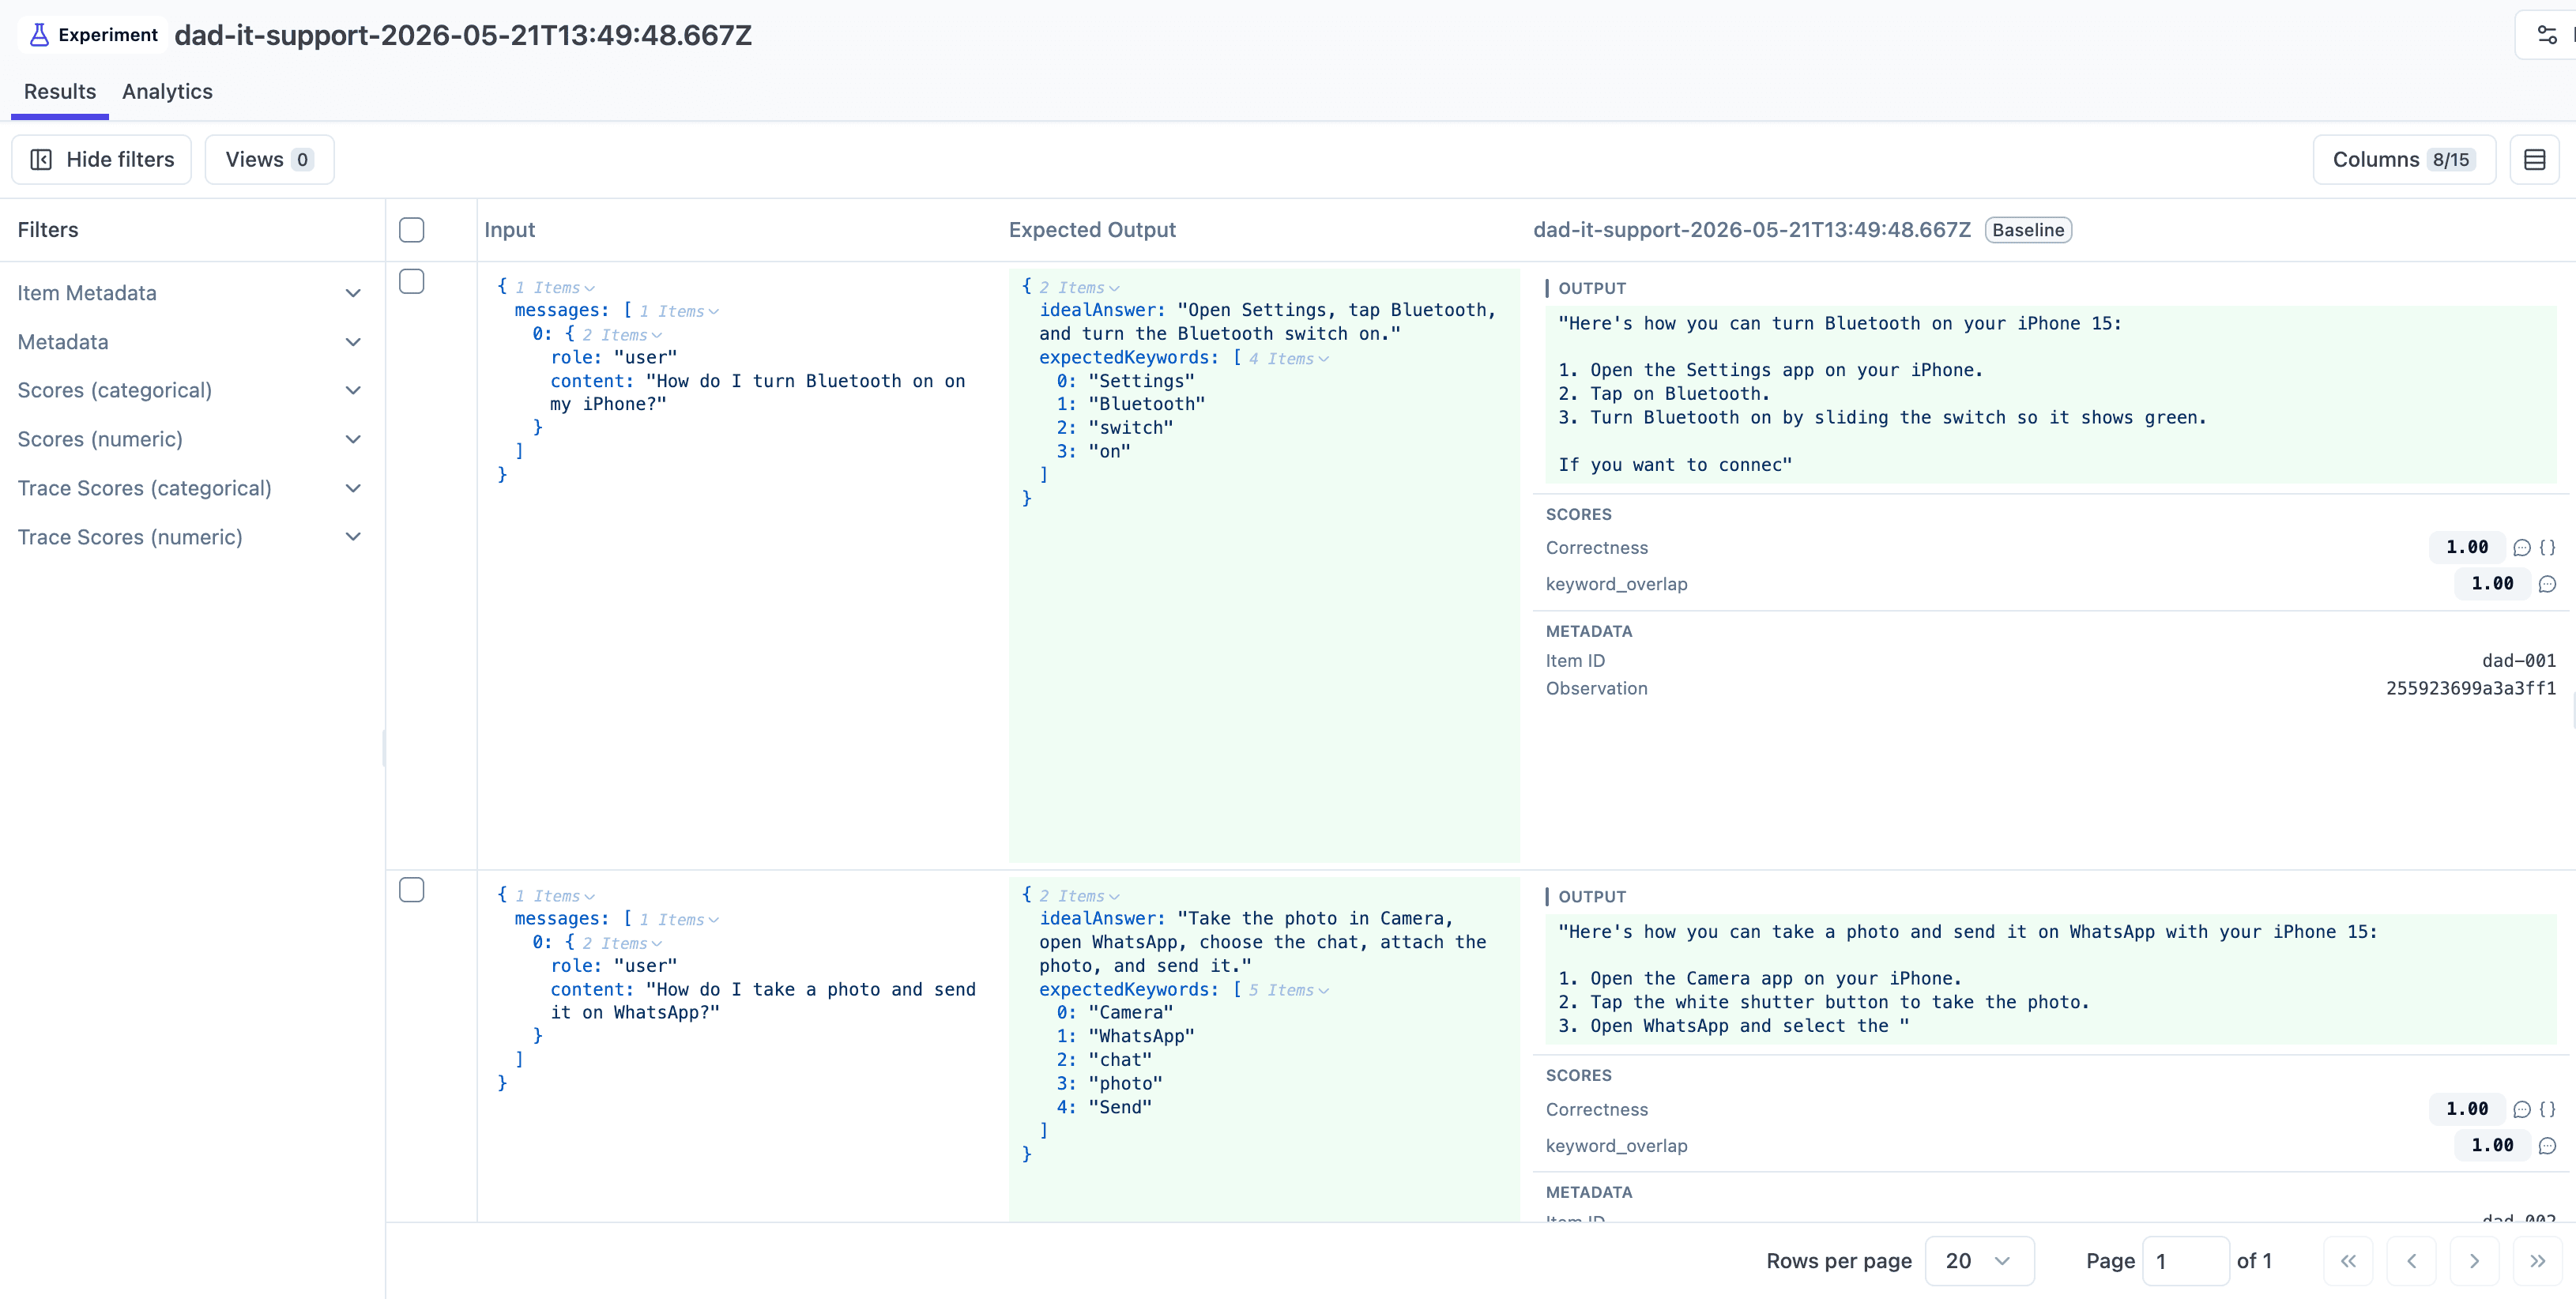
- O novo Run do dataset → uma linha por item, com duas pontuações,
keyword_overlapecorrectness, e um link para o trace. - Traces por item — idênticos aos de produção.
- A chart view do dataset → médias por execução para as duas pontuações, prontas para comparação futura.
Como verificar a conclusão
- Uma linha de execução aparece no dataset.
- Cada item tem um trace e as duas pontuações.
- O formato do trace corresponde a um trace normal de produção.
Encerramento
As duas pontuações oferecem perspectivas diferentes: keyword match responde "cobrimos as etapas?" e correctness responde "a resposta está correta?". Programas reais costumam combinar verificações determinísticas e baseadas em juiz.
Se sua equipe preferir mais lógica na interface, a verificação determinística pode migrar para um code evaluator. A documentação de code evaluators explica esse caminho, e a documentação de experimentos pelo SDK mostra como a configuração em código se encaixa.
A skill do Langfuse (/langfuse) conhece os formatos e padrões recomendados. Este percurso existe para mostrar seu funcionamento. Saiba mais na lição da Langfuse Academy.
Estado final
Este é o ponto de partida para 07-evaluation.
05 Dataset
Você tem uma aplicação com tracing, atribuição e monitoramento. data/seed-dataset.json e scripts/seed-dataset.ts já estão no repositório neste checkpoint.
07 Avaliar uma mudança
Sua aplicação tem tracing, monitoramento, um dataset hospedado e ao menos uma execução de experimento com pontuações keywordoverlap e correctness. Agora você altera a aplicação e executa novamente...