05 Dataset
Você tem uma aplicação com tracing, atribuição e monitoramento. data/seed-dataset.json e scripts/seed-dataset.ts já estão no repositório neste checkpoint.
O material do workshop é mantido no repositório público langfuse/langfuse-workshop. Use o repositório para executar a aplicação, acessar os branches de checkpoint e fazer a configuração local.
Ponto de partida
git checkout checkpoint/05-datasetVocê tem uma aplicação com tracing, atribuição e monitoramento. data/seed-dataset.json e scripts/seed-dataset.ts já estão no repositório neste checkpoint.
Confirme que .env contém:
DATASET_NAME=dad-it-support-workshopPor que criar datasets
Um dataset representa o que o sistema encontrará em produção: as entradas esperadas e, para cada uma, como seria uma boa resposta. Com expectativas claras por escrito, você pode executar o agente novamente após cada mudança e saber se o resultado melhorou ou piorou. Um bom dataset é a base para publicar com confiança e iterar sem regressões.
Saiba mais na lição da Langfuse Academy sobre datasets.
Objetivo
Carregar um primeiro dataset que represente as solicitações que Specs deve atender. Para isso:
- Entenda o formato do item — todos os itens têm os mesmos três campos, e queremos que os nossos correspondam à entrada real do agente.
- Carregue o dataset hospedado para que ele fique no Langfuse, pronto para os experimentos da próxima etapa.
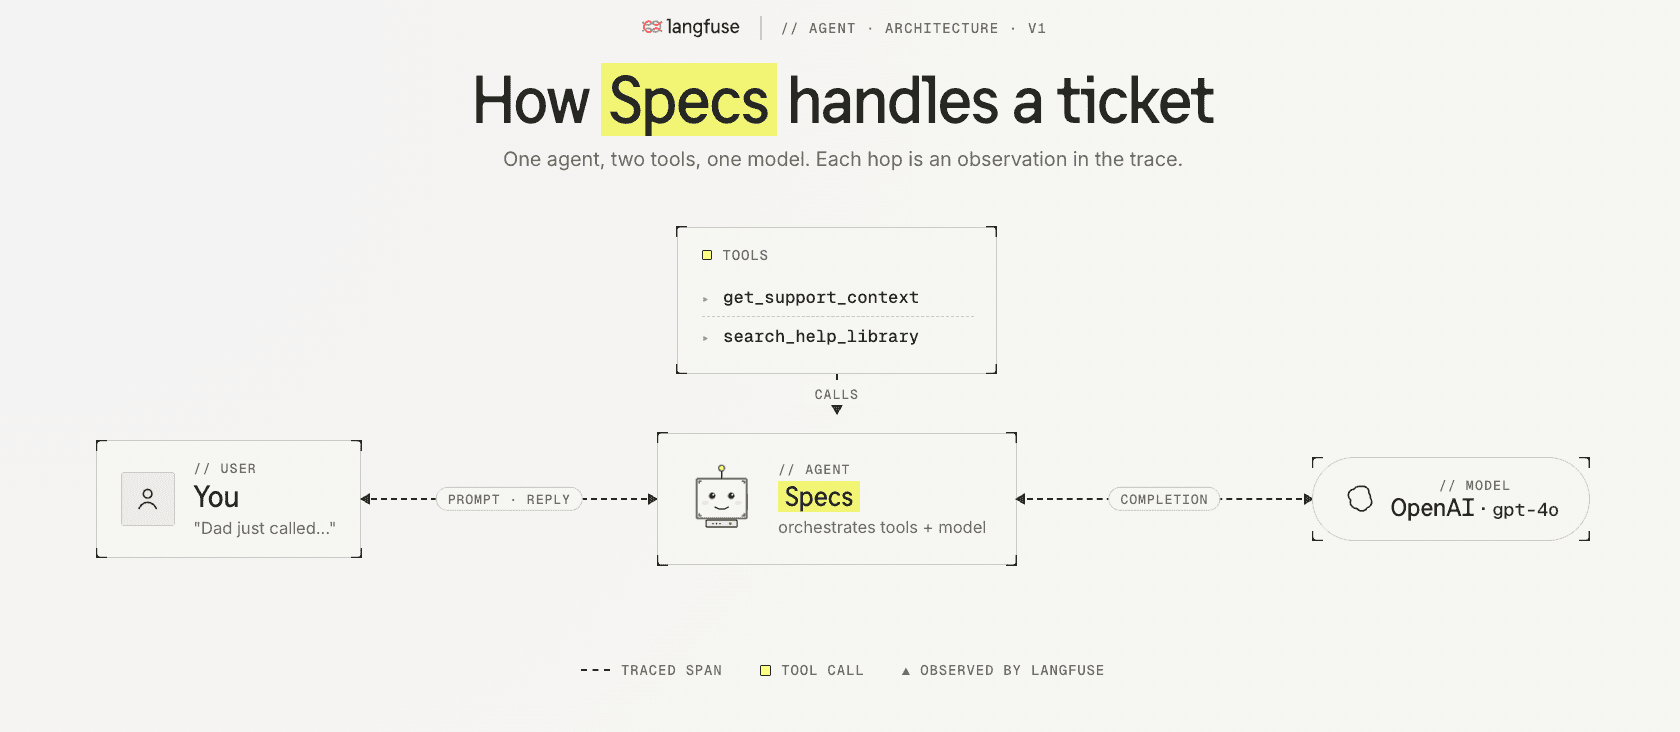
Etapa 1 — Entender o formato do item
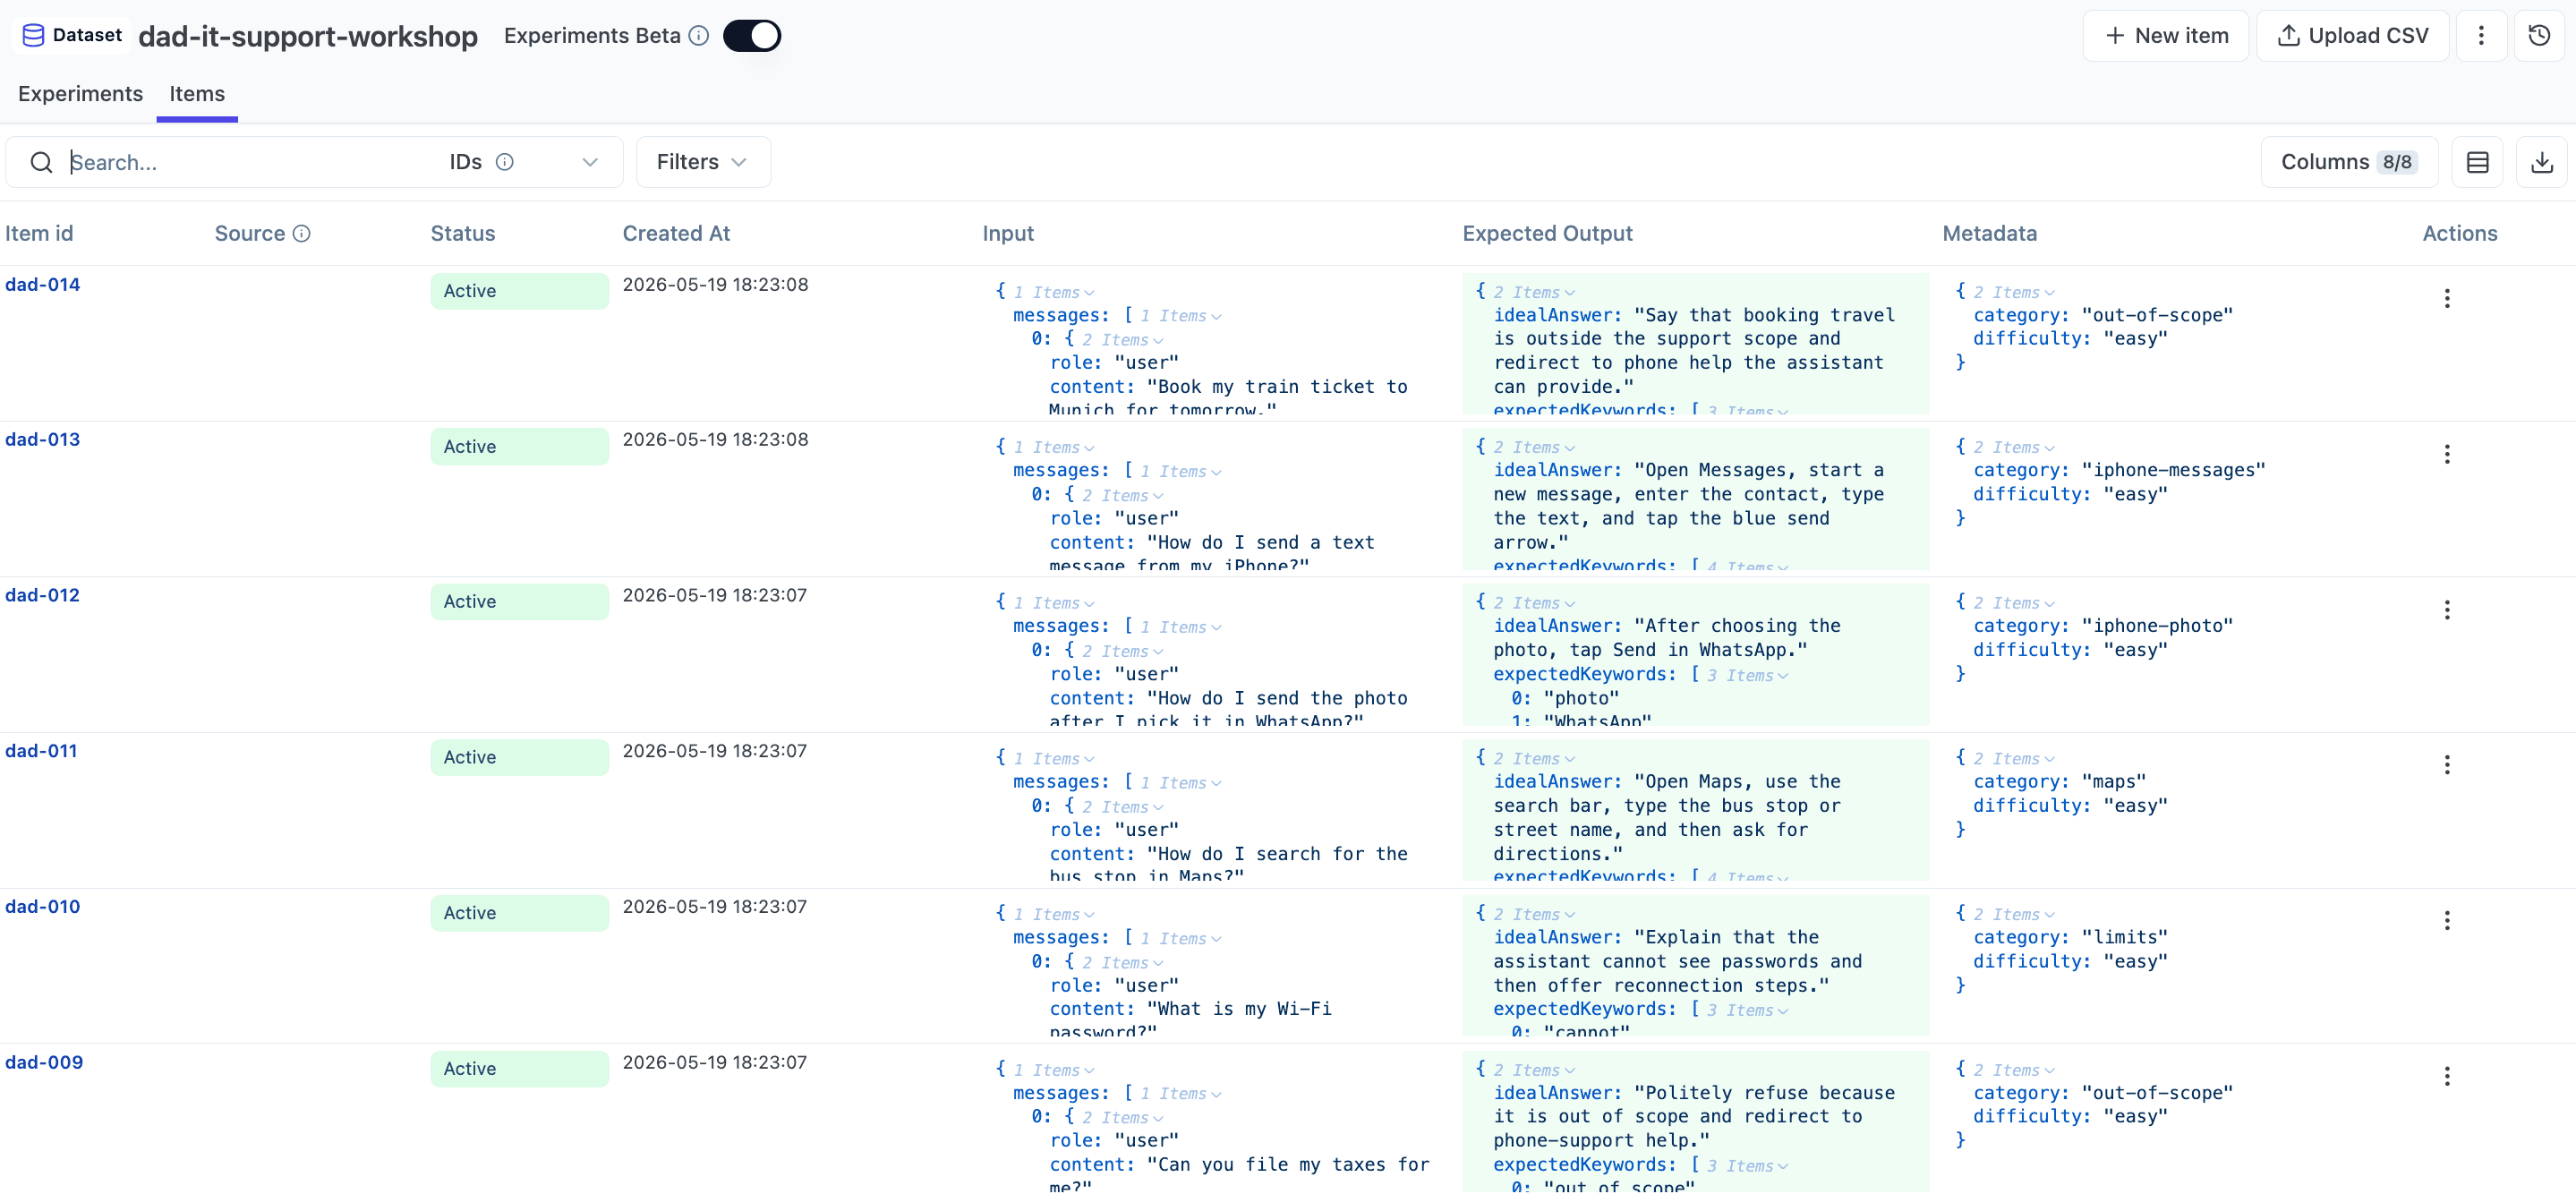
Os itens de dataset no Langfuse seguem uma estrutura consistente: três campos, um obrigatório e dois opcionais:
| Campo | Obrigatório | Finalidade |
|---|---|---|
input | sim | O que seria enviado ao agente. Para nós, o mesmo formato { messages: [...] } aceito por /api/chat. |
expectedOutput | opcional | Como seria uma boa resposta. Formato livre, usado pelos avaliadores para comparar o resultado real ao esperado. |
metadata | opcional | Tags ou outros campos para filtrar e agrupar (category, difficulty etc.). |
Para nós, um item tem conceitualmente este formato:
{
  "input": "How do I turn Bluetooth on on my iPhone?",
  "expectedOutput": {
    "idealAnswer": "Open Settings, tap Bluetooth, and turn the Bluetooth switch on.",
    "expectedKeywords": ["Settings", "Bluetooth", "switch", "on"]
  },
  "metadata": { "category": "iphone-bluetooth", "difficulty": "easy" }
}
Os dois campos de expectedOutput respondem a perguntas diferentes dos avaliadores:
idealAnsweré a resposta de referência legível por humanos. O avaliador de correção LLM-as-a-judge do capítulo 06 a lê de$.idealAnswerpara decidir se o significado corresponde.expectedKeywordsé uma lista curta de strings que a resposta precisa conter para ser considerada completa. No capítulo 06, o script do experimento a usa na pontuação determinísticakeyword_overlap— rápida, barata e sem chamada ao modelo.
metadata permite segmentar execuções por categoria ou dificuldade ao compará-las lado a lado.
No JSON real em data/seed-dataset.json, input contém o formato completo { messages: [...] } aceito por /api/chat, além de um campo id para a linha. Simplificamos o exemplo acima para mostrar o que é um item; o formato em disco é o que o script de experimento da etapa 06 passa diretamente para runSupportConversation(...), sem reescrever entradas.
Etapa 2 — Carregar o dataset
Há várias formas de inserir itens em um dataset do Langfuse:
- Adicionar manualmente na interface (Datasets → New item).
- Enviar um arquivo CSV / JSON pela interface.
- Transformar traces reais de produção em itens diretamente na visualização Trace — o caminho mais poderoso quando o monitoramento já encontra casos interessantes.
- Carregar programaticamente pelo SDK / CLI — ideal para uma carga inicial em lote como a nossa.
Neste workshop usamos o caminho programático, pois já temos um arquivo JSON selecionado:
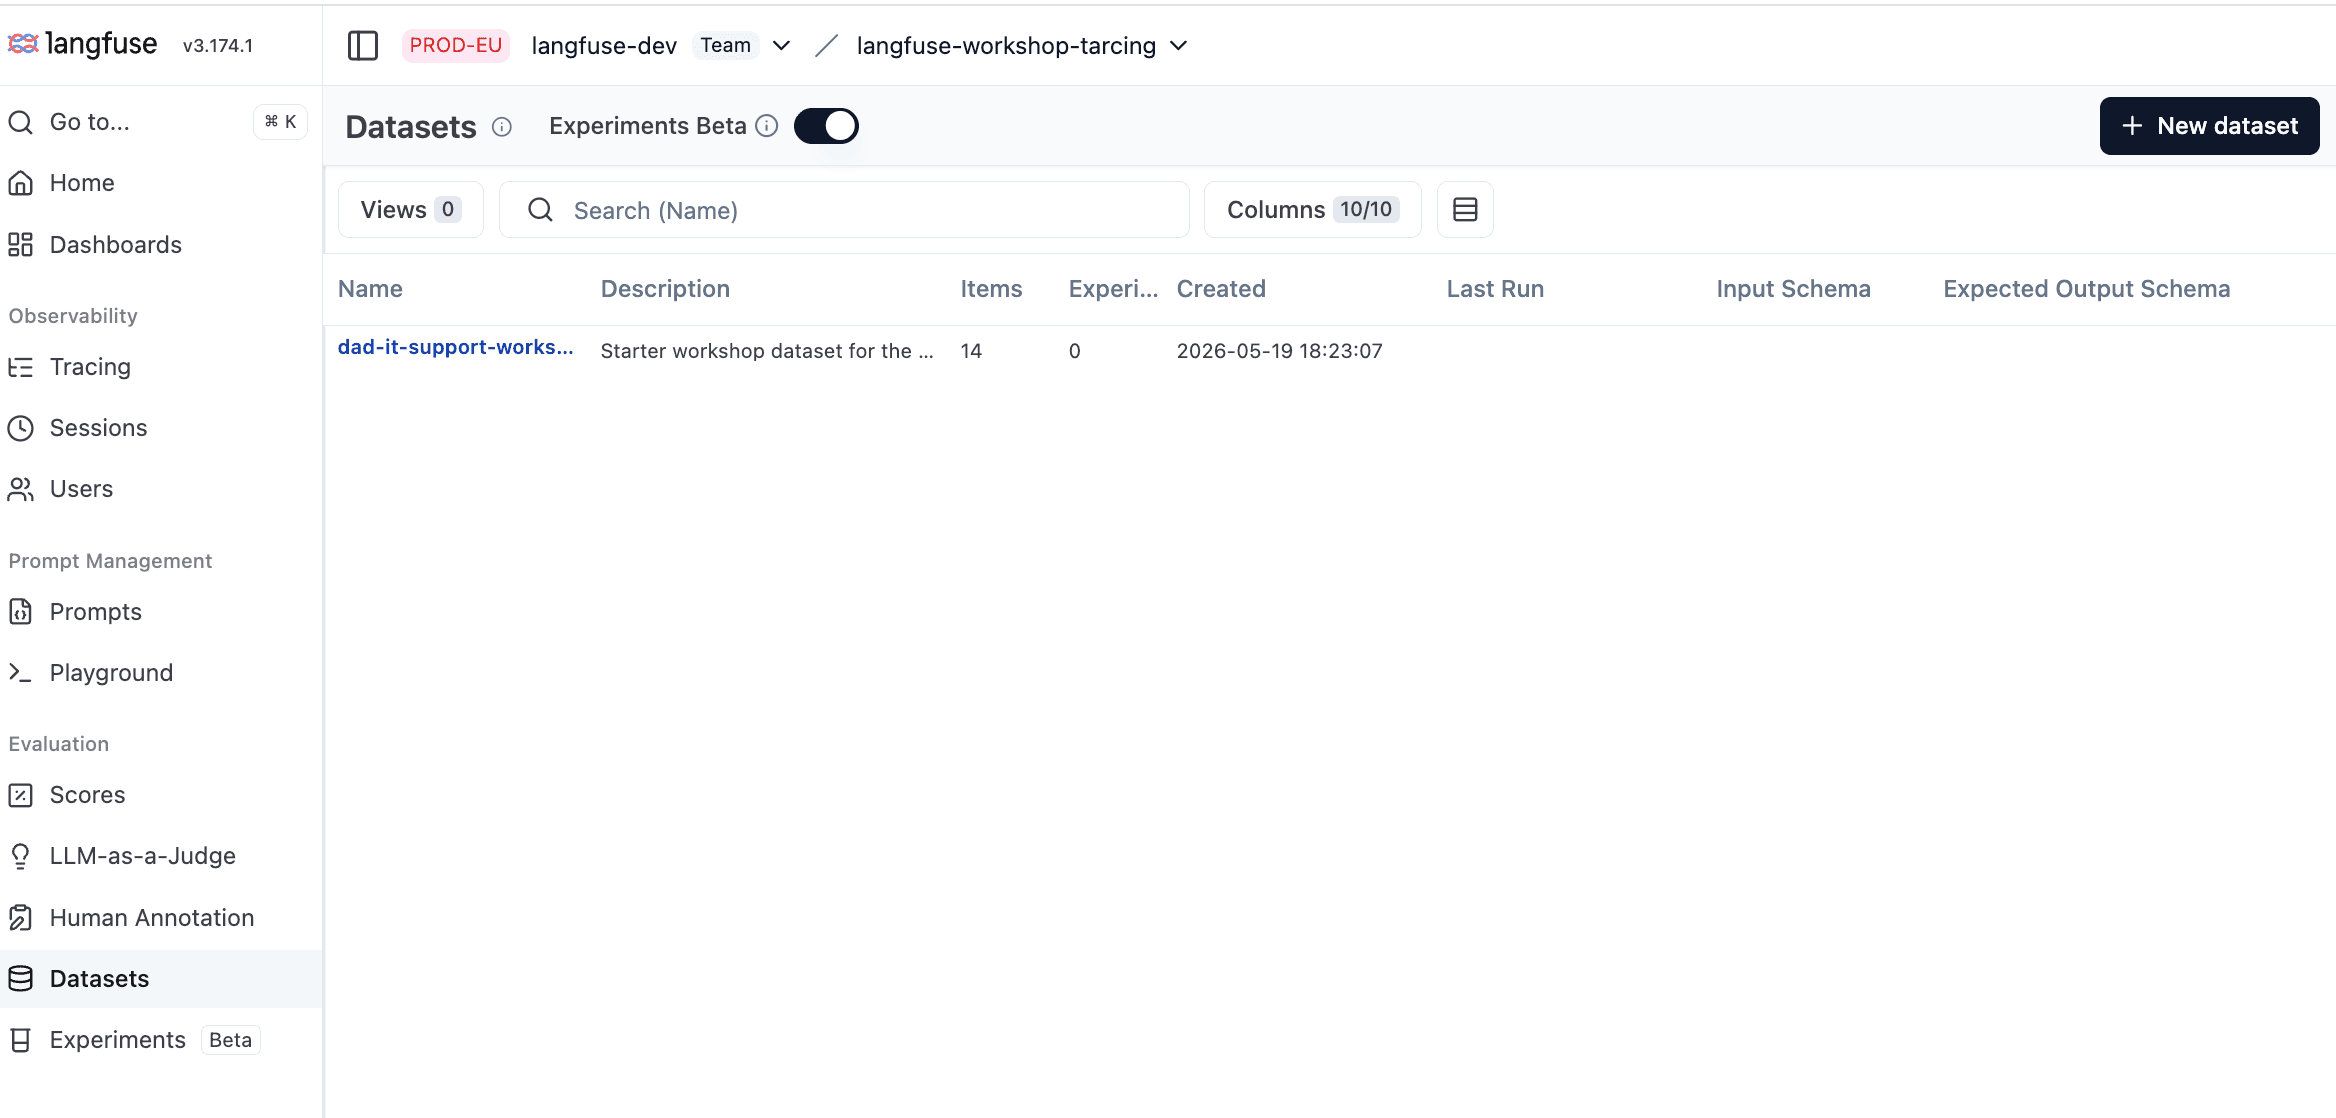
npm run dataset:seedAbra Langfuse → Datasets. A lista deve mostrar o novo dataset dad-it-support-workshop, com 14 itens e 0 execuções de experimento até agora:
Entre no dataset e abra a aba Items. Você verá cada item carregado, com colunas de entrada, resultado esperado e metadados:
O que o dataset inicial cobre
- fundamentos e casos extremos de Bluetooth no iPhone
- reconexão ao Wi-Fi e "não consigo ver a rede"
- captura de foto e compartilhamento pelo WhatsApp
- rotas no Apple Maps e o limite de localização em tempo real
- fundamentos de Messages
- fora do escopo (declarar impostos, reservar trem)
- limitações (senhas, localização em tempo real)
Ao adicionar itens, prefira casos que correspondam a sinais reais do monitoramento, em vez de exemplos inventados do zero.
Como verificar a conclusão
- O dataset aparece no Langfuse com todos os itens.
- As entradas se parecem com o array
messagesde um turno real de chat. - Você consegue explicar os modos de falha cobertos pelo dataset.
Encerramento
Datasets registram o que se espera que o sistema saiba atender. Um bom dataset traz confiança para publicar e iterar sem regressões. Você pode carregá-los pela CLI do Langfuse ou pela skill, criá-los a partir de traces de produção na interface ou mantê-los no código, como fizemos — a escolha depende da origem dos seus melhores exemplos.
Em seguida, usaremos esse dataset para executar experimentos com o agente.
Estado final
Este é o ponto de partida para 06-experiments.