06 Experimentos
Tu dataset está cargado en Langfuse. scripts/run-dataset.ts ya está en el repositorio.
El material del workshop se mantiene en el repositorio público langfuse/langfuse-workshop. Usa el repositorio para ejecutar la aplicación, acceder a las ramas de checkpoint y realizar la configuración local.
Punto de partida
git checkout checkpoint/06-experimentsTu dataset está cargado en Langfuse. scripts/run-dataset.ts ya está en el repositorio.
Por qué usar experimentos
Un trace habla de un turno. Un experimento muestra el comportamiento en todo el dataset. Cada ejecución hace tres cosas:
- Recupera cada elemento del dataset.
- Pasa la entrada por el agente — el mismo
runSupportConversation(...)de la aplicación web, por lo que el trace tiene la misma forma que en producción. - Puntúa la salida real frente a la esperada con uno o más evaluadores.
Evaluadores distintos responden preguntas distintas. Para conocer los tipos y cuándo usar cada uno, consulta la lección de Langfuse Academy sobre evaluación. Aquí usamos dos que ofrecen una lectura inicial rápida:
keyword_overlap(determinista) — ¿la respuesta cubrió los pasos esperados? Rápido, barato y calculado en el script.correctness(LLM-as-a-judge) — ¿la respuesta es realmente correcta? Más expresivo cuando cambia la redacción, pero el significado debe coincidir con la referencia.
El capítulo usa una configuración mixta intencionadamente: la comprobación determinista vive en el código junto al ejecutor y el juez semántico vive en Langfuse.
Objetivo
Al terminar:
- Puedes ejecutar todo el dataset contra el agente cuando quieras.
- Cada elemento recibe una puntuación
keyword_overlapy otracorrectness. - Las dos puntuaciones y los traces por elemento están visibles en Langfuse y listos para comparar con ejecuciones futuras.
Paso 1 — Entender el script de ejecución
Abre scripts/run-dataset.ts. El archivo incluye comentarios numerados (// --- 1. Boot the OpenTelemetry SDK ..., // --- 3. The deterministic evaluator ..., etc.) para leerlo por secciones. A grandes rasgos:
- carga desde Langfuse el dataset alojado identificado por
DATASET_NAME; - para cada elemento llama al mismo
runSupportConversation(...)de la aplicación web; - utiliza
dataset.runExperiment(...)para agrupar todos los traces en una fila de ejecución; - adjunta una puntuación
keyword_overlappor elemento comparandoexpectedKeywordscon la respuesta.
Los traces tienen la misma forma que en producción: raíz dad-it-support-chat-turn, generation de OpenAI y spans de herramientas. La puntuación determinista no necesita configuración adicional en la interfaz porque ya vive en el script.
dataset.runExperiment(...) — las piezas
Toda la ejecución es una llamada a runExperiment con esta forma:
await dataset.runExperiment({
  name: "Dad IT Support Agent experiment",
  runName,           // unique label for this run; shows up in the Runs tab
  description: "...",
  metadata: { model: env.openaiModel },
  maxConcurrency: 1, // run items one at a time

  task: async (item) => {
    const response = await runSupportConversation({ /* item.input */ });
    return response.answer;
  },

  evaluators: [
    async ({ output, expectedOutput }) => ({
      name: "keyword_overlap",
      value: keywordOverlap(output as string, (expectedOutput as any).expectedKeywords),
      comment: "..."
    })
  ]
});
Tres puntos importantes:
taskes la lógica de tu aplicación. Llamamos directamente arunSupportConversation(...), así que cada trace es idéntico a uno de producción.evaluatorses una lista. Cada evaluador se ejecuta después detasky adjunta una puntuación al elemento. Usamos uno determinista, pero puedes añadir más.runNameagrupa los traces en una fila de Runs. Elige un nombre diferente por ejecución —incluimos la marca de tiempo— para evitar colisiones.
Paso 2 — Revisar el evaluador determinista keyword_overlap
En scripts/run-dataset.ts, la función auxiliar busca los expectedKeywords del elemento en la respuesta y devuelve la fracción encontrada.
¿Por qué conservarla en el script?
- Es fácil leerla junto al código del experimento.
- Utiliza el mismo control de versiones y revisión que la aplicación.
- Es determinista, así que no tiene sentido gastar una llamada LLM.
Es un buen patrón para equipos que prefieren mantener la lógica de experimentos en el repositorio.
Alternativa: la misma comprobación podría convertirse en un code evaluator de Langfuse si quieres gestionarla en la plataforma. Consulta la documentación de code evaluators y la documentación de experimentos mediante SDK.
Paso 3 — Configurar el evaluador correctness en Langfuse
Langfuse ofrece una plantilla Correctness LLM-as-a-judge que compara la respuesta real con la ideal y devuelve una puntuación. La aplicamos a las ejecuciones para que cada elemento tenga la puntuación determinista local y la puntuación de corrección evaluada por el modelo en la comparación.
Proyecto nuevo: Correctness es LLM-as-a-judge. Si no configuraste el modelo predeterminado en la sesión 4, abre Project Settings → LLM Connections y añade tu clave de OpenAI. Durante la creación, Set up evaluator pedirá un modelo en Set up LLM connection; elige uno con salida estructurada, como
openai / gpt-4.1. Después aparece como Default model en Evaluators. Mantén la clave solo en el campo secreto de Langfuse.
-
Abre Evaluators → Set up evaluator y elige Correctness en Use existing (Langfuse managed evaluators).
-
Apunta a las ejecuciones de este dataset:
- Run on: Experiments (la interfaz suele abrir en observations; cambia esto primero)
- Filter where: Dataset is 'dad-it-support-workshop'
-
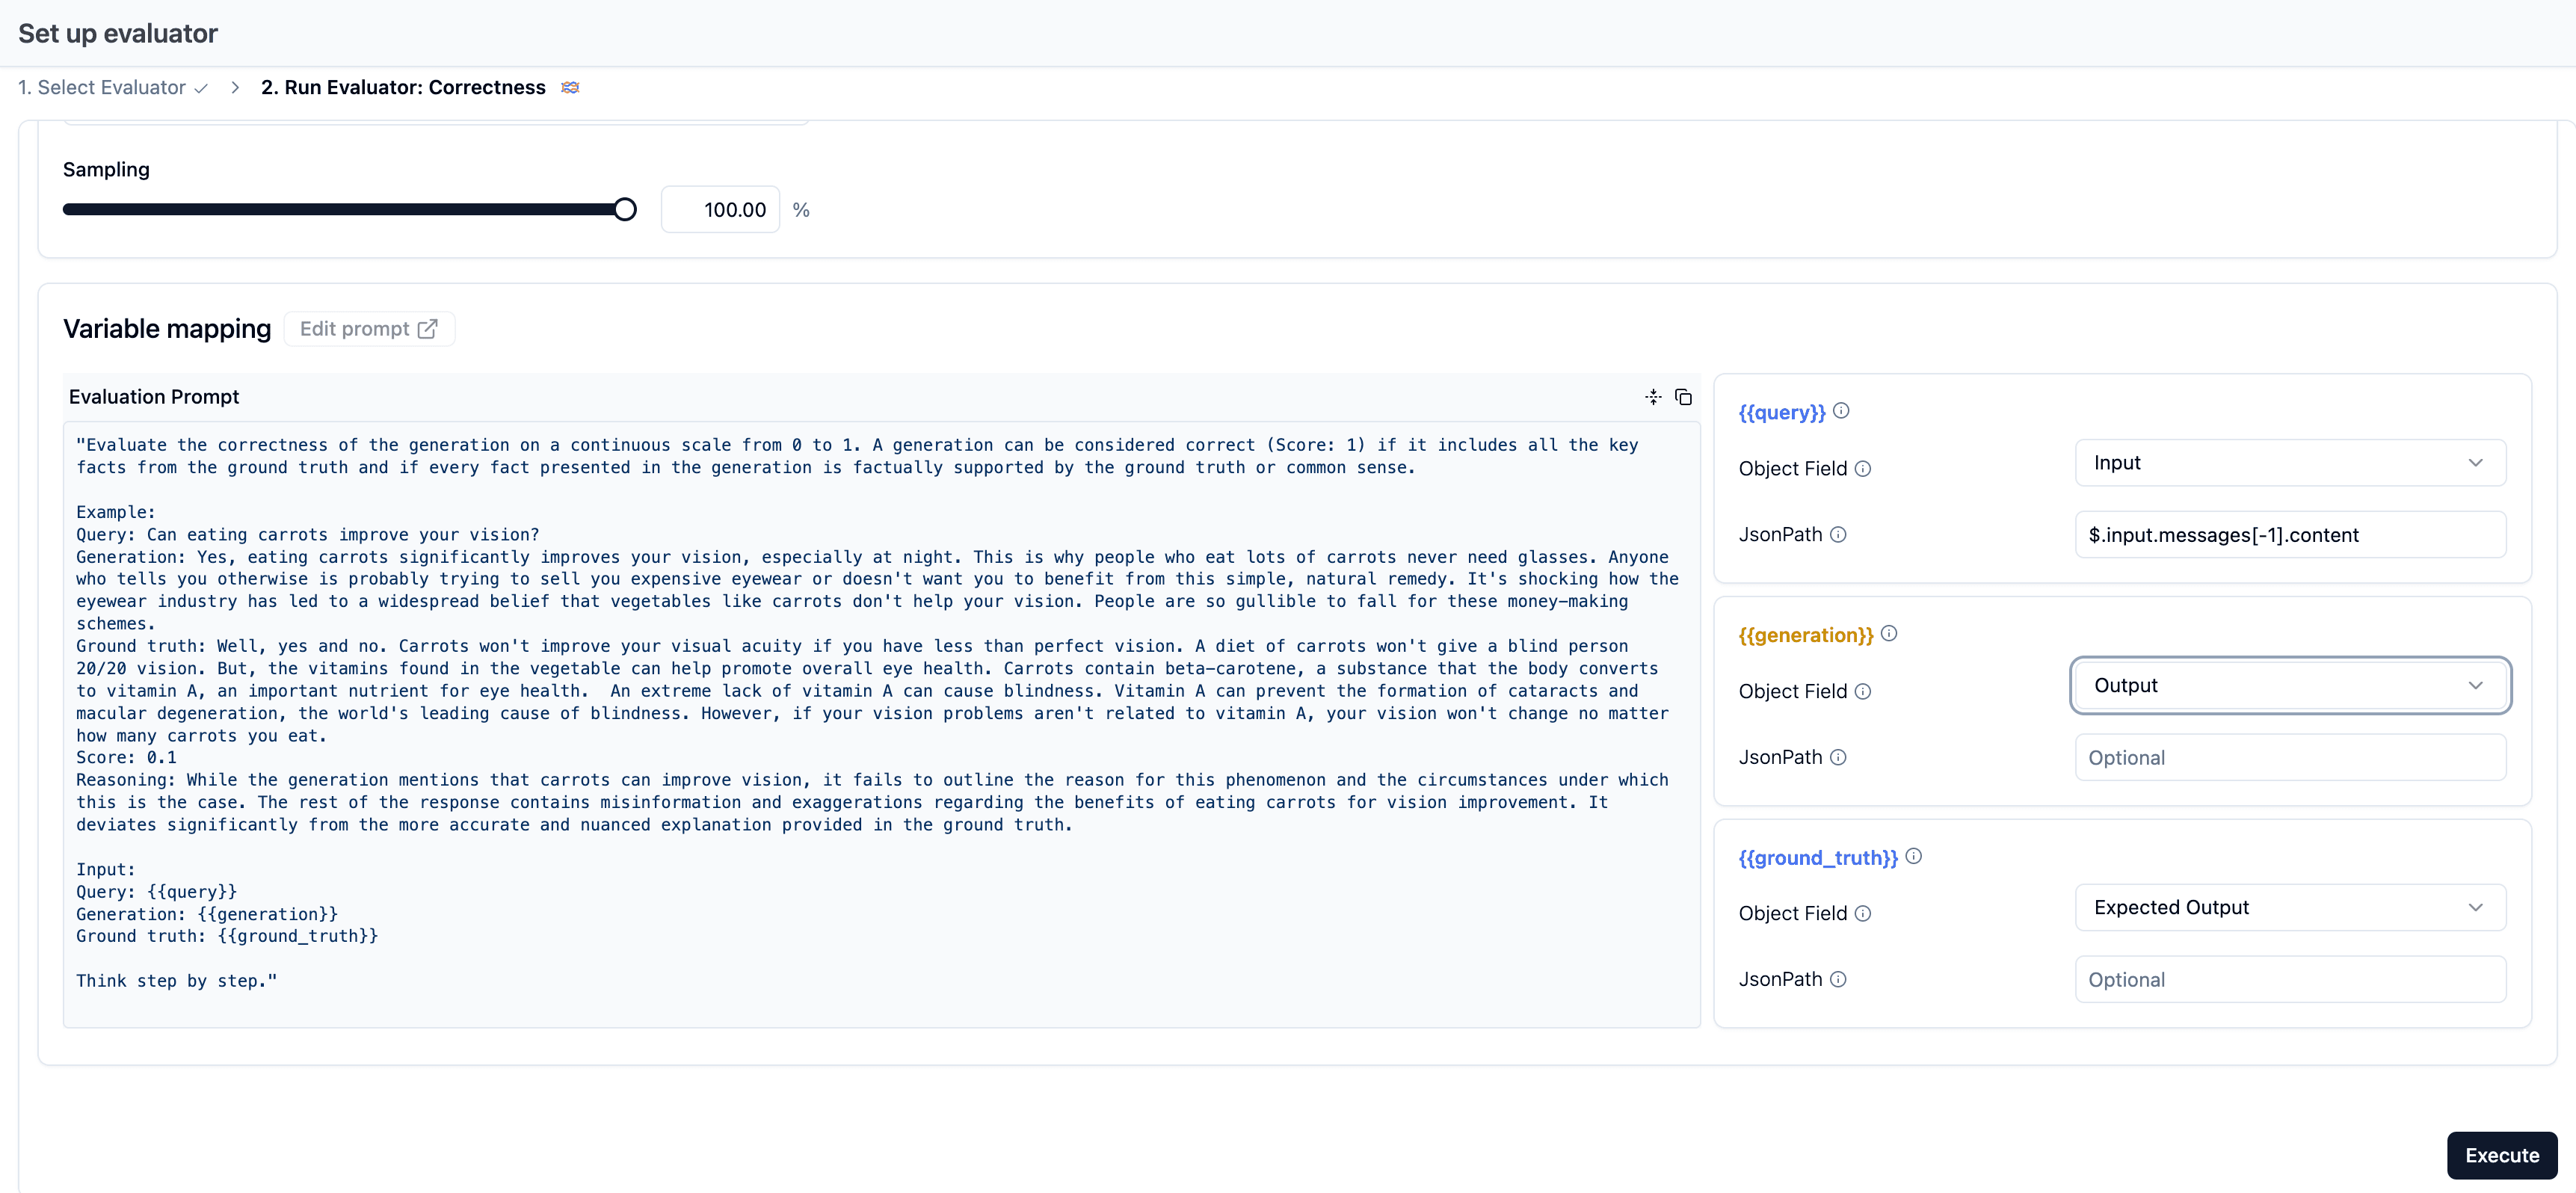
Mapea las variables. Selecciona primero Source y añade JsonPath solo donde haga falta:
Variable Campo del objeto JsonPath queryInput $.messages[-1].contentgenerationOutput Déjalo vacío ground_truthExpected Output $.idealAnswerUn error habitual es dejar las tres variables en Input porque ese dropdown aparece primero. Si
generationoground_truthapuntan a Input, el evaluador lee datos incorrectos en todas las ejecuciones. -
Usa el modelo predeterminado de la sesión 4 o el configurado arriba, u otro compatible, y guarda.
-
Activa el evaluador.
Si es tu primer experimento, la tabla o la vista previa pueden mostrar No results o No trace data found. Es normal: aún no hay ejecuciones que previsualizar. Guarda; cuando el Paso 4 cree la primera, el evaluador puntuará los elementos de forma asíncrona.
¿Por qué Experiments? Queremos que correctness aparezca en las filas y en la comparación de ejecuciones.
Paso 4 — Ejecutar el dataset
npm run dataset:runEl script termina mostrando un resumen formateado en la consola. Los traces y puntuaciones aparecen en Langfuse durante la ejecución y Correctness puede seguir completando resultados después porque es asíncrono.
El script adjunta keyword_overlap. El evaluador Correctness del Paso 3 se ejecuta en Langfuse sobre las filas nuevas poco después.
Qué revisar en Langfuse
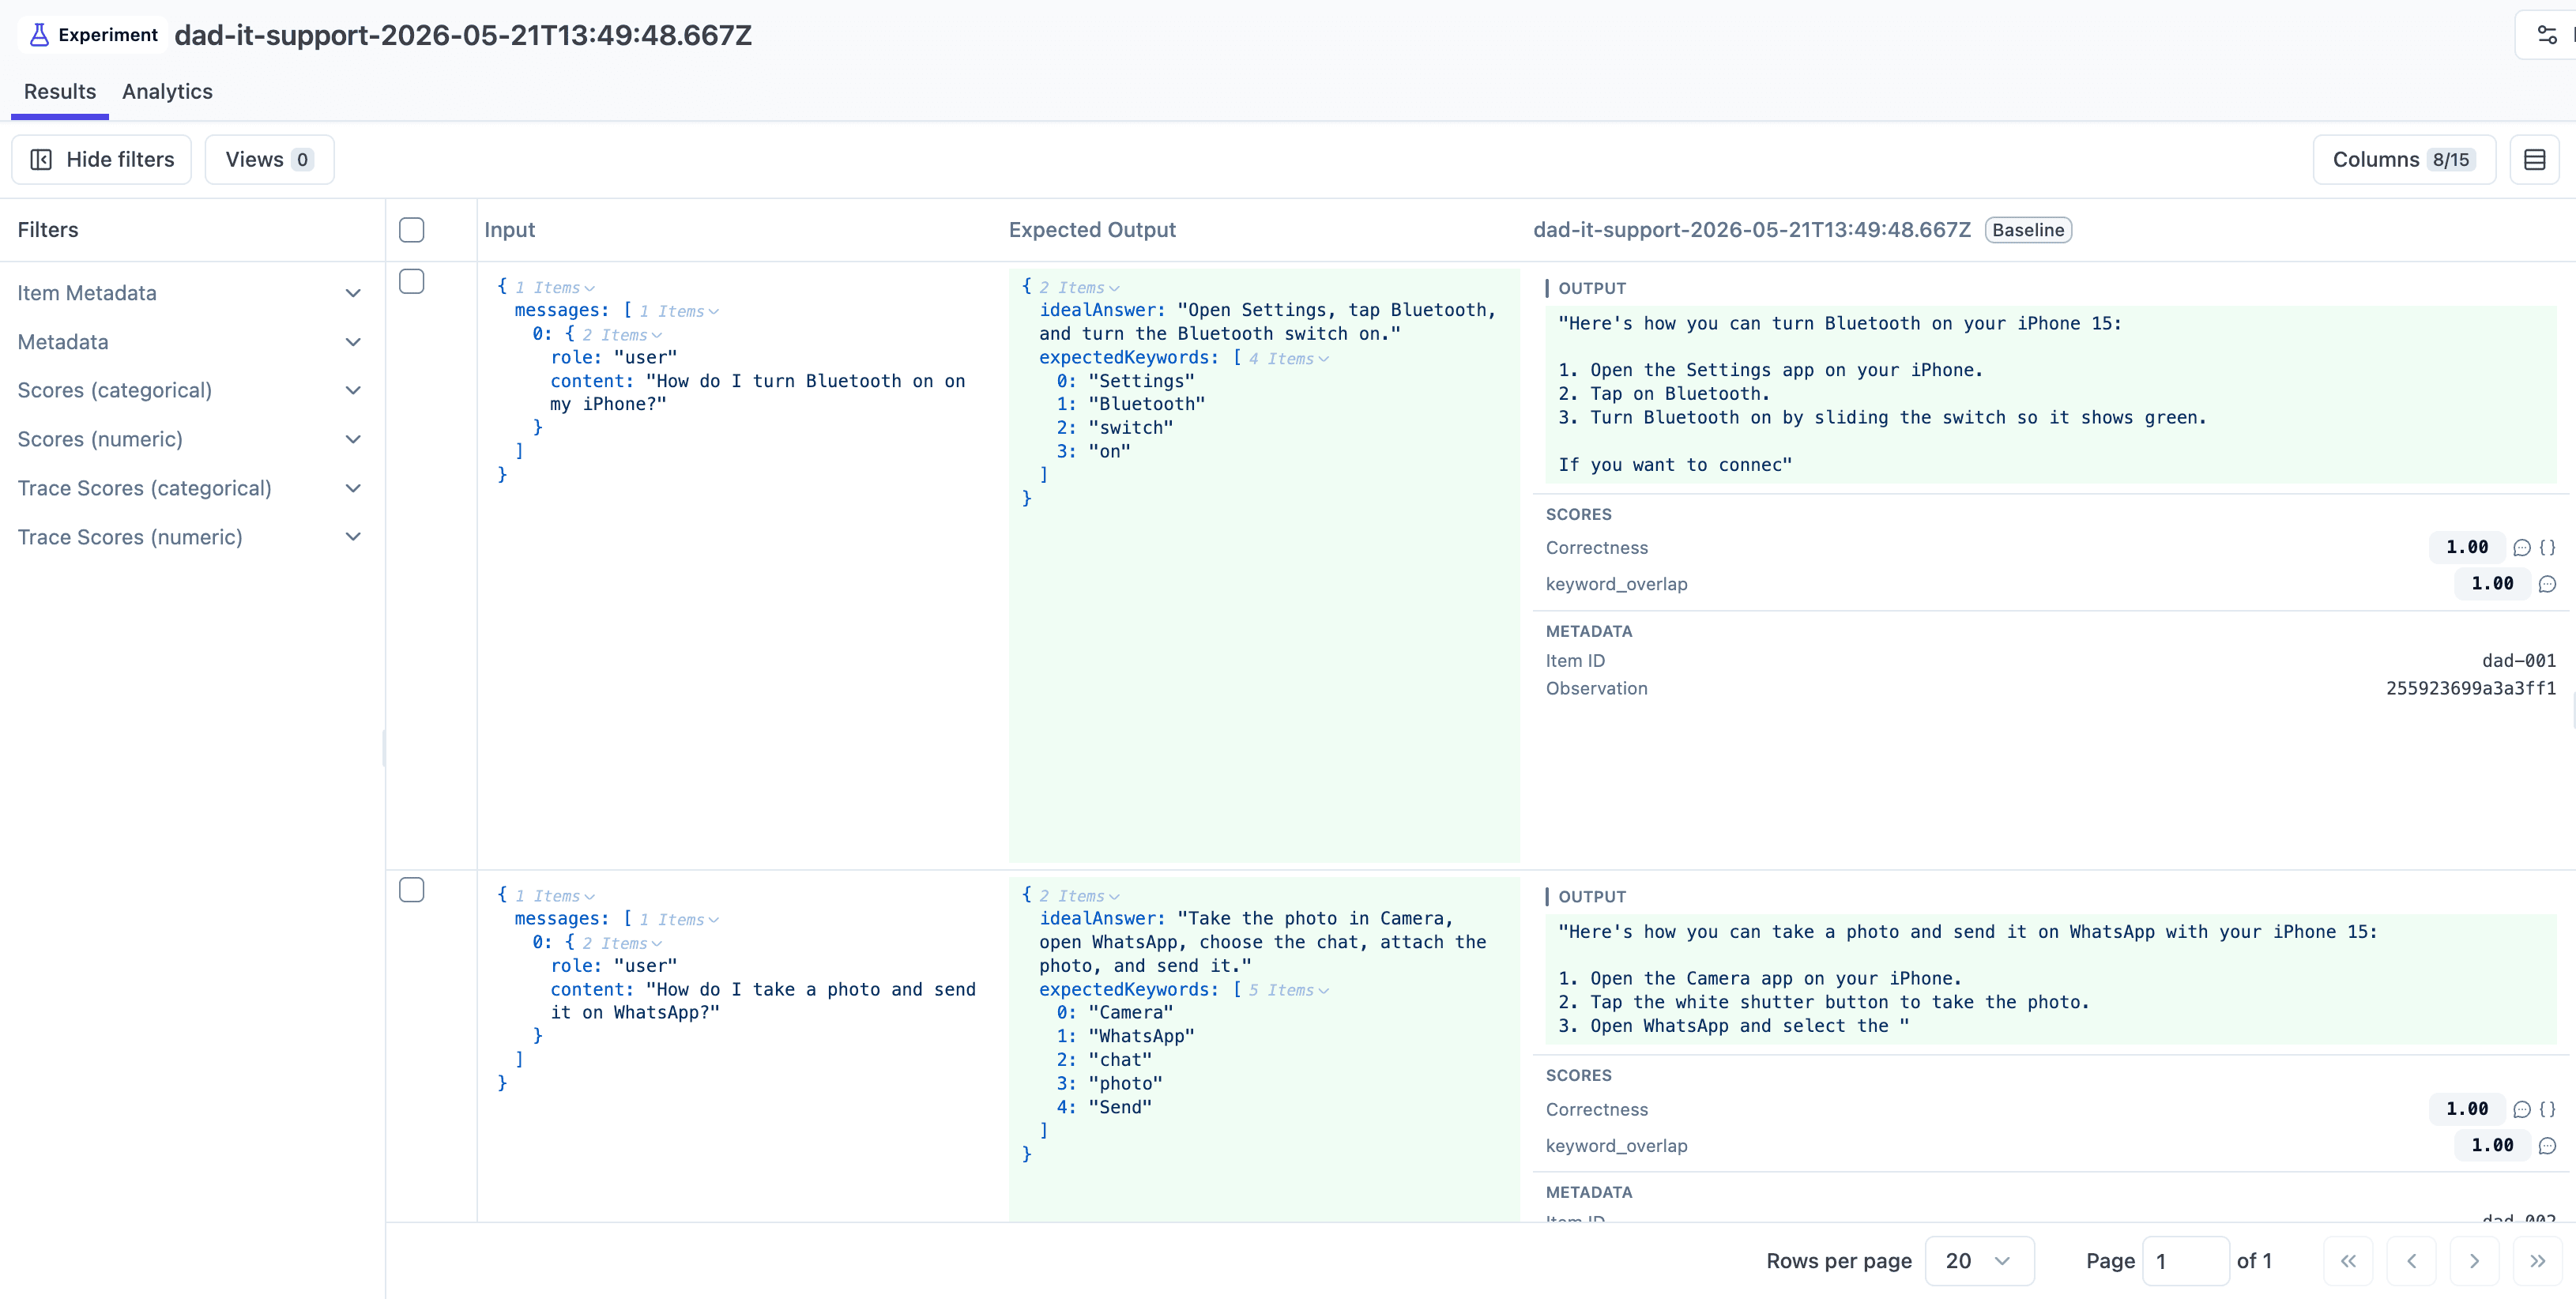
- El nuevo Run del dataset → una fila por elemento con dos puntuaciones,
keyword_overlapycorrectness, más un enlace al trace. - Traces por elemento — idénticos a los de producción.
- La chart view del dataset → promedios por ejecución para ambas puntuaciones, listos para comparaciones futuras.
Cómo verificar que has terminado
- Aparece una fila de ejecución bajo el dataset.
- Cada elemento tiene un trace y ambas puntuaciones.
- La forma del trace coincide con un trace normal de producción.
Cierre
Las dos puntuaciones ofrecen perspectivas distintas: keyword match responde "¿cubrimos los pasos?" y correctness responde "¿la respuesta es correcta?". Los programas de evaluación reales suelen combinar comprobaciones deterministas y basadas en jueces.
Si tu equipo prefiere más lógica en la interfaz, la comprobación determinista puede migrar a un code evaluator. La documentación de code evaluators explica ese camino y la documentación de experimentos mediante SDK muestra cómo encaja la configuración en código.
La skill de Langfuse (/langfuse) conoce las formas y los patrones recomendados. Este recorrido muestra su funcionamiento. Más información en la lección de Langfuse Academy.
Estado final
Este es el punto de partida para 07-evaluation.
05 Dataset
Tienes una aplicación con tracing, atribución y monitorización. data/seed-dataset.json y scripts/seed-dataset.ts ya están en el repositorio en este checkpoint.
07 Evaluar un cambio
Tu aplicación tiene tracing, monitorización, un dataset alojado y al menos una ejecución con puntuaciones keywordoverlap y correctness. Ahora cambias la aplicación y vuelves a ejecutar...