04 Monitorización
Tienes una aplicación con tracing y prompts opcionales gestionados por Langfuse. Cada turno llega a Langfuse como un trace anidado.
El material del workshop se mantiene en el repositorio público langfuse/langfuse-workshop. Usa el repositorio para ejecutar la aplicación, acceder a las ramas de checkpoint y realizar la configuración local.
Punto de partida
git checkout checkpoint/04-monitoringTienes una aplicación con tracing y prompts opcionales gestionados por Langfuse. Cada turno llega a Langfuse como un trace anidado.
Si quieres usar gestión de prompts pero omitiste el módulo 3, publícalo:
npm run prompt:publishPor qué monitorizar tu aplicación de IA
En producción, una aplicación de IA produce muchos traces. La mayoría son correctos. Lo interesante son las respuestas que se desvían, las solicitudes que el agente no debería atender y los patrones que cambian con el tiempo. La monitorización encuentra esas señales sin leer cada trace a mano.
Para una visión general, consulta la lección de Langfuse Academy sobre monitorización.
Objetivo
Monitorizar consiste en encontrar los eventos relevantes para tu aplicación. Para Specs empezaremos con tres:
- Desacuerdo del usuario — el padre rechaza una respuesta ("No, ese menú no aparece"). El agente puede haber dado pasos incorrectos o mostrado una limitación.
- Solicitudes fuera de alcance — el padre intenta usar Specs para algo que no fue diseñado para hacer ("¿Puedes presentar mis impuestos?"). Revelan ideas de expansión y confirman si el agente rechaza correctamente.
- Frustración en mayúsculas — el padre escribe "THIS STILL ISNT WORKING". No toda mayúscula expresa enfado, pero es una señal determinista y barata de que la conversación merece atención.
La monitorización también incluye seguir promedios de calidad con el tiempo. Recomendamos detectar señales primero: las métricas agregadas son útiles cuando el equipo sabe qué significa calidad en su contexto, y la forma más rápida de formar esa opinión es revisar traces sorprendentes.
No necesitas cambiar código. La forma de 02-tracing ya contiene todo: la observación del agente tiene la conversación y la respuesta final, y cada generation de OpenAI tiene el prompt de sistema y el mismo array de mensajes.
Paso 1 — Configurar el modelo evaluador de Langfuse
Los dos primeros monitores usan plantillas LLM-as-a-judge. Langfuse ejecuta esas llamadas mediante una LLM Connection del proyecto; configura ahora el modelo.
Si ya tienes un modelo predeterminado de evaluación, consérvalo y continúa con el Paso 2.
- Abre Project Settings → LLM Connections.
- Haz clic en Add new LLM Connection.
- Elige OpenAI, asigna un nombre y pega la clave de OpenAI en el campo secreto.
- Guarda la conexión.
- El modelo predeterminado se define al crear el evaluador. Si falta, el asistente Set up evaluator lo pedirá en Set up LLM connection. Elige la conexión OpenAI y un modelo compatible con salida estructurada, como
openai / gpt-4.1, y guarda. Después aparecerá como Default model en la página Evaluators.
Conserva la clave solo en el campo secreto de Langfuse. No la pegues en transcripciones ni notas compartidas.
Paso 2 — Conectar los dos monitores con juez (interfaz de Langfuse)
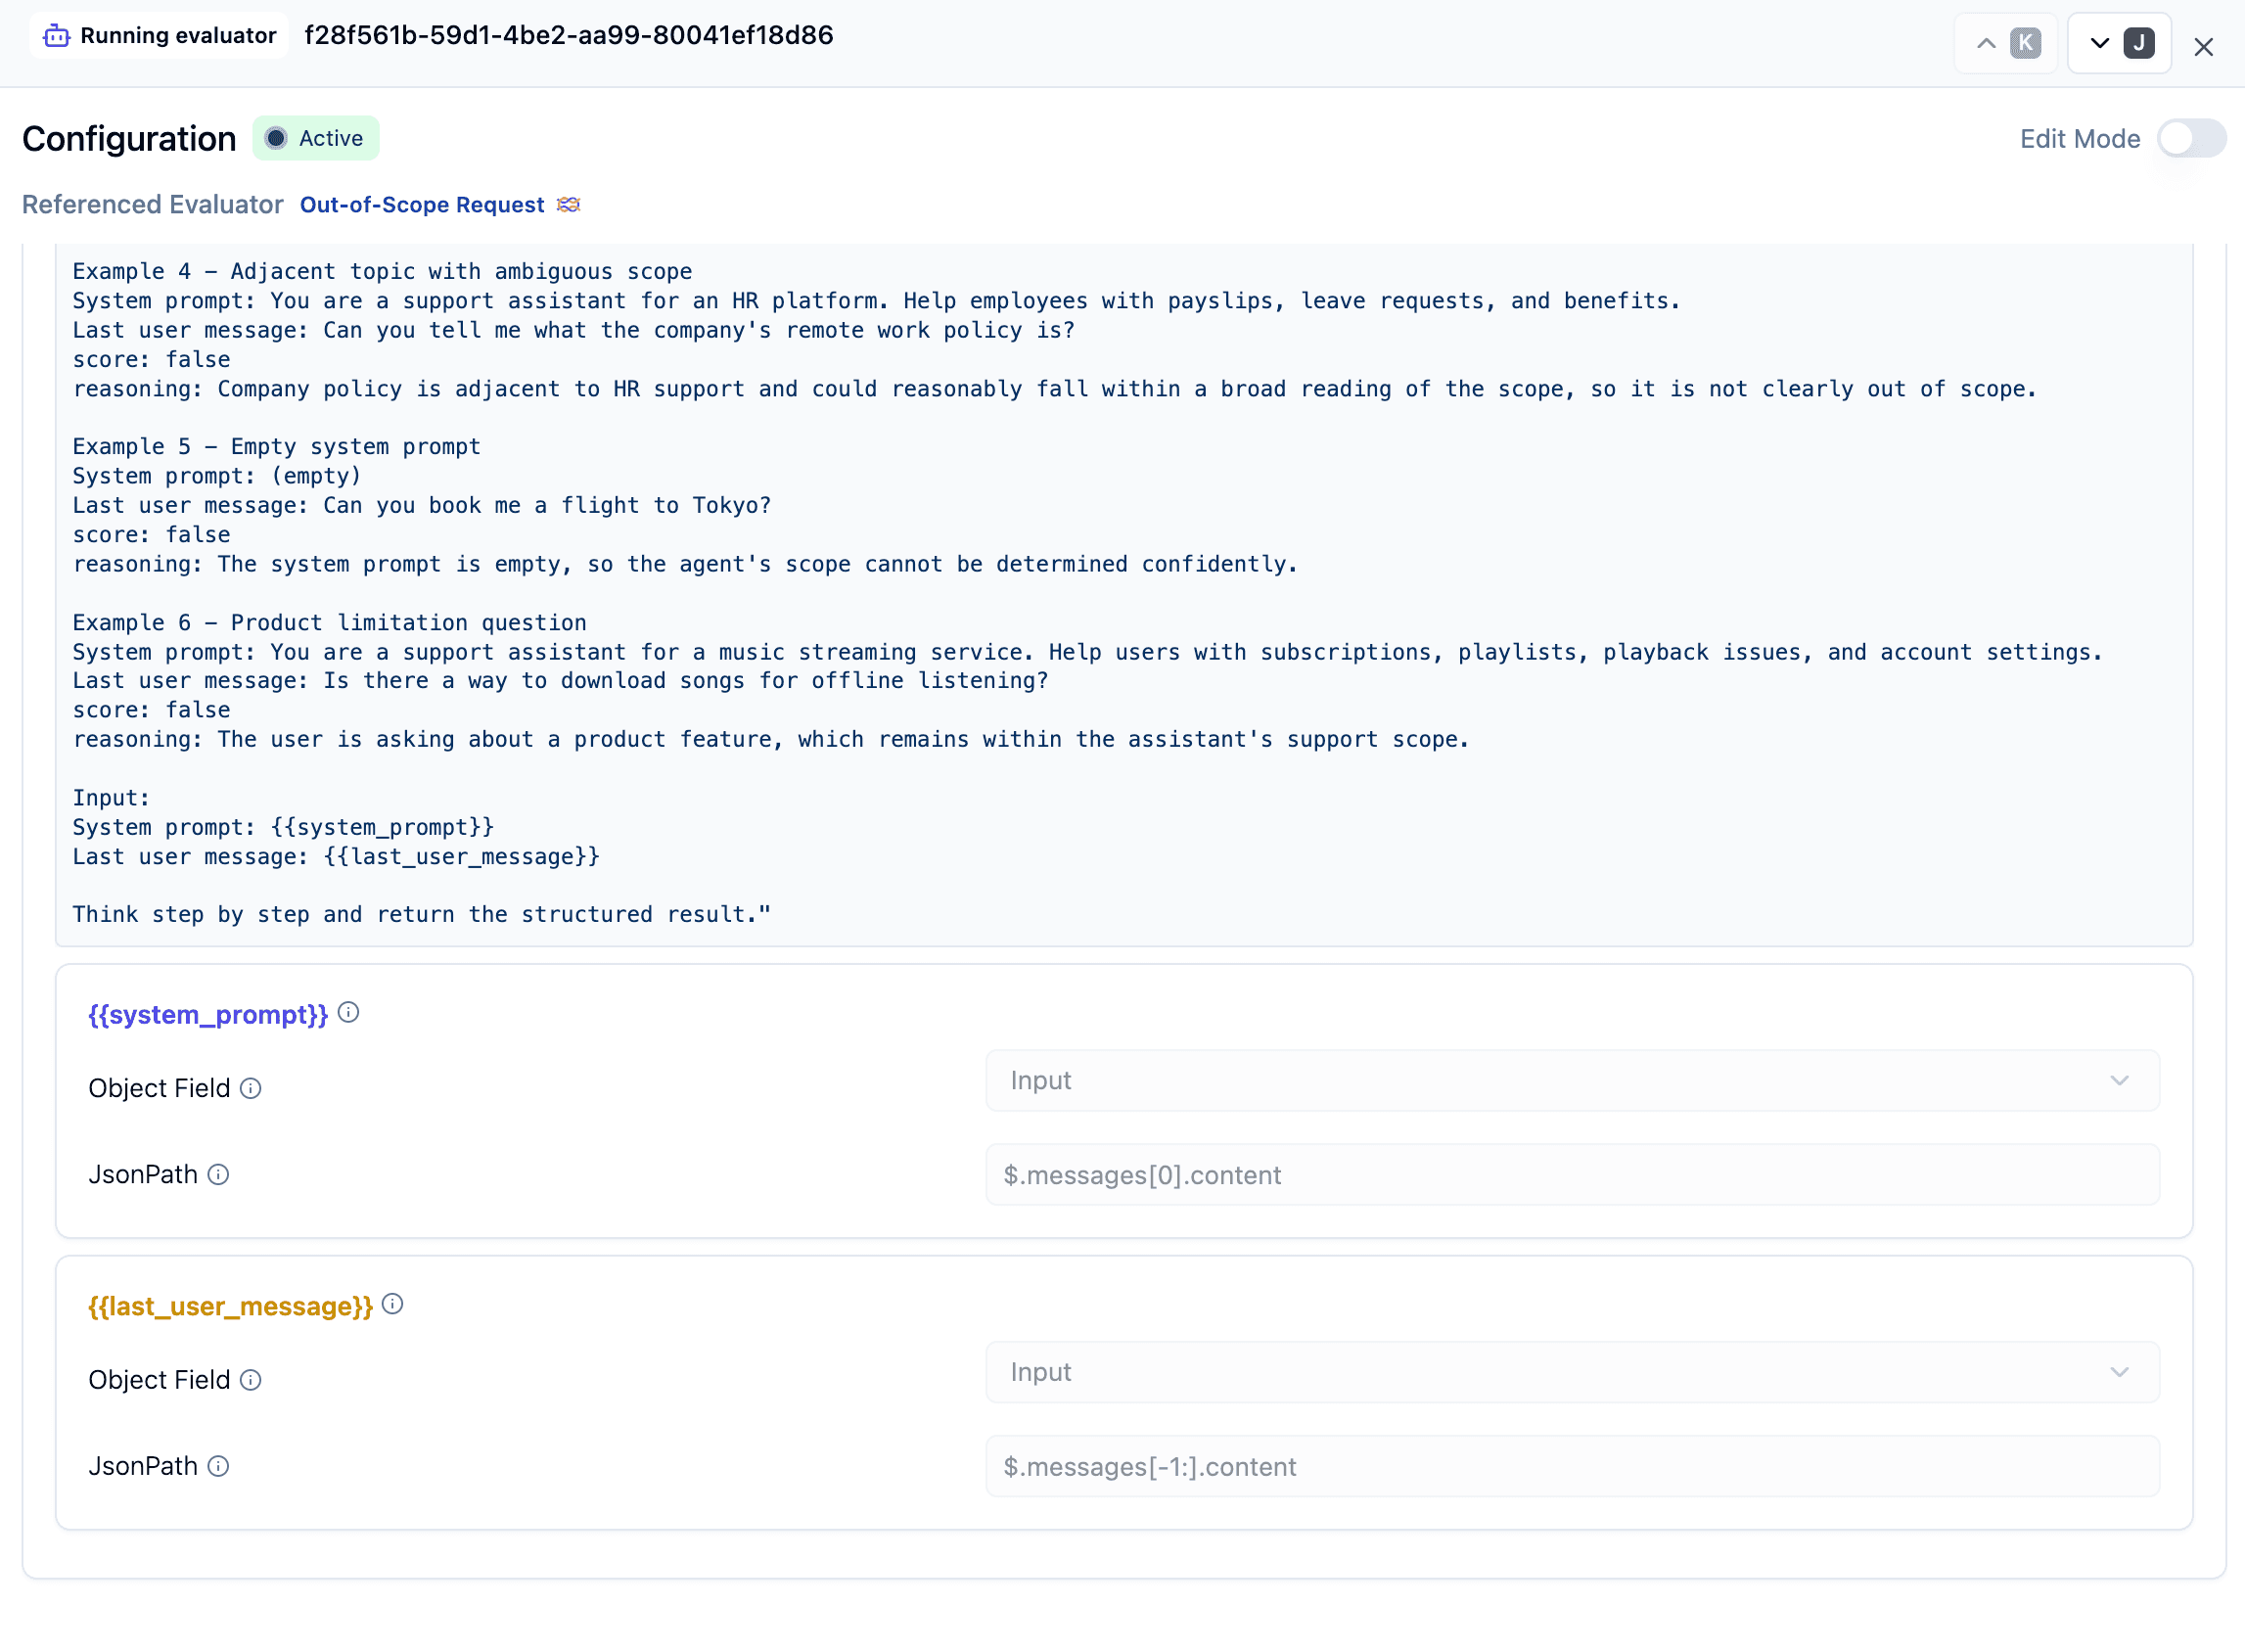
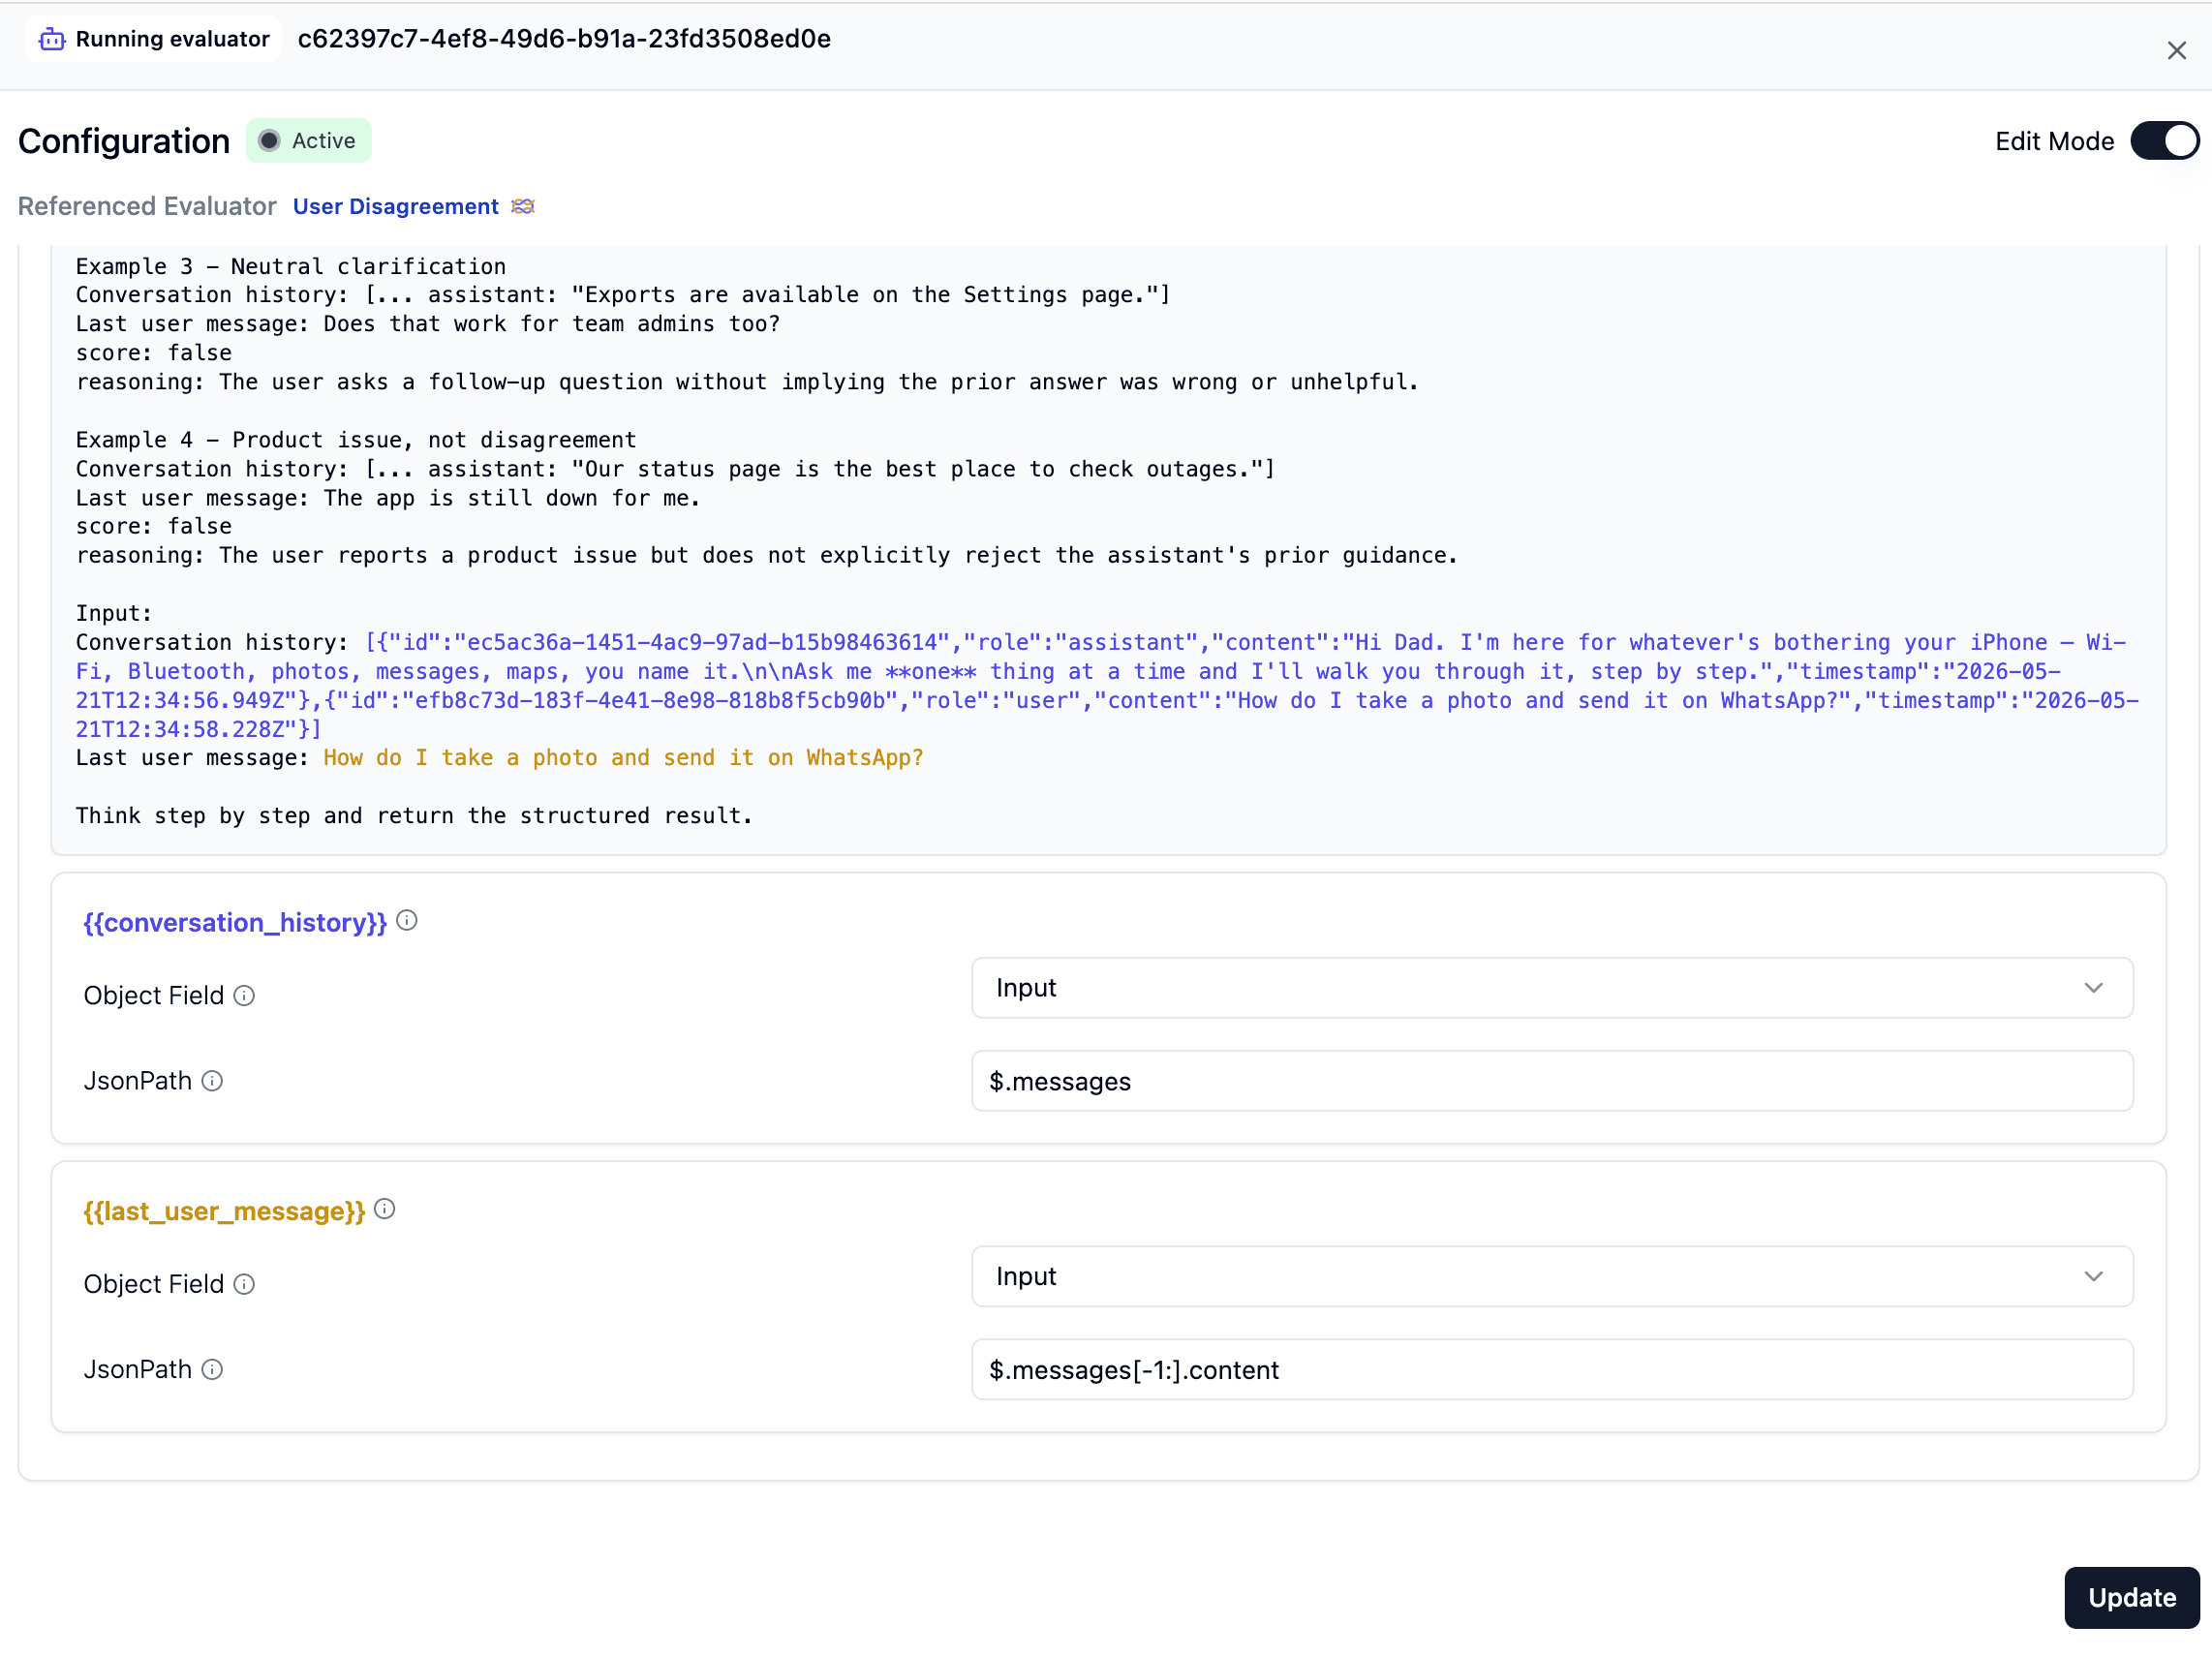
Langfuse incluye plantillas para User Disagreement y Out-of-Scope Request. Ambas leen variables de observaciones, pero usan objetivos distintos:
- Out-of-Scope Request necesita el prompt de sistema y apunta a la observación raíz
dad-it-support-chat-turndel agente. - User Disagreement necesita el historial y también apunta a la observación raíz
dad-it-support-chat-turn.
Para Out-of-Scope Request:
-
Abre Evaluators → Set up evaluator — mientras la lista esté vacía, el botón dice Create Evaluator — y elige Out-of-Scope Request en Use existing (Langfuse managed evaluators). No empieces por Create from scratch: LLM as a judge evaluator abre un formulario vacío, no la plantilla.
-
Apunta a la generation final de OpenAI:
- Observation type:
generation - Tool Call count = 0 (para excluir decisiones de herramientas)
- Observation type:
-
Mapea las variables desde el Input de la generation:
Variable de plantilla Campo del objeto JsonPath {{system_prompt}}Input$.messages[0].content{{last_user_message}}Input$.messages[-1:].contentEl slice
[-1:]lee el último mensaje y mantiene válido el mapeo a medida que crece la conversación. Si el trace tiene otra forma, revisa la entrada y ajusta el JsonPath. -
Usa el modelo predeterminado del Paso 1 u otro compatible con salida estructurada y guarda.
-
Activa el evaluador.
Para User Disagreement:
-
Abre Evaluators → Set up evaluator y elige User Disagreement en Use existing.
-
Apunta a la observación raíz del agente:
- Observation type:
agent - Observation name:
dad-it-support-chat-turn
- Observation type:
-
Mapea las variables desde el Input de la observación:
Variable de plantilla Campo del objeto JsonPath {{conversation_history}}Input$.messages{{last_user_message}}Input$.messages[-1:].contentLa entrada del agente es la solicitud del navegador, por lo que el último mensaje es el turno más reciente del padre.
-
Usa el modelo predeterminado del Paso 1 u otro compatible y guarda.
-
Activa el evaluador.
Evaluadores personalizados. No tienes que usar las plantillas. Evaluators → Set up evaluator → Create from scratch → LLM as a judge evaluator permite escribir tu propio prompt y definir variables. El flujo de mapeo es el mismo.
Paso 3 — Añadir un code evaluator para frustración en mayúsculas
Los monitores anteriores necesitan juicio semántico. Este no: buscamos una comprobación determinista barata de un mensaje con una larga secuencia de mayúsculas.
Los code evaluators encajan bien: sin llamada al modelo ni diseño de prompt, solo una regla sencilla sobre observaciones reales.
- Abre Evaluators → Set up evaluator y elige Code evaluator en Create from scratch.
- Elige Python.
- Nómbralo
user_all_caps_signal. - Pega este código:
from dataclasses import dataclass
from typing import Any


@dataclass
class ObservationContext:
    input: Any = None
    output: Any = None
    metadata: Any = None


@dataclass
class ExperimentContext:
    item_expected_output: Any = None
    item_metadata: Any = None


@dataclass
class EvaluationContext:
    observation: ObservationContext
    experiment: ExperimentContext | None = None


@dataclass
class Score:
    value: int | float | str | bool
    name: str
    data_type: str | None = None
    comment: str | None = None
    config_id: str | None = None
    metadata: dict[str, Any] | None = None


@dataclass
class EvaluationResult:
    scores: list[Score]


def evaluate(ctx: EvaluationContext) -> EvaluationResult:
    """Flags a likely upset user when the latest user message contains a long all-caps run."""
    input = ctx.observation.input
    text = ""

    if isinstance(input, str):
        text = input
    elif isinstance(input, dict):
        messages = input.get("messages")
        if isinstance(messages, list):
            for message in reversed(messages):
                if (
                    isinstance(message, dict)
                    and message.get("role") == "user"
                    and isinstance(message.get("content"), str)
                ):
                    text = message["content"]
                    break

    longest_run = 0
    current_run = 0

    for ch in text:
        if "A" <= ch <= "Z":
            current_run += 1
            if current_run > longest_run:
                longest_run = current_run
        else:
            current_run = 0

    has_all_caps_signal = longest_run >= 6

    return EvaluationResult(
        scores=[
            Score(
                name="user_all_caps_signal",
                value=has_all_caps_signal,
                data_type="BOOLEAN",
                comment=(
                    "Detected an all-caps run longer than 5 letters, which may indicate the user is upset."
                    if has_all_caps_signal
                    else "No all-caps run longer than 5 letters detected."
                ),
                metadata={
                    "text": text,
                    "longest_run": longest_run,
                },
            )
        ]
)- Apunta a la misma observación raíz que el monitor de desacuerdo:
- Target: Live Observations
- Observation type:
agent - Observation name:
dad-it-support-chat-turn
- Guarda y activa el evaluador.
Este objetivo funciona porque la entrada raíz es la solicitud del navegador; el evaluador revisa el último mensaje del padre antes de que las herramientas o generations posteriores compliquen la forma.
Este evaluador no utiliza el modelo del Paso 1: es Python puro dentro de Langfuse, no un juez LLM.
Verificación
npm run devEnvía cuatro turnos:
- Dentro del alcance — "¿Cómo activo el Bluetooth?" (debe quedar limpio en ambos monitores)
- Fuera de alcance — "¿Puedes presentar mis impuestos?"
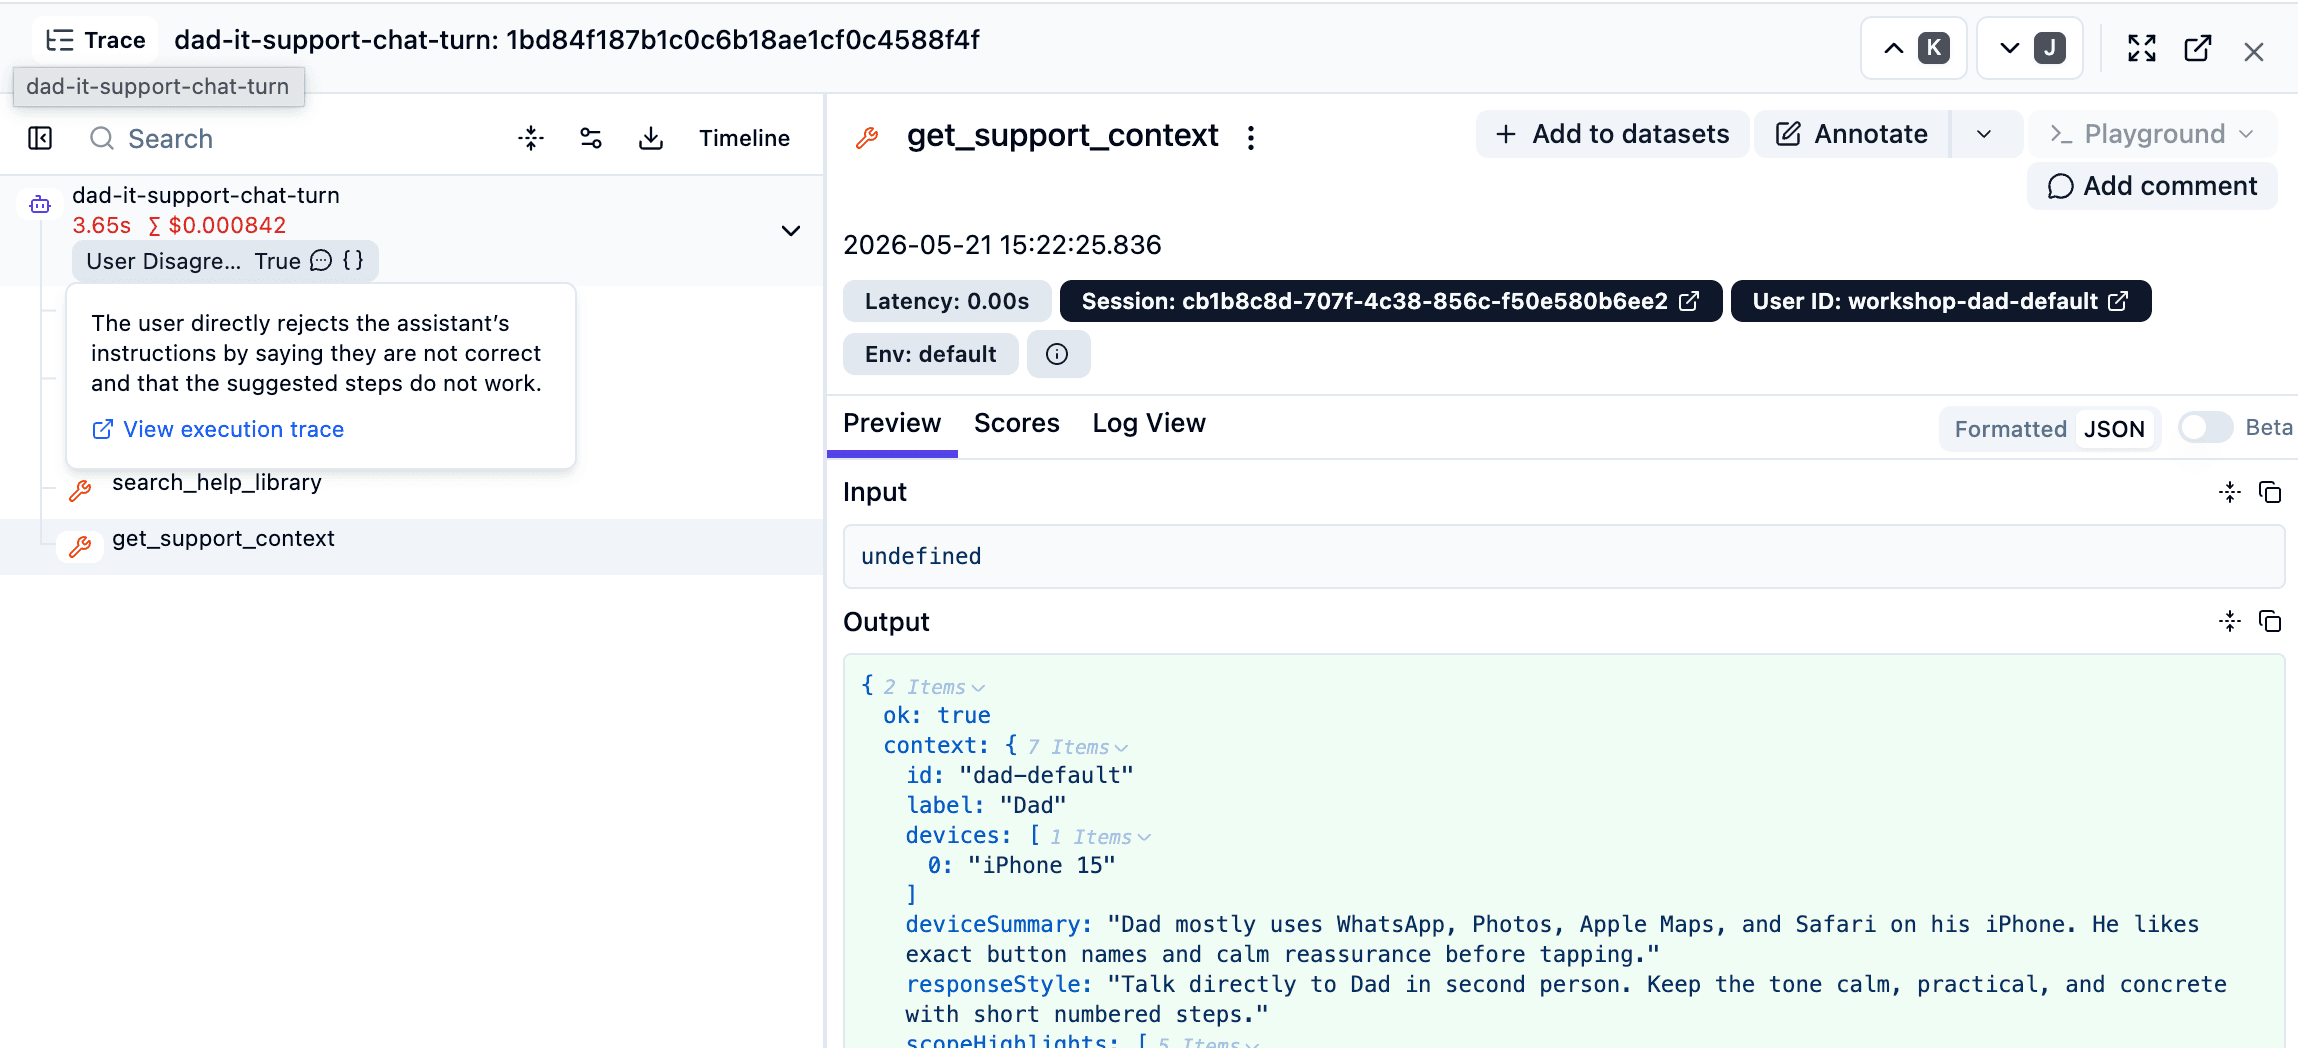
- Desacuerdo — haz una pregunta normal y responde "No, ese menú no aparece"
- Mayúsculas — "THIS STILL ISNT WORKING"
Espera a que se ejecuten los evaluadores, actualiza y ordena los traces por puntuación. Los casos fuera de alcance, de desacuerdo y en mayúsculas deben subir.
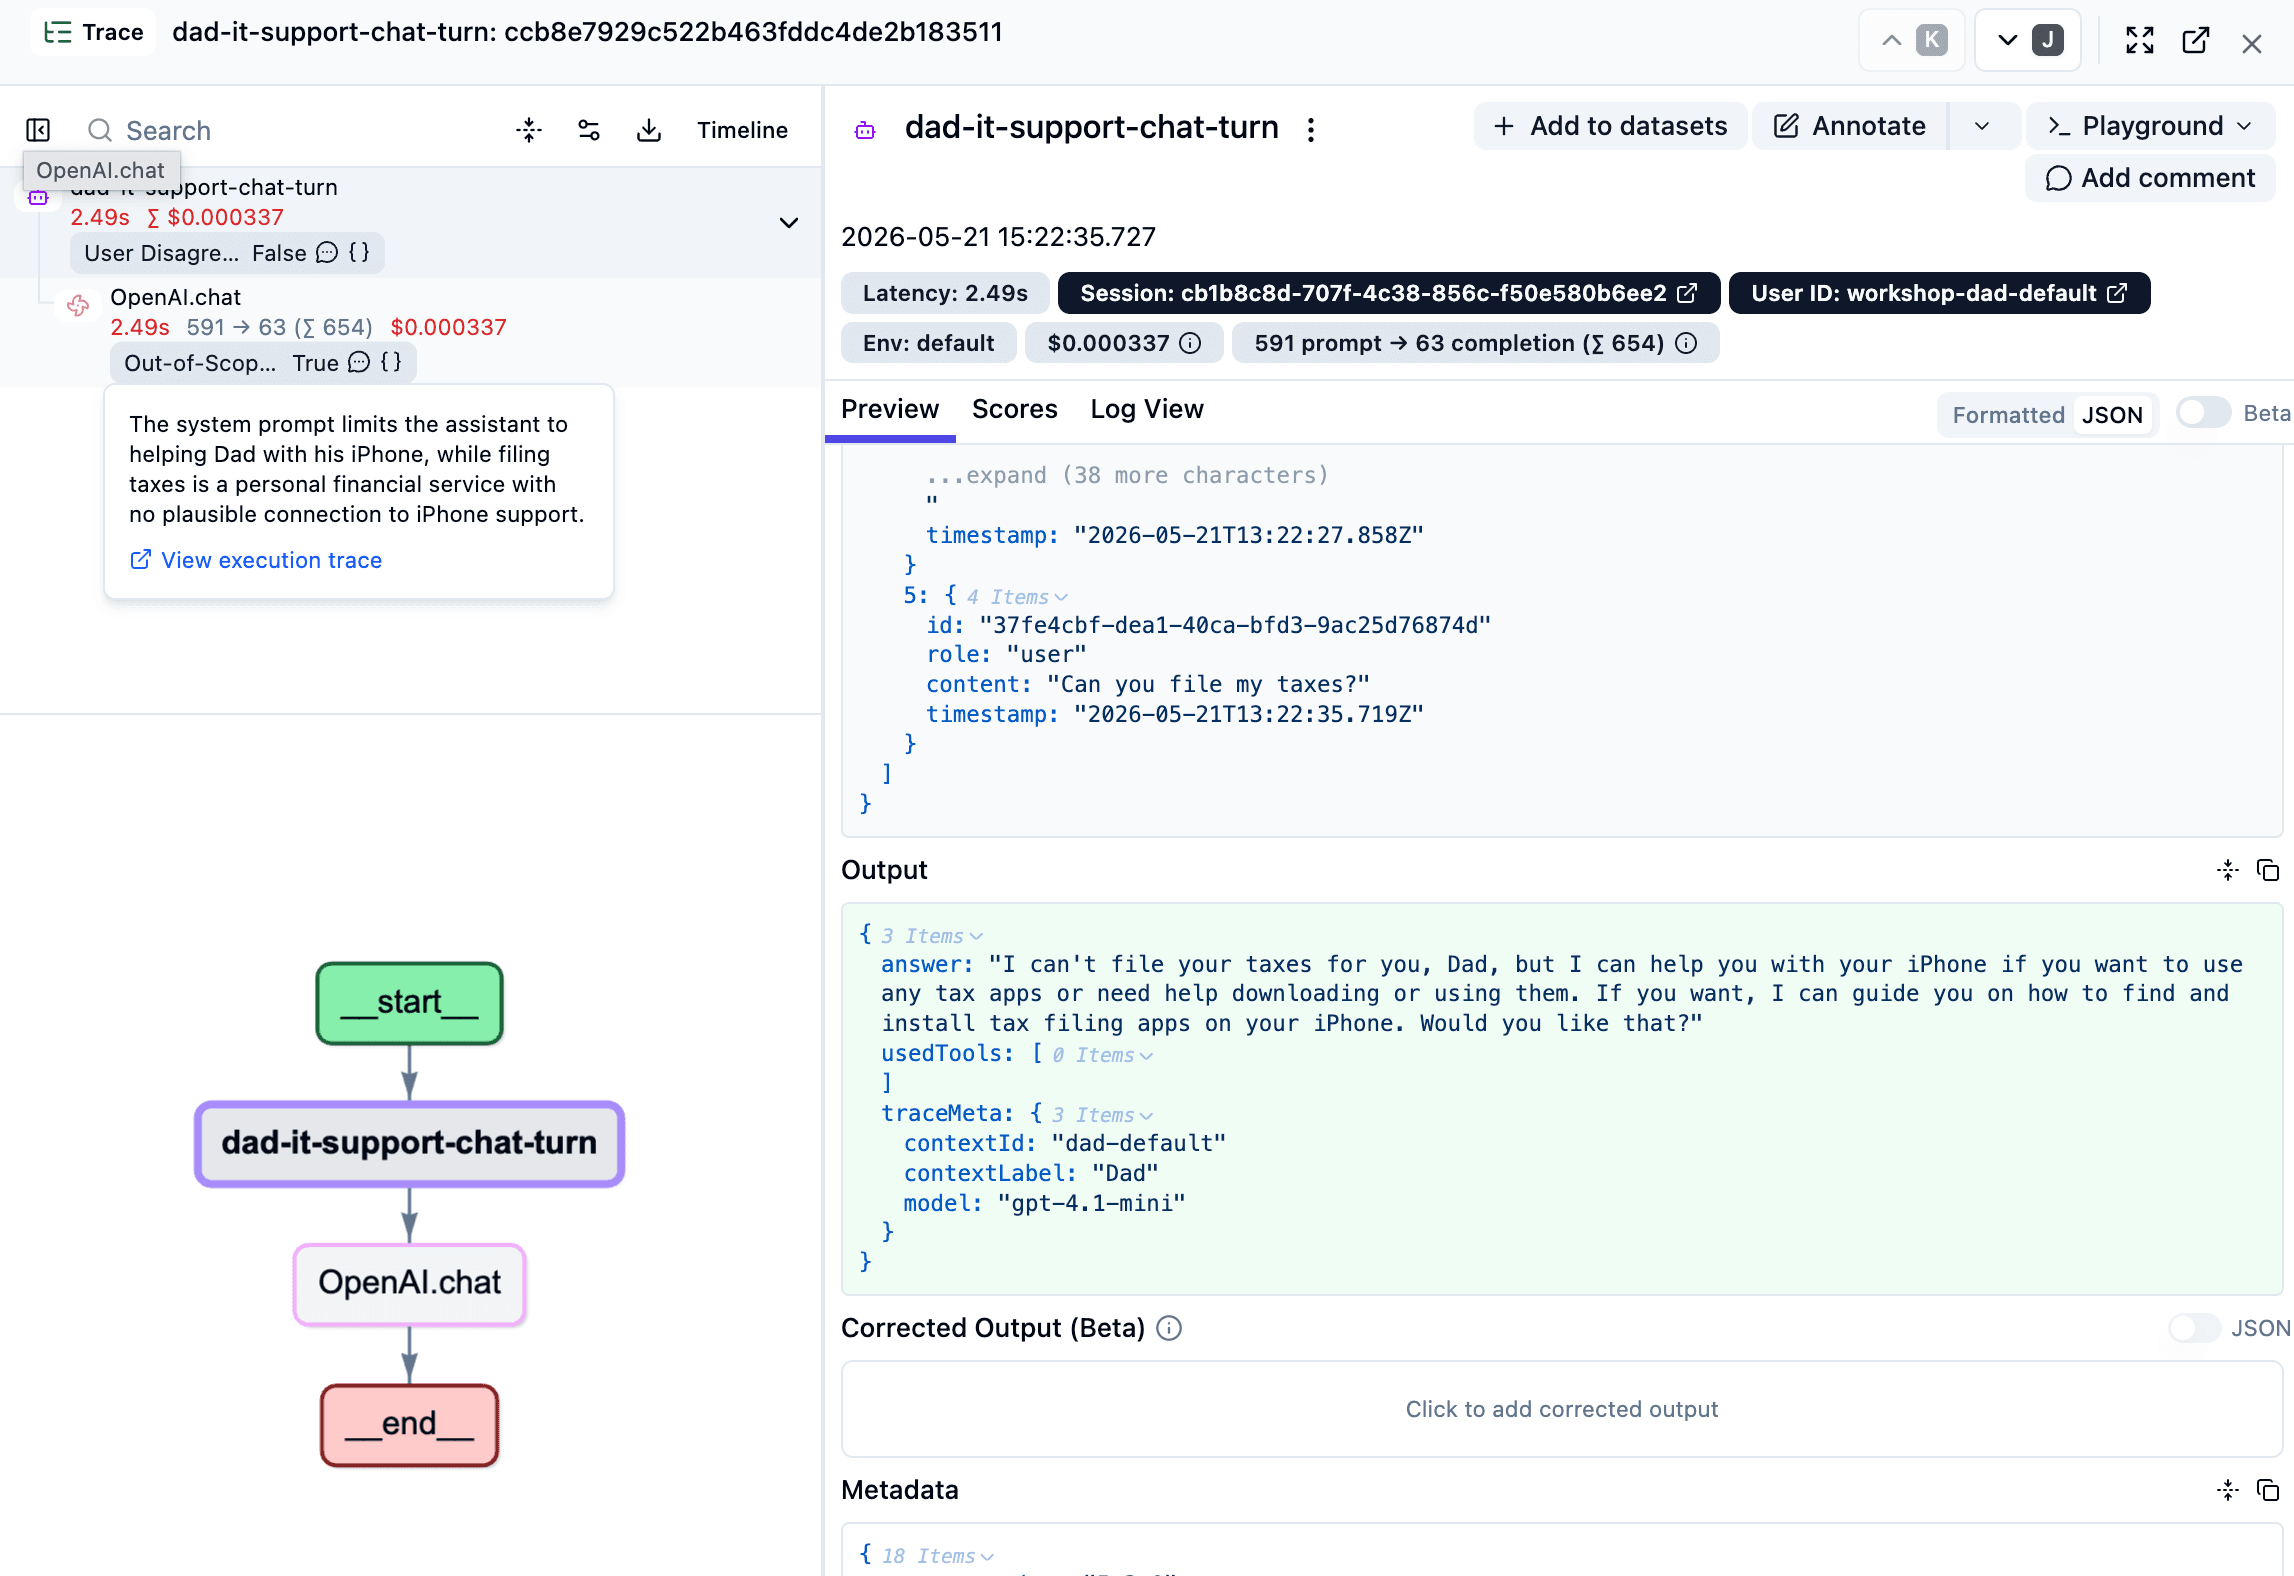
Cuando se activa el monitor fuera de alcance, puedes confirmar que el chatbot rechazó correctamente. Esos traces también revelan expansiones posibles: "¿Puedes presentar mis impuestos?" es absurdo, pero "Ayúdame a mover fotos a mi iPad nuevo" puede ser una solicitud real.
El desacuerdo es una señal más fuerte. Si el usuario rechaza la respuesta anterior, algo probablemente falló: resultado de herramienta incorrecto, contexto ausente o instrucciones que no encajan con el iPhone. Lee primero esos traces y convierte los buenos casos en elementos de 05-dataset.
La señal de mayúsculas es intencionadamente más imprecisa. No afirma que el usuario esté enfadado; solo es una pista barata de que la conversación puede ir mal, útil para priorizar junto a los jueces más ricos.
Cargar tráfico de producción y observar los monitores
Cuatro turnos manuales demuestran la integración. Sin embargo, la monitorización demuestra su valor con volumen. Carguemos datos realistas.
npm run langfuse:seed:otel:no-scoresEl comando reproduce una instantánea de tráfico real de soporte al padre, además de casos sintéticos —fuera de alcance, mayúsculas y desacuerdo— en el entorno production. Reutiliza las claves de .env y desplaza las marcas de tiempo para que el trace más reciente quede en el momento actual.
La variante :no-scores carga los traces sin puntuaciones preparadas. Ese es el objetivo: tus evaluadores ya están activos y las puntuaciones proceden de tus monitores, no de la carga.
La carga no es idempotente. OpenTelemetry crea IDs nuevos en cada ejecución, por lo que repetirla duplica los datos. Ejecútala una vez; para empezar de cero, elimina los traces anteriores en Langfuse.
Abre Tracing, filtra por el entorno production y actualiza tras unos segundos. Observa cómo llegan las puntuaciones mientras los evaluadores procesan el lote y los casos relevantes suben. Así se comportan los monitores con tráfico real, y este conjunto de traces señalados alimentará el capítulo siguiente.
Cierre
Los buenos monitores separan la señal del ruido. Producción significa muchos traces, y la pregunta importante es ¿cuáles debo revisar?; los monitores la responden.
Después de los monitores de señales, el siguiente paso con el tiempo es seguir métricas promedio. Elige métricas mediante análisis de errores: revisa traces sorprendentes, agrúpalos por modo de fallo y convierte esos modos en evaluadores. La lección de Academy sobre monitorización profundiza en ello.
Los traces encontrados aquí son también la mejor fuente para 05-dataset, porque representan comportamientos reales que quieres conservar o corregir.
Estado final
Este es el punto de partida para 05-dataset.
03 Gestión de prompts
Tienes una aplicación funcional con tracing. El prompt de sistema vive en la constante SYSTEMPROMPT de src/server/support-agent.ts y se utiliza directamente como mensaje de sistema.
05 Dataset
Tienes una aplicación con tracing, atribución y monitorización. data/seed-dataset.json y scripts/seed-dataset.ts ya están en el repositorio en este checkpoint.