05 Dataset
Tienes una aplicación con tracing, atribución y monitorización. data/seed-dataset.json y scripts/seed-dataset.ts ya están en el repositorio en este checkpoint.
El material del workshop se mantiene en el repositorio público langfuse/langfuse-workshop. Usa el repositorio para ejecutar la aplicación, acceder a las ramas de checkpoint y realizar la configuración local.
Punto de partida
git checkout checkpoint/05-datasetTienes una aplicación con tracing, atribución y monitorización. data/seed-dataset.json y scripts/seed-dataset.ts ya están en el repositorio en este checkpoint.
Comprueba que .env contiene:
DATASET_NAME=dad-it-support-workshopPor qué crear datasets
Un dataset representa lo que el sistema encontrará en producción: las entradas esperadas y, para cada una, cómo sería una buena respuesta. Con expectativas claras por escrito, puedes volver a ejecutar el agente después de cada cambio y saber si el resultado mejoró o empeoró. Un buen dataset es la base para publicar con confianza e iterar sin regresiones.
Más información en la lección de Langfuse Academy sobre datasets.
Objetivo
Cargar un primer dataset que represente las solicitudes que esperamos que Specs atienda. Para ello:
- Entender la forma del elemento — todos tienen los mismos tres campos y queremos que los nuestros coincidan con la entrada real del agente.
- Cargar el dataset alojado para que viva en Langfuse y quede listo para los experimentos del paso siguiente.
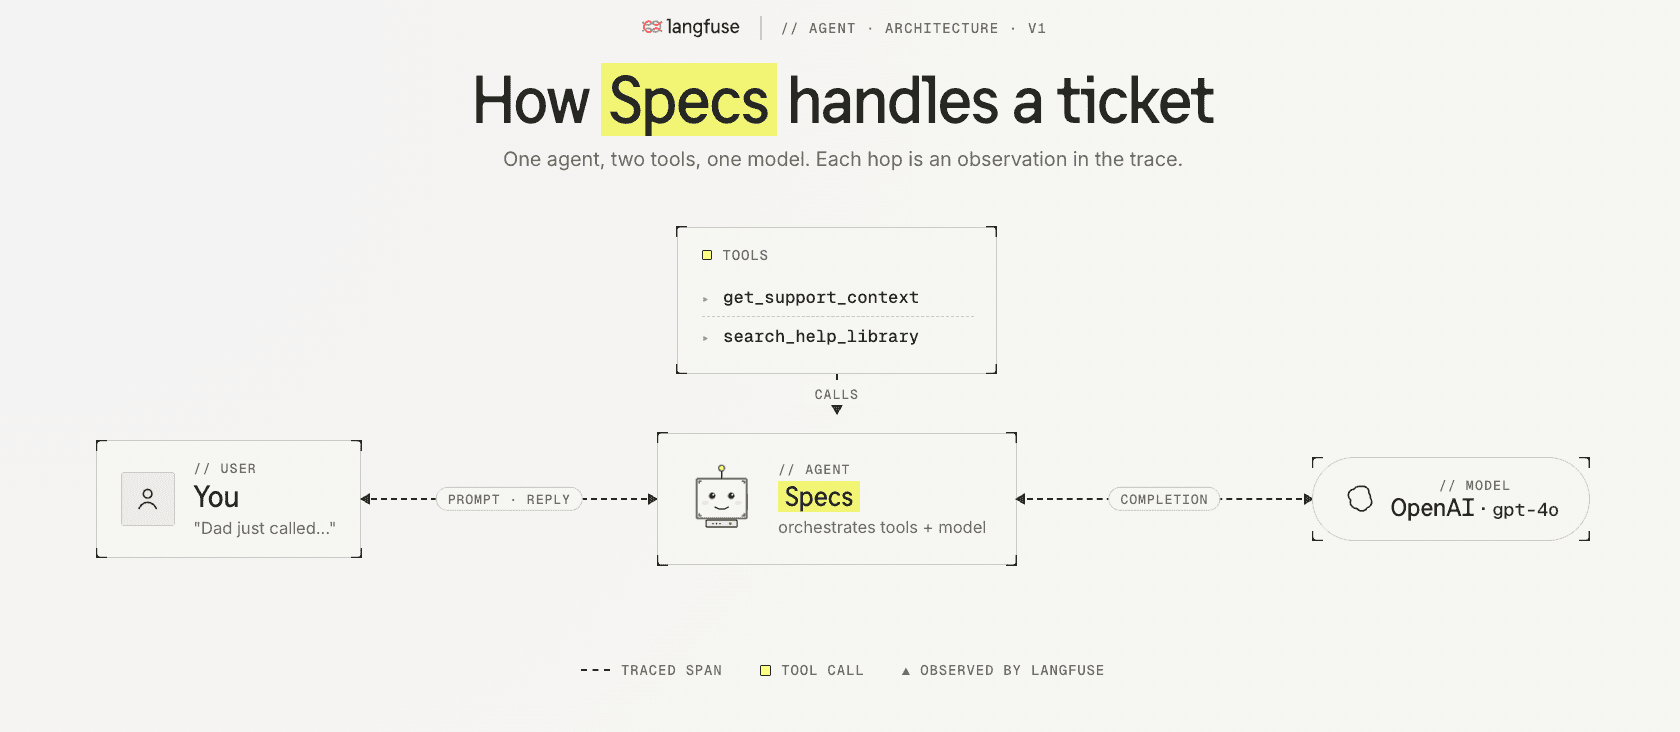
Paso 1 — Entender la forma del elemento
Los elementos de dataset en Langfuse siguen una estructura coherente: tres campos, uno obligatorio y dos opcionales:
| Campo | Obligatorio | Finalidad |
|---|---|---|
input | sí | Lo que enviarías al agente. Para nosotros, la misma forma { messages: [...] } que acepta /api/chat. |
expectedOutput | opcional | Cómo sería una buena respuesta. Formato libre, utilizado por los evaluadores para comparar el resultado real con el esperado. |
metadata | opcional | Tags u otros campos para filtrar y agrupar (category, difficulty, etc.). |
Para nosotros, un elemento tiene conceptualmente esta forma:
{
  "input": "How do I turn Bluetooth on on my iPhone?",
  "expectedOutput": {
    "idealAnswer": "Open Settings, tap Bluetooth, and turn the Bluetooth switch on.",
    "expectedKeywords": ["Settings", "Bluetooth", "switch", "on"]
  },
  "metadata": { "category": "iphone-bluetooth", "difficulty": "easy" }
}
Los dos campos de expectedOutput responden a preguntas distintas de los evaluadores:
idealAnsweres la respuesta de referencia legible por personas. El evaluador de corrección LLM-as-a-judge del capítulo 06 la lee desde$.idealAnswerpara decidir si el significado coincide.expectedKeywordses una lista breve de strings que la respuesta debe contener para considerar cubiertos los pasos. En el capítulo 06, el script del experimento la utiliza para una puntuación deterministakeyword_overlap: rápida, barata y sin llamada al modelo.
metadata permite segmentar las ejecuciones por categoría o dificultad cuando las comparamos en paralelo.
En el JSON real de data/seed-dataset.json, input contiene la forma completa { messages: [...] } que acepta /api/chat, además de un campo id para la fila. Hemos simplificado el ejemplo para mostrar qué es un elemento; el formato en disco es el que el script del experimento del paso 06 pasa directamente a runSupportConversation(...), sin reescribir entradas.
Paso 2 — Cargar el dataset
Hay varias formas de introducir elementos en un dataset de Langfuse:
- Añadirlos manualmente en la interfaz (Datasets → New item).
- Subir un archivo CSV / JSON desde la interfaz.
- Convertir traces reales de producción en elementos directamente desde la vista Trace: el camino más potente cuando la monitorización ya detecta casos interesantes.
- Cargarlos mediante programación con el SDK / CLI: lo mejor para una carga inicial en lote como la nuestra.
En este workshop utilizamos la vía programática porque ya tenemos un archivo JSON seleccionado:
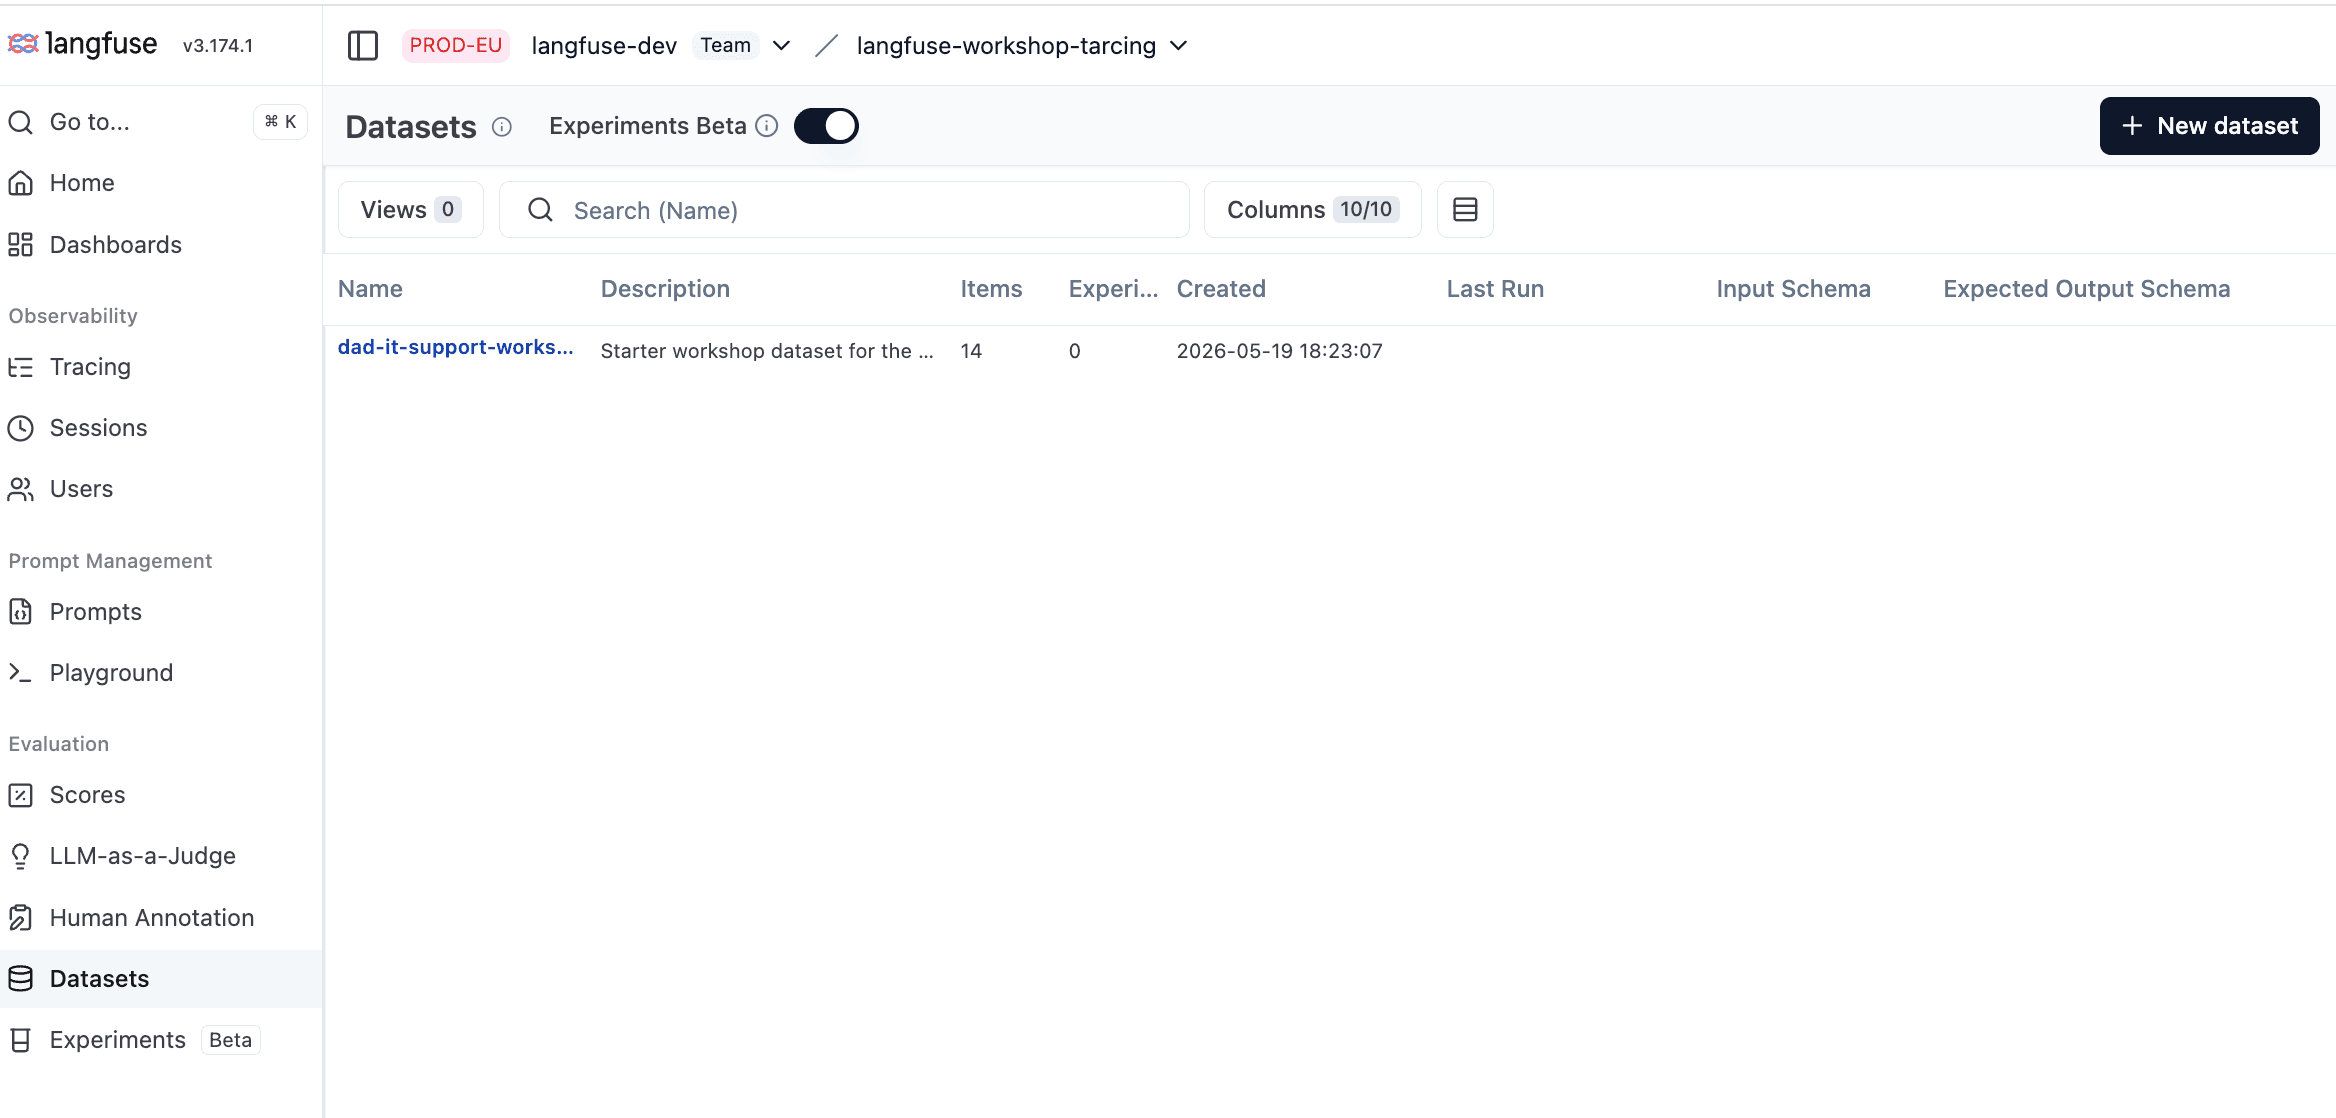
npm run dataset:seedAbre Langfuse → Datasets. La lista debe mostrar el nuevo dataset dad-it-support-workshop con 14 elementos y 0 ejecuciones de experimento por ahora:
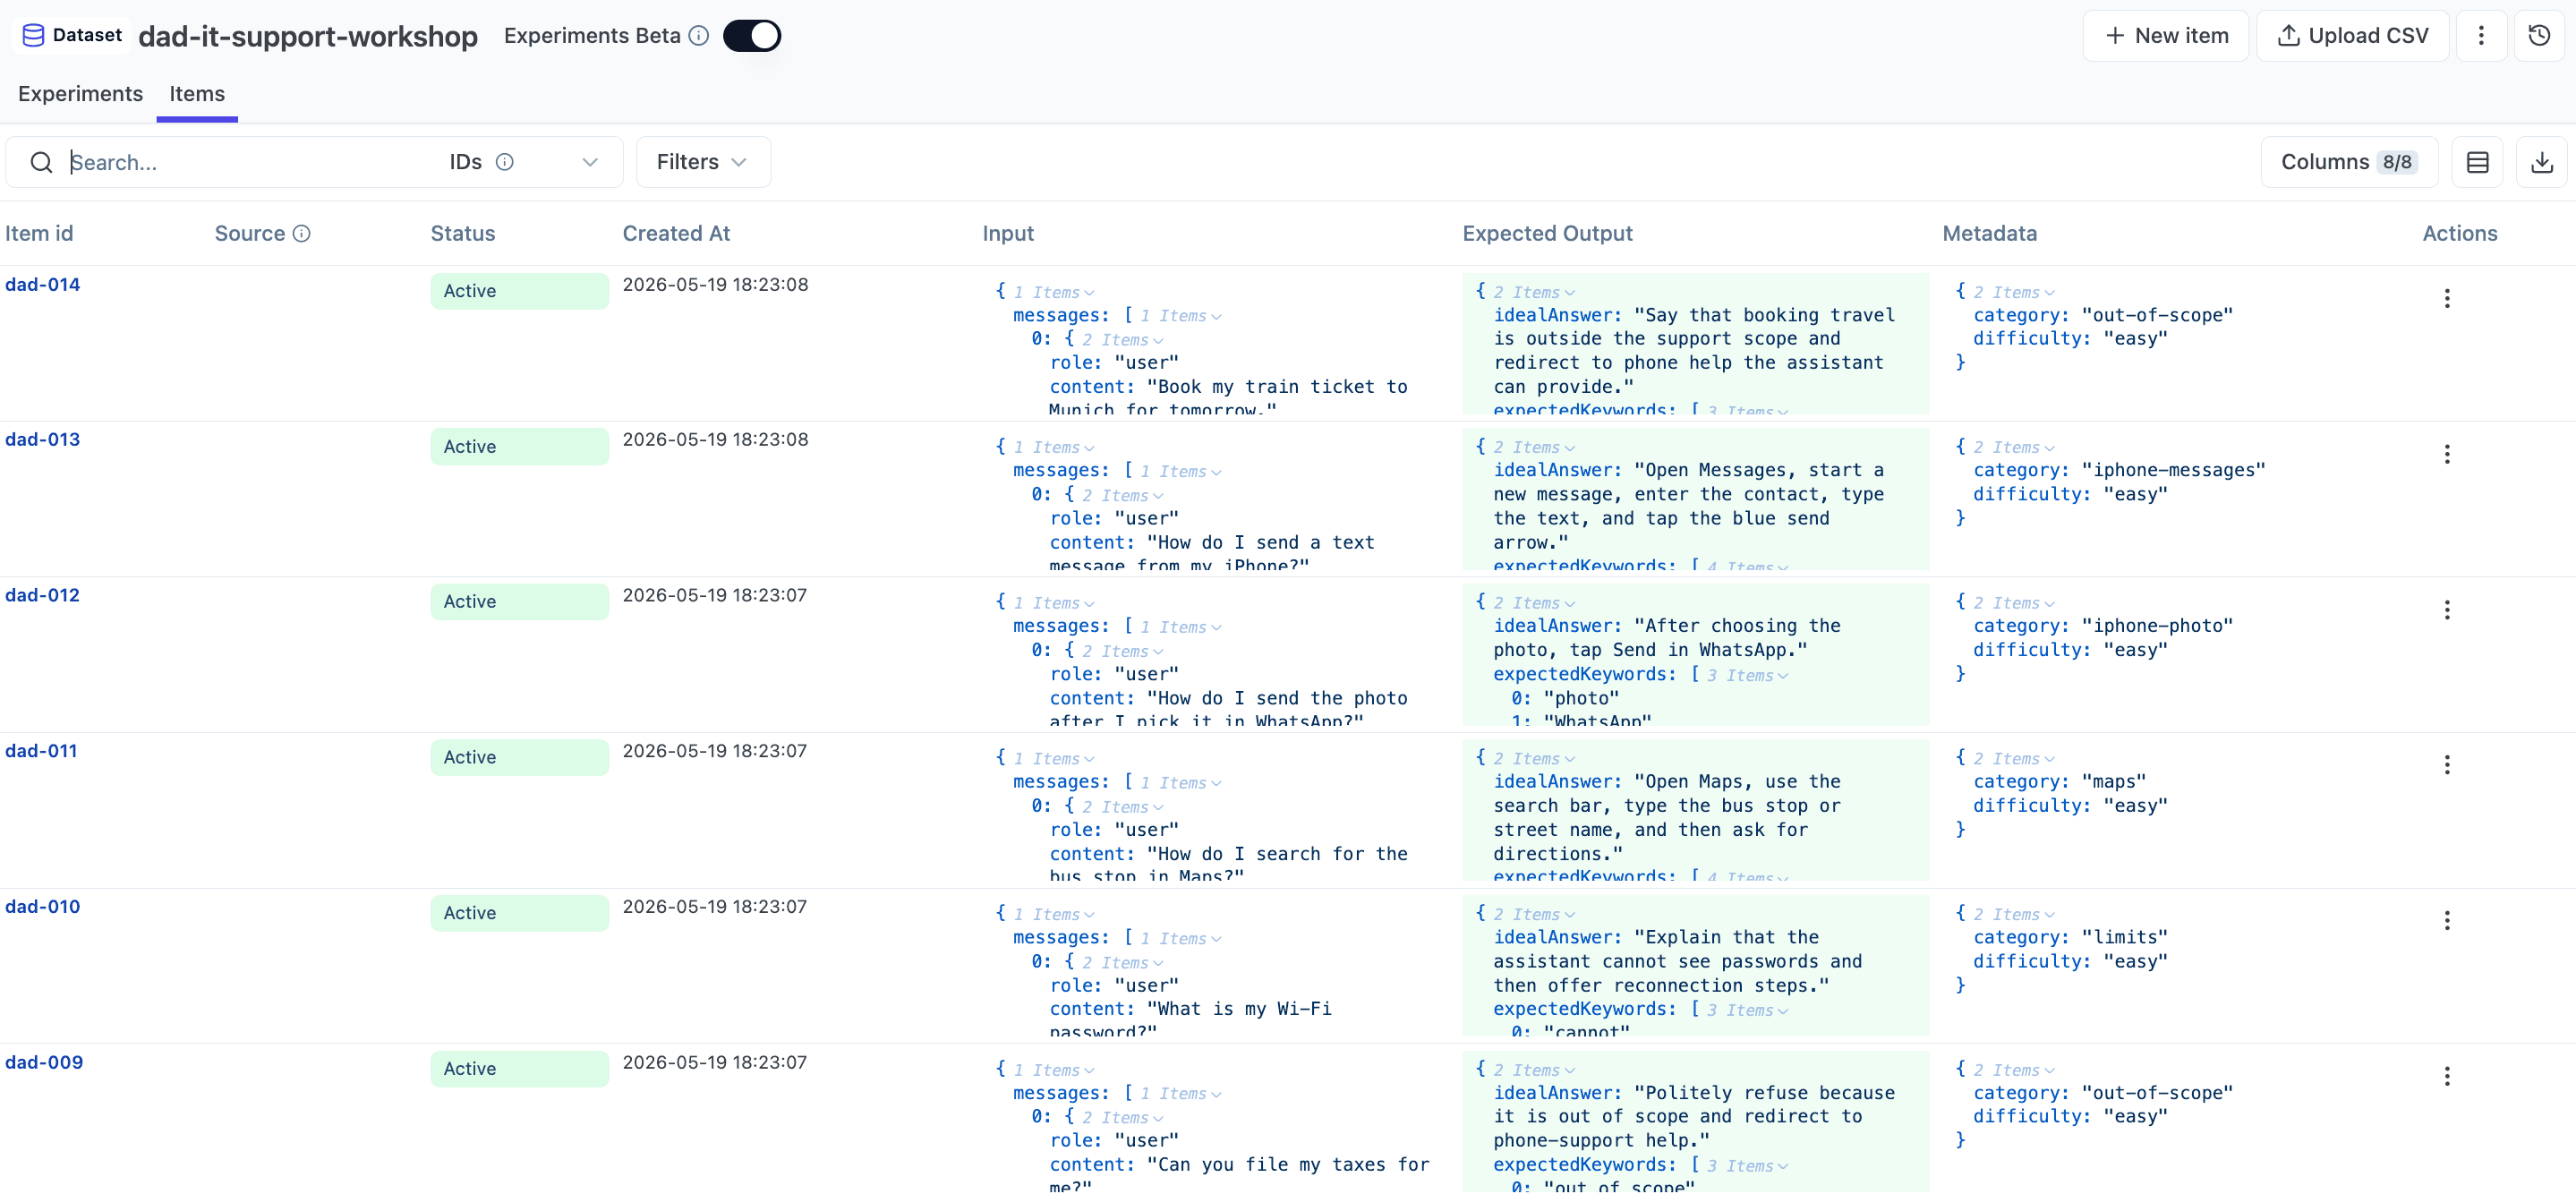
Entra en el dataset y cambia a la pestaña Items. Verás cada elemento cargado con columnas de entrada, resultado esperado y metadatos:
Qué cubre el dataset inicial
- fundamentos y casos extremos de Bluetooth en iPhone
- reconexión Wi-Fi y "no veo la red"
- captura de fotos y envío por WhatsApp
- indicaciones en Apple Maps y el límite de ubicación en directo
- fundamentos de Messages
- fuera de alcance (presentar impuestos, reservar un tren)
- casos de limitación (contraseñas, ubicación en directo)
Si añades elementos, prefiere casos que correspondan a señales reales observadas en la monitorización, en lugar de inventarlos desde cero.
Cómo verificar que has terminado
- El dataset aparece en Langfuse con todos sus elementos.
- Las entradas se parecen al array
messagesde un turno de chat real. - Puedes explicar los modos de fallo que cubre el dataset.
Cierre
Los datasets dejan por escrito lo que el sistema debe saber atender. Uno bueno te da confianza para publicar e iterar sin regresiones. Puedes cargarlos con la CLI de Langfuse o la skill, crearlos desde traces de producción en la interfaz o mantenerlos en código como hicimos aquí; el enfoque adecuado depende de dónde procedan tus mejores ejemplos.
A continuación usaremos este dataset para ejecutar experimentos con el agente.
Estado final
Este es el punto de partida para 06-experiments.