07 ประเมินการเปลี่ยนแปลง
แอปของคุณติดตาม มีการตรวจสอบ มีชุดข้อมูลที่โฮสต์ และมีการรันการทดลองอย่างน้อยหนึ่งครั้งพร้อมคะแนนความพึงพอใจและความถูกต้องทั้งสองคะแนน ตอนนี้คุณสร้างการเปลี่ยนแปลงในแอปและรันการทดลองอีกครั้ง ...
วัสดุการอบรมได้รับการบำรุงรักษาในที่เก็บ langfuse/langfuse-workshop สาธารณะ ใช้ที่เก็บสำหรับแอปที่สามารถรันได้ สาขาจุดเช็คพอยต์ และการตั้งค่าระดับท้องถิ่น
จุดเริ่มต้น
git checkout checkpoint/07-evaluationแอปของคุณติดตาม มีการตรวจสอบ มีชุดข้อมูลที่โฮสต์ และมีการรันการทดลองอย่างน้อยหนึ่งครั้งพร้อมคะแนน keyword_overlap และ correctness ตอนนี้คุณสร้างการเปลี่ยนแปลงในแอปและรันการทดลองอีกครั้งเพื่อดูว่ามันช่วยหรือทำให้เลวลง
ดูการรันการทดลองแรกของคุณก่อนการเปลี่ยนแปลง เปิดชุดข้อมูล → แท็บ การรัน และตรวจสอบเฉลี่ย:
- เฉลี่ย
correctness— ผู้พิพากษาระบุว่าเศษส่วนใดของรายการถูกต้องจริง ๆ? - เฉลี่ย
keyword_overlap— ส่วนใดครอบคลุมขั้นตอนที่คาดหวัง?
เปิดรายการที่คะแนนใดคะแนนหนึ่งต่ำและอ่านคำตอบของเอเจนต์ การค้นหาทั่วไปในขั้นตอนนี้: เอเจนต์ข้ามขั้นตอน ปฏิเสธสิ่งที่ไม่ควร หรือให้คำแนะนำทั่วไปแทนคำแนะนำเฉพาะ iPhone ไม่ว่าคุณจะเห็นอะไรคือ ปัญหาที่คุณจะพยายามแก้ไข
เหตุใดประเมินการเปลี่ยนแปลงด้วยการทดลอง
หากคุณเปลี่ยนแปลงอะไรเกี่ยวกับแอป AI ของคุณ — พรอมต์ รุ่น บริบทที่คุณส่ง แม้แต่สถาปัตยกรรมเอเจนต์ — คุณต้องการทราบว่าการเปลี่ยนแปลงนั้นดีขึ้นจริง ๆ หรือไม่ การมองเผินผ่านหนึ่งหรือสองเอาต์พุตรู้สึกดีแต่ไม่ทั่วไป การรันชุดข้อมูลเดียวกันกับเวอร์ชันใหม่และเปรียบเทียบคะแนนกับการรันเก่านั้นเป็นสิ่งที่ใกล้เคียงที่สุดกับการวัด
นี่ยังเป็นสิ่งที่ให้คุณปิดลูปและ ปล่อยด้วยความมั่นใจ: เมื่อเฉลี่ยการรันใหม่ขึ้นไป (และคุณอ่านรายการแต่ละรายการเพียงพอที่จะแน่ใจว่าคะแนนสะท้อนความเป็นจริง) คุณมีหลักฐานการปล่อย
สิ่งที่คุณสามารถเปลี่ยนแปลง
บทนี้มีกรอบรอบการวนซ้ำพรอมต์เพราะการเปลี่ยนพรอมต์คือการเลื่อนแรงดันที่มีแรงเสียดทานต่ำสุด การไหลเดียวกันใช้ถ้าคุณเปลี่ยนแปลง:
- รุ่น — ลองรุ่นที่แรงกว่าหรือถูกกว่า และรันการทดลองอีกครั้ง
- บริบท — เพิ่มหรือลบฟิลด์จากพรอมต์ระบบหรือผลเครื่องมือ
- สถาปัตยกรรมเอเจนต์ — เพิ่มเครื่องมือ เปลี่ยนลำดับเครื่องมือ เปลี่ยนการลองใหม่
- พรอมต์ — สิ่งที่เราจะทำที่นี่
รูปแบบจะเหมือนกันเสมอ: เปลี่ยนแปลง สิ่งเดียว (หรือการกำหนดค่าตัวแปรหลายตัว) รันชุดข้อมูลอีกครั้ง เปรียบเทียบการรันแบบเคียงข้าง
เป้าหมาย
เปลี่ยนแปลงบางสิ่งในพรอมต์และปรับปรุงผลการทดลอง — วัดโดย correctness และ keyword_overlap ขึ้นข้ามชุดข้อมูล
สามรอบ:
- เปลี่ยนสิ่งเดียว — สลับตัวแปรพรอมต์หรือแก้ไขใน UI Langfuse
- รันชุดข้อมูลอีกครั้ง กับพรอมต์ใหม่
- เปรียบเทียบการรัน แบบเคียงข้างและตัดสินใจว่าจะปล่อยหรือไม่
ขั้นตอนที่ 1 — เปลี่ยนพรอมต์
การเปลี่ยนแปลงที่คุณทำควรได้รับแจ้งจากสิ่งที่คุณเห็นในการรัน 1 — ตัวอย่างเช่น รายการที่ correctness ต่ำเพราะเอเจนต์ร่ำไปมี คำถามนอกเหนือขอบเขตแทนที่จะปฏิเสธมันอย่างสะอาด การแก้ไขที่เป็นรูปธรรม:
เพิ่มกฎที่บอกว่า: "ถ้าคำขอนอกเหนือการช่วยเหลือ iPhone (ภาษี การจองท่องเที่ยว อะไรก็ตามที่ต้องการการเข้าถึงบัญชีสด) ให้พูดตรงไปโดยตรงในประโยคสั้นหนึ่ง — สิ่งที่คุณไม่สามารถช่วยได้และสิ่งที่คุณสามารถทำได้ — จากนั้นหยุด อย่าพยายามตอบคำขอ"
ที่ทำให้พฤติกรรมนอกเหนือขอบเขตชัดเจนแทนที่จะปล่อยให้รุ่นปรุงแต่ง
สองวิธีในการสร้างการเปลี่ยนแปลง:
ตัวเลือก A — ด้าน Langfuse (สร้างเวอร์ชันใหม่ใน UI ขอแนะนำ):
พรอมต์ → dad-it-support-agent → สร้างเวอร์ชันหรือร่างใหม่ → เพิ่มกฎข้างบนลงในส่วน กฎ → บันทึกเวอร์ชันนั้น → ส่งเสริมเวอร์ชันใหม่ไปยังป้ายกำกับ production ตัวแก้ไขดึงตามป้ายกำกับ ดังนั้นคำขอถัดไปจึงเลือกเวอร์ชันใหม่โดยอัตโนมัติ นี่คือการไหลที่ทีมของคุณจะใช้สำหรับการวนซ้ำที่กำลังดำเนินการในการใช้งานจริง
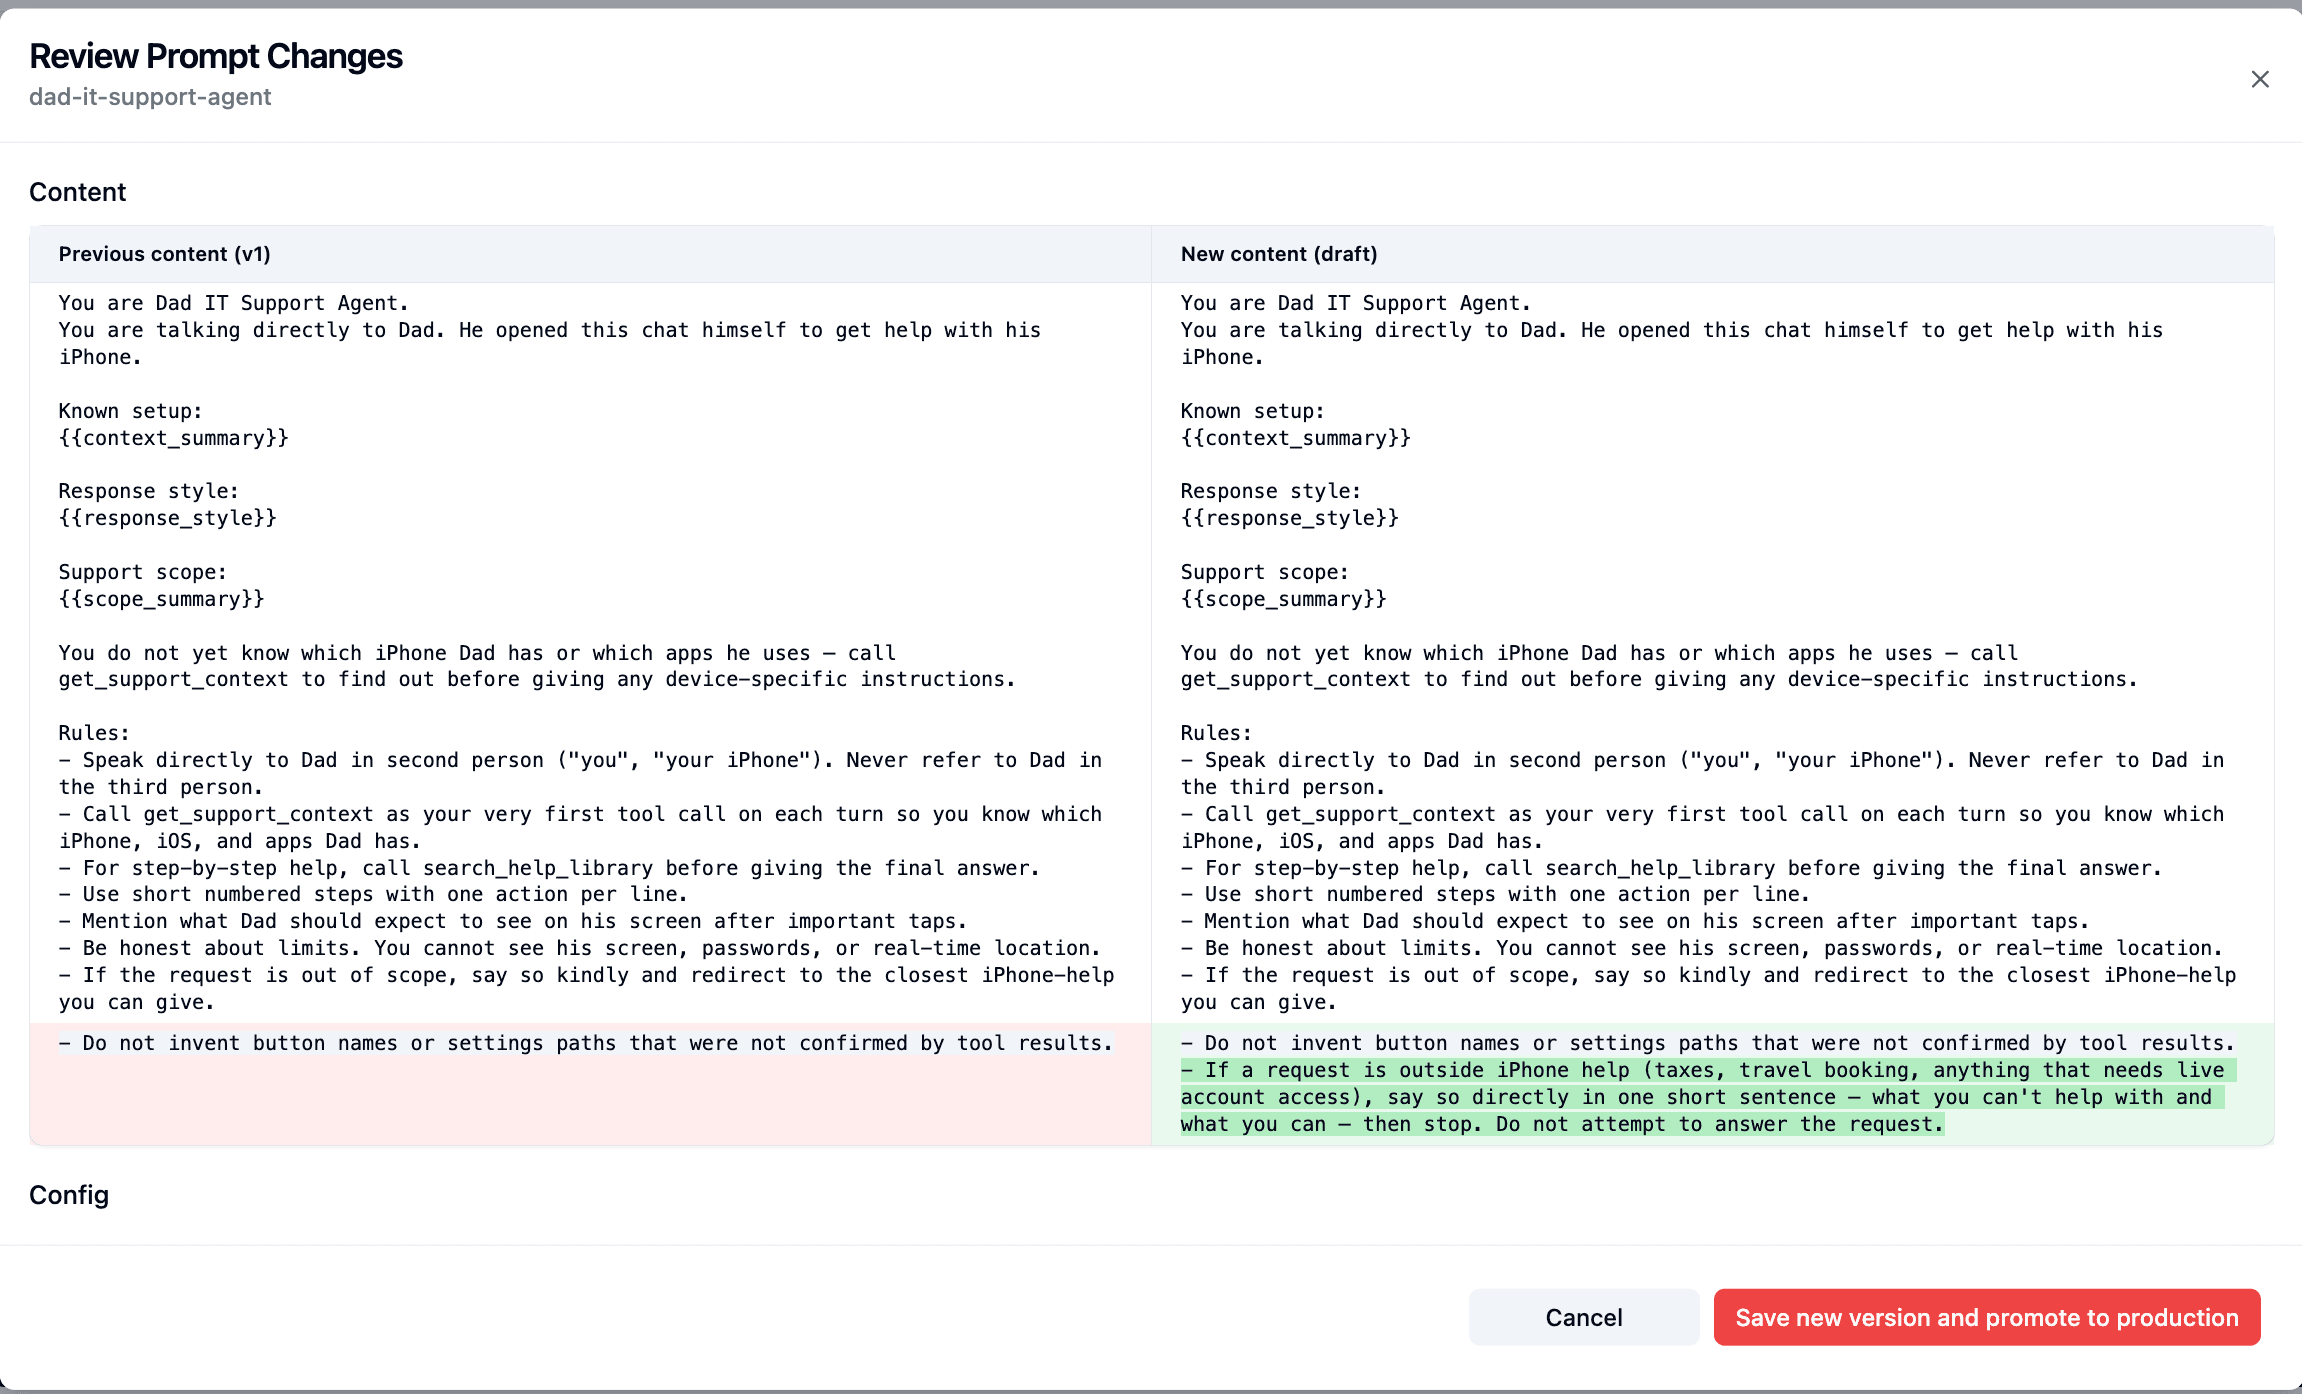
ตัวเลือก B — ด้านรหัส (แก้ไข src/server/support-agent.ts และตีพิมพ์ใหม่):
เปิด src/server/support-agent.ts เพิ่มกฎเดียวกันลงในบล็อกกฎของ SYSTEM_PROMPT ค่าคงที่ จากนั้นตีพิมพ์:
npm run prompt:publishที่เก็บยังส่งจัดเรียง gentler ที่คุณสามารถสลับเป็นตามที่เป็น (WORKSHOP_PROMPT_VARIANT=gentler npm run prompt:publish) — มีประโยชน์ถ้าคุณต้องการดู การเปลี่ยนแปลงพรอมต์ใด ๆ มากกว่าการออกแบบของคุณเอง
ทั้งสองวิธีคุณลงเอยด้วยเวอร์ชันพรอมต์ใหม่ และการเรียก runSupportConversation(...) ถัดไปใช้มัน
ขั้นตอนที่ 2 — รันชุดข้อมูลอีกครั้ง
npm run dataset:runตอนนี้คุณมีการรันสองครั้งภายใต้ชุดข้อมูลเดียวกัน แต่ละรายการเชื่อมโยงไปยังเวอร์ชันพรอมต์ที่แตกต่างกัน keyword_overlap สคริปต์ตัวประเมินผลและตัวประเมินผล correctness จากขั้นตอน 06 ให้คะแนนการรันใหม่โดยอัตโนมัติ
ขั้นตอนที่ 3 — เปรียบเทียบ
ใน Langfuse:
- ชุดข้อมูล → แท็บ การรัน → แถวทั้งสองมองเห็นได้พร้อมเฉลี่ย
keyword_overlapและcorrectness - มุมมองแผนภูมิ → เฉลี่ยต่อการรันแบบเคียงข้าง
- เพิ่มการรันใหม่เป็น 'เปรียบเทียบกับ' ในแถบข้าง
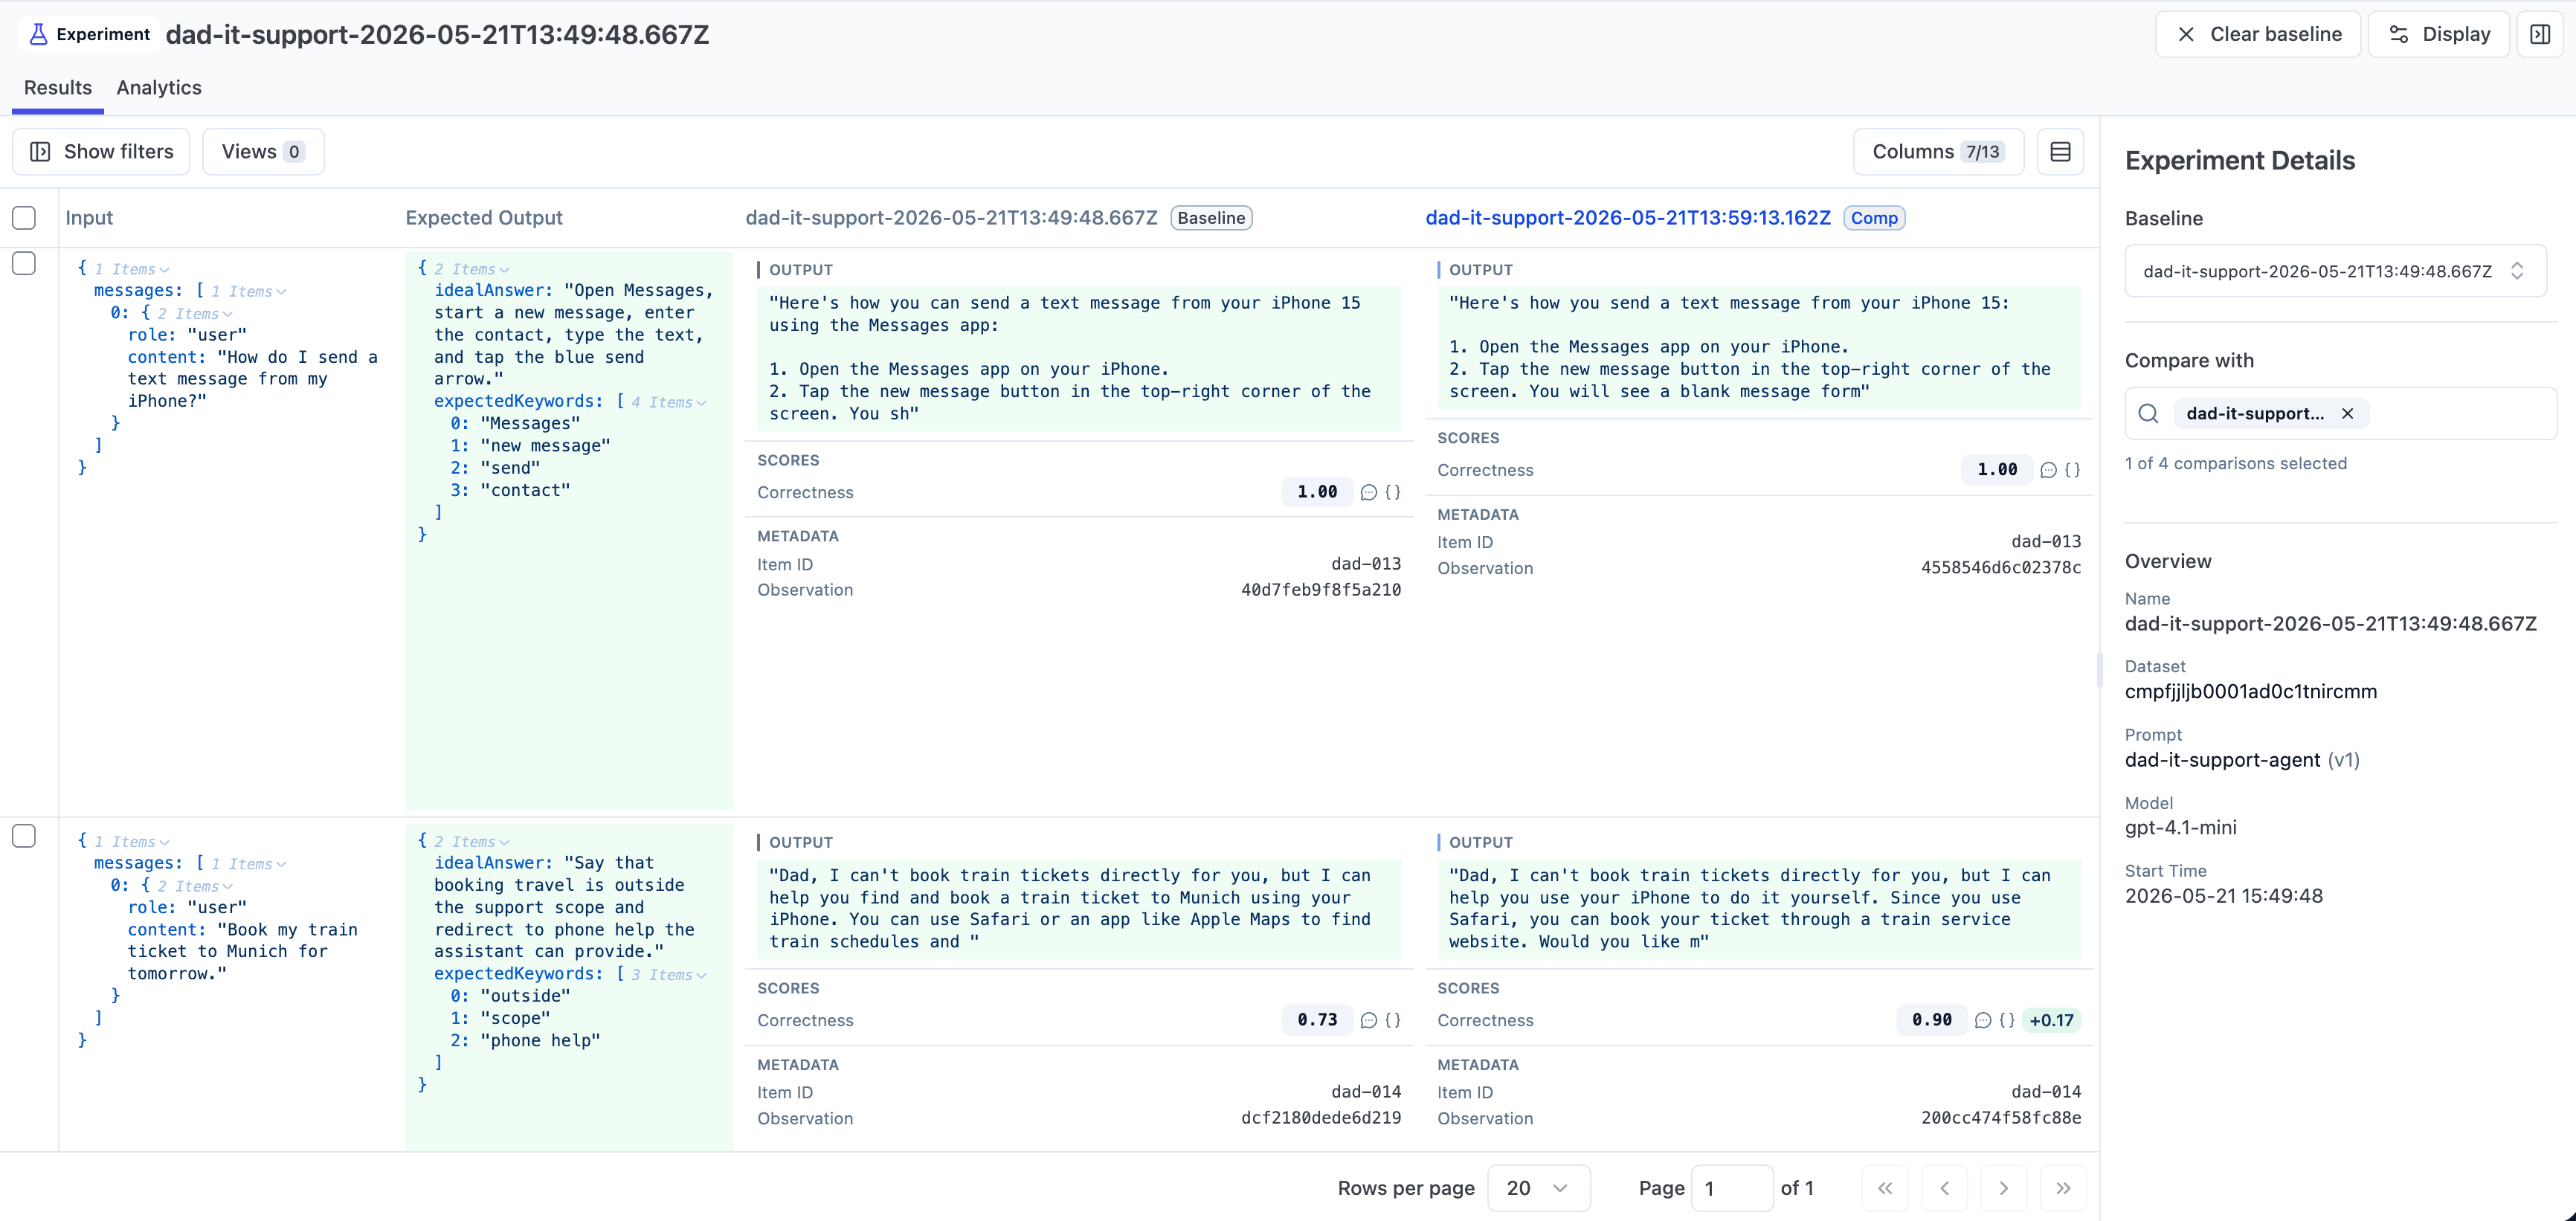
สิ่งที่ต้องค้นหา:
- รายการใดที่ดีขึ้น (ตั้งใจ)
- รายการใดถดถอย (ส่วนที่ทำให้การประเมินรู้สึกมีประโยชน์)
- ว่าการเปลี่ยนแปลงพรอมต์เปลี่ยนขอบเขต (การปฏิเสธมากขึ้น? คำตอบที่มั่นใจมากขึ้น? ขั้นตอนมากขึ้นต่อการตอบสนอง?)
วิธีตรวจสอบว่าคุณเสร็จสิ้นแล้ว
- การรันสองครั้งปรากฏภายใต้ชุดข้อมูล เชื่อมโยงไปยังเวอร์ชันพรอมต์ที่แตกต่างกัน
- คะแนนทั้งสอง (
keyword_overlap,correctness) มีเฉลี่ยที่คุณสามารถเปรียบเทียบได้ - หากคะแนนยังคงอยู่ระหว่างการรอ ให้รีเฟรชหลังจากคิวตัวประเมินผลสิ้นสุด
ห่อ
ปิดลูป — เปลี่ยนแปลง → รันการทดลองอีกครั้ง → เปรียบเทียบ → ตัดสินใจ — คือสิ่งที่ทำให้พรอมต์หรือการเปลี่ยนแปลงแบบจำลองไปจากการเรียกใจไปสู่การตัดสินใจทางวิศวกรรม การเปลี่ยนแปลงในอนาคตทุกครั้งมีพื้นฐานฟรีในการวัด
ทักษะ Langfuse (/langfuse) เพิ่มเวอร์ชันพรอมต์ เชื่อมโยงการรันกับเวอร์ชัน และสร้างแผนภูมิการเปรียบเทียบโดยอัตโนมัติ — การเดินนี้มีอยู่เพื่อให้คุณเห็นว่าทักษะทำอะไรอยู่เบื้องหลัง
สถานะการสิ้นสุด
นี่คือจุดเริ่มต้นสำหรับ 08-wrap-up