02 Medir offline
Use evaluators, datasets e traces do Langfuse para descobrir a qualidade real do vencedor — por pergunta e por nível.
Ponto de partida
Módulo 01 concluído: a Arena foi executada, o Leaderboard está preenchido e você tem um config_id vencedor (<model>__<prompt>, por exemplo claude-sonnet-5__P1_zeroshot).
Por quê
Vencer a Arena mostra que uma configuração superou as demais no custo por resposta correta agregado. Não mostra como venceu, onde é mais fraca nem se seu SQL é apenas correto ou realmente bom. Antes de publicar e avaliar o tráfego de produção, vale entendê-la — como saber não apenas que alguém passou numa entrevista, mas quais perguntas dominou e em quais quase falhou. O Langfuse já contém tudo: os evaluators do Módulo 01 pontuaram cada item, e cada item possui um trace completo. Este módulo ensina a ler esses detalhes, não a gerar novos dados.
Conceitos — por baixo dos panos
Trace → observações → pontuações. O Langfuse estrutura cada execução do agente assim:
- Um trace é uma execução do agente — uma combinação
model × prompt × question, chamadaagent_rune identificada com oconfig_id. - Observações são os spans internos. A única é
llm_call, uma observação de generation com prompt, conclusão e uso de tokens. A saída do Experiment Item registra custo exato e latência ponta a ponta usados pelo leaderboard. Não há observação separada para executar SQL: ele roda como uma chamada ClickHouse comum, e o SQL e seu resultado ficam na entrada/saída da raiz do trace. - Pontuações são anexadas depois pelos evaluators:
correctness(precisão binária de execução),agent-arena-llm-judge(qualidade SQL graduada por LLM-as-a-judge) e a categoriaoutcome. A definição do evaluator no Langfuse éllm_judge; a pontuação emitida e aguardada pelo harness é exatamenteagent-arena-llm-judge.
Cada trace é um agent_run com uma única observação filha, a generation llm_call, e três pontuações anexadas pelos evaluators do Langfuse: correctness, agent-arena-llm-judge e outcome.
Níveis. O corpus tem 20 perguntas YAML, mas q019 e q020 são holdouts do prompt few-shot. Em um projeto limpo, cada uma das 18 perguntas em arena-golden possui um tier de 1 (mais simples: contagens e filtros em uma tabela) a 5 (mais difícil: joins, funis e cálculo de margem). A precisão por nível existe porque o resultado geral pode ocultar um colapso no nível 5 atrás de bom desempenho nos níveis 1 e 2.
Categorias de outcome. O Code Evaluator correctness do Langfuse (eval/langfuse_evaluators/correctness_evaluator.py) classifica cada Experiment Item concluído, conforme o quanto avançou:
| Outcome | Significado |
|---|---|
correct | O conjunto de resultados corresponde ao dourado. |
model_error | A chamada ao OpenRouter falhou (chave inválida/expirada, limite ou indisponibilidade) antes de gerar SQL. |
sql_policy_rejected | agents/sqlguard.py bloqueou o SQL antes do ClickHouse (não era um único SELECT ou continha palavra proibida). |
sql_exec_error | O SQL chegou ao ClickHouse, mas falhou (sintaxe, coluna desconhecida etc.). |
empty_but_expected | A consulta retornou zero linhas, mas a resposta dourada tem linhas. |
wrong_result | A consulta retornou linhas diferentes do resultado dourado. |
Cada categoria pede uma correção: sql_policy_rejected requer um prompt de sistema melhor sobre somente leitura; sql_exec_error geralmente indica lacuna de dialeto (veja P3_dialect); empty_but_expected e wrong_result normalmente revelam erro de filtro, join ou agregação.
Objetivo
Ler com segurança a precisão por nível e a distribuição de outcomes do vencedor, entender o que agent-arena-llm-judge acrescenta à correctness bruta e navegar de uma linha do leaderboard ao trace exato de qualquer pergunta.
Etapa 1 — Ler a precisão por nível e a distribuição de outcomes
Abra http://localhost:5174 → Leaderboard e clique na configuração vencedora. Além de precisão, latência e custo por resposta correta, cada configuração mostra:
- Precisão por nível — perguntas de
arena-goldenagrupadas por dificuldade; uma configuração forte no geral pode ser instável no nível mais difícil, algo ocultado pelo agregado. - Distribuição de outcomes — respostas incorretas falham de maneiras distintas: rejeição pela sandbox, erro do ClickHouse, resultado vazio ou conjunto incorreto. Cada problema exige uma correção diferente.
Como interpretar. A precisão por nível tem uma linha por nível 1–5: procure onde o número cai. Quase perfeição nos níveis 1–2 e queda nos níveis 4–5 indica domínio de consultas simples, mas dificuldade com joins e agregação em várias etapas. A distribuição conta (correct, sql_policy_rejected, sql_exec_error, empty_but_expected, wrong_result): muitos sql_exec_error indicam dialeto; muitos wrong_result, lógica.
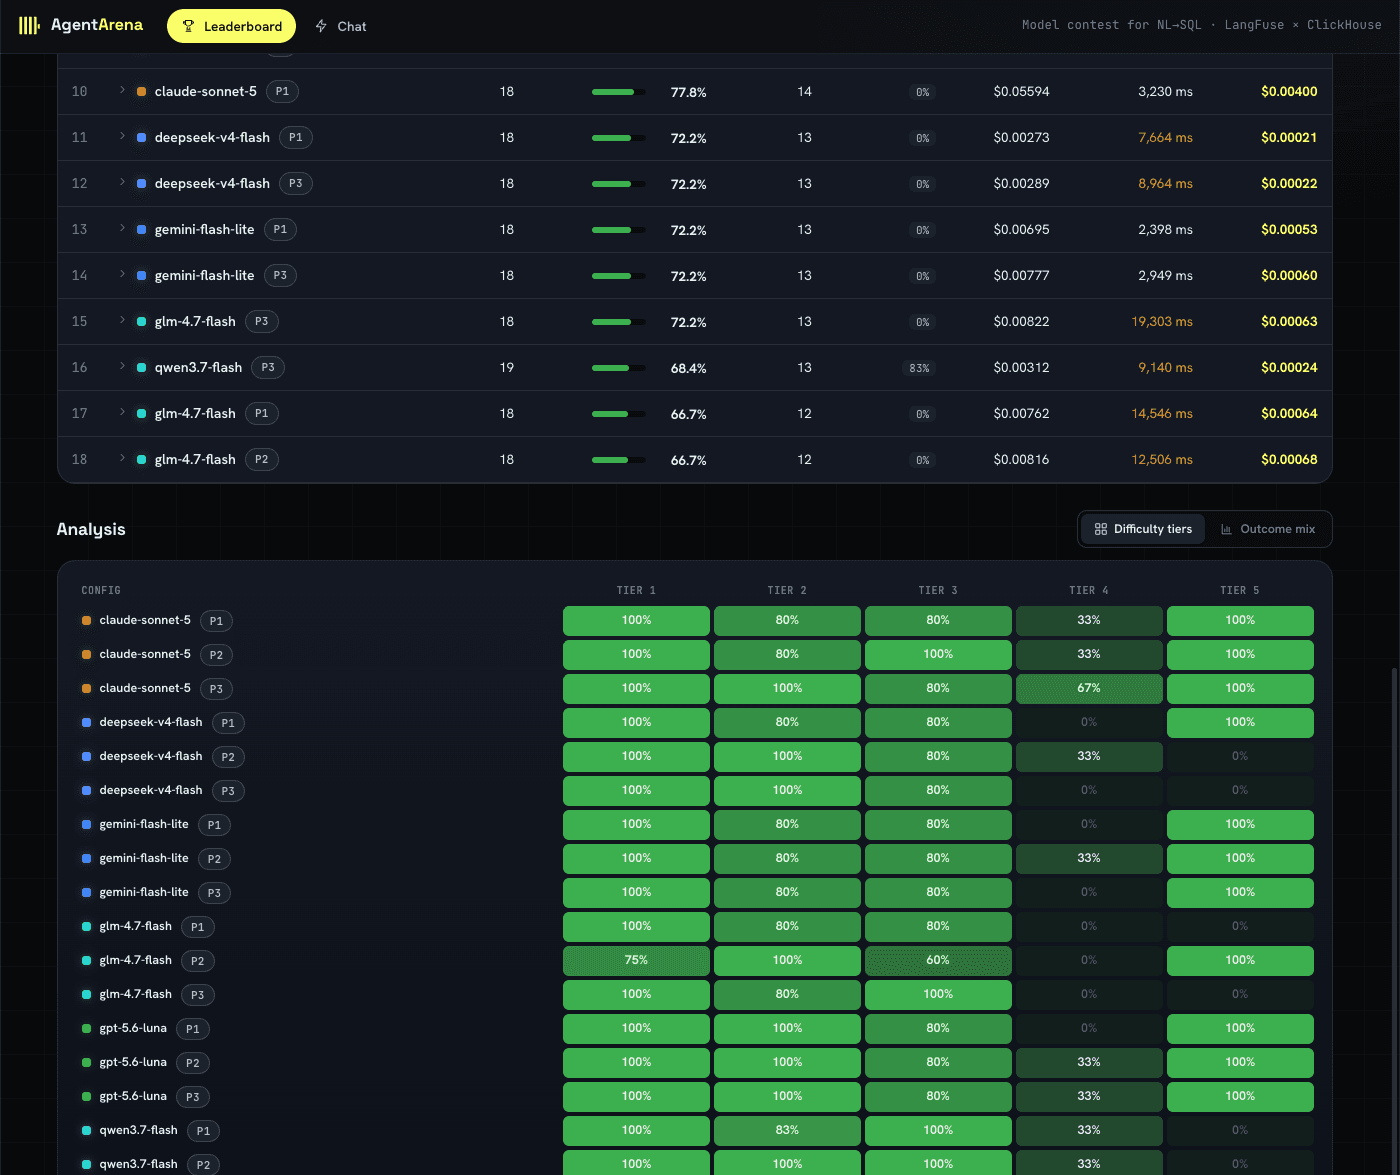
A visão Difficulty tiers revela padrões ocultos pela precisão geral. Nesta execução, a maioria das configurações é forte nos níveis 1–3, e o nível 4 é a fraqueza compartilhada mais clara; compare as linhas para ver se o vencedor também cai.
Etapa 2 — Ler o sinal secundário agent-arena-llm-judge
A pontuação correctness é binária: o conjunto de resultados corresponde ou não. agent-arena-llm-judge, emitida pela definição llm_judge configurada no Módulo 01, é um sinal secundário mais granular: uma avaliação LLM-as-a-judge da qualidade do SQL. Uma configuração pode ser correta em execução e ainda produzir SQL questionável (subconsulta desnecessária, comparação de data frágil ou join que funciona apenas nestes dados). Use agent-arena-llm-judge para identificar a diferença entre “passa” e “bem escrito”.
Etapa 3 — Explorar traces individuais
Na linha do leaderboard, abra os resultados por pergunta e clique numa pergunta para abrir seu trace no Langfuse. Ele contém o caminho completo: prompt, SQL gerado, generation llm_call (prompt, conclusão e tokens), custo exato e latência ponta a ponta do Experiment Item e, se houver falha, o erro do ClickHouse. Essa mesma habilidade será usada na investigação humana do Módulo 04, com perguntas de usuários reais.
Escolha duas ou três perguntas erradas (ou com baixa pontuação em agent-arena-llm-judge) e leia os traces de ponta a ponta. Procure um padrão: uma formulação, join ou filtro de data que o modelo erra repetidamente.
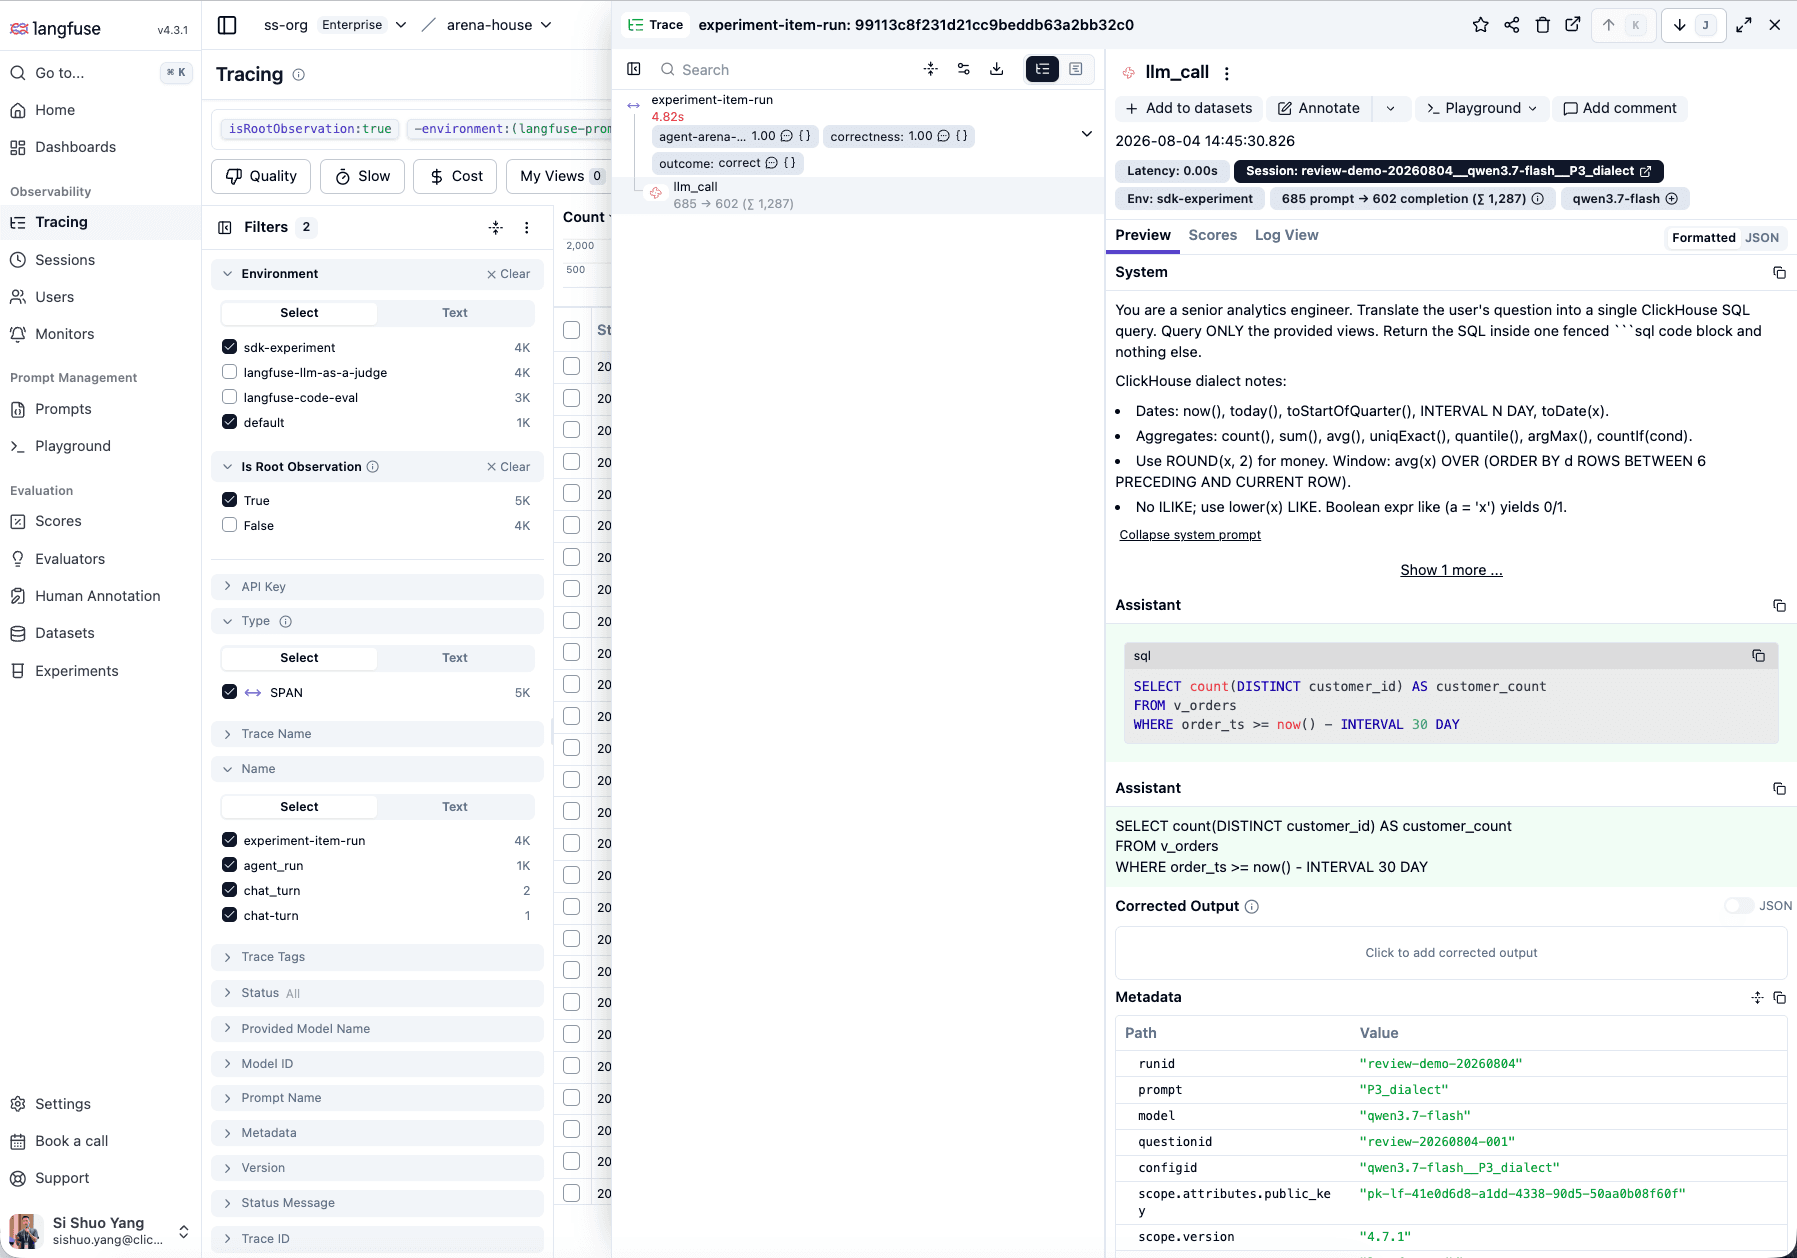
Um Experiment Item conecta as pontuações no topo do trace ao llm_call exato. O painel mostra prompt, SQL, tokens, latência e metadados necessários para explicar aprovação ou falha.
Como verificar se terminou
- Você consegue informar a precisão do vencedor em pelo menos um nível específico, não só o total.
- Consegue indicar uma pergunta em que
correctnesseagent-arena-llm-judgediscordam, ou explicar por que não discordam nesta execução. - Abriu ao menos um trace e consegue percorrer prompt → SQL gerado → resultado ou erro.
Exercício — praticar o diagnóstico de trace antes da publicação
Transforme a leitura da Etapa 3 em um registro escrito antes de publicar no Módulo 03:
-
Nos resultados do vencedor, escolha 2–3 perguntas com
correctness = 0ou baixaagent-arena-llm-judge. -
Abra o trace de cada uma e preencha uma linha:
Pergunta O que gerou Por que falhou Categoria de outcome (texto da pergunta) (resumo do SQL) (sua análise: join errado, filtro de data ausente, interpretação incorreta, …) ( sql_exec_error/wrong_result/ …) -
Procure nas 2–3 linhas um padrão repetido — o mesmo join, erro de data ou formulação mal interpretada. O objetivo é um padrão, não apenas bugs desconexos.
Guarde essa observação como contexto offline, mas não a trate como incidente de produção. O Módulo 03 cria um novo trace de produção marcado por feedback, e o Módulo 04 usa o método praticado aqui para investigar exatamente esse incidente.
Recapitulação
Agora você sabe não apenas que a configuração venceu, mas como: seus pontos fortes, fracos e falhas no nível do trace. Esses detalhes viram ação em seguida.
Estado final
Um retrato detalhado da qualidade do vencedor. Continue para 03 Lançar e detectar e publique a configuração selecionada para capturar uma divergência real entre evaluator e sinal do usuário.