02 วัดคุณภาพ
ใช้ Langfuse evaluators, datasets และ traces เพื่อดูว่าผู้ชนะดีแค่ไหนจริง ๆ — รายคำถาม รายระดับ
จุดเริ่มต้น
โมดูล 01 เสร็จแล้ว: Arena รันไปแล้ว, Leaderboard มีข้อมูลแล้ว และคุณมี
config_id ที่ชนะ (<model>__<prompt> เช่น claude-sonnet-5__P1_zeroshot)
ทำไม
การชนะใน Arena บอกคุณว่าคอนฟิกหนึ่งเอาชนะที่เหลือด้านต้นทุนต่อคำตอบที่ถูกต้องใน ภาพรวม มันไม่ได้บอกว่ามันชนะอย่างไร จุดอ่อนที่สุดอยู่ตรงไหน หรือ SQL ของมัน แค่ถูกต้องหรือดีจริง ก่อนที่คุณจะสร้างต่อบนโมเดลนี้ (พัฒนามัน ปล่อย มัน) มันคุ้มที่จะทำความเข้าใจมัน — แบบเดียวกับที่คุณจะอยากรู้ไม่ใช่แค่ว่า ผู้สมัครผ่านสัมภาษณ์ แต่คำถามไหนที่เขาตอบได้สวยและข้อไหนที่เขาแค่ เฉียดฉิวผ่านมา Langfuse มีทุกอย่างที่คุณต้องการสำหรับเรื่องนี้อยู่แล้ว: evaluator จาก โมดูล 01 ให้คะแนนทุก item แล้ว และทุก item มี trace ครบถ้วน โมดูลนี้เกี่ยวกับการ อ่านรายละเอียดนั้น ไม่ใช่การผลิตข้อมูลใหม่
แนวคิด — เบื้องหลังการทำงาน
Trace → observations → scores Langfuse จัดโครงสร้างการรันของ agent ทุกครั้งใน รูปแบบเดียวกัน:
- trace คือการรัน agent หนึ่งครั้ง — การประมวลผลหนึ่งชุดของ
model × prompt × questionชื่อagent_runและติดแท็กด้วยconfig_id - Observations คือ span ภายใน trace นั้น อันเดียวที่มีคือ
llm_callซึ่งเป็น observation แบบ generation ที่บรรทุก prompt, completion และการใช้ token ของการ เรียกโมเดล เอาต์พุตของ Experiment Item บันทึกต้นทุนและ latency ตั้งแต่ต้นจนจบที่แม่นยำ ซึ่ง leaderboard ใช้ ไม่มี observation แยกสำหรับขั้นการรัน SQL — SQL รันเป็นการเรียก ClickHouse ธรรมดาโดยไม่มี Langfuse span ของตัวเอง; SQL ที่ถูกสร้างขึ้นและ result set ของมันไปลงที่ input/output ของราก trace แทน - Scores คือสิ่งที่ evaluator จากโมดูล 01 แนบไปที่ trace/dataset item
ในภายหลัง:
correctness(ความแม่นยำเชิงการรันแบบไบนารี),agent-arena-llm-judge(คุณภาพ SQL แบบ LLM-as-a-judge ที่ให้คะแนนเป็นระดับ) และหมวดoutcomeโดย evaluator definition ใน Langfuse ชื่อllm_judgeแต่ score ที่ปล่อยออกมาและ harness รอคือagent-arena-llm-judgeแบบตรงเป๊ะ
ทุก trace คือ agent_run หนึ่งครั้งที่มี observation ลูกหนึ่งอัน คือ generation ชื่อ llm_call บวกกับสาม score ที่ evaluator ของ Langfuse แนบเข้ามาหลังให้คะแนน: correctness, agent-arena-llm-judge และ outcome
ระดับความยาก (tier) คลังต้นทางมีคำถาม YAML 20 ข้อ แต่ q019 และ q020
กันไว้เป็น few-shot prompt holdout ในโปรเจกต์ที่สะอาด คำถาม experiment 18 ข้อที่ seed เข้า arena-golden
แต่ละข้อมี tier ตั้งแต่ 1
(ง่ายที่สุด — การนับและกรองบนตารางเดียว) ถึง 5 (ยากที่สุด — join หลายตาราง
funnel การคำนวณ margin) ความแม่นยำรายระดับมีอยู่เพราะตัวเลขรวมของคอนฟิก
สามารถซ่อนการพังยับใน tier 5 ไว้หลังผลงานที่แข็งแรงใน tier 1/2 ได้
หมวดผลลัพธ์ (outcome) Code Evaluator correctness ของ Langfuse
(eval/langfuse_evaluators/correctness_evaluator.py) จัดหมวด Experiment Item ที่ทำเสร็จ
ทุกรายการลงในหมวดใดหมวดหนึ่งต่อไปนี้ เรียงตามว่าคำตอบไป "ไกล" แค่ไหน:
| Outcome | มันหมายถึงอะไร |
|---|---|
correct | result set ตรงกับ golden result set |
model_error | การเรียก OpenRouter เองล้มเหลว (key ผิด/หมดอายุ, ติดลิมิตอัตรา, ผู้ให้บริการล่ม) ก่อนที่จะมีการสร้าง SQL ใด ๆ |
sql_policy_rejected | agents/sqlguard.py บล็อก SQL ที่ถูกสร้างขึ้นก่อนที่มันจะไปถึง ClickHouse (ไม่ใช่ SELECT เดี่ยว ๆ หรือเจอคีย์เวิร์ดที่ห้าม) |
sql_exec_error | SQL ไปถึง ClickHouse แล้วแต่ query รันไม่สำเร็จ (syntax ผิด, ไม่รู้จักคอลัมน์ ฯลฯ) |
empty_but_expected | query รันได้และคืนศูนย์แถว แต่คำตอบ golden มีแถวอยู่ |
wrong_result | query รันได้และคืนแถวออกมา แต่ไม่ตรงกับ golden result set |
แต่ละอันบ่งชี้การแก้ที่ต่างกัน: การรันที่เป็น sql_policy_rejected ต้องการ system prompt
ที่ดีกว่าเรื่องการอยู่ในโหมดอ่านอย่างเดียว; sql_exec_error มักหมายถึงช่องว่างเรื่อง dialect (ดู
P3_dialect); empty_but_expected และ wrong_result มักหมายถึงความผิดพลาดเชิงตรรกะของ
ตัวกรอง join หรือการรวมค่า
เป้าหมาย
อ่านความแม่นยำรายระดับและการแยกย่อยของ outcome สำหรับคอนฟิกที่ชนะของคุณได้อย่าง
คล่องแคล่ว เข้าใจว่าคะแนนรอง agent-arena-llm-judge เพิ่มอะไรเข้ามาบน correctness
ดิบ และเจาะจากแถวใน leaderboard ลงไปถึง Langfuse trace ที่แม่นยำ
ซึ่งอยู่เบื้องหลังคำถามข้อใดข้อหนึ่งได้
ขั้นที่ 1 — อ่านความแม่นยำรายระดับและการแยกย่อยของ outcome
เปิด http://localhost:5174 → Leaderboard แล้วคลิกเข้าไปในแถวของคอนฟิกที่ชนะของ คุณ ควบคู่กับความแม่นยำ latency และต้นทุนต่อคำตอบที่ถูกต้อง แต่ละคอนฟิกแสดง:
- ความแม่นยำรายระดับ — คำถามใน
arena-goldenถูกจัดกลุ่มตามระดับความยาก; คอนฟิกที่ดูแข็งแรงในภาพรวมยังอาจสั่นคลอนในระดับที่ยากที่สุดได้ และนั่นคือ ช่องว่างประเภทที่ตัวเลขรวมซ่อนไว้เป๊ะ ๆ - การแยกย่อยของ outcome — คำตอบที่ไม่ถูกต้องไม่ได้ล้มเหลวแบบเดียวกันทั้งหมด SQL บางส่วนถูก sandbox ปฏิเสธ บางส่วนคืน error ของ ClickHouse บางส่วนคืนผลลัพธ์ ว่างเปล่า บางส่วนแค่คืน result set ที่ผิด แต่ละอันเป็นปัญหาต่างชนิดกัน ที่ต้องแก้ต่างกัน
วิธีอ่าน ความแม่นยำรายระดับเป็นตารางเล็กหรือชุดแท่ง หนึ่งแถวต่อระดับ
1–5 — กวาดตาจากขวาไปซ้ายเพื่อหาว่าตัวเลขตกตรงไหน; คอนฟิกที่เกือบสมบูรณ์แบบ
ใน tier 1–2 แล้วร่วงเป็นหน้าผาที่ tier 4–5 กำลังบอกคุณว่ามันจัดการการค้นหาแบบง่าย
ได้ดี แต่มีปัญหากับ join และการรวมค่าหลายขั้น การแยกย่อยของ outcome คือ
จำนวนนับต่อหมวด (correct, sql_policy_rejected, sql_exec_error,
empty_but_expected, wrong_result) — กอง sql_exec_error ชี้ไปที่ปัญหา
dialect กอง wrong_result ชี้ไปที่ปัญหาเชิงตรรกะ และทั้งสองเรียกร้อง
การแก้ที่ต่างกัน
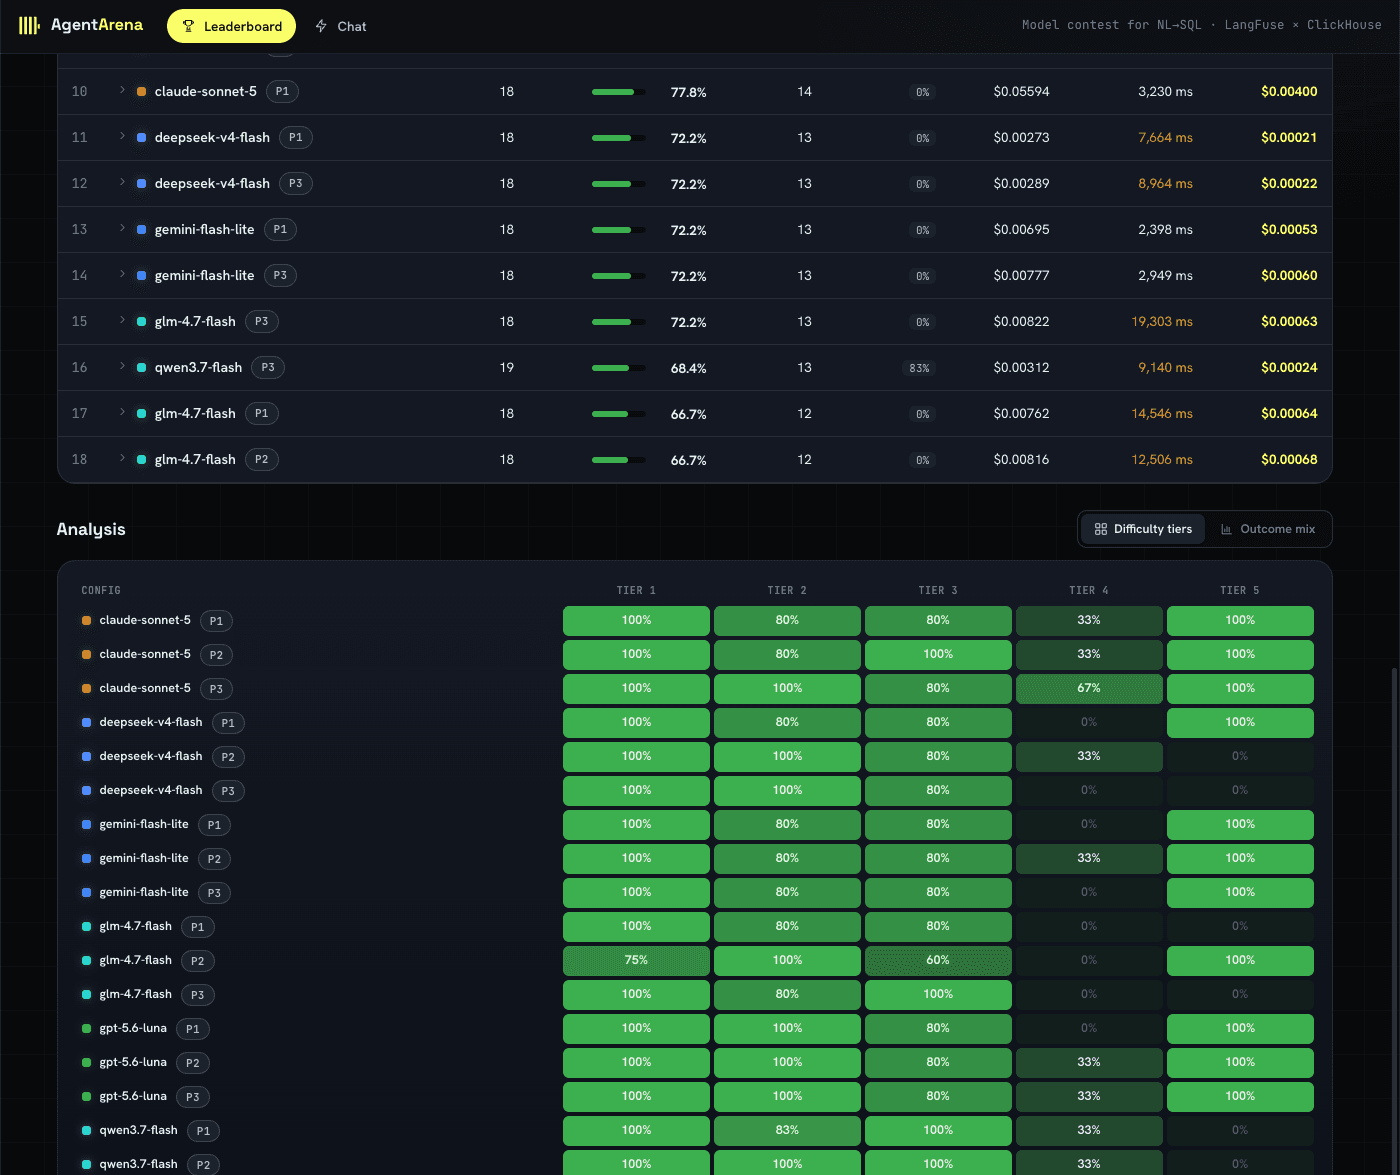
มุมมอง Difficulty tiers เผยรูปแบบที่ความแม่นยำรวมซ่อนไว้ ในการรันครั้งนี้ คอนฟิก ส่วนใหญ่แข็งแรงใน tier 1–3 ขณะที่ tier 4 เป็นจุดอ่อนร่วมที่ชัดที่สุด; เทียบ แถวต่าง ๆ เพื่อดูว่าคอนฟิกที่ชนะมีการร่วงแบบเดียวกันหรือไม่
ขั้นที่ 2 — อ่านคะแนนรอง agent-arena-llm-judge
คะแนน correctness เป็นไบนารี: result set ตรงหรือไม่ตรง คะแนน
agent-arena-llm-judge ซึ่งปล่อยออกมาจาก evaluator definition llm_judge ที่คุณตั้งค่า
ในโมดูล 01 เป็นสัญญาณรองที่
ละเอียดกว่า — การให้คะแนนคุณภาพ SQL แบบ LLM-as-a-judge เพิ่มเติมจากผลไบนารี
นั้น คอนฟิกหนึ่งอาจ ถูกต้อง ตามความแม่นยำเชิงการรันแต่ยังเขียน SQL ที่
ผู้ตรวจจะติงได้ (subquery ที่ไม่จำเป็น การเทียบวันที่ที่เปราะบาง join ที่
เผอิญให้แถวถูกต้องกับข้อมูลชุดนี้แต่จะใช้ทั่วไปไม่ได้) ใช้
agent-arena-llm-judge เพื่อจับช่องว่างระหว่าง "ผ่าน" กับ "เขียนดี"
ขั้นที่ 3 — เจาะลงไปใน trace แต่ละรายการ
คลิกจากแถวใน leaderboard ไปยังผลลัพธ์รายคำถามของมัน แล้วคลิกคำถามข้อใด
ก็ได้เพื่อเปิด Langfuse trace ของมัน แต่ละ trace บรรทุกเส้นทางทั้งหมดของคำถาม
นั้น: prompt ที่ส่งไปยังโมเดล, SQL ที่ถูกสร้างขึ้น, generation llm_call ของโมเดล
(prompt, completion และจำนวน token), ต้นทุนที่แม่นยำและ latency ตั้งแต่ต้นจนจบ
บน Experiment Item และ — ถ้าคำถามนั้นล้มเหลว — error ของ ClickHouse
ที่ตอบกลับมา นี่คือทักษะการอ่าน trace
แบบเดียวกับที่คุณจะใช้อีกครั้งใน โมดูล 04 เมื่อ
คำถามเริ่มเข้ามาจากผู้ใช้จริงแทน golden dataset
เลือกสองหรือสามคำถามที่คอนฟิกที่ชนะของคุณตอบผิด (หรือได้คะแนน
agent-arena-llm-judge ต่ำ) แล้วอ่าน trace ของมันตั้งแต่ต้นจนจบ คุณกำลังมองหารูปแบบ:
การใช้ถ้อยคำ join หรือตัวกรองวันที่ที่โมเดลจัดการผิดอย่างสม่ำเสมอ
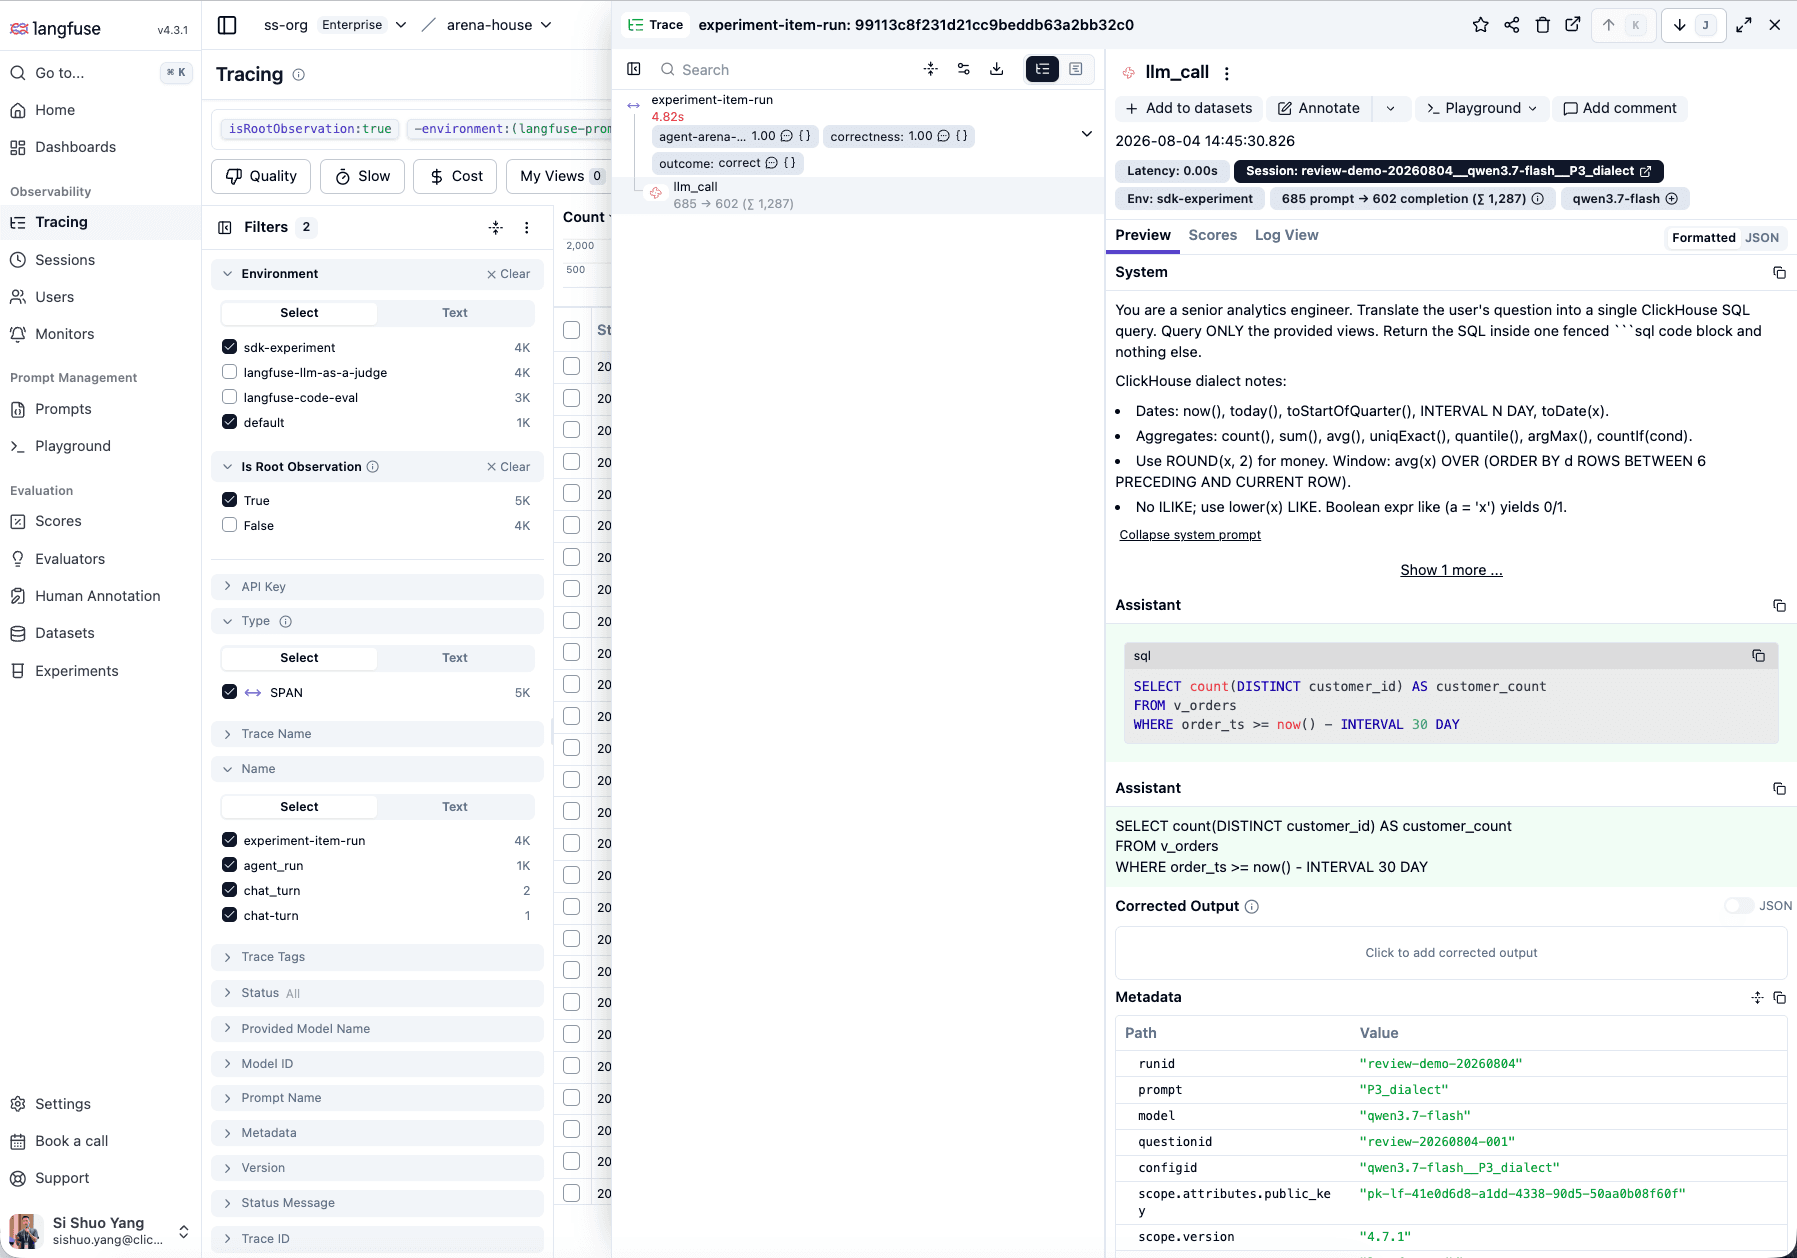
Experiment Item ของ Langfuse เชื่อมคะแนนที่อยู่ด้านบนของ trace เข้ากับ
llm_call ที่แม่นยำอยู่ใต้มัน แผงรายละเอียดแสดง prompt, SQL ที่ถูกสร้างขึ้น, การใช้ token,
latency และ metadata ของการรันที่จำเป็นต่อการอธิบายว่าทำไมคำถามนี้ผ่านหรือล้มเหลว
วิธีตรวจสอบว่าคุณทำเสร็จแล้ว
- คุณบอกความแม่นยำของคอนฟิกที่ชนะในระดับใดระดับหนึ่งได้อย่างเจาะจง ไม่ใช่แค่ ตัวเลขรวมของมัน
- คุณชี้ได้ถึงคำถามอย่างน้อยหนึ่งข้อที่
correctnessและagent-arena-llm-judgeไม่ตรงกัน หรืออธิบายได้ว่าทำไมมันไม่ขัดกันในการรันของคุณ - คุณได้เปิด Langfuse trace อย่างน้อยหนึ่งรายการ และเดินตาม prompt → SQL ที่ถูกสร้างขึ้น → ผลลัพธ์หรือ error ของคำถามนั้นได้
แบบฝึกหัด — ทำให้พังแล้ววินิจฉัยรูปแบบความล้มเหลว
เปลี่ยนการอ่าน trace จากขั้นที่ 3 ให้เป็นชิ้นงานที่เขียนไว้และส่งต่อไปยัง โมดูล 03 ได้:
-
จากผลลัพธ์รายคำถามของคอนฟิกที่ชนะ เลือกคำถาม 2–3 ข้อที่เป็น
correctness = 0หรือได้คะแนนagent-arena-llm-judgeต่ำ -
สำหรับแต่ละข้อ เปิด Langfuse trace ของมันแล้วกรอกหนึ่งแถวของตารางนี้:
คำถาม มันสร้างอะไรออกมา ทำไมมันล้มเหลว หมวด outcome (ข้อความคำถาม) (SQL ที่มันผลิตออกมา แบบย่อ) (ที่คุณอ่านได้: join ผิด, ไม่มีตัวกรองวันที่, อ่านถ้อยคำผิด, …) ( sql_exec_error/wrong_result/ …) -
มองข้ามแถว 2–3 แถวของคุณเพื่อหารูปแบบที่ซ้ำกัน — join ชนิดเดียวกัน ความผิดพลาด เรื่องตัวกรองวันที่แบบเดียวกัน ถ้อยคำแบบเดียวกันที่โมเดลอ่านผิดอย่างสม่ำเสมอ รูปแบบ หนึ่งอย่าง ไม่ใช่แค่รายการบั๊กที่ไม่เกี่ยวกัน คือสิ่งที่คุณต้องการตรงนี้
รูปแบบใดก็ตามที่คุณพบจะกลายเป็นเมล็ดพันธุ์สำหรับโมดูล 03: เปลี่ยนความล้มเหลวที่สังเกตได้ ให้เป็นข้อมูล golden ใหม่ที่ตอกย้ำการแก้ไข
สรุปปิดท้าย
ตอนนี้คุณรู้ไม่ใช่แค่ว่าคอนฟิกของคุณชนะ แต่รู้ว่าอย่างไร — มันแข็งแรงตรงไหน อ่อนแอ ตรงไหน และความล้มเหลวของมันหน้าตาเป็นอย่างไรจริง ๆ ในระดับ trace รายละเอียดนั้นคือ สิ่งที่จะเปลี่ยนเป็นการลงมือทำต่อไปเป๊ะ ๆ
สถานะสุดท้าย
ตอนนี้คุณมีภาพคุณภาพโดยละเอียดของคอนฟิกที่ชนะแล้ว ไปต่อที่ 03 ปล่อยใช้งานและตรวจจับ เพื่อปล่อยใช้งาน คอนฟิกที่เลือกและจับความไม่สอดคล้องระหว่าง evaluator กับสัญญาณจากผู้ใช้จริง