01 Selecionar o modelo base
A Arena — execute a grade de modelo × prompt como experimentos do Langfuse e escolha o vencedor pelo custo por resposta correta.
Ponto de partida
Módulo 00 concluído: .env carregado, banco arena populado, Langfuse conectado e dashboard local acessível em http://localhost:5174, com a aba Leaderboard vazia.
Por que esta é a decisão fundamental
Todo o workshop se apoia nesta decisão. Antes de publicar um agente sério, é preciso responder: qual modelo deve movê-lo? Modelos variam enormemente em capacidade e preço, e a melhor escolha depende da sua tarefa — não de um leaderboard público executado por outra pessoa em outra carga. Adivinhar custa caro nos dois sentidos: pagar demais por um modelo de fronteira desnecessário ou publicar um barato que erra silenciosamente suas perguntas reais.
Em vez de adivinhar, você promove uma competição: a Arena. Uma grade de modelos e estratégias de prompt responde às mesmas perguntas douradas; o Langfuse avalia cada resposta como um experimento; e o vencedor não é escolhido pela precisão bruta, mas pelo custo por resposta correta — qualidade por dólar no seu caso de uso. Concretamente, este módulo responde com evidências: em uma grade de modelos e estratégias de prompt, qual configuração produz mais respostas corretas por dólar? “Correta” significa precisão de execução: o SQL gerado retorna o mesmo conjunto de resultados do SQL dourado, não apenas um SQL plausível. A avaliação ocorre dentro do Langfuse, não no harness: o Langfuse hospeda os evaluators e mantém cada Experiment Item, pontuação e trace. O leaderboard local lê esses registros pela API Pública do Langfuse. Todos os módulos seguintes pressupõem que essa escolha foi feita com evidências.
Conceitos — por baixo dos panos
O modelo de dados do Langfuse para esta avaliação. O corpus-fonte do repositório tem 20 perguntas YAML. q019 e q020 são holdouts do prompt few-shot; portanto, em um projeto limpo, o Dataset populado (arena-golden) contém 18 perguntas experimentais, cada uma com o conjunto de resultados esperado. Cada configuração model × prompt executada é um Experiment — um Dataset Run do Langfuse — sobre os mesmos 18 itens, garantindo igualdade. As definições de evaluator criadas na Etapa 1 são correctness e llm_judge; suas pontuações de Experiment são correctness e agent-arena-llm-judge. Um dataset, muitos experimentos e uma pontuação por item e experimento permitem comparar configurações de forma equivalente.
Cada configuração de modelo × prompt é um Experiment (Dataset Run) sobre o dataset arena-golden, e cada experimento associa duas pontuações a cada item: correctness (0/1) e agent-arena-llm-judge (0..1).
As estratégias de prompt também competem. A grade não contém apenas modelos: ela é model × prompt, pois a forma de perguntar importa tanto quanto a quem se pergunta. De config.yaml e agents/prompts.py:
| Prompt | O que faz | Como pode ajudar em NL→SQL |
|---|---|---|
P1_zeroshot | Apenas esquema + pergunta; retorna um bloco SQL cercado. É a referência. | Menor custo por chamada; mede o que o modelo faz sem ajuda. |
P2_fewshot | P1 mais 2 exemplos NL→SQL resolvidos (excluídos do conjunto de testes). | Mostra o formato esperado de uma “boa” resposta antes que o modelo escreva. |
P3_dialect | P1 mais uma folha de consulta do dialeto ClickHouse (funções de data, uniqExact, argMax, INTERVAL, sem ILIKE, …). | Corrige a falha mais comum: SQL fluente que não é SQL ClickHouse válido. |
Os participantes: proprietários versus pesos abertos. Os seis concorrentes se dividem igualmente em outro eixo importante: pesos fechados (API de fornecedor) ou abertos (modelo que pode ser auto-hospedado, ajustado ou mantido dentro do seu limite de dados). Modelos de pesos abertos costumam ser muito mais baratos por token; modelos proprietários de fronteira podem liderar em capacidade bruta — mas esse “podem” é o que a Arena testa na sua tarefa. Executar ambos sobre o mesmo dataset dourado deixa o custo por resposta correta indicar se a fronteira vale o preço ou se um modelo aberto barato alcança o resultado por uma fração do custo. A lista foi deliberadamente mantida econômica: NL→SQL é simples o bastante para que até o participante mais caro seja intermediário, não de fronteira.
| Modelo | Fornecedor | Aberto / Proprietário | Referência ilustrativa ($/1M entrada · saída) |
|---|---|---|---|
claude-sonnet-5 | Anthropic | Proprietário | $2.00 · $10.00 |
gpt-5.6-luna | OpenAI | Proprietário | $0.50 · $3.00 |
gemini-flash-lite | Proprietário | $0.30 · $2.50 | |
deepseek-v4-flash | DeepSeek | Pesos abertos | $0.14 · $0.28 |
qwen3.7-flash | Qwen | Pesos abertos | $0.03 · $0.13 |
glm-4.7-flash | Z.ai | Pesos abertos | $0.06 · $0.40 |
Por que custo por resposta correta e precisão de execução. “Correto” é determinado pela precisão de execução: executar o SQL gerado produz o mesmo conjunto de resultados que o SQL dourado? Esse é o sinal honesto: não exige SQL idêntico, apenas a resposta correta. A principal métrica do ranking é
cost_per_correct_answer = total cost of the run ($) / number of correct answersAssim, um modelo quase tão preciso e muito mais barato pode superar um modelo de fronteira marginalmente melhor e muito mais caro — exatamente o que uma equipe atenta a custos otimizaria.
Objetivo
Um Leaderboard com pelo menos algumas configurações model × prompt classificadas por custo por resposta correta, cada uma respaldada por um trace detalhável do Langfuse, e um vencedor: um config_id.
Etapa 1 — Configurar os evaluators do Langfuse (uma vez)
Faça isso uma vez, seguindo eval/langfuse_evaluators/README.md. Primeiro, popule arena-golden e configure pela API o judge apoiado pelo OpenRouter:
python -m scripts.provision_langfuse_evaluatorsDepois, configure o evaluator de código determinístico na interface do Langfuse:
- Evaluator de código
correctness— Evaluators → Set up Evaluator → Code → coleeval/langfuse_evaluators/correctness_evaluator.py→ Target: Experiments → filtre dataset =arena-golden. Ele compara o conjunto de resultados do agente (no trace) com o conjunto dourado (oexpected_outputdo item) e emite a pontuaçãocorrectness(0/1) de precisão de execução e uma categoriaoutcome. Não há tráfego de rede: o SQL já foi executado pelo agente; o evaluator apenas compara resultados. - Alternativa manual para a definição
llm_judge— Evaluators → Set up Evaluator → LLM-as-a-judge → Custom → use os prompts de sistema/avaliação e mapeamentos de variáveis deeval/langfuse_evaluators/llm_judge_prompt.md→ Target: Experiments, datasetarena-golden→ emita a pontuação numéricaagent-arena-llm-judge. Definição e pontuação têm nomes distintos intencionalmente. Esse sinal secundário avalia a qualidade do SQL além da correctness principal e será usado no Módulo 02.
O helper é o caminho recomendado; o judge manual é apenas uma alternativa. O evaluator de código determinístico correctness continua sendo configurado uma única vez na interface.
Etapa 2 — Executar a competição
source .env && python -m eval.harness --run-id demoO que você deve ver. O harness primeiro imprime um resumo (run_id=demo configs=6x3 ...) e depois uma linha por pergunta, por exemplo:
claude-sonnet-5__P1_zeroshot q001 pending 812ms $0.00021Cada linha começa como pending: o SQL foi executado e o resultado está no trace, mas os evaluators do Langfuse ainda não pontuaram. Depois que todas as configurações terminam, o harness passa a aguardar: grading via Langfuse evaluators — waiting on N traces...,
mostra uma contagem regressiva enquanto chegam as pontuações correctness/agent-arena-llm-judge e
conclui com Langfuse scored all N traces; leaderboard ready. Essa transição de pending → pontuado é a entrega da avaliação ao Langfuse; resultado e veredito permanecem juntos como fonte da verdade do leaderboard.
Isso executa a grade model × prompt completa (todos os modelos de config.yaml contra todas as estratégias, de P1_zeroshot a P3_dialect) como Dataset Runs (Experiments) no dataset arena-golden. O harness aguarda as pontuações exatas correctness e agent-arena-llm-judge em cada item. Custo exato do OpenRouter e latência ponta a ponta ficam no mesmo Experiment Item.
Uma configuração é <model>__<prompt>, por exemplo claude-sonnet-5__P1_zeroshot. Os nomes vêm de config.yaml:
- Modelos: os seis da tabela — três proprietários (
claude-sonnet-5,gpt-5.6-luna,gemini-flash-lite) e três de pesos abertos (deepseek-v4-flash,qwen3.7-flash,glm-4.7-flash) - Prompts:
P1_zeroshot,P2_fewshot,P3_dialect
Opções úteis:
--models qwen3.7-flash,gpt-5.6-luna/--prompts P1_zeroshot,P3_dialect— limita a grade a um subconjunto CSV.--run-id <name>— identifica a execução no Leaderboard e na visão Experiments do Langfuse.
O SDK pode processar itens em ordem inversa ou concorrente; acompanhe o ID da pergunta, não espere a ordem q001, q002, ... Uma grade completa com 18 configurações costuma levar 35–45 minutos. Em workshops, comece com dois modelos e um prompt; execute tudo apenas se o cronograma e os limites do provedor permitirem.
Os evaluators do Langfuse são obrigatórios. O Langfuse agora é o único repositório de avaliação; não há alternativa de avaliação local ou resultados no ClickHouse. Se o harness expirar aguardando pontuações, corrija a configuração da Etapa 1 e use um novo --run-id.
Etapa 3 — Escolher o vencedor
Abra http://localhost:5174 → Leaderboard. Cada configuração model × prompt é classificada por custo por resposta correta. Um gráfico de custo × precisão e um ranking de “melhor valor” aparecem acima da tabela.
O custo usa os preços ao vivo do OpenRouter: o harness atualiza os preços pelo endpoint /models no início da execução, para refletir o preço atual, não um número obsoleto em config.yaml.
Como interpretar. A ordem é custo por resposta correta crescente: o vencedor é a linha do topo, não a de maior precisão. No gráfico, observe um modelo barato perto de um caro no eixo de precisão; essa diferença por uma fração do custo justifica a métrica.
Armadilha — maior precisão ≠ vencedor. É tentador olhar só a precisão. A Arena classifica pelo custo por resposta correta; uma configuração um pouco menos precisa e muito mais barata pode superar outra mais cara e um pouco mais precisa. Consulte $/correct, não apenas a precisão.
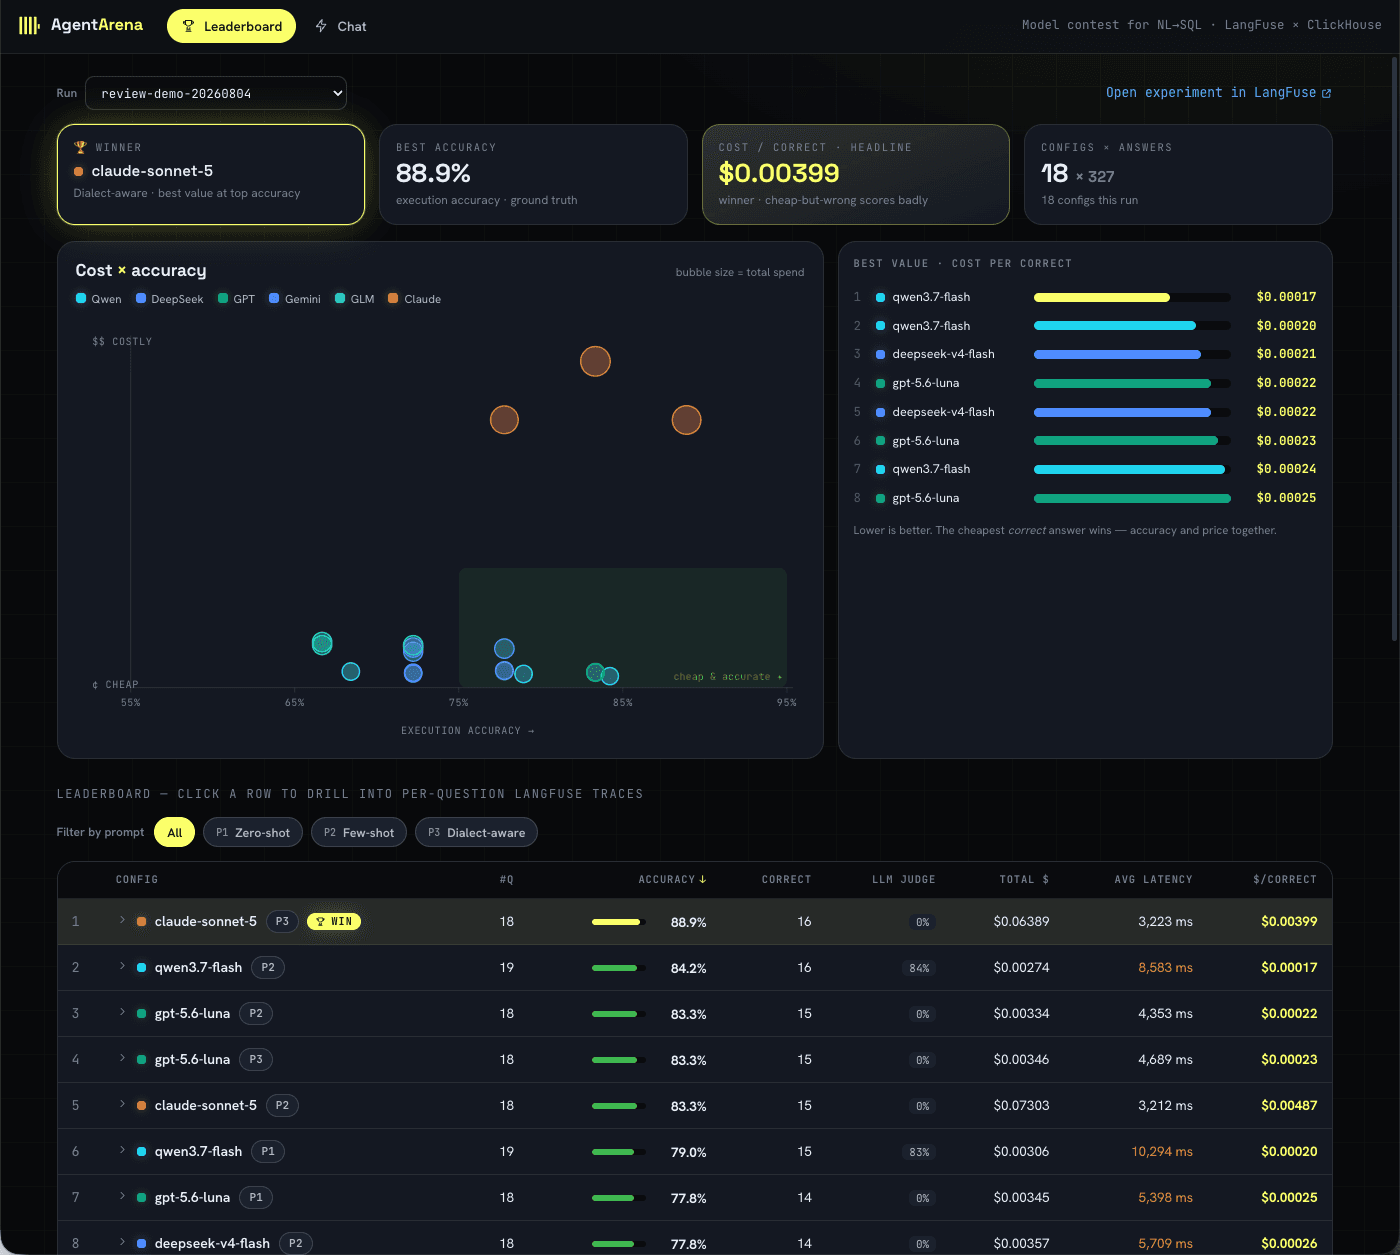
O Leaderboard coloca qualidade e preço lado a lado. O gráfico mostra a relação custo × precisão, enquanto a lista de melhor valor e a coluna $/correct revelam quais configurações convertem investimento em respostas corretas com mais eficiência.
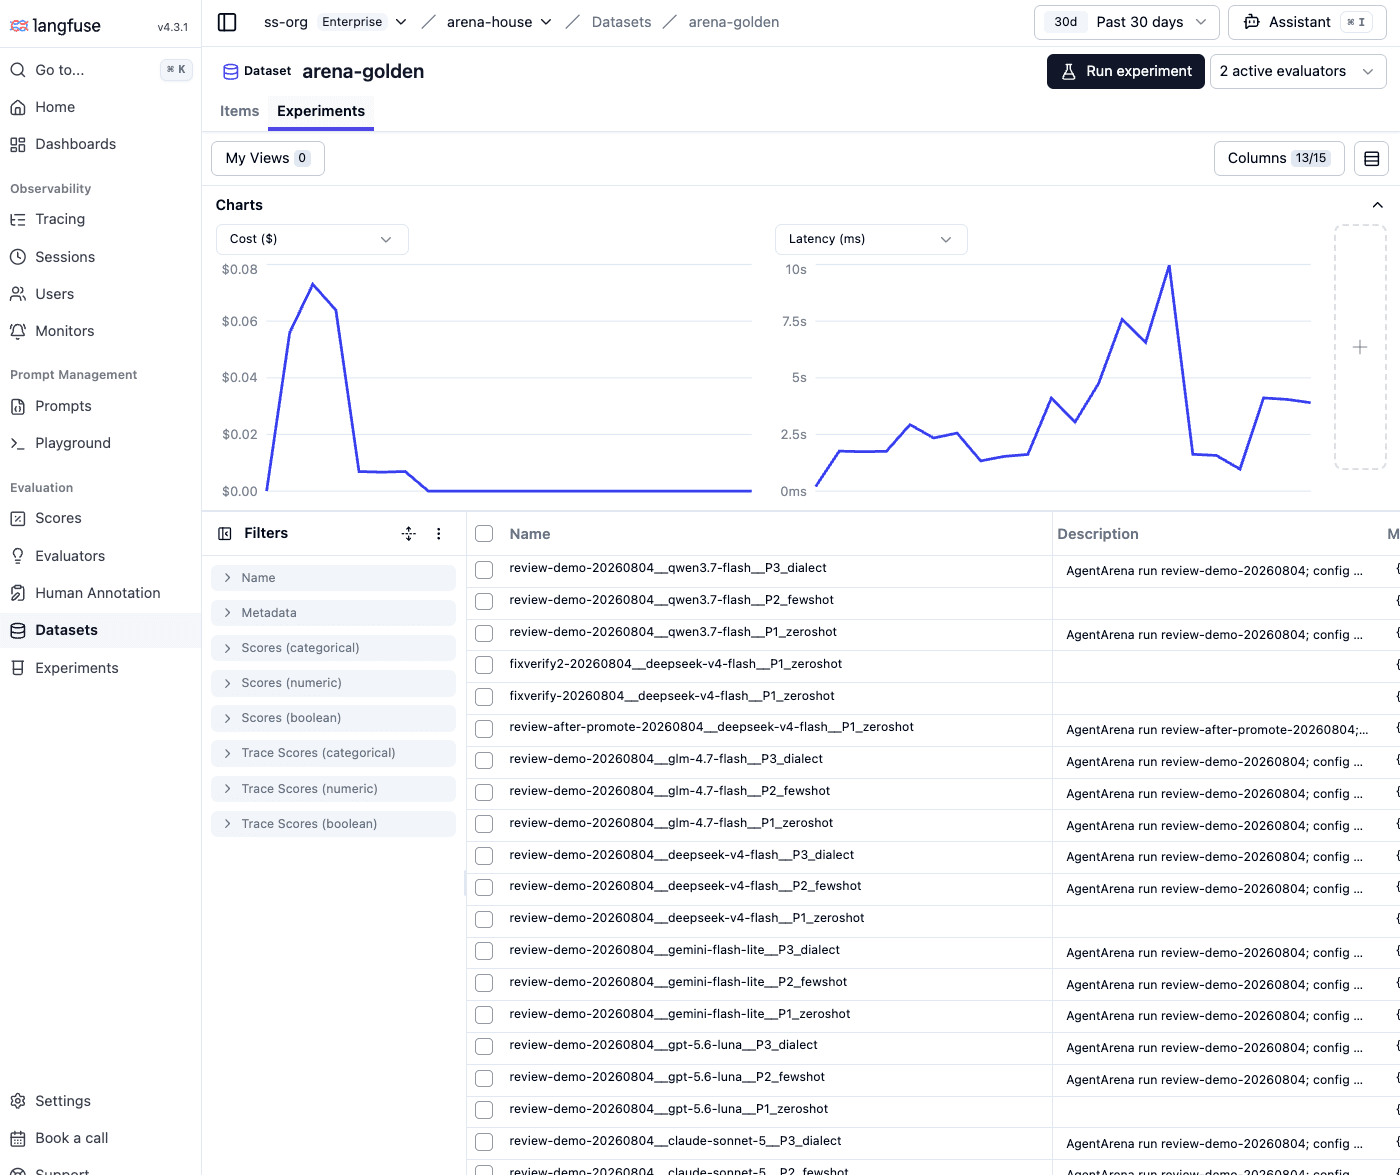
A aba Experiments de arena-golden contém um Dataset Run para cada configuração de modelo × prompt. Os gráficos resumem custo e latência nas mesmas perguntas douradas, portanto cada linha é diretamente comparável.
A primeira linha é o vencedor: anote seu config_id. O Módulo 02 aprofunda o quanto ele é bom, não apenas o fato de ter vencido.
Como verificar se terminou
- A tabela Leaderboard mostra pelo menos uma linha
model × promptcom valor de custo por resposta correta. - Clicar numa configuração mostra resultados por pergunta; clicar numa pergunta abre seu trace no Langfuse com o SQL gerado.
- Você sabe indicar o
config_id(<model>__<prompt>) vencedor.
Exercício — prever e verificar
Antes de abrir o Leaderboard, faça uma previsão e anote-a:
- Olhando apenas a lista de modelos e a tabela de prompts, adivinhe qual configuração
model × promptvencerá em custo por resposta correta. Anote oconfig_ide uma frase explicando por quê (por exemplo, “o modelo mais barato com o prompt de dialeto, pois a maioria das falhas é de dialeto, não de raciocínio”). - Abra o Leaderboard e confira. Você acertou?
- Qualquer que seja o resultado, um modelo mais barato venceu (ou chegou perto de) um modelo de fronteira? Se sim, essa diferença — barato e quase tão bom superando caro e um pouco melhor — é a razão para classificar por custo por resposta correta. Se um modelo de fronteira venceu com folga, anote a margem sobre a configuração seguinte mais barata: ela justificaria o preço numa decisão real de implantação.
Recapitulação
Agora você tem evidências, não um palpite, sobre qual modelo e estratégia vale executar — classificados pelo custo por resposta correta e respaldados por traces do Langfuse. Anote o config_id vencedor; ele será usado em todos os módulos seguintes.
Estado final
Um leaderboard classificado e um config_id vencedor. Continue para
02 Medir offline e descubra o desempenho real do vencedor.