02 Ukur kualitas
Pakai evaluators, datasets, dan traces Langfuse untuk melihat sebaik apa pemenangnya — per pertanyaan, per tier.
Titik awal
Modul 01 selesai: Arena sudah berjalan, Leaderboard sudah terisi, dan kamu punya satu
config_id pemenang (<model>__<prompt>, misalnya claude-sonnet-5__P1_zeroshot).
Mengapa
Menang di Arena hanya memberi tahu kamu bahwa satu config mengalahkan yang lain pada cost per correct answer secara agregat. Itu tidak memberi tahu bagaimana dia menang, di mana titik terlemahnya, atau apakah SQL-nya sekadar benar atau memang bagus. Sebelum kamu membangun di atas model ini (meningkatkannya, merilisnya), sebaiknya kamu memahaminya — seperti kamu ingin tahu bukan cuma bahwa seorang kandidat lulus wawancara, tetapi pertanyaan mana yang dia kuasai dan mana yang nyaris tidak dia lewati. Langfuse sudah punya semua yang kamu butuhkan untuk ini: evaluator dari Modul 01 menilai setiap item, dan setiap item punya trace lengkap. Modul ini tentang membaca detail itu, bukan menghasilkan data baru.
Konsep — di balik layar
Trace → observations → scores. Langfuse menyusun setiap run agent dengan cara yang sama:
- Sebuah trace adalah satu run agent — satu eksekusi
model × prompt × question, bernamaagent_rundan diberi tagconfig_id. - Observations adalah span di dalam trace itu. Satu-satunya adalah
llm_call, sebuah observation generation yang membawa prompt, completion, dan token usage untuk panggilan model. Output Experiment Item mencatat cost dan latensi end-to-end persis yang dipakai leaderboard. Tidak ada observation terpisah untuk langkah eksekusi SQL — SQL-nya berjalan sebagai panggilan ClickHouse biasa tanpa span Langfuse sendiri; SQL yang dihasilkan dan result set-nya justru mendarat di input/output root trace. - Scores adalah yang dilekatkan evaluator dari Modul 01 ke trace/dataset item
setelahnya:
correctness(execution accuracy biner),agent-arena-llm-judge(kualitas SQL bergradasi ala LLM-as-a-judge), dan sebuah kategorioutcome. Definisi evaluator Langfuse bernamallm_judge; score yang dihasilkannya dan ditunggu harness bernama persisagent-arena-llm-judge.
Setiap trace adalah satu agent_run dengan satu observation anak, generation llm_call, ditambah tiga score yang dilekatkan evaluator Langfuse setelah penilaian: correctness, agent-arena-llm-judge, dan outcome.
Tier. Korpus sumber berisi 20 pertanyaan YAML, tetapi q019 dan q020 adalah
holdout untuk prompt few-shot. Pada project bersih, masing-masing dari 18 pertanyaan experiment yang di-seed
ke arena-golden punya tier dari 1
(paling sederhana — count dan filter satu tabel) sampai 5 (paling sulit — join multi-tabel,
funnel, perhitungan margin). Akurasi per tier ada karena angka keseluruhan sebuah config
bisa menyembunyikan kehancuran di tier 5 di balik performa kuat di tier 1/2.
Kategori outcome. Code Evaluator correctness di Langfuse
(eval/langfuse_evaluators/correctness_evaluator.py) mengklasifikasikan setiap
Experiment Item yang selesai ke salah satu kategori ini, diurut berdasarkan seberapa "jauh" jawabannya sampai:
| Outcome | Artinya |
|---|---|
correct | Result set cocok dengan golden result set. |
model_error | Panggilan OpenRouter itu sendiri gagal (key salah/kedaluwarsa, rate limit, provider tumbang) sebelum SQL apa pun dihasilkan. |
sql_policy_rejected | agents/sqlguard.py memblokir SQL yang dihasilkan sebelum sampai ke ClickHouse (bukan satu SELECT, atau kena keyword terlarang). |
sql_exec_error | SQL sampai ke ClickHouse tetapi query-nya gagal dieksekusi (sintaks salah, kolom tidak dikenal, dsb.). |
empty_but_expected | Query berjalan dan mengembalikan nol baris, tetapi jawaban golden-nya punya baris. |
wrong_result | Query berjalan dan mengembalikan baris, tetapi tidak cocok dengan golden result set. |
Masing-masing menyiratkan perbaikan yang berbeda: run sql_policy_rejected butuh system prompt yang lebih baik
soal tetap read-only; sql_exec_error biasanya berarti celah dialek (lihat
P3_dialect); empty_but_expected dan wrong_result biasanya berarti kesalahan logika filter, join, atau
agregasi.
Tujuan
Nyaman membaca akurasi per tier dan rincian outcome untuk config pemenangmu,
memahami apa yang ditambahkan sinyal sekunder agent-arena-llm-judge di atas correctness
mentah, dan mampu menelusuri dari satu baris leaderboard ke trace Langfuse persis
di balik satu pertanyaan mana pun.
Langkah 1 — Baca akurasi per tier dan rincian outcome
Buka http://localhost:5174 → Leaderboard dan klik masuk ke baris config pemenangmu. Selain akurasi, latensi, dan cost-per-correct-answer, setiap config memperlihatkan:
- Akurasi per tier — pertanyaan di
arena-goldendikelompokkan menurut tier kesulitan; config yang tampak kuat secara keseluruhan tetap bisa goyah di tier tersulit, dan itu persis jenis celah yang disembunyikan angka agregat. - Rincian outcome — tidak semua jawaban yang tidak benar gagal dengan cara yang sama. Ada SQL yang ditolak sandbox, ada yang mengembalikan error ClickHouse, ada yang mengembalikan hasil kosong, ada yang cuma mengembalikan result set yang salah. Masing-masing masalah berbeda dengan perbaikan yang berbeda.
Cara membacanya. Akurasi per tier berupa tabel kecil atau set bar, satu baris per tier
1–5 — pindai dari kanan ke kiri untuk melihat di mana angkanya jatuh; config yang nyaris sempurna
di tier 1–2 lalu jatuh curam di tier 4–5 sedang memberi tahu kamu bahwa ia menangani lookup sederhana
dengan baik tetapi kesulitan dengan join dan agregasi bertahap. Rincian outcome adalah
jumlah per kategori (correct, sql_policy_rejected, sql_exec_error,
empty_but_expected, wrong_result) — tumpukan sql_exec_error menunjuk ke masalah
dialek, tumpukan wrong_result menunjuk ke masalah logika, dan keduanya menuntut
perbaikan yang berbeda.
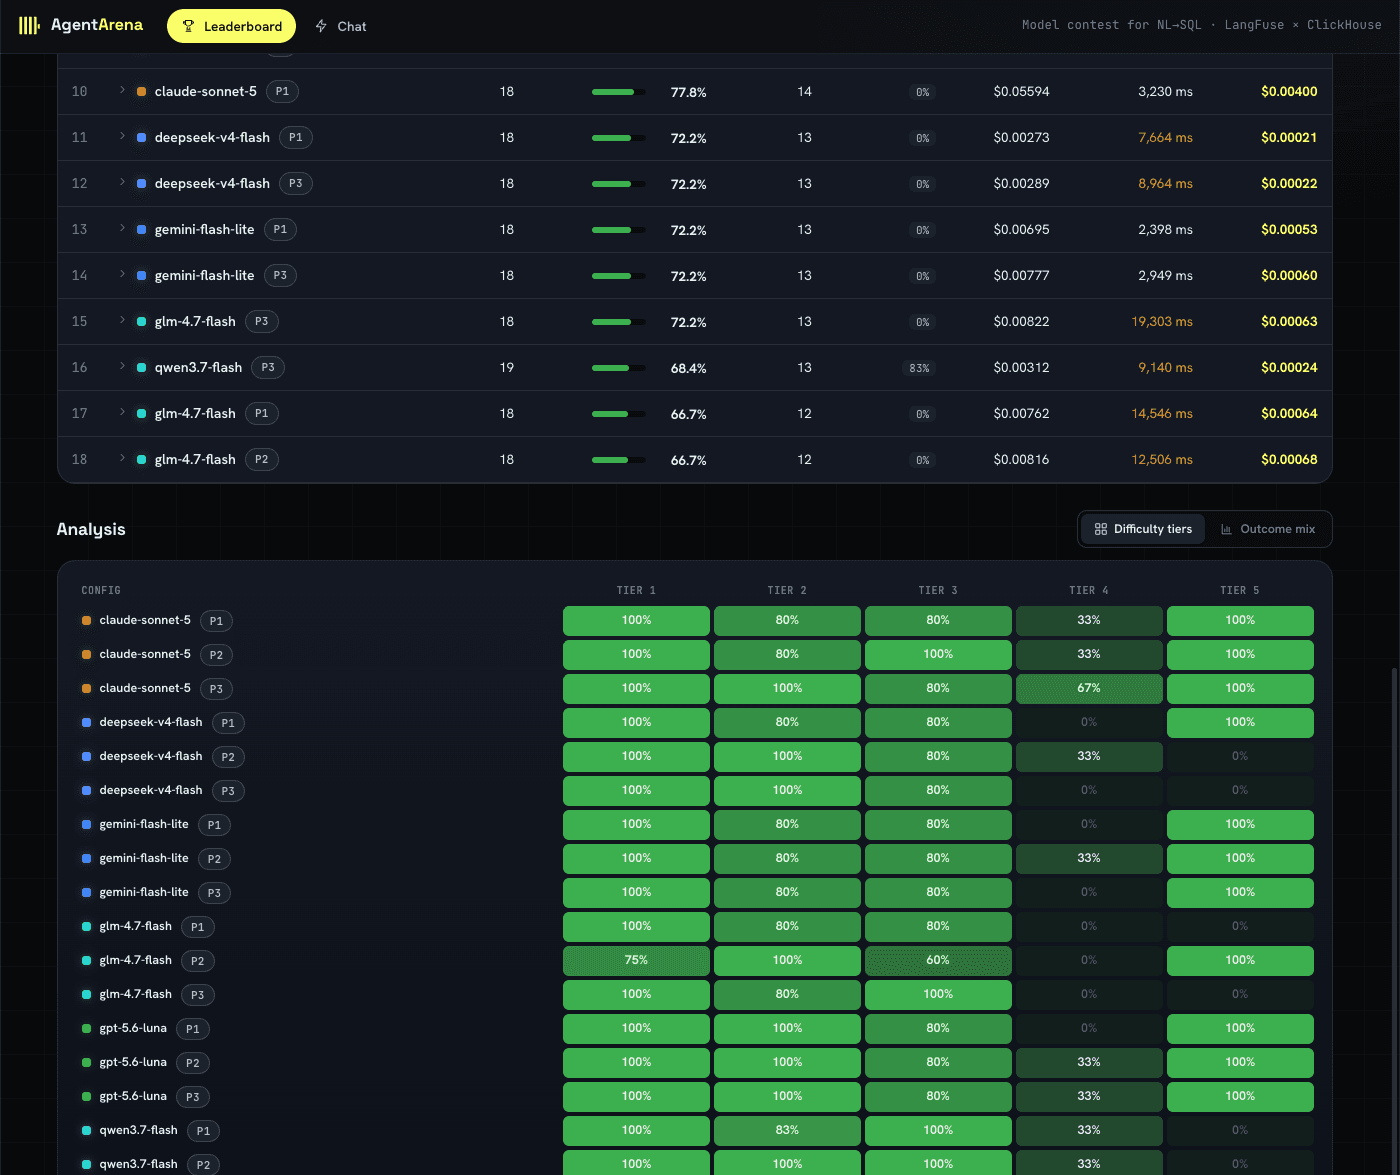
Tampilan Difficulty tiers menyingkap pola yang tersembunyi di balik akurasi keseluruhan. Pada run ini, sebagian besar konfigurasi kuat di tier 1–3, sementara tier 4 adalah kelemahan bersama yang paling jelas; bandingkan antar baris untuk melihat apakah konfigurasi pemenang punya penurunan yang sama.
Langkah 2 — Baca sinyal sekunder agent-arena-llm-judge
Score correctness bersifat biner: apakah result set-nya cocok, ya atau tidak. Score
agent-arena-llm-judge, yang dihasilkan definisi evaluator llm_judge yang kamu
konfigurasikan di Modul 01, adalah sinyal sekunder
yang lebih halus — penilaian kualitas SQL ala LLM-as-a-judge di atas outcome biner
itu. Sebuah config bisa benar menurut execution accuracy sambil tetap menulis SQL yang akan
ditandai seorang reviewer (subquery yang tidak perlu, perbandingan tanggal yang rapuh, join yang
kebetulan menghasilkan baris yang benar untuk data ini tetapi tidak akan digeneralisasi). Pakai
agent-arena-llm-judge untuk menemukan celah antara "lulus" dan "ditulis dengan baik."
Langkah 3 — Telusuri trace individual
Klik dari satu baris leaderboard ke hasil per pertanyaannya, lalu klik satu
pertanyaan untuk membuka trace Langfuse-nya. Setiap trace membawa jalur lengkap untuk pertanyaan
itu: prompt yang dikirim ke model, SQL yang dihasilkan, generation llm_call model
(prompt, completion, dan jumlah token), cost persis dan latensi end-to-end
pada Experiment Item, dan — kalau pertanyaannya gagal — error ClickHouse
yang kembali. Ini keterampilan membaca trace yang sama
yang akan kamu pakai lagi di Modul 04 begitu
pertanyaan mulai datang dari pengguna nyata ketimbang dari golden dataset.
Pilih dua atau tiga pertanyaan yang dijawab salah oleh config pemenangmu (atau bernilai rendah pada
agent-arena-llm-judge) dan baca trace-nya dari awal sampai akhir. Kamu mencari sebuah pola: satu
frasa, satu join, satu filter tanggal yang konsisten salah ditangani model.
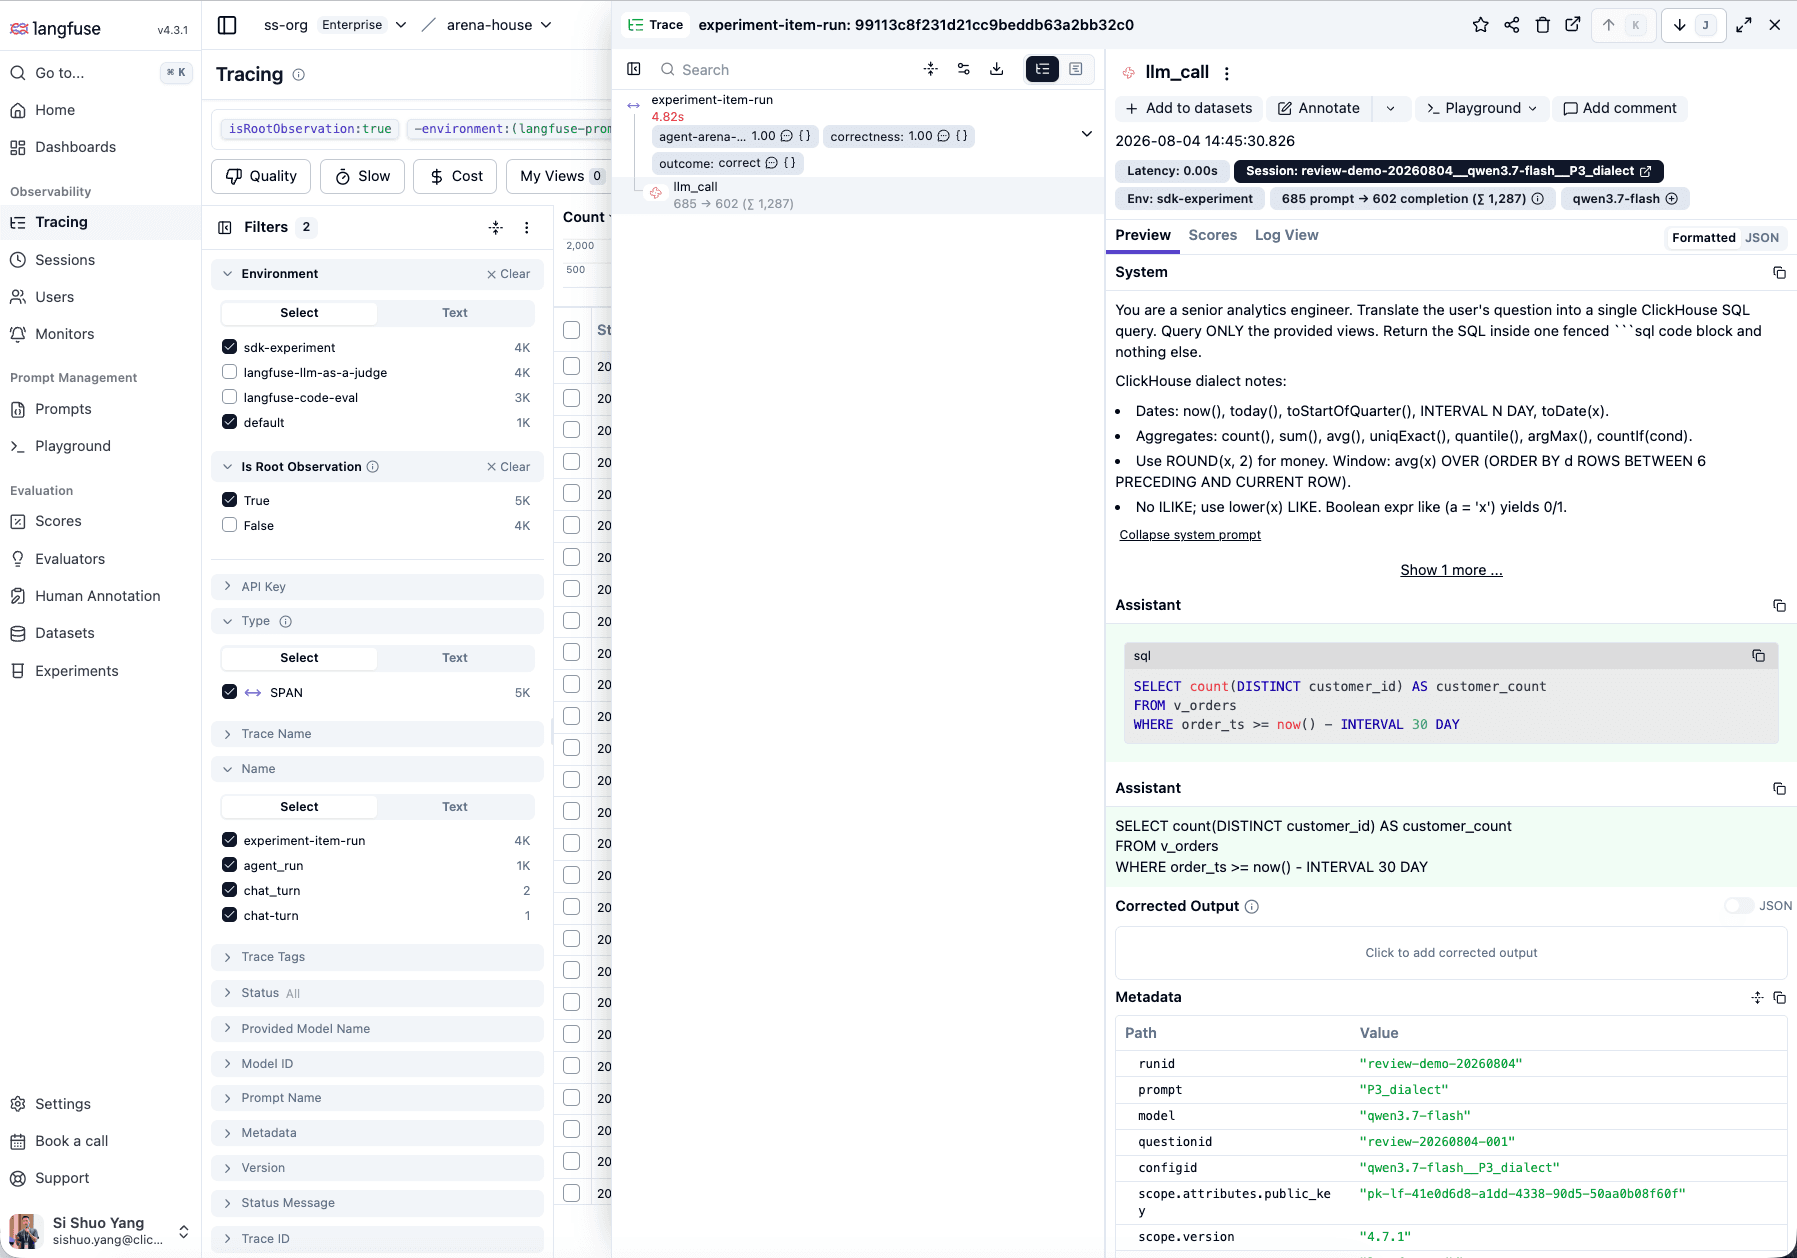
Sebuah Experiment Item Langfuse menghubungkan score di bagian atas trace dengan
llm_call persis di bawahnya. Panel detail memperlihatkan prompt, SQL yang dihasilkan, token usage,
latensi, dan metadata run yang dibutuhkan untuk menjelaskan mengapa pertanyaan ini lulus atau gagal.
Cara memastikan kamu sudah selesai
- Kamu bisa menyebutkan akurasi config pemenangmu pada setidaknya satu tier tertentu, bukan cuma angka keseluruhannya.
- Kamu bisa menunjuk setidaknya satu pertanyaan di mana
correctnessdanagent-arena-llm-judgetidak sepakat, atau menjelaskan kenapa keduanya sepakat pada run kamu. - Kamu sudah membuka setidaknya satu trace Langfuse dan bisa menelusuri prompt → SQL yang dihasilkan → hasil atau error untuk pertanyaan itu.
Latihan — rusakkan lalu diagnosa satu pola kegagalan
Ubah pembacaan trace dari Langkah 3 menjadi artefak tertulis yang bisa kamu serahkan ke Modul 03:
-
Dari hasil per pertanyaan config pemenangmu, pilih 2–3 pertanyaan yang entah
correctness = 0atau bernilai rendah padaagent-arena-llm-judge. -
Untuk masing-masing, buka trace Langfuse-nya dan isi satu baris tabel ini:
Pertanyaan Apa yang dihasilkannya Kenapa gagal Kategori outcome (teks pertanyaan) (SQL yang dihasilkan, ringkas) (bacaanmu: join salah, filter tanggal hilang, frasa salah dibaca, …) ( sql_exec_error/wrong_result/ …) -
Lihat lintas 2–3 baris itu untuk menemukan pola yang berulang — jenis join yang sama, kesalahan filter tanggal yang sama, frasa yang sama yang konsisten salah dibaca model. Satu pola, bukan sekadar daftar bug yang tidak berhubungan, itulah yang kamu cari di sini.
Pola apa pun yang kamu temukan menjadi benih untuk Modul 03: mengubah kegagalan yang teramati menjadi golden data baru yang memaku perbaikannya.
Penutup
Sekarang kamu tahu bukan cuma bahwa config-mu menang, tetapi bagaimana — di mana ia kuat, di mana ia lemah, dan seperti apa kegagalannya sebenarnya di level trace. Detail itulah yang berubah menjadi tindakan selanjutnya.
Kondisi akhir
Kini Anda memiliki gambaran kualitas yang terperinci untuk konfigurasi pemenang. Lanjut ke 03 Rilis dan deteksi untuk merilis konfigurasi terpilih dan menangkap perbedaan nyata antara evaluator dan sinyal pengguna.
01 Pilih model dasar
Arena — jalankan grid model × prompt sebagai Langfuse experiments dan tetapkan pemenang berdasarkan cost per correct answer.
03 Rilis dan deteksi
Rilis agen terpilih dengan titik buta kebijakan yang sudah diketahui, lalu gunakan evaluasi operasional dan masukan pengguna nyata untuk mendeteksinya.