02 Đo chất lượng
Dùng evaluators, datasets và traces của Langfuse để xem người thắng thực sự tốt đến đâu — theo từng câu hỏi, theo từng tier.
Điểm khởi đầu
Module 01 đã hoàn tất: Arena đã chạy, Leaderboard đã có dữ liệu, và bạn có một
config_id thắng (<model>__<prompt>, ví dụ claude-sonnet-5__P1_zeroshot).
Vì sao
Thắng Arena chỉ cho bạn biết một cấu hình đã vượt phần còn lại về chi phí trên mỗi câu trả lời đúng tính tổng thể. Nó không cho bạn biết nó thắng bằng cách nào, nó yếu nhất ở đâu, hay SQL của nó chỉ đúng hay thực sự tốt. Trước khi bạn xây tiếp trên model này (cải thiện nó, phát hành nó), đáng để hiểu nó — giống như bạn muốn biết không chỉ rằng một ứng viên đã qua phỏng vấn, mà là họ trả lời xuất sắc câu nào và câu nào chỉ vừa đủ lướt qua. Langfuse đã có mọi thứ bạn cần cho việc này: các evaluator từ Module 01 đã chấm điểm mọi item, và mọi item đều có một trace đầy đủ. Module này nói về việc đọc phần chi tiết đó, không phải sinh thêm dữ liệu mới.
Khái niệm — bên dưới lớp vỏ
Trace → observations → scores. Langfuse cấu trúc mọi lần chạy của agent theo cùng một cách:
- Một trace là một lần chạy agent — một lần thực thi
model × prompt × question, đặt tênagent_runvà gắn tagconfig_id. - Observations là các span bên trong trace đó. Span duy nhất là
llm_call, một observation loại generation mang theo prompt, completion và lượng token dùng cho lệnh gọi model. Output của Experiment Item ghi lại chi phí và độ trễ đầu-cuối chính xác mà leaderboard dùng. Không có observation riêng cho bước thực thi SQL — SQL chạy như một lệnh gọi ClickHouse thuần, không có span Langfuse riêng; thay vào đó SQL được sinh ra và tập kết quả của nó nằm ở input/output của gốc trace. - Scores là những gì các evaluator từ Module 01 gắn vào trace/dataset item
sau đó:
correctness(độ chính xác khi thực thi, nhị phân),agent-arena-llm-judge(chất lượng SQL do LLM-as-a-judge chấm theo thang điểm), và một hạng mụcoutcome. Evaluator definition trong Langfuse làllm_judge; score nó phát ra và harness chờ có tên chính xác làagent-arena-llm-judge.
Mỗi trace là một agent_run với đúng một observation con, generation llm_call, cộng thêm ba score mà các evaluator của Langfuse gắn vào sau khi chấm điểm: correctness, agent-arena-llm-judge và outcome.
Tiers. Bộ nguồn có 20 câu hỏi YAML, nhưng q019 và q020 được giữ lại làm
few-shot prompt holdout. Trong một project sạch, mỗi câu trong 18 câu hỏi experiment được seed vào
arena-golden có một tier từ 1
(đơn giản nhất — đếm và lọc trên một bảng) đến 5 (khó nhất — join nhiều bảng,
funnel, tính biên lợi nhuận). Độ chính xác theo tier tồn tại vì con số tổng thể của một cấu hình
có thể che giấu việc sụp đổ ở tier 5 phía sau kết quả tốt ở tier 1/2.
Các hạng mục outcome. Code Evaluator correctness của Langfuse
(eval/langfuse_evaluators/correctness_evaluator.py) phân loại mọi Experiment Item đã
hoàn tất vào một trong các hạng mục sau, theo thứ tự câu trả lời đi được "xa" đến đâu:
| Outcome | Nó nghĩa là gì |
|---|---|
correct | Tập kết quả khớp với tập kết quả golden. |
model_error | Bản thân lệnh gọi OpenRouter thất bại (key sai/hết hạn, giới hạn tần suất, nhà cung cấp gián đoạn) trước khi sinh ra SQL nào. |
sql_policy_rejected | agents/sqlguard.py đã chặn SQL được sinh ra trước khi nó tới được ClickHouse (không phải một SELECT duy nhất, hoặc trúng một từ khóa bị cấm). |
sql_exec_error | SQL tới được ClickHouse nhưng truy vấn thực thi thất bại (sai cú pháp, cột không tồn tại, v.v.). |
empty_but_expected | Truy vấn chạy và trả về không dòng nào, nhưng câu trả lời golden có dòng. |
wrong_result | Truy vấn chạy và trả về các dòng, nhưng chúng không khớp tập kết quả golden. |
Mỗi hạng mục hàm ý một cách sửa khác nhau: một lần chạy sql_policy_rejected cần một system prompt tốt hơn
về việc giữ chế độ chỉ đọc; sql_exec_error thường nghĩa là thiếu hụt về dialect (xem
P3_dialect); empty_but_expected và wrong_result thường nghĩa là lỗi logic ở bộ lọc, join hoặc
phép tổng hợp.
Mục tiêu
Thoải mái đọc độ chính xác theo tier và phần phân tách outcome cho cấu hình thắng
của bạn, hiểu score thứ cấp agent-arena-llm-judge bổ sung thêm điều gì bên trên độ chính xác
thuần, và có thể đi từ một dòng trên leaderboard vào đúng trace Langfuse
phía sau bất kỳ câu hỏi nào.
Bước 1 — Đọc độ chính xác theo tier và phần phân tách outcome
Mở http://localhost:5174 → Leaderboard rồi bấm vào dòng của cấu hình thắng của bạn. Bên cạnh độ chính xác, độ trễ và chi phí trên mỗi câu trả lời đúng, mỗi cấu hình còn hiển thị:
- Độ chính xác theo tier — các câu hỏi trong
arena-goldenđược nhóm theo tier độ khó; một cấu hình trông có vẻ mạnh tổng thể vẫn có thể chông chênh ở tier khó nhất, và đó đúng là loại khoảng trống mà một con số tổng thể che giấu. - Phân tách outcome — không phải mọi câu trả lời sai đều thất bại theo cùng một cách. Có SQL bị sandbox từ chối, có cái trả về lỗi ClickHouse, có cái trả về kết quả rỗng, có cái chỉ đơn giản trả về tập kết quả sai. Mỗi loại là một dạng vấn đề khác nhau với một cách sửa khác nhau.
Cách đọc nó. Độ chính xác theo tier là một bảng nhỏ hoặc một dãy cột, một dòng cho mỗi tier
1–5 — hãy quét từ phải sang trái xem con số tụt ở đâu; một cấu hình gần như hoàn hảo
ở tier 1–2 rồi rơi thẳng đứng ở tier 4–5 đang nói với bạn rằng nó xử lý các phép tra cứu đơn giản
tốt nhưng chật vật với join và tổng hợp nhiều bước. Phần phân tách outcome là số
lượng theo từng hạng mục (correct, sql_policy_rejected, sql_exec_error,
empty_but_expected, wrong_result) — một đống sql_exec_error chỉ về vấn đề
dialect, một đống wrong_result chỉ về vấn đề logic, và chúng đòi
những cách sửa khác nhau.
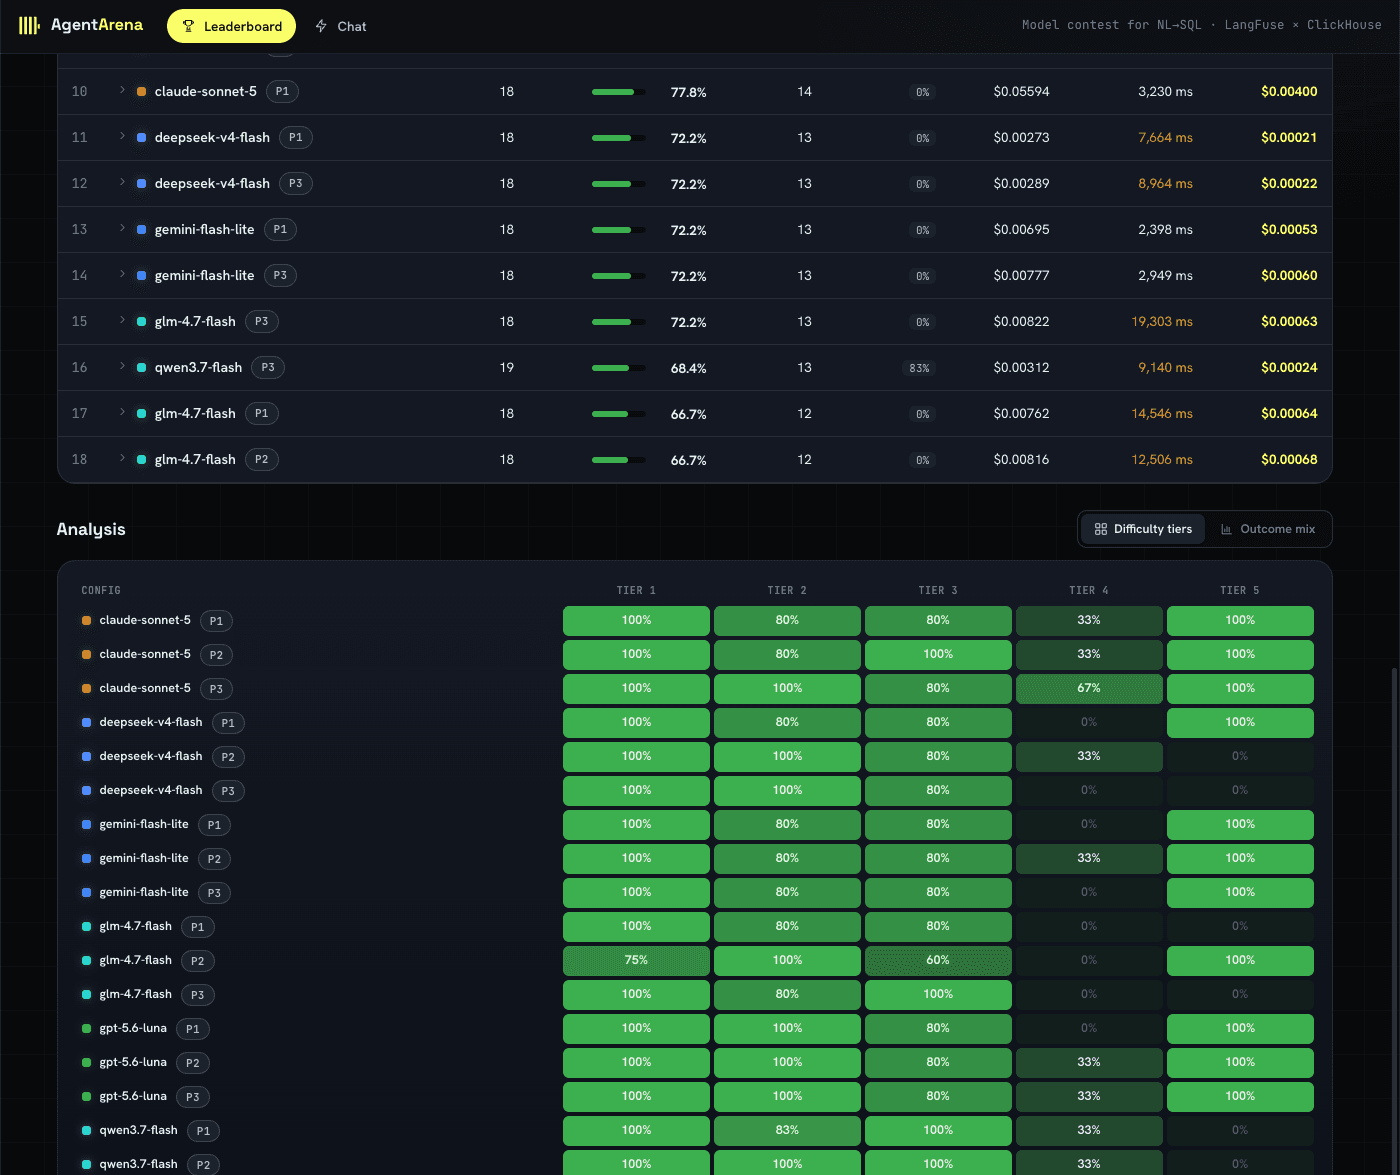
Màn hình Difficulty tiers phơi ra những khuôn mẫu bị độ chính xác tổng thể che giấu. Trong lần chạy này, phần lớn cấu hình mạnh ở tier 1–3, còn tier 4 là điểm yếu chung rõ nhất; hãy so sánh các dòng để xem cấu hình thắng có cùng mức tụt đó hay không.
Bước 2 — Đọc score thứ cấp agent-arena-llm-judge
Score correctness là nhị phân: tập kết quả có khớp hay không, có hoặc không. Score
agent-arena-llm-judge, do evaluator definition llm_judge bạn đã cấu hình ở
Module 01 phát ra, là một tín hiệu thứ cấp,
mịn hơn — một điểm chấm chất lượng SQL theo kiểu LLM-as-a-judge bên trên kết quả nhị phân
đó. Một cấu hình có thể đúng theo độ chính xác khi thực thi mà vẫn viết ra SQL mà một
người review sẽ gắn cờ (một subquery không cần thiết, một phép so sánh ngày mong manh, một join
tình cờ cho ra đúng dòng với dữ liệu này nhưng không tổng quát được). Hãy dùng
agent-arena-llm-judge để phát hiện khoảng cách giữa "đạt" và "viết tốt".
Bước 3 — Đào vào từng trace riêng lẻ
Bấm từ một dòng trên leaderboard vào kết quả theo từng câu hỏi của nó, rồi bấm vào một
câu hỏi bất kỳ để mở trace Langfuse của nó. Mỗi trace mang theo trọn đường đi của câu hỏi
đó: prompt gửi tới model, SQL được sinh ra, generation llm_call của
model (prompt, completion và số token), chi phí chính xác và độ trễ đầu-cuối
trên Experiment Item, và — nếu câu hỏi thất bại — lỗi ClickHouse
trả về. Đây cũng chính là kỹ năng
đọc trace bạn sẽ dùng lại ở Mô-đun 04 khi các
câu hỏi bắt đầu đến từ người dùng thật thay vì từ bộ dữ liệu golden.
Hãy chọn hai hoặc ba câu hỏi mà cấu hình thắng của bạn làm sai (hoặc bị điểm thấp ở
agent-arena-llm-judge) và đọc trace của chúng từ đầu đến cuối. Bạn đang tìm một khuôn mẫu: một
cách diễn đạt, một phép join, một bộ lọc ngày mà model liên tục xử lý sai.
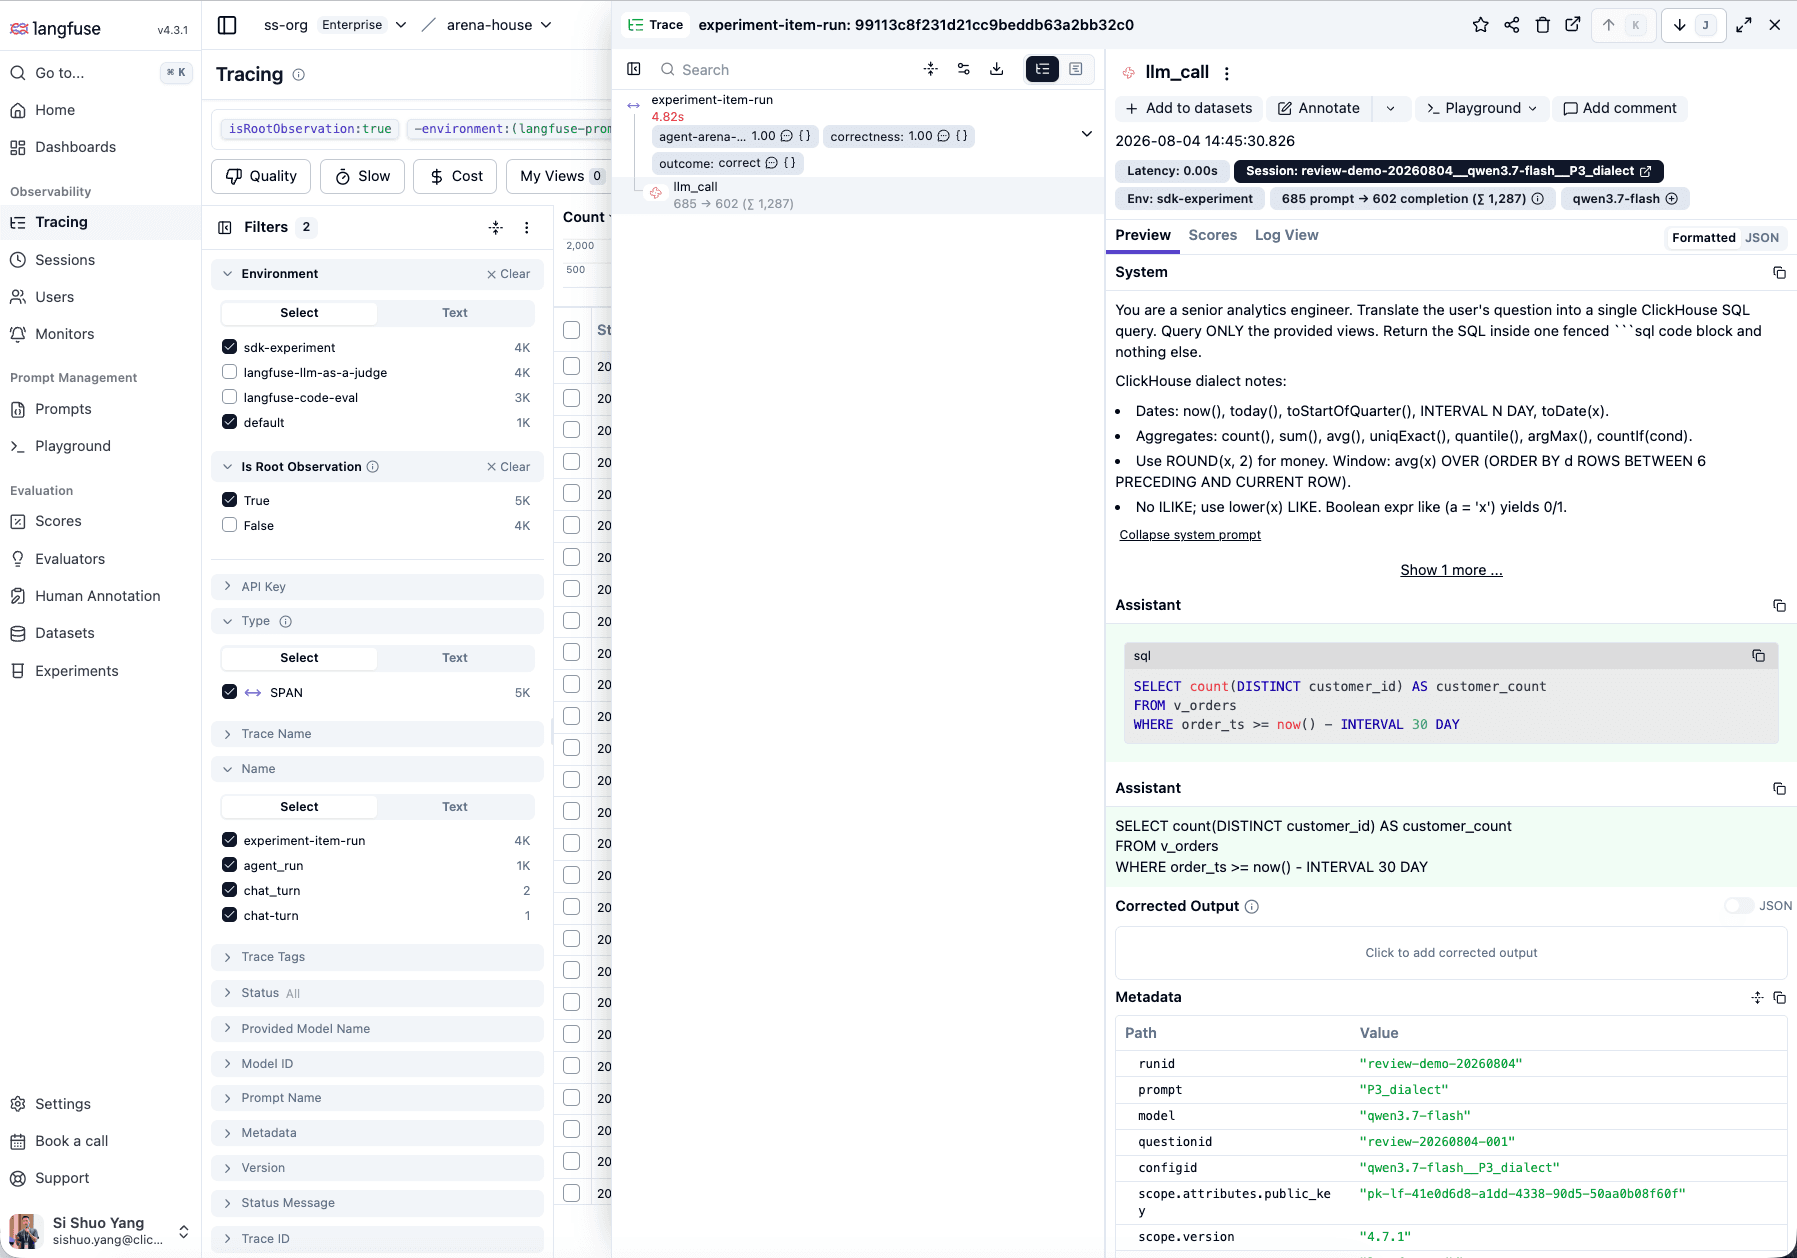
Một Experiment Item của Langfuse nối các score ở đầu trace với đúng
llm_call bên dưới nó. Bảng chi tiết cho thấy prompt, SQL được sinh ra, lượng token,
độ trễ và metadata của lần chạy — đủ để giải thích vì sao câu hỏi này đạt hay không đạt.
Cách xác nhận bạn đã xong
- Bạn nêu được độ chính xác của cấu hình thắng ở ít nhất một tier cụ thể, không chỉ con số tổng thể của nó.
- Bạn chỉ ra được ít nhất một câu hỏi mà
correctnessvàagent-arena-llm-judgebất đồng, hoặc giải thích được vì sao chúng không bất đồng trong lần chạy của bạn. - Bạn đã mở ít nhất một trace Langfuse và đi được qua prompt → SQL được sinh ra → kết quả hoặc lỗi cho câu hỏi đó.
Bài tập — làm hỏng và chẩn đoán một khuôn mẫu lỗi
Biến việc đọc trace ở Bước 3 thành một sản phẩm viết ra được mà bạn có thể chuyển sang Mô-đun 03:
-
Từ kết quả theo từng câu hỏi của cấu hình thắng, chọn 2–3 câu hỏi hoặc là
correctness = 0hoặc bị điểm thấp ởagent-arena-llm-judge. -
Với mỗi câu, mở trace Langfuse của nó và điền một dòng vào bảng này:
Câu hỏi Nó sinh ra gì Vì sao nó thất bại Hạng mục outcome (nội dung câu hỏi) (đoạn SQL nó tạo ra, viết ngắn) (nhận định của bạn: join sai, thiếu bộ lọc ngày, hiểu sai cách diễn đạt, …) ( sql_exec_error/wrong_result/ …) -
Nhìn xuyên qua 2–3 dòng của bạn để tìm một khuôn mẫu lặp lại — cùng một kiểu join, cùng một lỗi bộ lọc ngày, cùng một cách diễn đạt mà model liên tục hiểu sai. Một khuôn mẫu, không phải chỉ là danh sách các lỗi rời rạc, mới là điều bạn cần ở đây.
Giữ quan sát này làm ngữ cảnh offline, nhưng đừng xem nó là sự cố production. Mô-đun 03 tạo một trace production mới có feedback, còn Mô-đun 04 dùng phương pháp đọc trace bạn vừa thực hành để điều tra chính sự cố đó.
Tổng kết
Giờ bạn biết không chỉ rằng cấu hình của bạn đã thắng, mà là bằng cách nào — nó mạnh ở đâu, yếu ở đâu, và các lỗi của nó thực sự trông thế nào ở mức trace. Chi tiết đó chính là điều sẽ biến thành hành động tiếp theo.
Trạng thái kết thúc
Một bức tranh chất lượng chi tiết cho cấu hình chiến thắng. Tiếp tục sang 03 Phát hành và phát hiện để phát hành cấu hình đã chọn và ghi nhận mâu thuẫn thật giữa evaluator với tín hiệu người dùng.
01 Chọn model nền
Arena — chạy lưới model × prompt dưới dạng experiments của Langfuse và chọn người thắng theo chi phí trên mỗi câu trả lời đúng.
03 Phát hành và phát hiện
Phát hành tác nhân đã chọn với một điểm mù chính sách có chủ đích, rồi dùng đánh giá vận hành và phản hồi thật của người dùng để phát hiện vấn đề.