02 品質を測る
Langfuse の evaluator、データセット、traces を使い、勝者が実際にどれだけ良いのかを質問ごと・ティアごとに見ます。
出発点
Module 01 が完了していること。Arena を実行済み、Leaderboard にデータが入っており、勝った
config_id (<model>__<prompt>、たとえば claude-sonnet-5__P1_zeroshot) を持っています。
なぜ
Arena に勝ったという事実は、その構成が 集計値で 正答あたりのコストで他を上回ったことを教えてくれます。 どのように 勝ったのか、どこが最も弱いのか、その SQL が単に正しいだけなのか本当に良いのかは教えて くれません。このモデルの上に何かを築く前に(改善する、リリースする)、それを理解しておく価値があります。 候補者が面接に通ったという事実だけでなく、どの質問を完璧に答え、どの質問をぎりぎり通過したのかを 知りたいのと同じです。Langfuse にはそのために必要なものがすでにすべて揃っています。Module 01 の evaluator がすべてのアイテムを採点しており、すべてのアイテムには完全な trace があります。このモジュールは 新しいデータを作るのではなく、その細部を読むことがテーマです。
コンセプト — 内側の仕組み
Trace → observations → scores。 Langfuse はエージェントのすべての実行を同じ形で 構造化します。
- trace は 1 回のエージェント実行です。1 つの
model × prompt × questionの実行で、agent_runという名前が付き、config_idでタグ付けされます。 - observations はその trace の内側の span です。唯一存在するのは
llm_callで、モデル呼び出しの プロンプト、補完、トークン使用量を運ぶ generation observation です。Experiment Item の出力には、 leaderboard が使う正確なエンドツーエンドのコストとレイテンシが記録されます。SQL 実行ステップ 専用の observation はありません。SQL は独自の Langfuse span を持たない素の ClickHouse 呼び出しとして 実行され、生成された SQL とその結果セットは代わりに trace ルートの input/output に置かれます。 - scores は Module 01 の evaluator が事後に trace / データセットアイテムに紐づけるものです。
correctness(二値の実行精度)、agent-arena-llm-judge(LLM-as-a-judge による段階的な SQL 品質)、そしてoutcomeカテゴリです。Langfuse の evaluator 定義名はllm_judgeで、 それが出力し harness が待つ score 名は正確にagent-arena-llm-judgeです。
すべての trace は 1 つの agent_run で、子の observation は llm_call generation の 1 つだけです。加えて Langfuse の evaluator が採点後に紐づける 3 つの score があります: correctness、agent-arena-llm-judge、outcome。
ティア。 ソースコーパスには YAML の質問が 20 個ありますが、q019 と q020 は
few-shot holdout です。クリーンなプロジェクトの arena-golden に seed された 18 個の Experiment 用質問にはそれぞれ tier があり、1
(最も単純 — 単一テーブルのカウントとフィルタ)から 5(最も難しい — 複数テーブルの join、
ファネル、マージン計算)までです。ティアごとの精度が存在するのは、構成の全体の数値が、強いティア 1/2 の
性能の裏にティア 5 の崩壊を隠してしまうからです。
Outcome カテゴリ。 Langfuse の correctness Code Evaluator
(eval/langfuse_evaluators/correctness_evaluator.py) は、完了したすべての
Experiment Item を、回答がどこまで「進めた」かの順で以下のいずれかに分類します。
| Outcome | 意味 |
|---|---|
correct | 結果セットがゴールデンの結果セットと一致した。 |
model_error | SQL が生成される前に OpenRouter の呼び出し自体が失敗した(キーが不正/期限切れ、レート制限、プロバイダー障害)。 |
sql_policy_rejected | agents/sqlguard.py が、生成された SQL が ClickHouse に届く前にブロックした(単一の SELECT でない、または禁止キーワードに当たった)。 |
sql_exec_error | SQL は ClickHouse に届いたが、クエリの実行が失敗した(構文が不正、未知のカラムなど)。 |
empty_but_expected | クエリは実行され 0 行を返したが、ゴールデンの答えには行がある。 |
wrong_result | クエリは実行され行を返したが、ゴールデンの結果セットと一致しない。 |
それぞれが異なる直し方を示します。sql_policy_rejected の run には、読み取り専用に留まることについての
より良いシステムプロンプトが必要です。sql_exec_error は通常方言のギャップを意味します
(P3_dialect を参照)。empty_but_expected と wrong_result は通常、フィルタ、join、
集計のロジックの誤りを意味します。
ゴール
勝った構成のティアごとの精度と outcome の内訳を無理なく読めるようになり、素の correctness の上に
副次的な agent-arena-llm-judge のシグナルが何を加えるのかを理解し、leaderboard の行から任意の 1 質問の背後にある
まさにその Langfuse trace まで掘り下げられるようになること。
Step 1 — ティアごとの精度と outcome の内訳を読む
http://localhost:5174 → Leaderboard を開き、勝った構成の行をクリックして入ります。 精度、レイテンシ、正答あたりのコストと並んで、各構成には次が表示されます。
- ティアごとの精度 —
arena-goldenの質問は難易度ティアでグループ化されています。 全体では強く見える構成でも、最も難しいティアでは不安定なことがあり、それこそ集計値が隠す種類の ギャップです。 - Outcome の内訳 — 正答でない回答がすべて同じように失敗するわけではありません。ある SQL は サンドボックスに拒否され、ある SQL は ClickHouse のエラーを返し、ある SQL は空の結果を返し、 ある SQL は単に誤った結果セットを返します。それぞれ別種の問題で、直し方も別です。
読み方。 ティアごとの精度は、ティア 1〜5 で 1 行ずつの小さな表またはバーの集まりです。数値が
落ち込むところを右から左へ走査してください。ティア 1〜2 でほぼ完璧なのにティア 4〜5 で崖のように落ちる
構成は、単純な参照は問題なくこなすが join と多段の集計で苦戦している、と言っています。outcome の内訳は
カテゴリごとの件数 (correct、sql_policy_rejected、sql_exec_error、
empty_but_expected、wrong_result) です。sql_exec_error の山は方言の問題を、
wrong_result の山はロジックの問題を指しており、必要な直し方は
異なります。
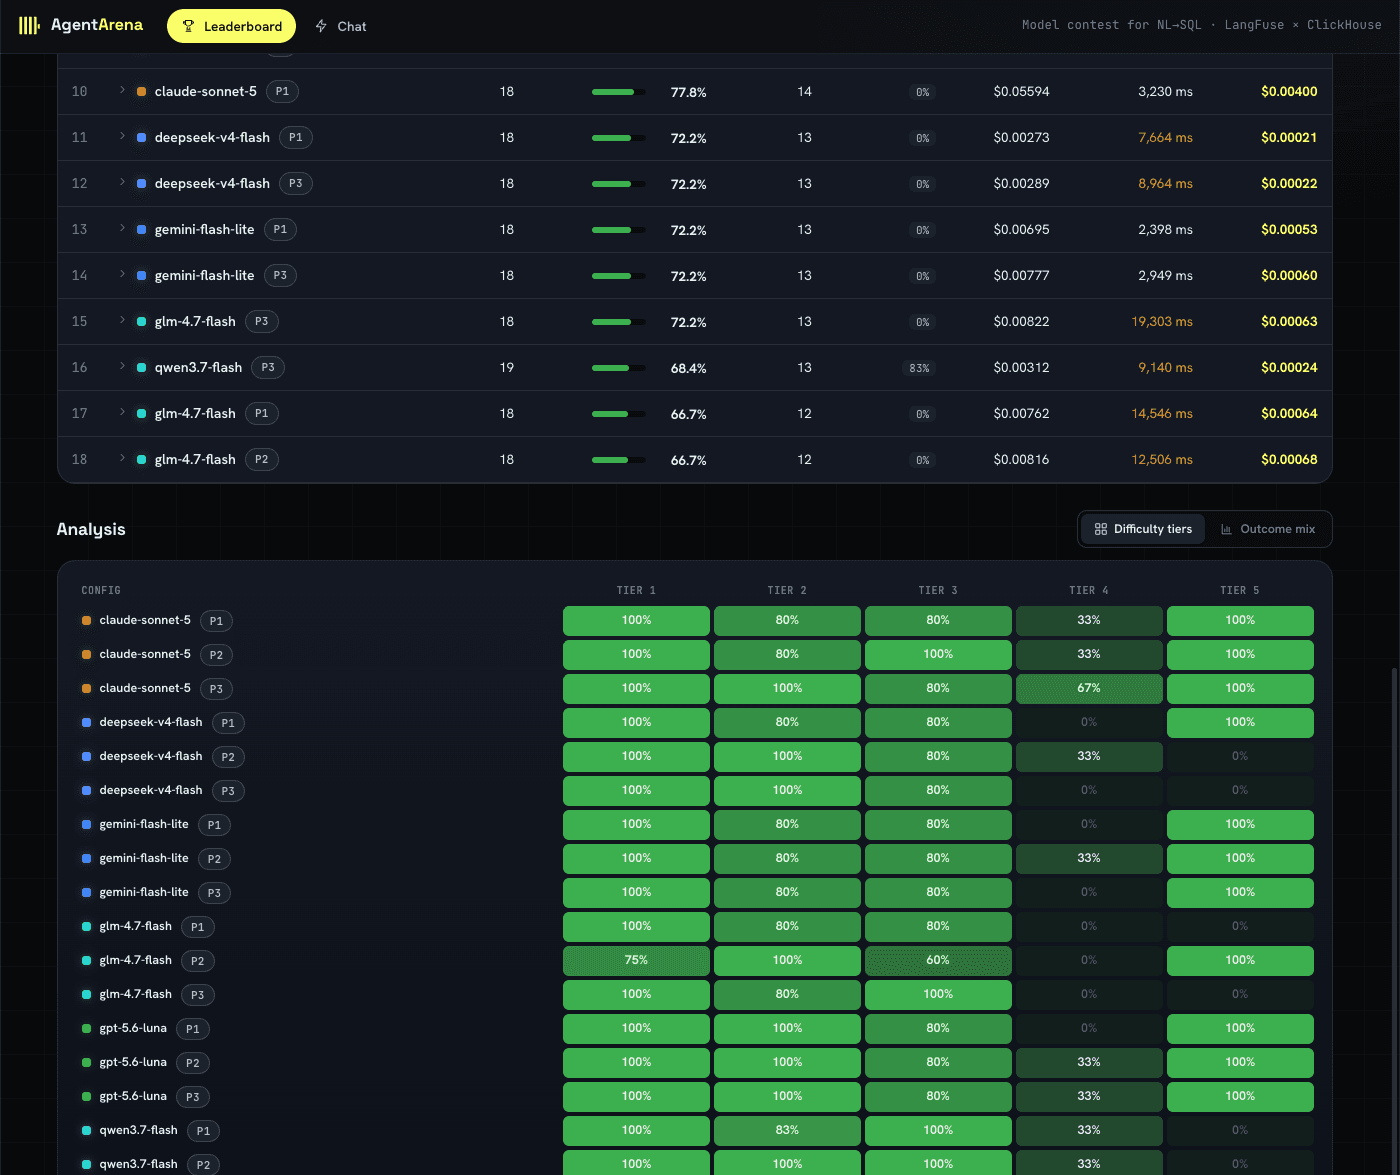
Difficulty tiers のビューは、全体精度に隠れたパターンを露わにします。この run では、ほとんどの 構成がティア 1〜3 で強く、ティア 4 が最も明白な共通の弱点です。行を比較して、勝った構成に同じ落ち込みが あるかを確認してください。
Step 2 — 副次シグナル agent-arena-llm-judge を読む
correctness の score は二値です。結果セットが一致するか、するかしないか。
Module 01 で設定した evaluator 定義 llm_judge が出力する
agent-arena-llm-judge score は副次的で、
より細かい粒度のシグナルです。その二値の結果の上に乗る、LLM-as-a-judge による SQL 品質の評価です。
ある構成は実行精度の上では 正しい のに、レビュアーなら指摘するような SQL を書いていることがあります
(不要なサブクエリ、壊れやすい日付比較、このデータでは偶然正しい行を返すが一般化しない join)。
「通る」と「よく書けている」のギャップを見つけるために agent-arena-llm-judge を使ってください。
Step 3 — 個々の trace を掘り下げる
leaderboard の行から質問ごとの結果へ進み、任意の 1 質問をクリックしてその Langfuse trace を開きます。
各 trace はその質問に関する完全な経路を運びます。モデルに送られたプロンプト、生成された SQL、
モデルの llm_call generation(プロンプト、補完、トークン数)、Experiment Item 上の正確なコストと
エンドツーエンドのレイテンシ、そして — 質問が失敗した場合は — 返ってきた ClickHouse のエラーです。
これは、ゴールデンデータセットではなく実際のユーザーから質問が届き始めたあとに
Module 04 の人による調査で再び使う、
同じ trace 読解のスキルです。
勝った構成が間違えた(あるいは agent-arena-llm-judge で低い点だった)質問を 2〜3 個選び、その trace を
端から端まで読んでください。探しているのはパターンです。モデルが一貫して扱いを誤る言い回し、join、
日付フィルタです。
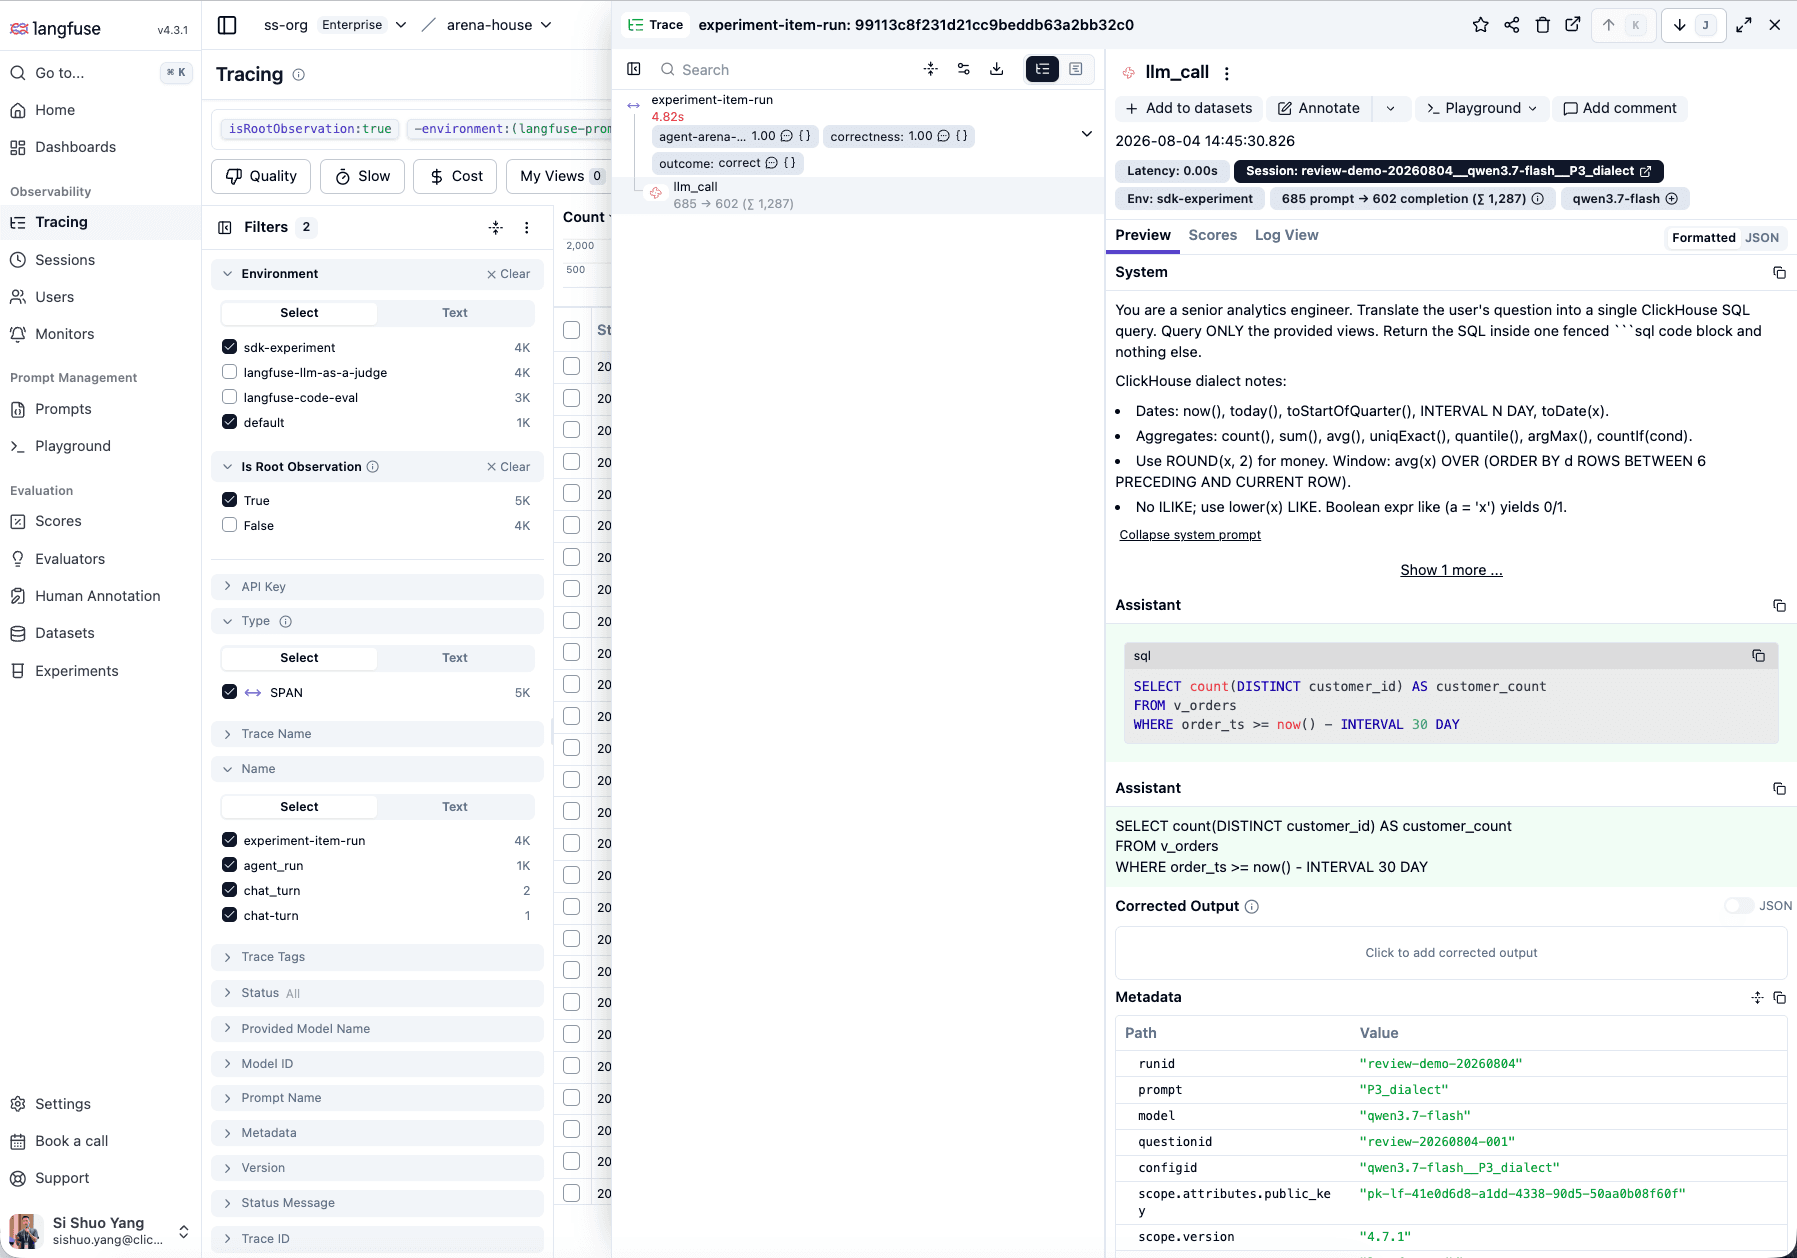
Langfuse の Experiment Item は、trace の上部にある score を、その下のまさにその
llm_call と結びつけます。詳細パネルには、この質問が通ったのか落ちたのかを説明するために必要な
プロンプト、生成された SQL、トークン使用量、レイテンシ、run のメタデータが表示されます。
完了したかどうかの確認
- 勝った構成について、全体の数値だけでなく、少なくとも 1 つの特定のティアの精度を言える。
correctnessとagent-arena-llm-judgeが食い違う質問を少なくとも 1 つ指し示せる、あるいは自分の run では なぜ食い違わないのかを説明できる。- Langfuse の trace を少なくとも 1 つ開き、その質問についてプロンプト → 生成された SQL → 結果またはエラーをたどれる。
演習 — 失敗パターンを壊して診断する
Step 3 の trace 読解を、Module 03 に引き継げる 書かれた成果物にしましょう。
-
勝った構成の質問ごとの結果から、
correctness = 0かagent-arena-llm-judgeで低い点だった質問を 2〜3 個選びます。 -
それぞれについて Langfuse の trace を開き、この表の 1 行を埋めます。
質問 何を生成したか なぜ失敗したか Outcome カテゴリ (質問の文) (生成した SQL を短く) (あなたの読み: 誤った join、日付フィルタの欠落、言い回しの誤読、…) ( sql_exec_error/wrong_result/ …) -
2〜3 行を横断して繰り返されるパターンを探してください。同じ種類の join、同じ 日付フィルタの誤り、モデルが一貫して誤読する同じ言い回しです。無関係なバグの一覧ではなく 1 つの パターン が、ここで欲しいものです。
見つけたパターンが Module 03 の種になります。観測された失敗を、その修正を固定する新しい ゴールデンデータに変えます。
まとめ
構成が勝ったという事実だけでなく、どのように 勝ったのかが分かりました。どこが強く、どこが 弱く、その失敗が trace のレベルで実際にどう見えるかです。その細部こそ、次に行動へと変わるものです。
到達状態
勝った構成についての詳細な品質像。見つけたものを新しいゴールデンデータに変えるため、 03 リリースして検知する に進んでください。