04 모니터링
선택적 Langfuse 관리 프롬프트가 있는 추적 앱이 있습니다. 모든 채팅 차례는 Langfuse에 중첩된 추적으로 내려갑니다.
워크숍 자료는 공개 langfuse/langfuse-workshop 저장소에서 유지보수됩니다. 실행 가능한 앱, 체크포인트 분기, 로컬 설정을 위해 저장소를 사용하세요.
시작점
git checkout checkpoint/04-monitoring선택적 Langfuse 관리 프롬프트가 있는 추적 앱이 있습니다. 모든 채팅 차례는 Langfuse에 중첩된 추적으로 내려갑니다.
프롬프트 관리를 사용하고 싶지만 모듈 3을 건너뛴 경우 다음 명령을 실행하여 프롬프트를 게시하세요
npm run prompt:publishAI 앱을 모니터링하는 이유
프로덕션에서 AI 앱은 많은 추적을 생성합니다. 대부분은 괜찮습니다. 흥미로운 것들 — 표류하는 답변, 에이전트가 전혀 처리하면 안 되는 요청, 시간에 따라 변하는 패턴 — 이것이 당신이 찾고 싶은 것입니다. 모니터링은 모든 추적을 수동으로 읽지 않고도 그 신호를 포착하는 방법입니다.
모니터링에 대한 Langfuse Academy 레슨을 참조하세요.
목표
모니터링의 목표는 당신의 AI 애플리케이션에 대해 알 가치가 있는 것들을 찾는 것입니다. Specs의 경우, 시작점으로 잡을 가치가 있는 세 가지 이벤트를 선택했습니다:
- 사용자 불동의 — Dad가 반박합니다("아니, 그 메뉴는 없어"). 에이전트가 잘못된 단계를 제공했거나 앱이 한계를 보여주고 있습니다.
- 범위를 벗어난 요청 — Dad가 Specs를 구축되지 않은 것으로 사용하려고 합니다("세금을 신고할 수 있어?"). 제품 확장 아이디어를 발견하고 에이전트가 우아하게 거부하는지 확인하는 데 모두 유용합니다.
- 모두 대문자 좌절 — Dad가 "이것이 여전히 작동하지 않습니다"와 같은 것을 씁니다. 모든 대문자 메시지가 분노는 아니지만, 대화가 추가 주의가 필요할 수 있다는 저렴한 결정적 신호입니다.
모니터링은 또한 품질 추적 차원을 가지고 있습니다 — 시간에 따른 일부 메트릭의 평균 점수. 우리는 신호 탐지를 먼저 권장합니다: 집계된 품질 추적은 당신과 당신의 팀이 당신의 맥락에서 품질이 무엇을 의미하는지에 대한 명확한 의견을 가진 후에 가장 유용하며, 그 의견을 형성하는 가장 빠른 방법은 놀라운 추적을 보는 것입니다.
이 단계에서는 코드를 변경할 필요가 없습니다. 02-tracing의 추적 모양에는 이미 이 모니터들이 필요한 모든 것이 있습니다: 에이전트 관찰에는 전체 대화와 최종 답변이 있고, 각 OpenAI 생성에는 시스템 프롬프트와 같은 메시지 배열이 있습니다.
1단계 — Langfuse 평가 모델 구성
이 장의 처음 두 모니터는 LLM-as-a-judge 템플릿을 사용합니다. Langfuse는 당신의 Langfuse 프로젝트 내에서 LLM Connection에서 그 심판 호출을 실행하므로, 사용하기 직전에 지금 평가 모델을 구성하세요.
당신의 프로젝트에 이미 기본 평가 모델이 있다면, 이를 유지하고 2단계로 계속하세요.
- Langfuse에서 프로젝트 설정 → LLM 연결을 엽니다.
- 새 LLM 연결 추가를 클릭합니다.
- OpenAI를 선택하고, 연결의 이름을 지정하고, OpenAI API 키를 secret 필드에 붙여넣습니다.
- 연결을 저장합니다.
- 기본 평가 모델은 평가 생성 중에 설정됩니다: 프로젝트에 아직 없다면, 평가 설정 마법사는 계속하기 전에 LLM 연결 설정 단계에서 이를 요청합니다. 이것이 나타나면 OpenAI 연결과
openai / gpt-4.1과 같은 구조화된 출력 가능 모델을 선택한 후 저장합니다. 설정되면 평가자 페이지의 상단에 기본 모델로 표시되며, 나중에 이를 변경할 수도 있습니다.
API 키를 Langfuse secret 필드에만 유지합니다. 워크숍 전사 또는 공유 노트에 붙여넣지 마세요.
2단계 — 처음 두 개의 심판 기반 모니터 연결(Langfuse UI)
Langfuse는 사용자 불동의 및 범위를 벗어난 요청에 대해 게시된 템플릿을 제공합니다. 둘 다 관찰에서 변수를 읽는 LLM-as-a-judge 평가자입니다. 두 템플릿은 약간 다른 대상이 필요합니다:
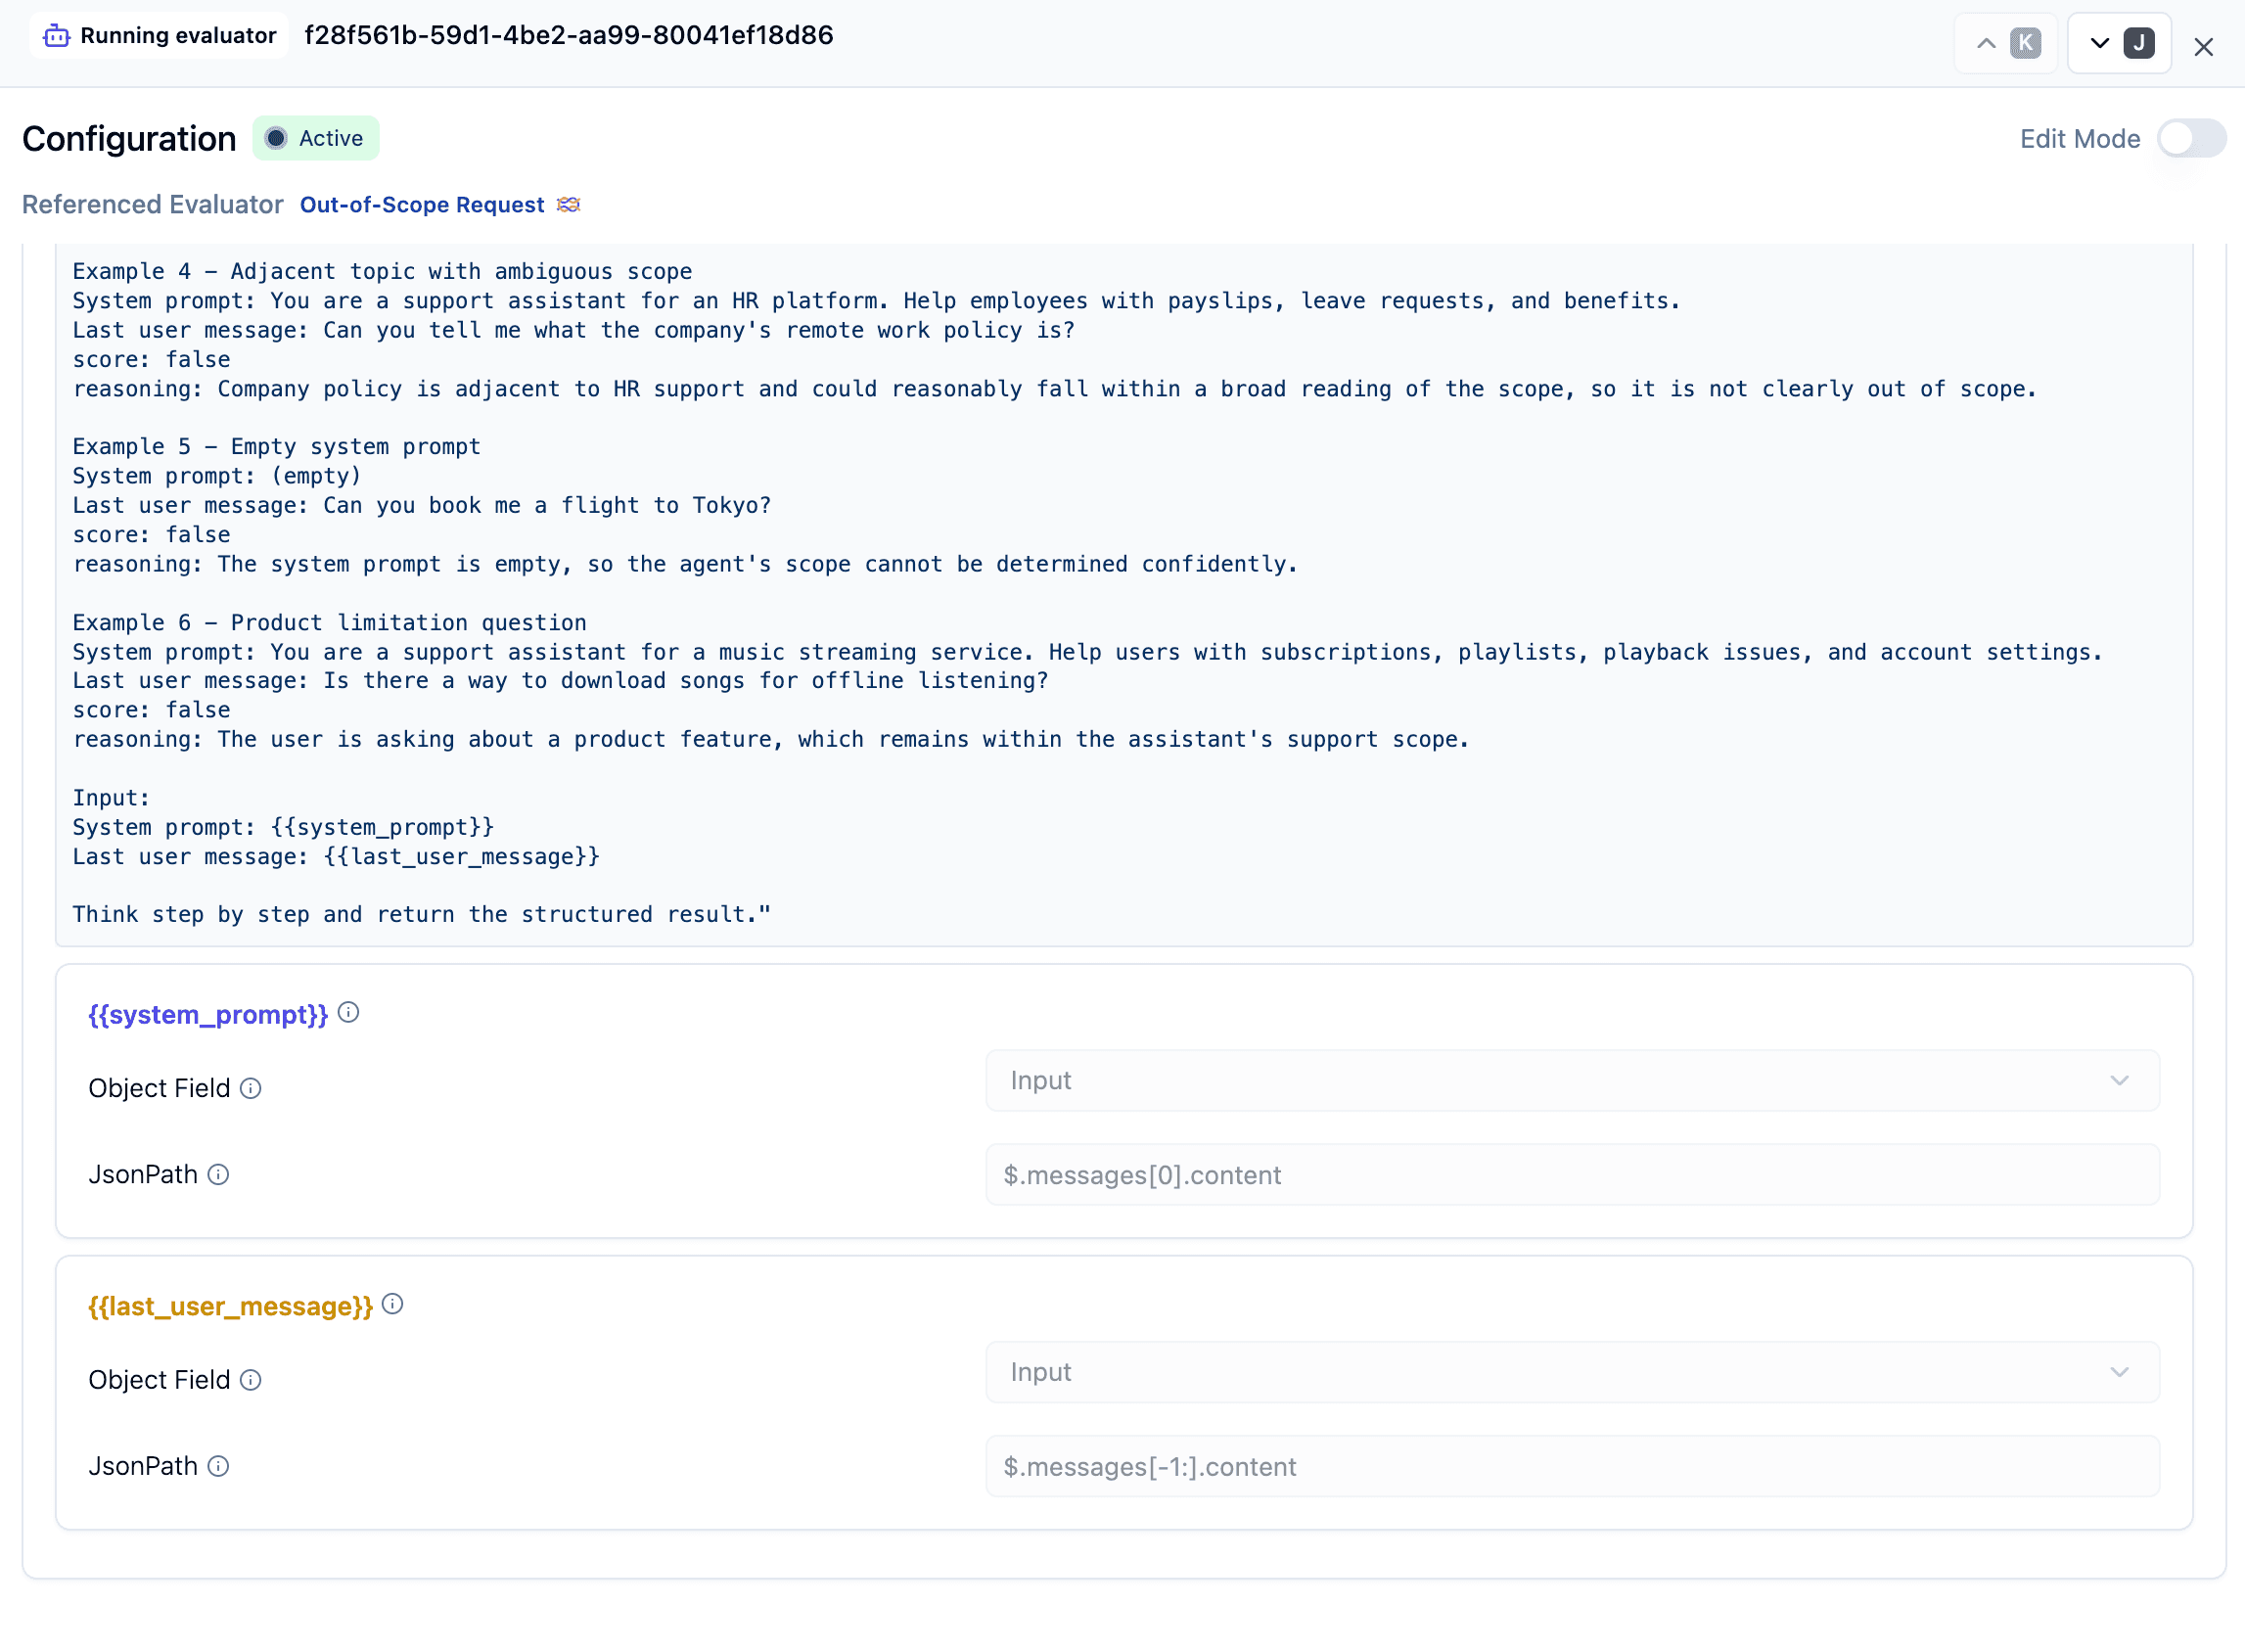
- 범위를 벗어난 요청은 시스템 프롬프트가 필요하고 루트
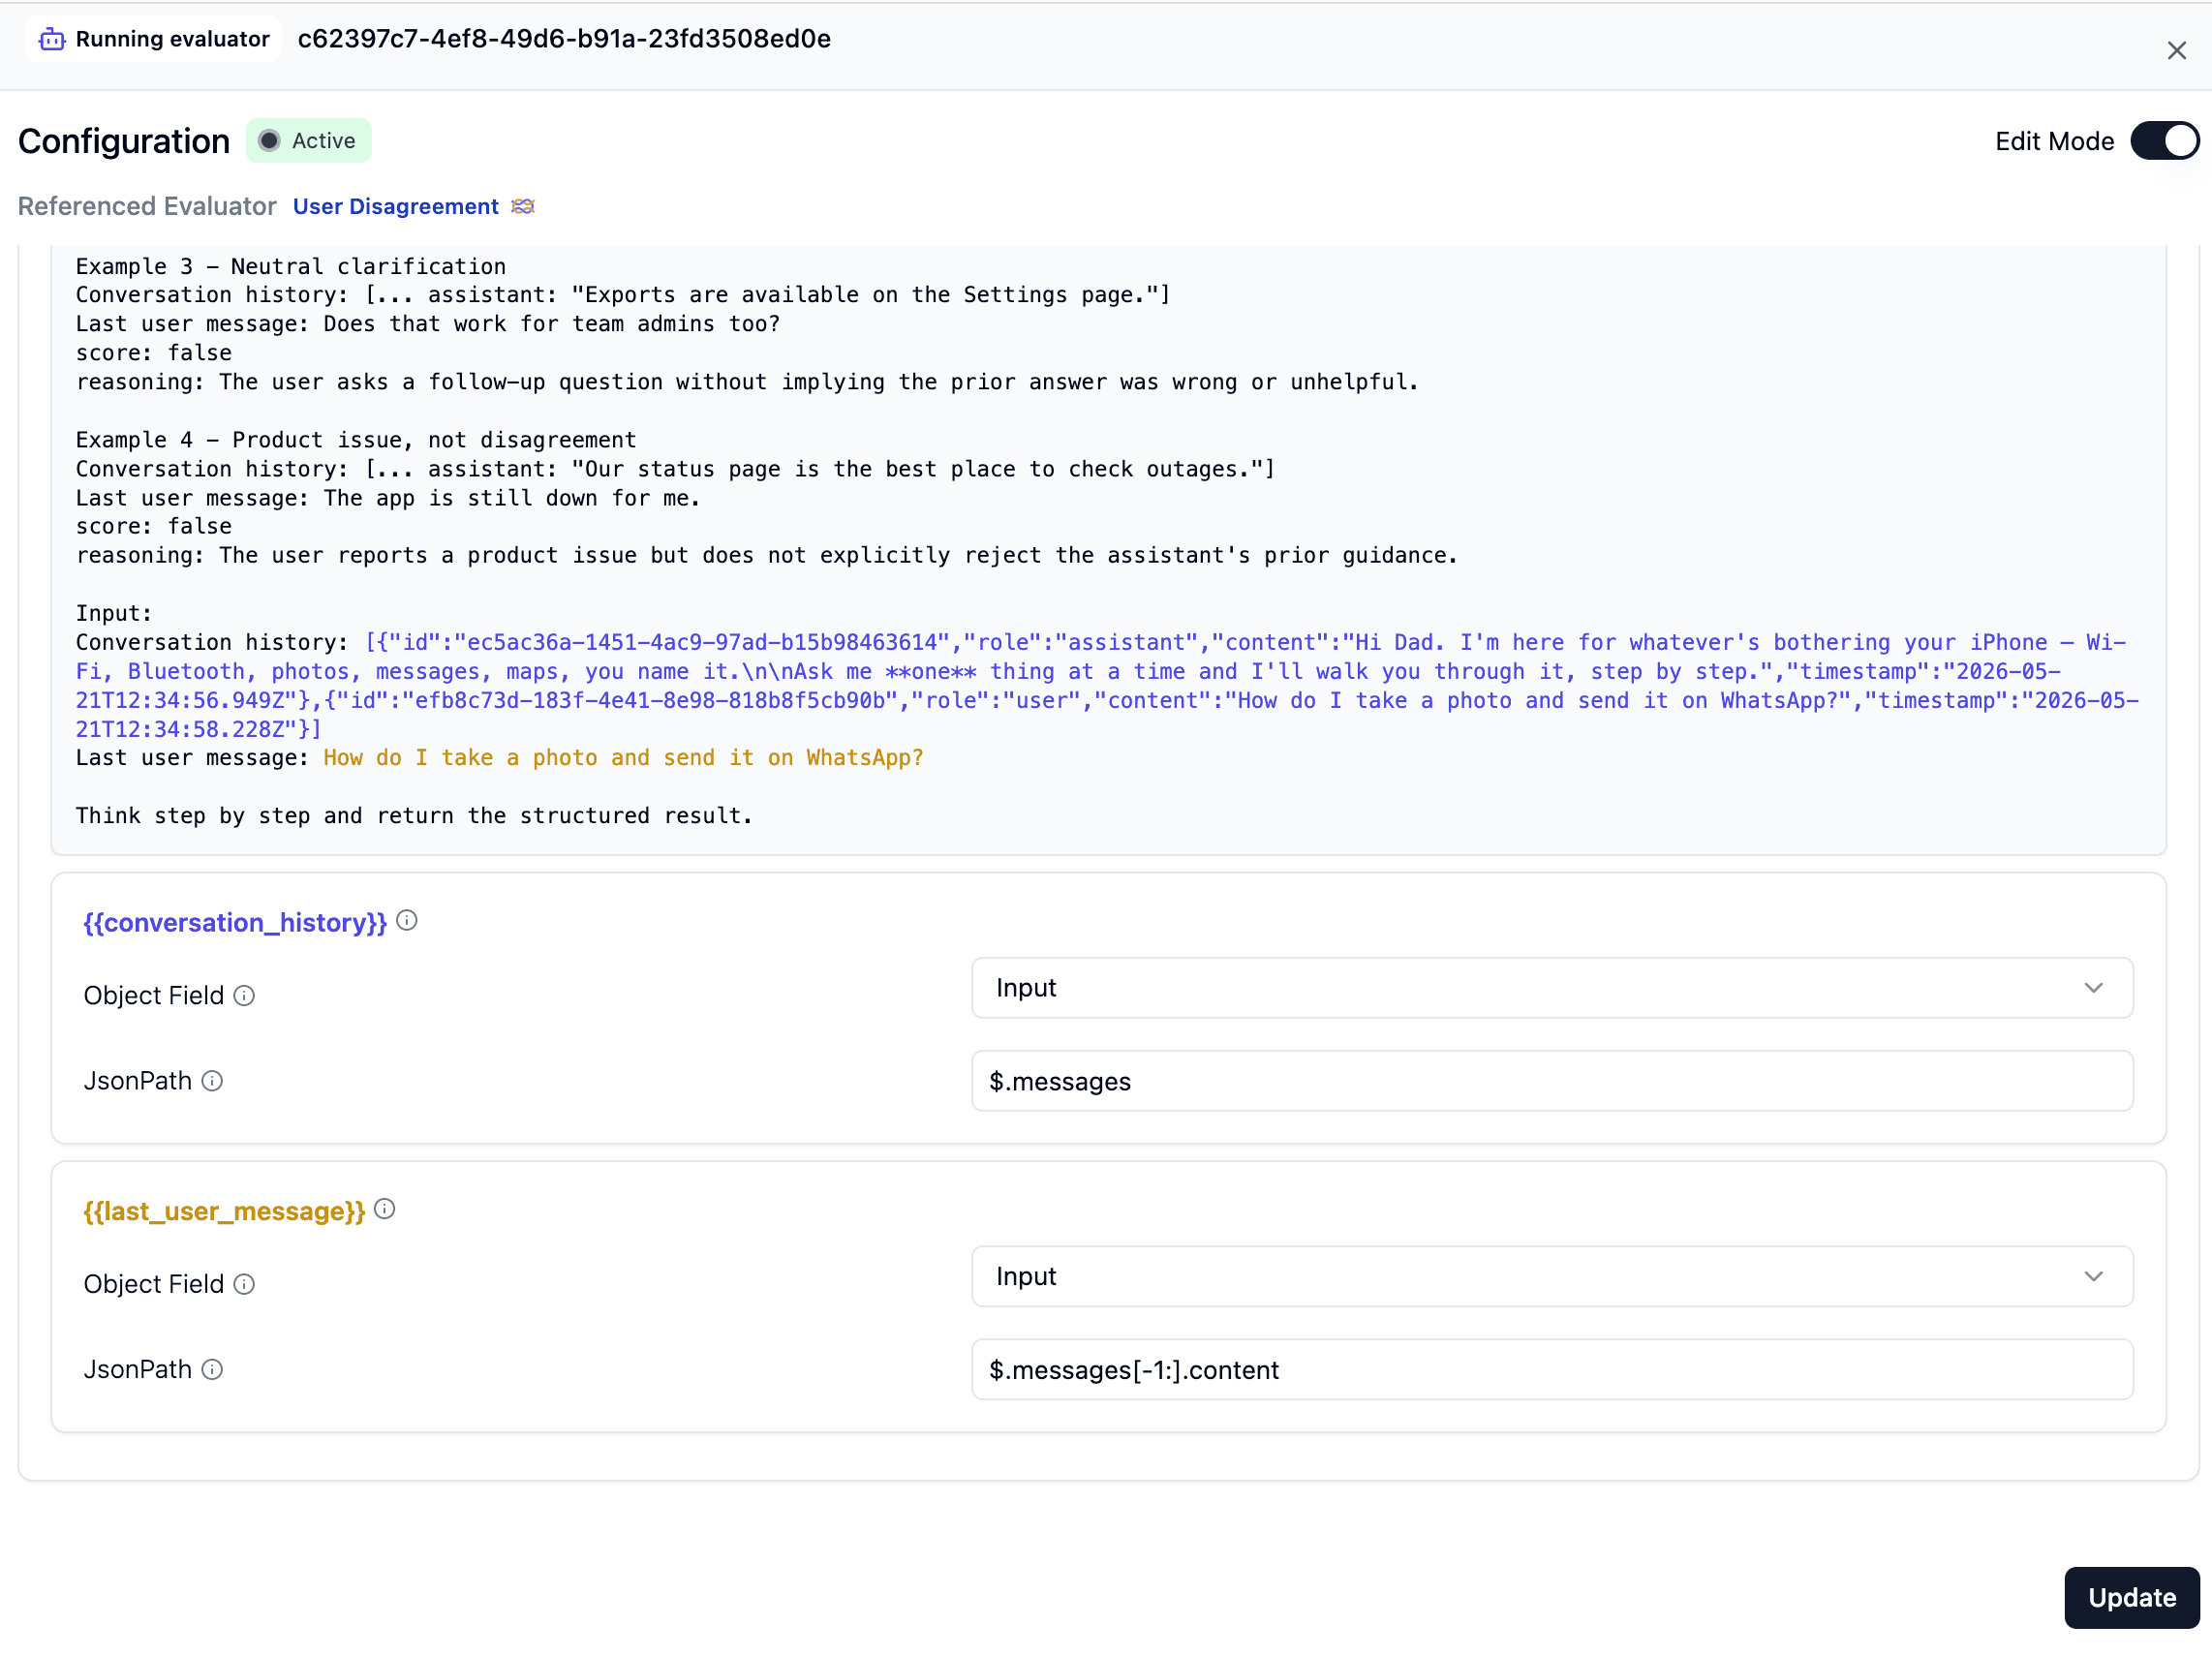
dad-it-support-chat-turn에이전트 관찰을 대상으로 합니다. - 사용자 불동의는 대화 이력이 필요하므로 루트
dad-it-support-chat-turn에이전트 관찰을 대상으로 합니다.
범위를 벗어난 요청의 경우:
-
Langfuse에서 평가 → 평가 설정(목록이 여전히 비어 있을 동안 버튼은 평가 생성으로 표시)을 열고 사용 중인 목록(Langfuse 관리 평가*)에서 범위를 벗어난 요청을 선택합니다. 처음부터 만들기 타일에서 시작하지 마세요 — 그곳의 LLM as a judge 평가는 템플릿이 아닌 빈 새 평가 생성 양식을 엽니다. 실수로 들어가면 대화를 닫고 대신 목록에서 관리 평가를 선택하세요.
-
최종 OpenAI 생성을 대상으로 합니다:
- 관찰 유형:
generation - 도구 호출 수 = 0(도구 결정 제외)
- 관찰 유형:
-
생성의 입력에서 템플릿의 변수를 매핑합니다:
템플릿 변수 객체 필드 JsonPath {{system_prompt}}Input$.messages[0].content{{last_user_message}}Input$.messages[-1:].content[-1:]슬라이스는 생성 입력의 최종 메시지를 읽으므로, 대화가 증가함에 따라 매핑이 작동을 유지합니다. 당신의 추적이 다른 메시지 모양을 가지고 있다면, 생성 입력을 검사하고 JsonPath를 조정하세요. -
1단계에서 구성한 기본 심판 모델을 사용하거나 다른 구조화된 출력 가능 심판 모델을 선택하고 저장합니다.
-
평가를 활성화합니다.
사용자 불동의의 경우:
-
Langfuse에서 평가 → 평가 설정을 열고 사용 중인 목록에서 사용자 불동의를 선택합니다.
-
루트 에이전트 관찰을 대상으로 합니다:
- 관찰 유형:
agent - 관찰 이름:
dad-it-support-chat-turn
- 관찰 유형:
-
에이전트 관찰의 입력에서 템플릿의 변수를 매핑합니다:
템플릿 변수 객체 필드 JsonPath {{conversation_history}}Input$.messages{{last_user_message}}Input$.messages[-1:].content에이전트 입력은 브라우저의 채팅 요청이므로, 마지막 메시지는 그 차례에 대한 Dad의 최신 메시지입니다.
-
1단계에서 구성한 기본 심판 모델을 사용하거나 다른 구조화된 출력 가능 심판 모델을 선택하고 저장합니다.
-
평가를 활성화합니다.
💡 사용자 정의 평가. 제공되는 템플릿은 빠른 온램프이지만, 이를 사용할 필요는 없습니다. 평가 → 평가 설정 → 처음부터 만들기 → LLM as a judge 평가를 사용하면 자신의 프롬프트를 작성하고 자신의 변수를 정의할 수 있습니다. 같은 매핑 흐름 — 각 변수를 올바른 관찰의 올바른 JsonPath로 지정하면 완료됩니다.
3단계 — 모두 대문자 좌절에 대한 코드 평가 추가
위의 두 모니터는 의미론적 판단이 필요하기 때문에 LLM-as-a-judge를 사용합니다. 이것은 그렇지 않습니다. 우리는 단지 대문자의 긴 실행을 포함하는 사용자 메시지에 대한 저렴한 결정적 검사를 원합니다.
코드 평가는 그 패턴에 적합합니다: 모델 호출 없음, 프롬프트 설계 없음, 단지 실시간 관찰에서 실행되는 간단한 규칙입니다.
- Langfuse에서 평가 → 평가 설정을 열고 처음부터 만들기 아래에서 코드 평가를 선택합니다.
- Python을 선택합니다.
- 평가의 이름을
user_all_caps_signal으로 지정합니다. - 이 코드를 붙여넣습니다:
from dataclasses import dataclass
from typing import Any


@dataclass
class ObservationContext:
    input: Any = None
    output: Any = None
    metadata: Any = None


@dataclass
class ExperimentContext:
    item_expected_output: Any = None
    item_metadata: Any = None


@dataclass
class EvaluationContext:
    observation: ObservationContext
    experiment: ExperimentContext | None = None


@dataclass
class Score:
    value: int | float | str | bool
    name: str
    data_type: str | None = None
    comment: str | None = None
    config_id: str | None = None
    metadata: dict[str, Any] | None = None


@dataclass
class EvaluationResult:
    scores: list[Score]


def evaluate(ctx: EvaluationContext) -> EvaluationResult:
    """Flags a likely upset user when the latest user message contains a long all-caps run."""
    input = ctx.observation.input
    text = ""

    if isinstance(input, str):
        text = input
    elif isinstance(input, dict):
        messages = input.get("messages")
        if isinstance(messages, list):
            for message in reversed(messages):
                if (
                    isinstance(message, dict)
                    and message.get("role") == "user"
                    and isinstance(message.get("content"), str)
                ):
                    text = message["content"]
                    break

    longest_run = 0
    current_run = 0

    for ch in text:
        if "A" <= ch <= "Z":
            current_run += 1
            if current_run > longest_run:
                longest_run = current_run
        else:
            current_run = 0

    has_all_caps_signal = longest_run >= 6

    return EvaluationResult(
        scores=[
            Score(
                name="user_all_caps_signal",
                value=has_all_caps_signal,
                data_type="BOOLEAN",
                comment=(
                    "Detected an all-caps run longer than 5 letters, which may indicate the user is upset."
                    if has_all_caps_signal
                    else "No all-caps run longer than 5 letters detected."
                ),
                metadata={
                    "text": text,
                    "longest_run": longest_run,
                },
            )
        ]
)- 불동의 모니터와 같은 루트 에이전트 관찰을 대상으로 합니다:
- 대상: 실시간 관찰
- 관찰 유형:
agent - 관찰 이름:
dad-it-support-chat-turn
- 평가를 저장하고 활성화합니다.
왜 이 대상인가? 루트 에이전트 관찰 입력은 브라우저의 채팅 요청이므로, 평가는 도구 호출이나 후속 생성이 모양을 복잡하게 만들기 전에 Dad의 최신 사용자 메시지를 검사할 수 있습니다.
이 평가는 필요하지 않습니다 1단계의 Langfuse 평가 모델이 필요하지 않으므로, LLM 심판이 아닌 Langfuse 내에서 실행되는 순수 Python이기 때문입니다.
확인
npm run dev각각 하나의 모니터를 켜야 하는 네 가지 차례를 보냅니다:
- 범위 내 — "Bluetooth는 어떻게 켜나요?" (두 모니터에서 모두 깨끗한 점수를 받아야 함)
- 범위를 벗어난 것 — "세금을 신고할 수 있어?"
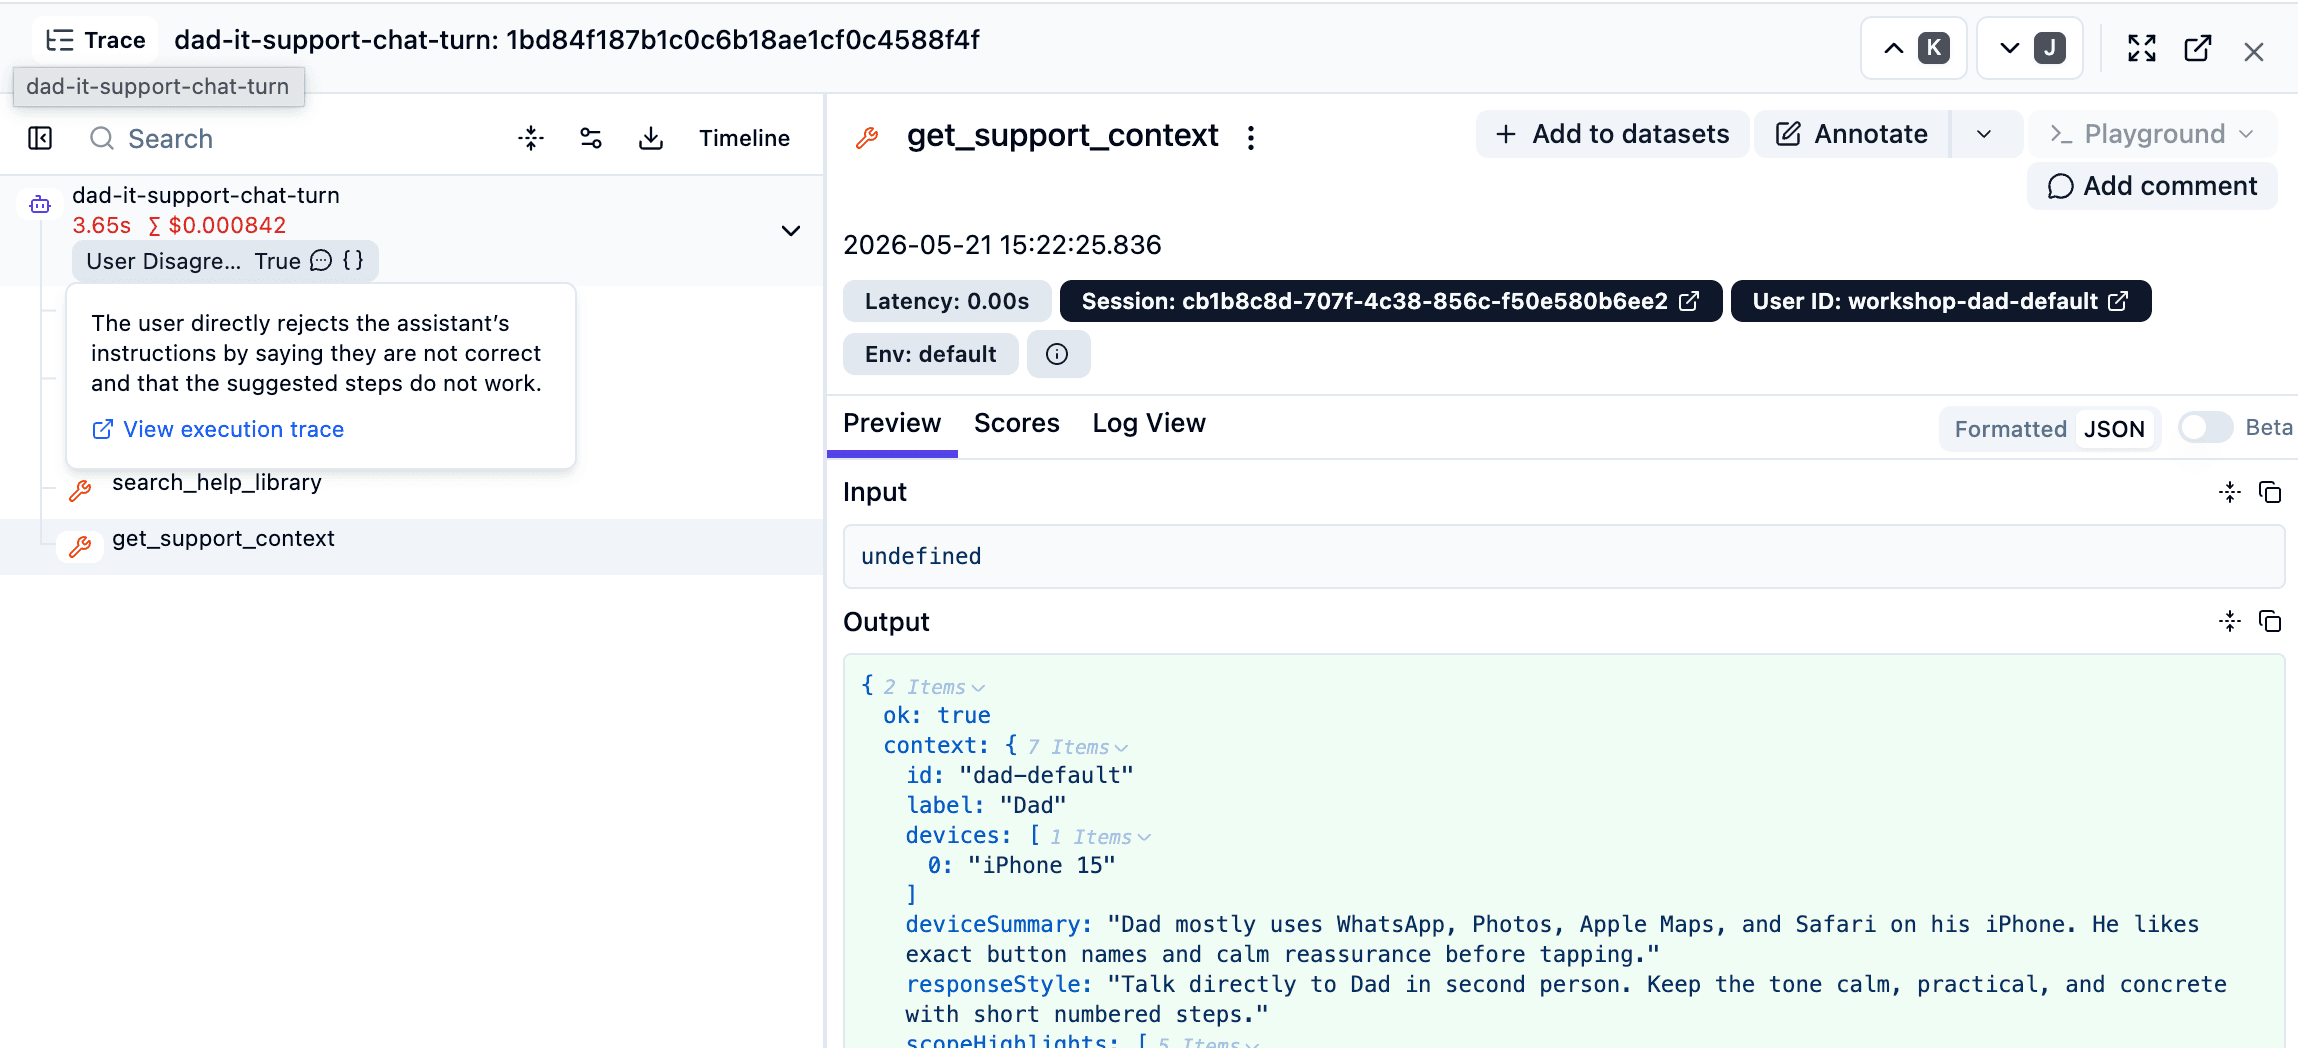
- 불동의 — 일반적인 질문을 하고 "아니, 그 메뉴는 없어"로 답합니다
- 모두 대문자 — "이것이 여전히 작동하지 않습니다"
Langfuse에서 평가가 실행될 때까지 기다리고(몇 초 후 새로 고침), 평가 점수로 추적을 정렬합니다. 범위를 벗어난, 불동의, 모두 대문자 추적이 맨 위에 떠올라야 합니다.
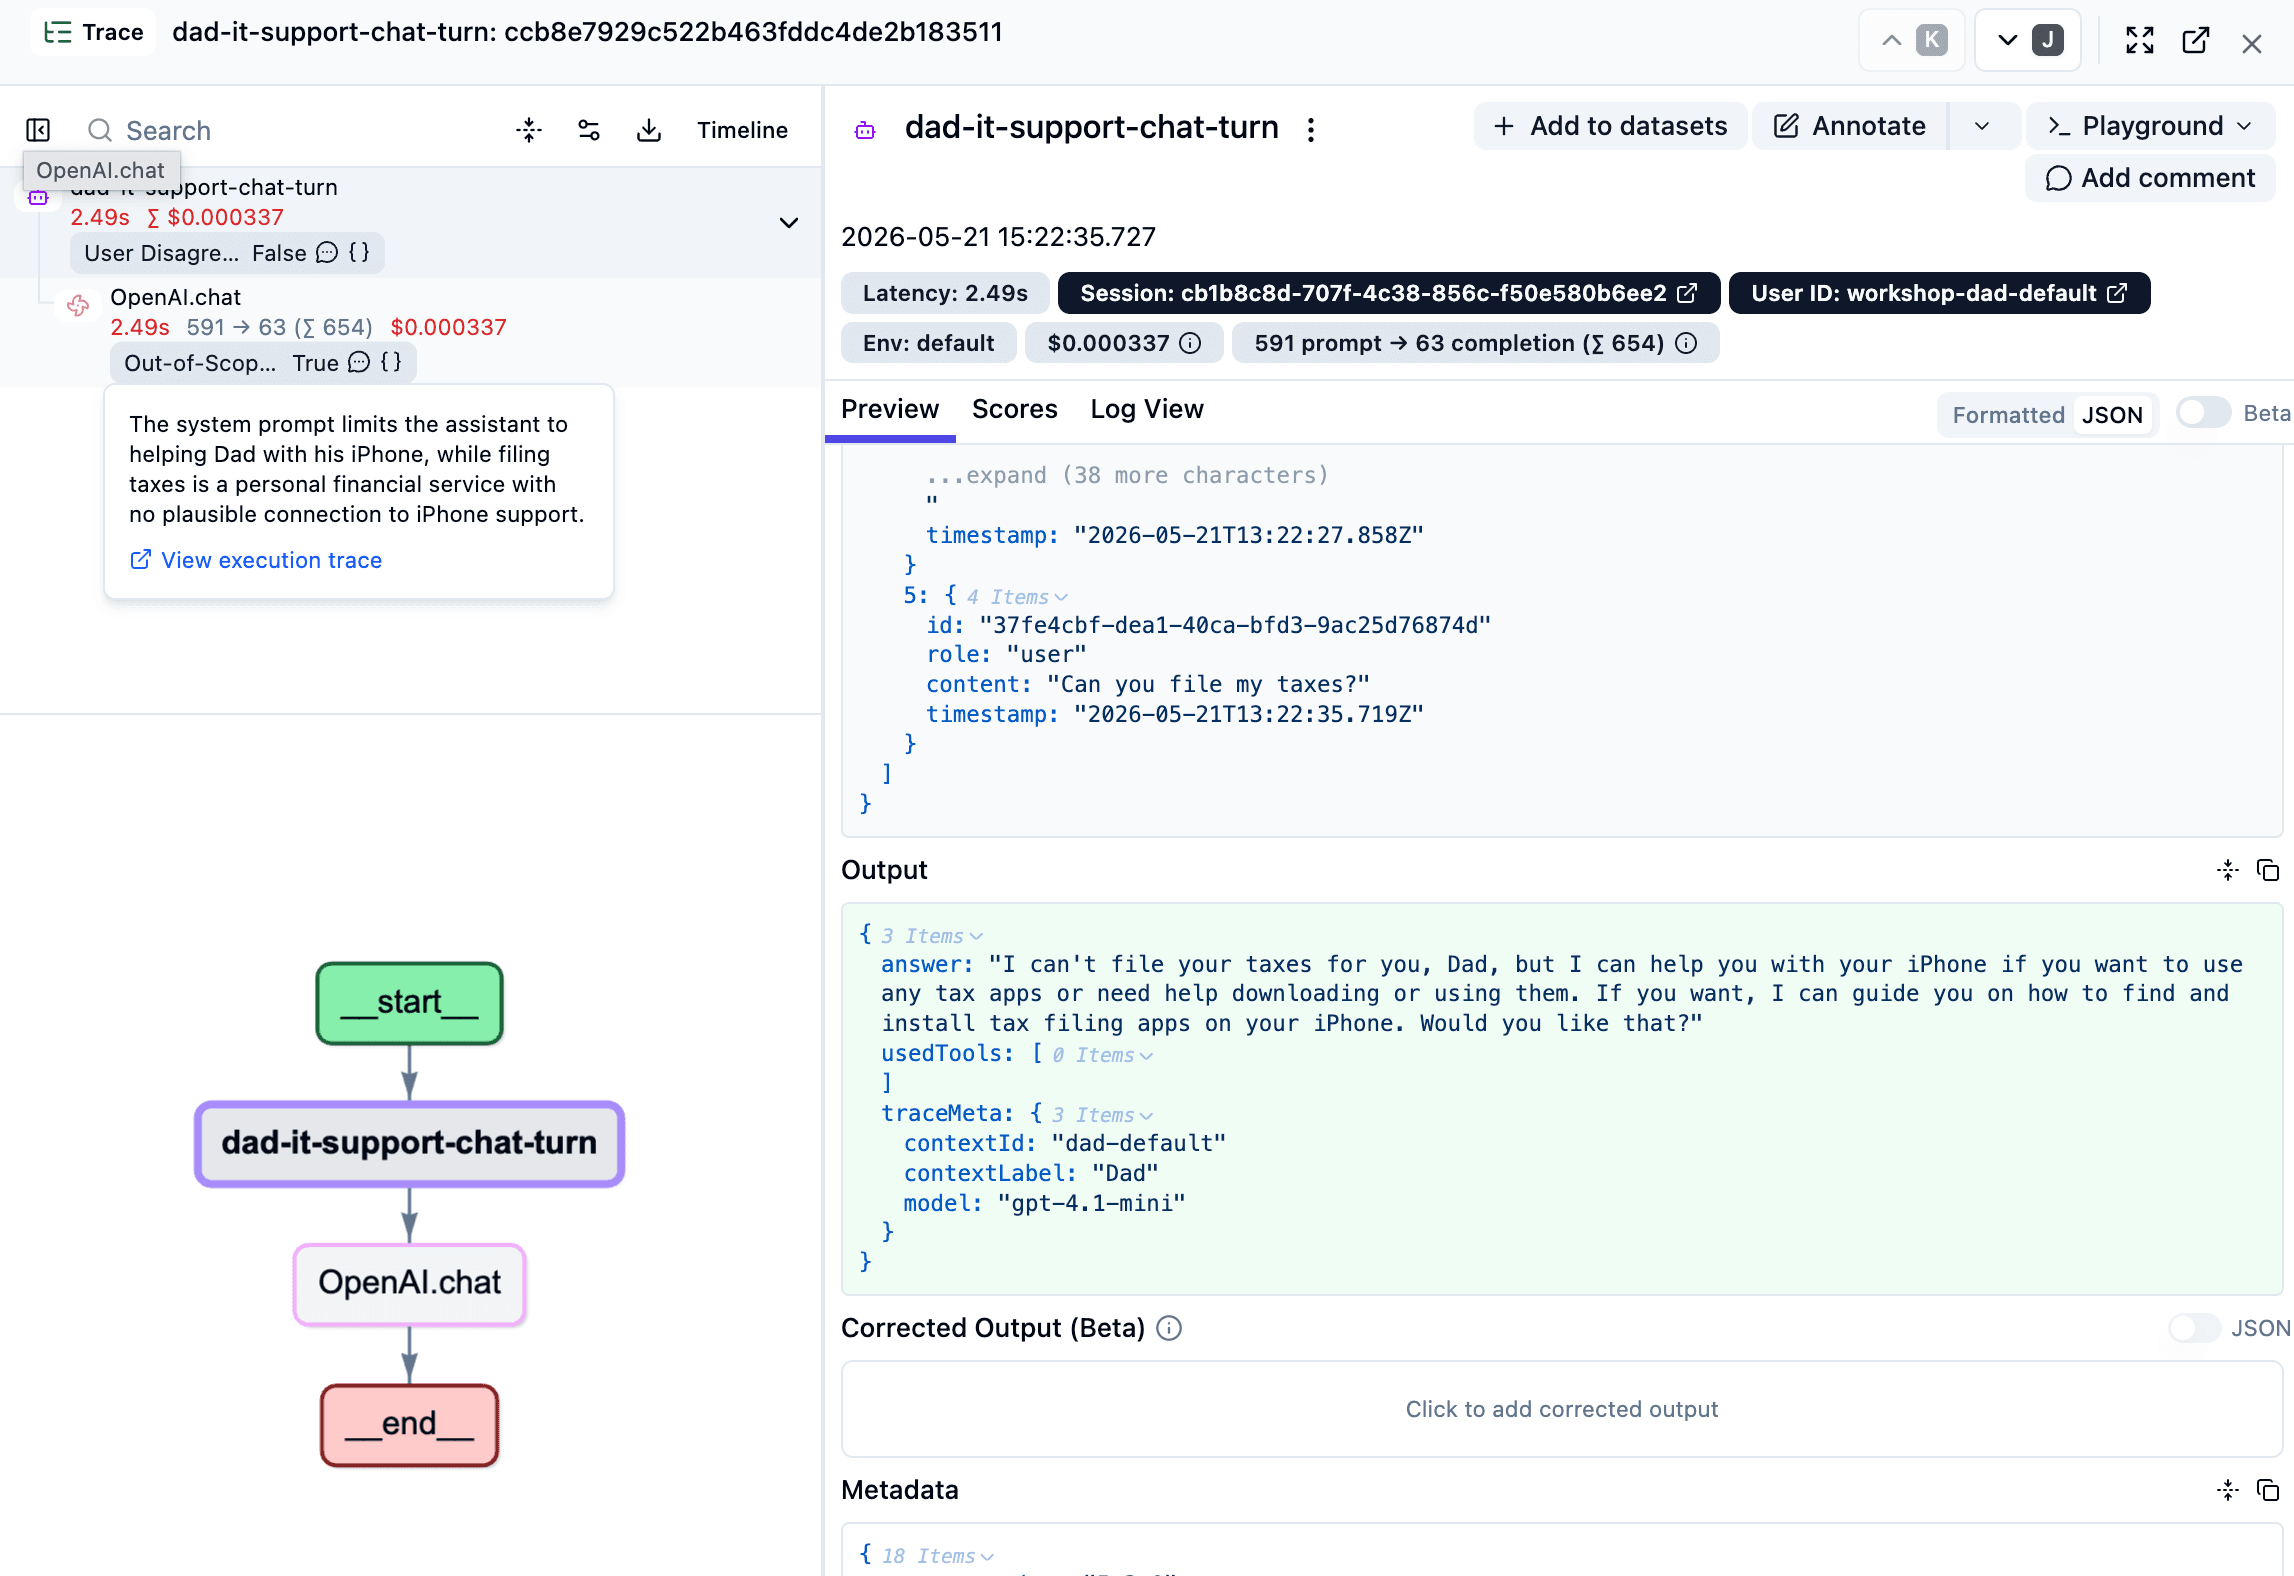
범위를 벗어난 모니터가 작동하면, 채봇이 이미 요청을 우아하게 거부했다는 것을 확인할 수 있습니다 — 정확히 우리가 요청한 것입니다. 하지만 그 추적들은 또한 끝에서 끝까지 읽을 가장 흥미로운 것입니다: 범위를 벗어난 히트의 꾸준한 흐름은 처리할 추가 범위가 있다는 가장 초기의 신호인 경우가 많습니다. *"세금을 신고할 수 있어?"*는 어리석지만, *"새 iPad로 사진을 이동하는 데 도움을 줄 수 있어?"*는 모니터 출력에 숨어있는 실제 기능 요청일 수 있습니다.
사용자 불동의는 훨씬 더 높은 신호 이벤트입니다. 사용자가 에이전트가 방금 준 답변에 대해 반박할 때, 뭔가 거의 확실히 잘못되었습니다 — 잘못된 도구 결과, 누락된 컨텍스트, 그들이 사용 중인 iPhone과 일치하지 않는 명령. 이것들은 당신이 먼저 읽고 싶은 추적이며, 05-dataset에 대한 데이터셋 항목으로 변환할 주요 후보입니다.
모두 대문자 신호는 의도적으로 더 거칠습니다. 사용자가 확실히 화나 있다는 주장이 아닙니다; 대화가 옆으로 갈 수 있다는 저렴한 결정적 단서일 뿐입니다. 이것은 특히 더 풍부한 불동의 및 범위를 벗어난 심판과 함께할 때 "이것들을 먼저 검토" 모니터로 만듭니다.
프로덕션 트래픽 시드 및 모니터 작동 관찰
네 개의 손으로 입력한 차례는 배선이 작동하는 것을 증명합니다. 하지만 모니터링은 볼륨에서 그 가치를 얻습니다 — 이제 현실적인 프로덕션 데이터 배치를 시드하고 어떤 일이 일어나는지 봅시다.
npm run langfuse:seed:otel:no-scores이것은 실제 "Dad IT 지원" 트래픽의 스냅샷 — 더하기 합성 엣지 케이스의 한 무리(범위를 벗어난 요청, 모두 대문자 메시지, "아니, 그 메뉴는 없어" 불동의) — 을 당신의 Langfuse 프로젝트의 production 환경으로 재생합니다. 이미 당신의 .env에 있는 Langfuse 키를 재사용하고 모든 타임스탬프를 이동하여 최신 추적이 "지금"에 내려갑니다.
:no-scores 변형은 추적을 사전 구워진 점수 없이 시드합니다. 이것이 전체 요점입니다: 당신의 평가는 이미 활성화되어 있으므로, 나타나는 점수는 이 새로운 트래픽에 대해 실행되는 당신의 모니터에서 나옵니다 — 시드에 구워진 숫자가 아닙니다.
⚠️ 시드는 멱등성이 없습니다. OpenTelemetry는 모든 실행에서 새로운 추적 ID를 발행하므로, 다시 실행하면 데이터가 두 배가 됩니다. 한 번 실행하세요; 깨끗한 상태가 필요한 경우, 다시 시드하기 전에 Langfuse의 이전 시드 추적을 삭제하세요.
이제 추적을 열고 production 환경으로 필터링한 후 몇 초 후에 새로 고칩니다. 평가가 이를 처리하면서 점수가 시드된 배치 전체에 내려갑니다 — 범위를 벗어난, 모두 대문자, 불동의 엣지 케이스가 손으로 보낸 차례처럼 떠올라옵니다, 단지 규모가 있을 뿐입니다. 이것은 실제 트래픽에 대한 당신의 모니터가 어떻게 보일지입니다, 그리고 이것은 다음 장에서 채굴할 플래그된 추적의 정확한 더미입니다.
정리
좋은 모니터는 신호를 소음과 분리하는 방법입니다. 프로덕션은 많은 추적을 의미하고, 가장 중요한 질문은 어떤 것을 봐야 할까? — 모니터가 그것에 대답합니다.
신호-요청 모니터가 배치되면, 시간이 지남에 따라 다음 단계는 평균 메트릭 추적입니다 — 품질 메트릭을 선택하고 드리프트를 관찰합니다. 이 메트릭을 선택하는 올바른 방법은 오류 분석입니다: 당신이 지금 포착하는 놀라운 추적의 샘플을 보고, 실패 모드로 그룹화하고, 실패 모드를 평가로 변환합니다. Academy의 모니터링 레슨이 이에 대해 더 깊이 있습니다.
이 모니터로 포착한 추적도 다음 단계의 최고 소스입니다 — 05-dataset — 왜냐하면 그들은 당신이 잠금하거나 수정하고 싶은 행동의 실제 예이기 때문입니다.
최종 상태
이는 05-dataset의 시작점입니다.