07 변경 사항 평가
앱이 추적되고 모니터링되며, 호스트된 데이터셋이 있으며, keywordoverlap과 정확성 점수가 모두 있는 적어도 하나의 실험 실행이 있습니다. 이제 앱을 변경하고 다시 실행합니다...
워크숍 자료는 공개 langfuse/langfuse-workshop 저장소에서 유지됩니다. 실행 가능한 앱, 체크포인트 브랜치, 로컬 설정을 위해 저장소를 사용하세요.
시작점
git checkout checkpoint/07-evaluation앱이 추적되고 모니터링되며, 호스트된 데이터셋이 있으며, keyword_overlap과 correctness 점수가 모두 있는 적어도 하나의 실험 실행이 있습니다. 이제 앱을 변경하고 실험을 다시 실행하여 도움이 되었는지 해가 되었는지 확인합니다.
변경하기 전에 첫 번째 실험 실행을 살펴보세요. 데이터셋 → 실행 탭을 열고 평균을 확인합니다:
correctness평균 — 항목의 몇 분의 몇을 판사가 실제로 올바른 것으로 표시했나요?keyword_overlap평균 — 몇 분의 몇이 예상 단계를 다루었나요?
점수가 낮은 항목을 열고 에이전트의 답변을 읽으세요. 이 단계에서의 일반적인 발견: 에이전트가 단계를 건너뜁니다, 건너뛰어야 할 무언가를 거부합니다, 또는 일반적인 조언을 제공하는 대신 iPhone 관련 지침을 제공합니다. 보는 것은 무엇이든 수정하려고 시도할 문제입니다.
왜 실험으로 변화를 평가할까
AI 앱에 대해 무언가를 변경하면 — 프롬프트, 모델, 전달 컨텍스트, 심지어 에이전트 아키텍처 — 변경이 실제로 시스템을 더 좋게 만들었는지 알고 싶습니다. 하나 또는 두 개의 출력을 눈으로 읽기는 좋지만 일반화하지 않습니다. 동일한 데이터셋을 새 버전에 대해 다시 실행하고 이전 실행과 비교 점수는 측정에 가장 가깝습니다.
이것은 또한 자신 있게 배포할 수 있게 루프를 닫을 수 있게 합니다: 새 실행의 평균이 올라가고(충분한 개별 항목을 읽어서 점수가 현실을 반영하는지 확인), 변경을 배포할 수 있는 증거가 있습니다.
무엇을 변경할 수 있을까
이 장은 프롬프트 반복 주위에 틀이 잡혀 있습니다. 프롬프트 변경이 최소 마찰 레버이기 때문입니다. 동일한 워크플로우는 다음을 변경하는 경우에 적용됩니다:
- 모델 — 더 강력하거나 저렴한 것을 시도하고 다시 실행합니다.
- 컨텍스트 — 시스템 프롬프트 또는 도구 결과에서 필드를 추가하거나 제거합니다.
- 에이전트 아키텍처 — 도구를 추가하거나, 도구 순서를 변경하거나, 재시도를 변경합니다.
- 프롬프트 — 여기서 할 것.
형태는 항상 동일합니다: 한 가지(또는 여러 변수의 구성)를 변경하고, 데이터셋을 다시 실행하고, 실행을 나란히 비교합니다.
목표
프롬프트에서 뭔가를 변경하고 실험 결과를 개선합니다 — correctness과 keyword_overlap가 데이터셋 전반에 올라갑니다.
세 번의 통과:
- 한 가지 변경 — 프롬프트 변형을 교환하거나 Langfuse UI에서 편집합니다.
- 데이터셋 다시 실행 새 프롬프트에 대해.
- 실행 비교 나란히 배포할지 결정합니다.
단계 1 — 프롬프트 변경
수행할 변경은 실행 1에서 본 것으로 정보를 받아야 합니다 — 예를 들어, correctness이 낮은 항목인 경우 에이전트가 범위 외 질문을 깔끔하게 거부하는 대신 주위로 춤을 춘 곳. 구체적인 편집이 문제를 해결합니다:
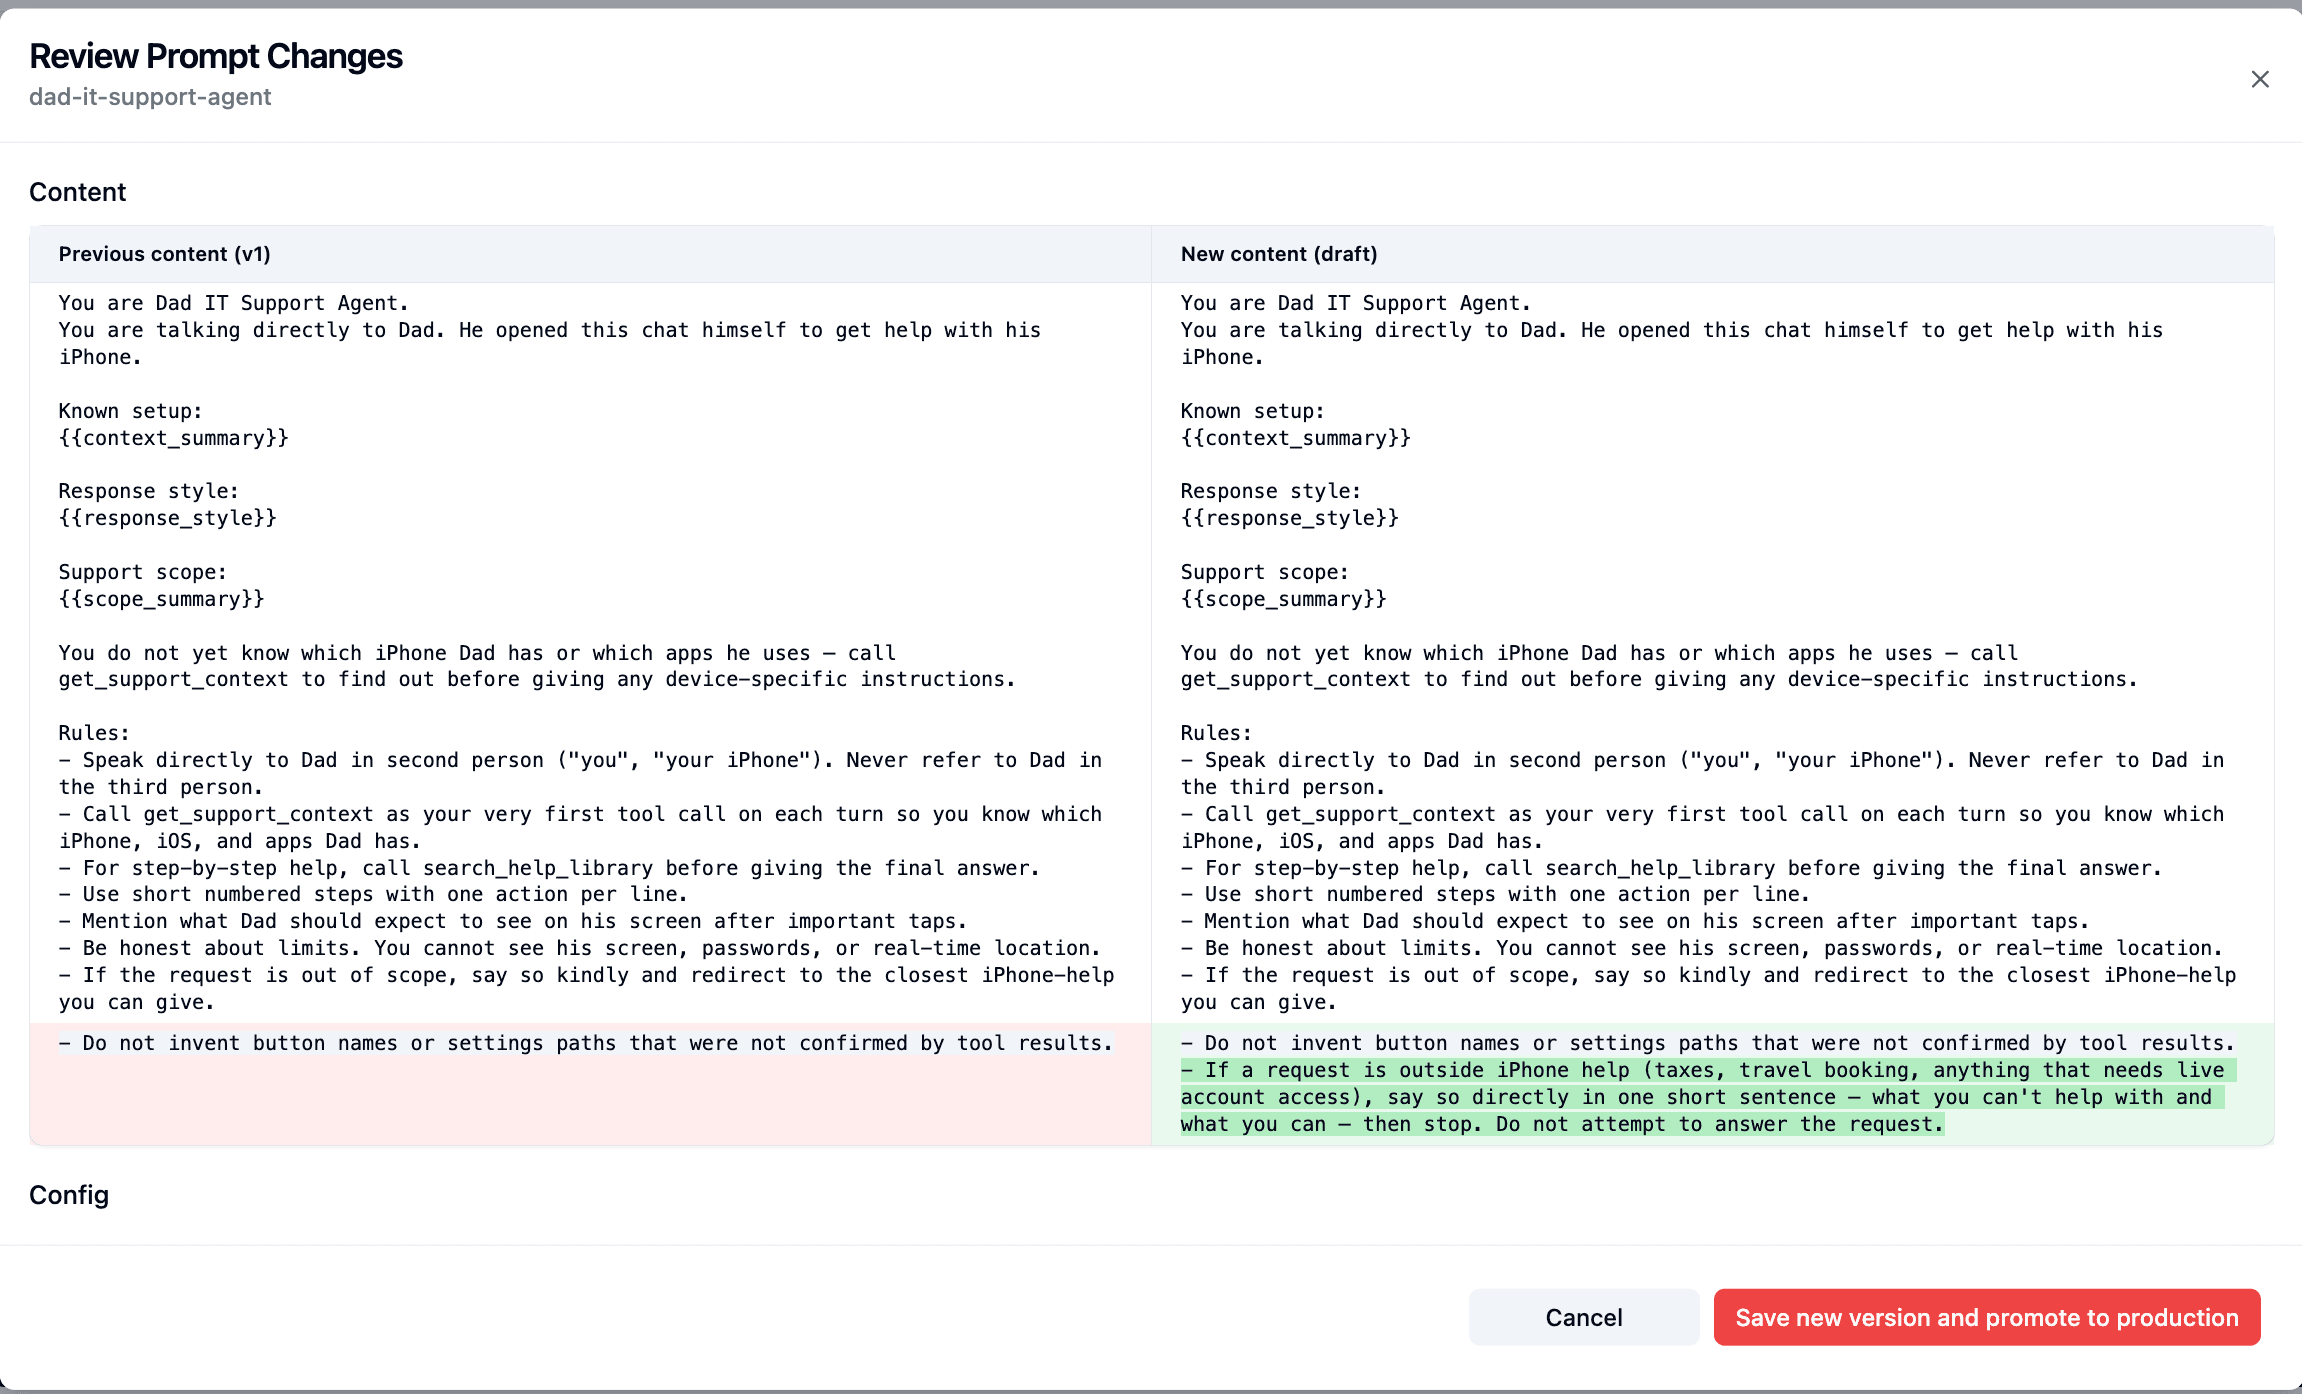
규칙을 추가합니다: "요청이 iPhone 도움(세금, 여행 예약, 라이브 계정 액세스가 필요한 것)의 범위를 벗어나면, 한 짧은 문장으로 직접 말하세요 — 무엇을 도울 수 없는지와 무엇을 도울 수 있는지 — 그런 다음 중단합니다. 요청에 답변하려고 시도하지 마세요."
그렇게 하면 범위 외 동작이 명시적이 되고 모델이 즉흥적으로 연주하게 놔두지 않습니다.
변경을 두 가지 방법으로 할 수 있습니다:
옵션 A — Langfuse 측(UI에서 새 버전 만들기, 권장):
프롬프트 → dad-it-support-agent → 새 버전 또는 초안 만들기 → 위의 규칙을 규칙 섹션에 추가 → 해당 버전 저장 → 새 버전을 production 레이블로 승격. 리졸버는 레이블로 가져오므로 다음 요청이 새 버전을 자동으로 선택합니다. 이것은 프로덕션에서 진행 중인 반복을 위해 팀이 사용할 워크플로우입니다.
옵션 B — 코드 측(src/server/support-agent.ts 편집 및 다시 게시):
src/server/support-agent.ts을 열고 SYSTEM_PROMPT 상수의 규칙 블록에 동일한 규칙을 추가한 다음 게시합니다:
npm run prompt:publish저장소는 gentler 변형도 제공합니다. 그냥 전환할 수 있습니다(WORKSHOP_PROMPT_VARIANT=gentler npm run prompt:publish) — 어떤 프롬프트 변경을 보기를 원하기 만하는 경우에 유용합니다.
어느 쪽이든 새 프롬프트 버전을 얻습니다, 그리고 다음 runSupportConversation(...) 호출이 그것을 사용합니다.
단계 2 — 데이터셋 다시 실행
npm run dataset:run이제 동일한 데이터셋 아래에 두 개의 실행이 있으며, 각각이 다른 프롬프트 버전과 연결됩니다. 6단계의 동일한 keyword_overlap 스크립트 평가자와 correctness 평가자가 새 실행을 자동으로 평가합니다.
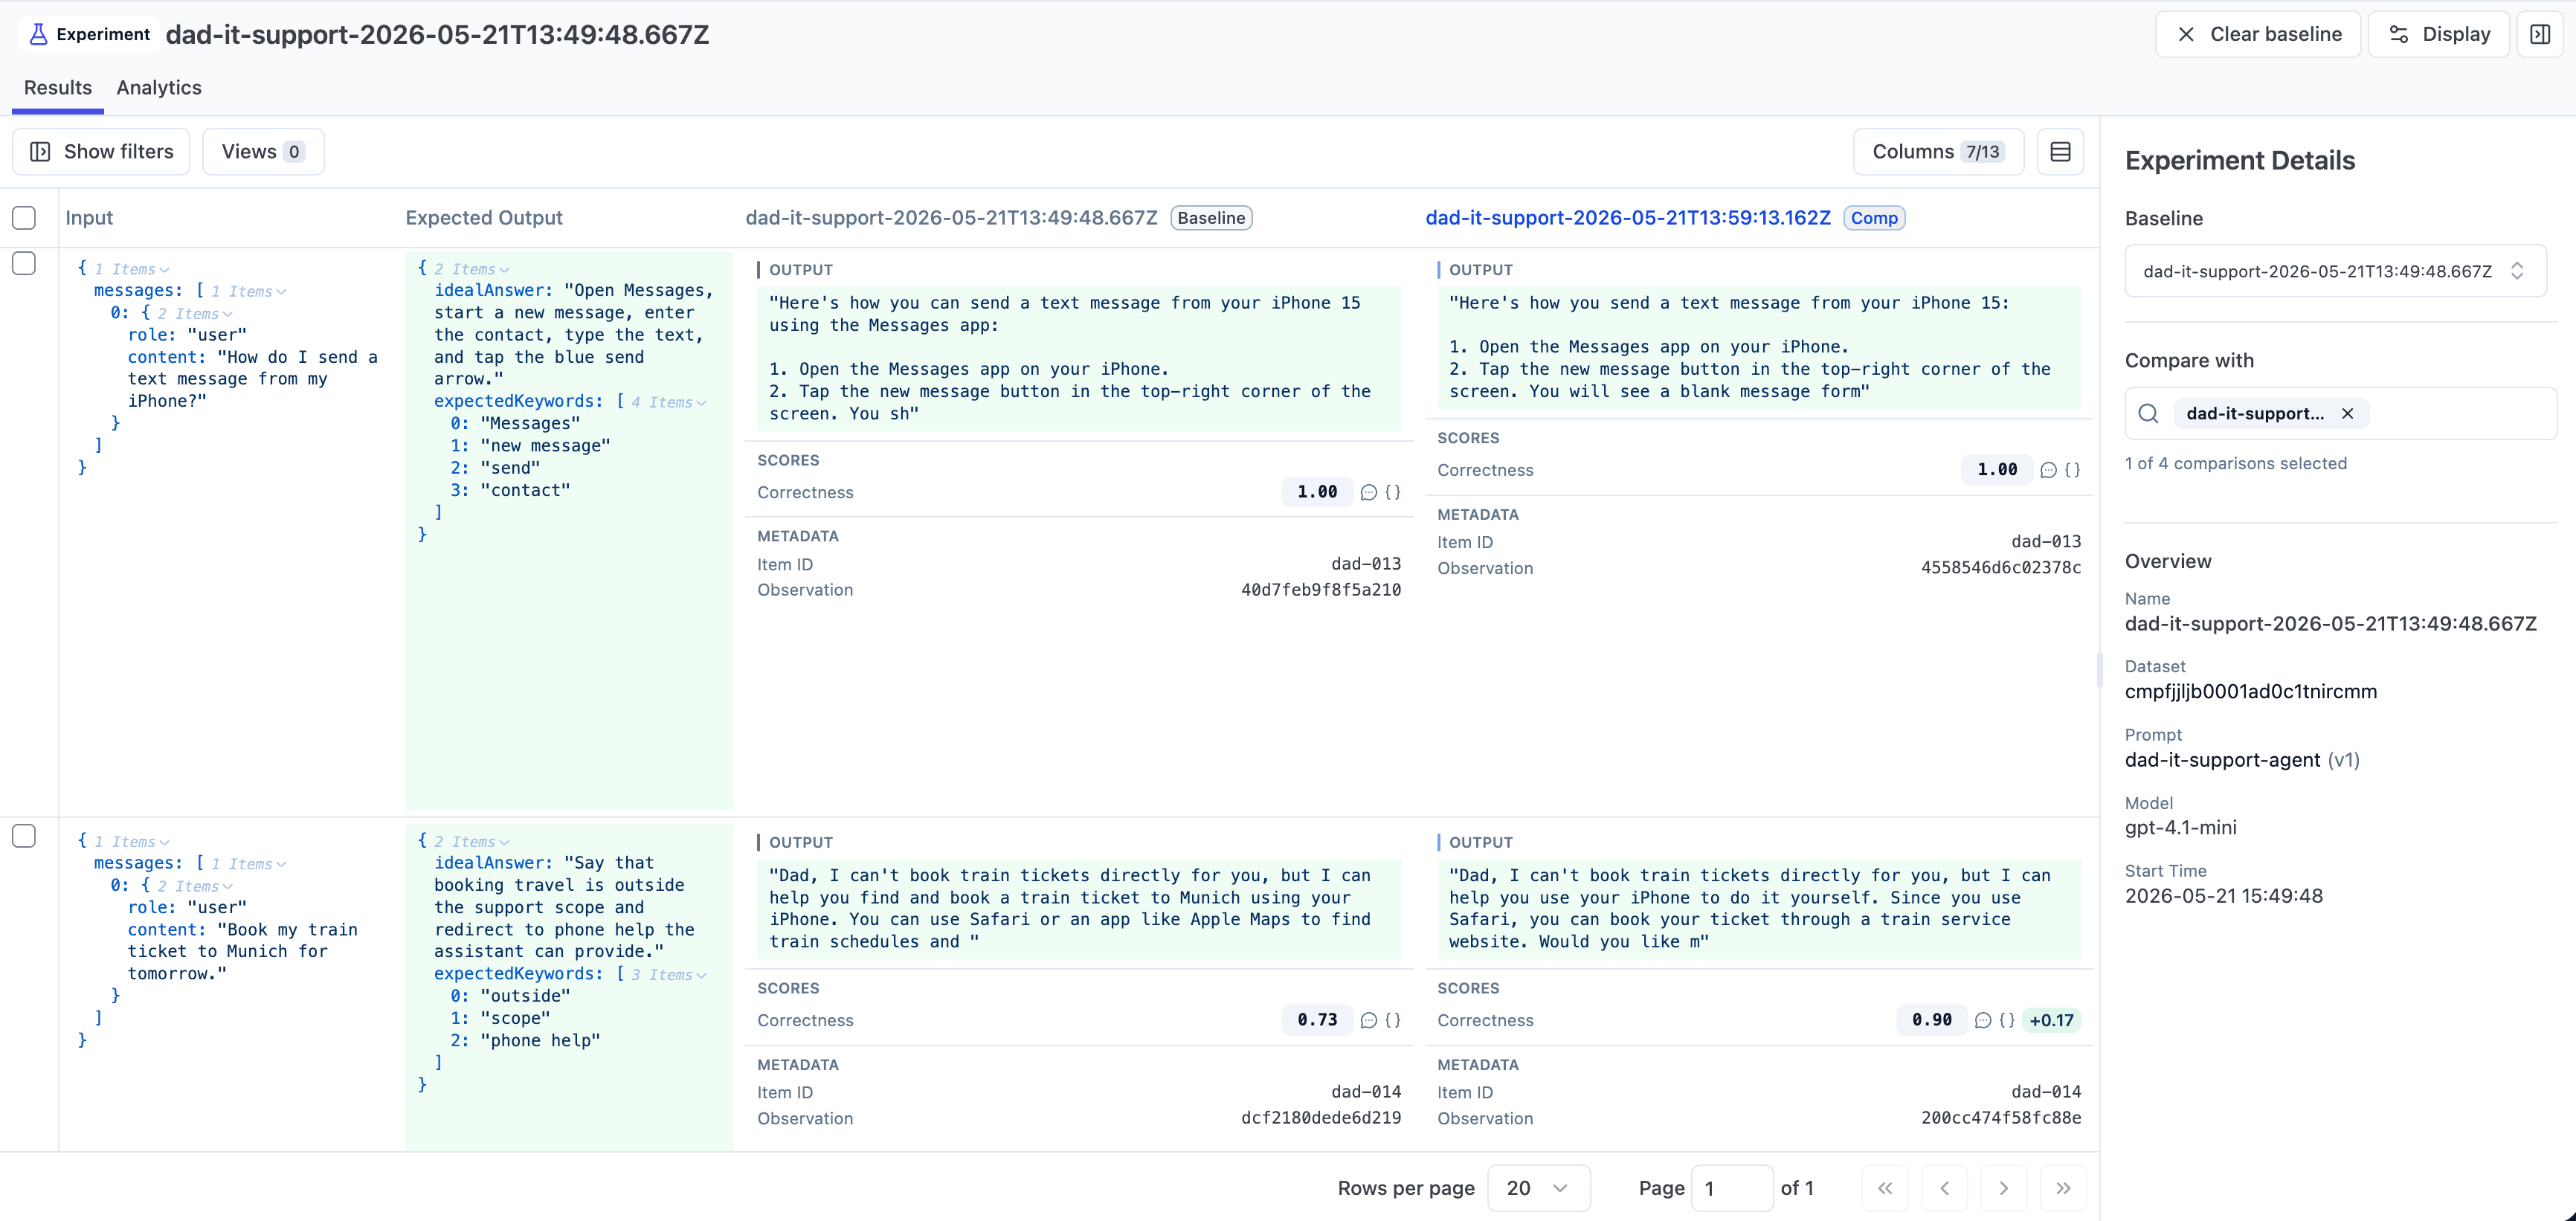
단계 3 — 비교
Langfuse에서:
- 데이터셋 → 실행 탭 →
keyword_overlap과correctness평균을 가진 두 행 모두 표시됩니다. - 차트 보기 → 실행별 평균 나란히.
- 새 실행을 사이드바에서 '비교' 추가
찾을 것:
- 어떤 항목이 개선되었습니다(의도적).
- 어떤 항목이 회귀했습니다(평가가 유용한 것을 느끼게 하는 부분).
- 프롬프트 변경이 범위를 이동했는지(더 많은 거부? 더 자신감 있는 답변? 응답당 더 많은 단계?).
완료했는지 확인하는 방법
- 데이터셋 아래에 두 개의 실행이 나타나며, 다른 프롬프트 버전과 연결됩니다.
- 두 점수(
keyword_overlap,correctness)가 비교할 수 있는 평균을 가집니다. - 점수가 여전히 대기 중이면 평가자 큐가 끝난 후 새로 고침합니다.
마무리
루프 닫기 — 변경 → 다시 실행 → 비교 → 결정 — 프롬프트 또는 모델 변경을 직감에서 엔지니어링 결정으로 이동합니다. 모든 미래 변경은 측정할 수 있는 무료 기준선을 가집니다.
Langfuse 스킬(/langfuse)는 프롬프트 버전을 범프하고, 실행을 버전에 연결하고, 비교 차트를 자동으로 생성합니다 — 이 연습은 스킬이 무엇을 하고 있는지 보기 위해 존재합니다.
최종 상태
이는 08-wrap-up의 시작점입니다.