02 Mesurer hors ligne
Utilisez les evaluators, datasets et traces Langfuse pour mesurer réellement le gagnant, question par question et niveau par niveau.
Point de départ
Le Module 01 est terminé : l'Arena a été exécutée, le Leaderboard est rempli et vous avez un config_id gagnant (<model>__<prompt>, par exemple claude-sonnet-5__P1_zeroshot).
Pourquoi
Gagner l'Arena prouve qu'une configuration a battu les autres globalement selon le coût par réponse correcte. Cela ne dit pas comment elle gagne, où elle est la plus faible, ni si son SQL est seulement correct ou vraiment bon. Avant de la publier et d'évaluer le trafic de production, il est utile de la comprendre, comme vous voudriez savoir non seulement qu'un candidat a réussi un entretien, mais quelles questions il a maîtrisées et lesquelles il a tout juste passées. Langfuse contient déjà tout le nécessaire : les evaluators du Module 01 ont noté chaque élément et chacun possède une trace complète. Ce module consiste à lire ces détails, pas à produire de nouvelles données.
Concepts — sous le capot
Trace → observations → scores. Langfuse structure de la même manière chaque exécution de l'agent :
- Une trace correspond à une exécution, une combinaison
model × prompt × question, nomméeagent_runet taguée avec leconfig_id. - Les observations sont les spans de cette trace. La seule est
llm_call, une observation de type generation qui porte le prompt, la réponse et l'usage des tokens. La sortie de l'Experiment Item enregistre le coût exact de bout en bout et la latence utilisés par le leaderboard. Il n'existe pas d'observation séparée pour l'exécution SQL : celle-ci est un appel ClickHouse ordinaire sans span Langfuse propre ; le SQL et son résultat se trouvent dans l'entrée et la sortie de la racine. - Les scores sont attachés après coup par les evaluators du Module 01 :
correctness(précision d'exécution binaire),agent-arena-llm-judge(qualité SQL graduée par LLM-as-a-judge) et une catégorieoutcome. La définition Langfuse estllm_judge; le score qu'elle émet et que le harness attend s'appelle exactementagent-arena-llm-judge.
Chaque trace est un agent_run avec une unique observation enfant, la génération llm_call, ainsi que trois scores attachés après la notation : correctness, agent-arena-llm-judge et outcome.
Niveaux. Le corpus contient 20 questions YAML, mais q019 et q020 sont des exemples few-shot réservés. Dans un projet propre, chacune des 18 questions de arena-golden possède un tier de 1, le plus simple avec des décomptes et filtres sur une table, à 5, le plus difficile avec joins multi-tables, funnels et calculs de marge. La précision par niveau existe parce qu'un score global peut masquer un effondrement au niveau 5 derrière de bons résultats aux niveaux 1 et 2.
Catégories de résultat. Le Code Evaluator correctness de Langfuse (eval/langfuse_evaluators/correctness_evaluator.py) classe chaque Experiment Item terminé selon sa progression :
| Résultat | Signification |
|---|---|
correct | Le jeu de résultats correspond au jeu doré. |
model_error | L'appel OpenRouter échoue avant la génération du SQL (clé incorrecte ou expirée, limite, panne fournisseur). |
sql_policy_rejected | agents/sqlguard.py bloque le SQL avant ClickHouse (pas une instruction SELECT unique ou mot-clé interdit). |
sql_exec_error | Le SQL atteint ClickHouse mais ne s'exécute pas (syntaxe, colonne inconnue, etc.). |
empty_but_expected | La requête renvoie zéro ligne alors que la réponse dorée en contient. |
wrong_result | La requête renvoie des lignes différentes du jeu doré. |
Chaque catégorie appelle une correction différente : sql_policy_rejected réclame un meilleur prompt système sur la lecture seule ; sql_exec_error indique généralement une lacune de dialecte, voir P3_dialect ; empty_but_expected et wrong_result pointent souvent vers un filtre, join ou agrégat erroné.
Objectif
Savoir lire la précision par niveau et la répartition des résultats de la configuration gagnante, comprendre ce qu'ajoute agent-arena-llm-judge à la correction brute et pouvoir passer d'une ligne du leaderboard à la trace Langfuse exacte d'une question.
Étape 1 — Lire la précision par niveau et la répartition des résultats
Ouvrez http://localhost:5174 → Leaderboard, puis la ligne du gagnant. En plus de la précision, de la latence et du coût par réponse correcte, chaque configuration présente :
- Précision par niveau — les questions de
arena-goldensont groupées par difficulté ; une configuration solide globalement peut vaciller au niveau le plus difficile, ce qu'un agrégat masque. - Répartition des résultats — toutes les réponses incorrectes n'échouent pas de la même manière : sandbox, erreur ClickHouse, résultat vide ou mauvais jeu de résultats. Chaque problème demande une correction différente.
Comment la lire. La précision par niveau apparaît comme une table ou des barres pour les niveaux 1 à 5. Repérez où le score chute : une configuration presque parfaite aux niveaux 1 et 2 mais faible aux niveaux 4 et 5 maîtrise les recherches simples, pas les joins et agrégations en plusieurs étapes. La répartition compte les catégories (correct, sql_policy_rejected, sql_exec_error, empty_but_expected, wrong_result) : beaucoup de sql_exec_error indiquent le dialecte ; beaucoup de wrong_result, la logique.
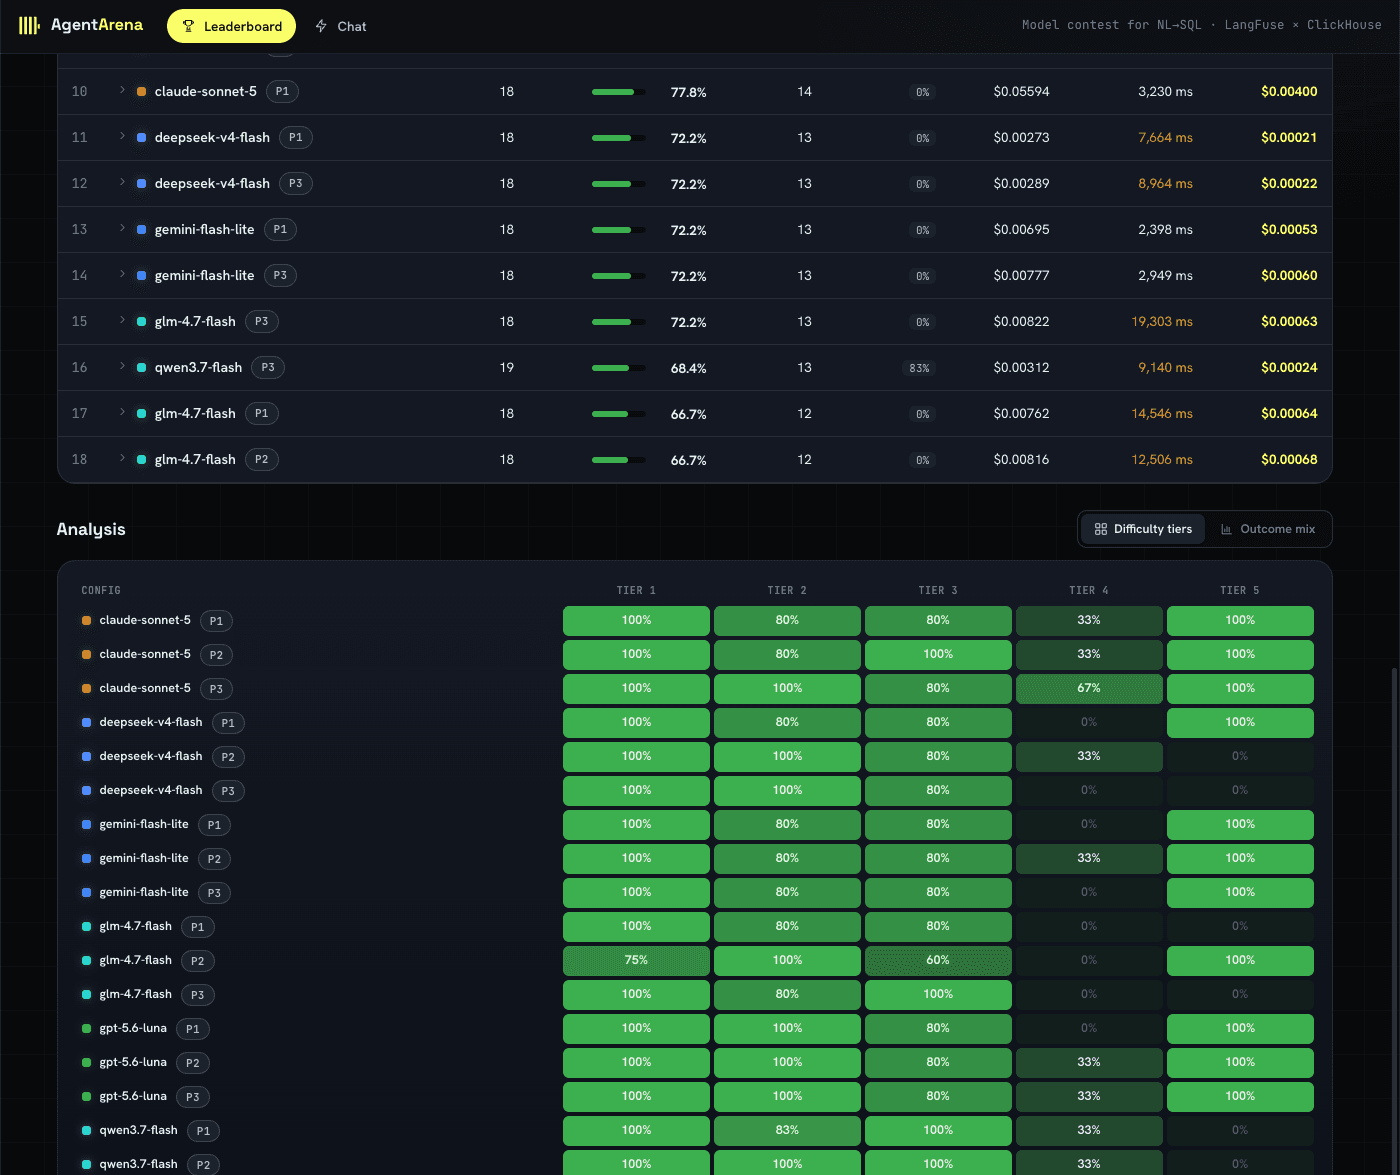
La vue Difficulty tiers révèle des motifs cachés par la précision globale. Ici, la plupart des configurations réussissent aux niveaux 1 à 3, tandis que le niveau 4 est la faiblesse commune la plus nette ; comparez la baisse du gagnant.
Étape 2 — Lire le signal secondaire agent-arena-llm-judge
Le score correctness est binaire. agent-arena-llm-judge, émis par la définition llm_judge configurée au Module 01, est un signal secondaire plus fin : une note LLM-as-a-judge de la qualité SQL. Une configuration peut être correcte à l'exécution tout en écrivant un SQL qu'un relecteur signalerait, comme une sous-requête inutile, une comparaison de dates fragile ou un join qui ne généraliserait pas. Utilisez agent-arena-llm-judge pour distinguer « passe » de « bien écrit ».
Étape 3 — Examiner des traces individuelles
Depuis une ligne du leaderboard, ouvrez ses résultats par question puis une trace Langfuse. Elle contient le chemin complet : prompt, SQL généré, génération llm_call avec réponse et tokens, coût et latence exacts de l'Experiment Item et, en cas d'échec, l'erreur ClickHouse. Vous réutiliserez cette compétence lors de l'enquête humaine du Module 04, quand les questions viendront de vrais utilisateurs.
Choisissez deux ou trois questions incorrectes, ou mal notées par agent-arena-llm-judge, et lisez leur trace de bout en bout. Cherchez un motif : formulation, join ou filtre de date systématiquement mal géré.
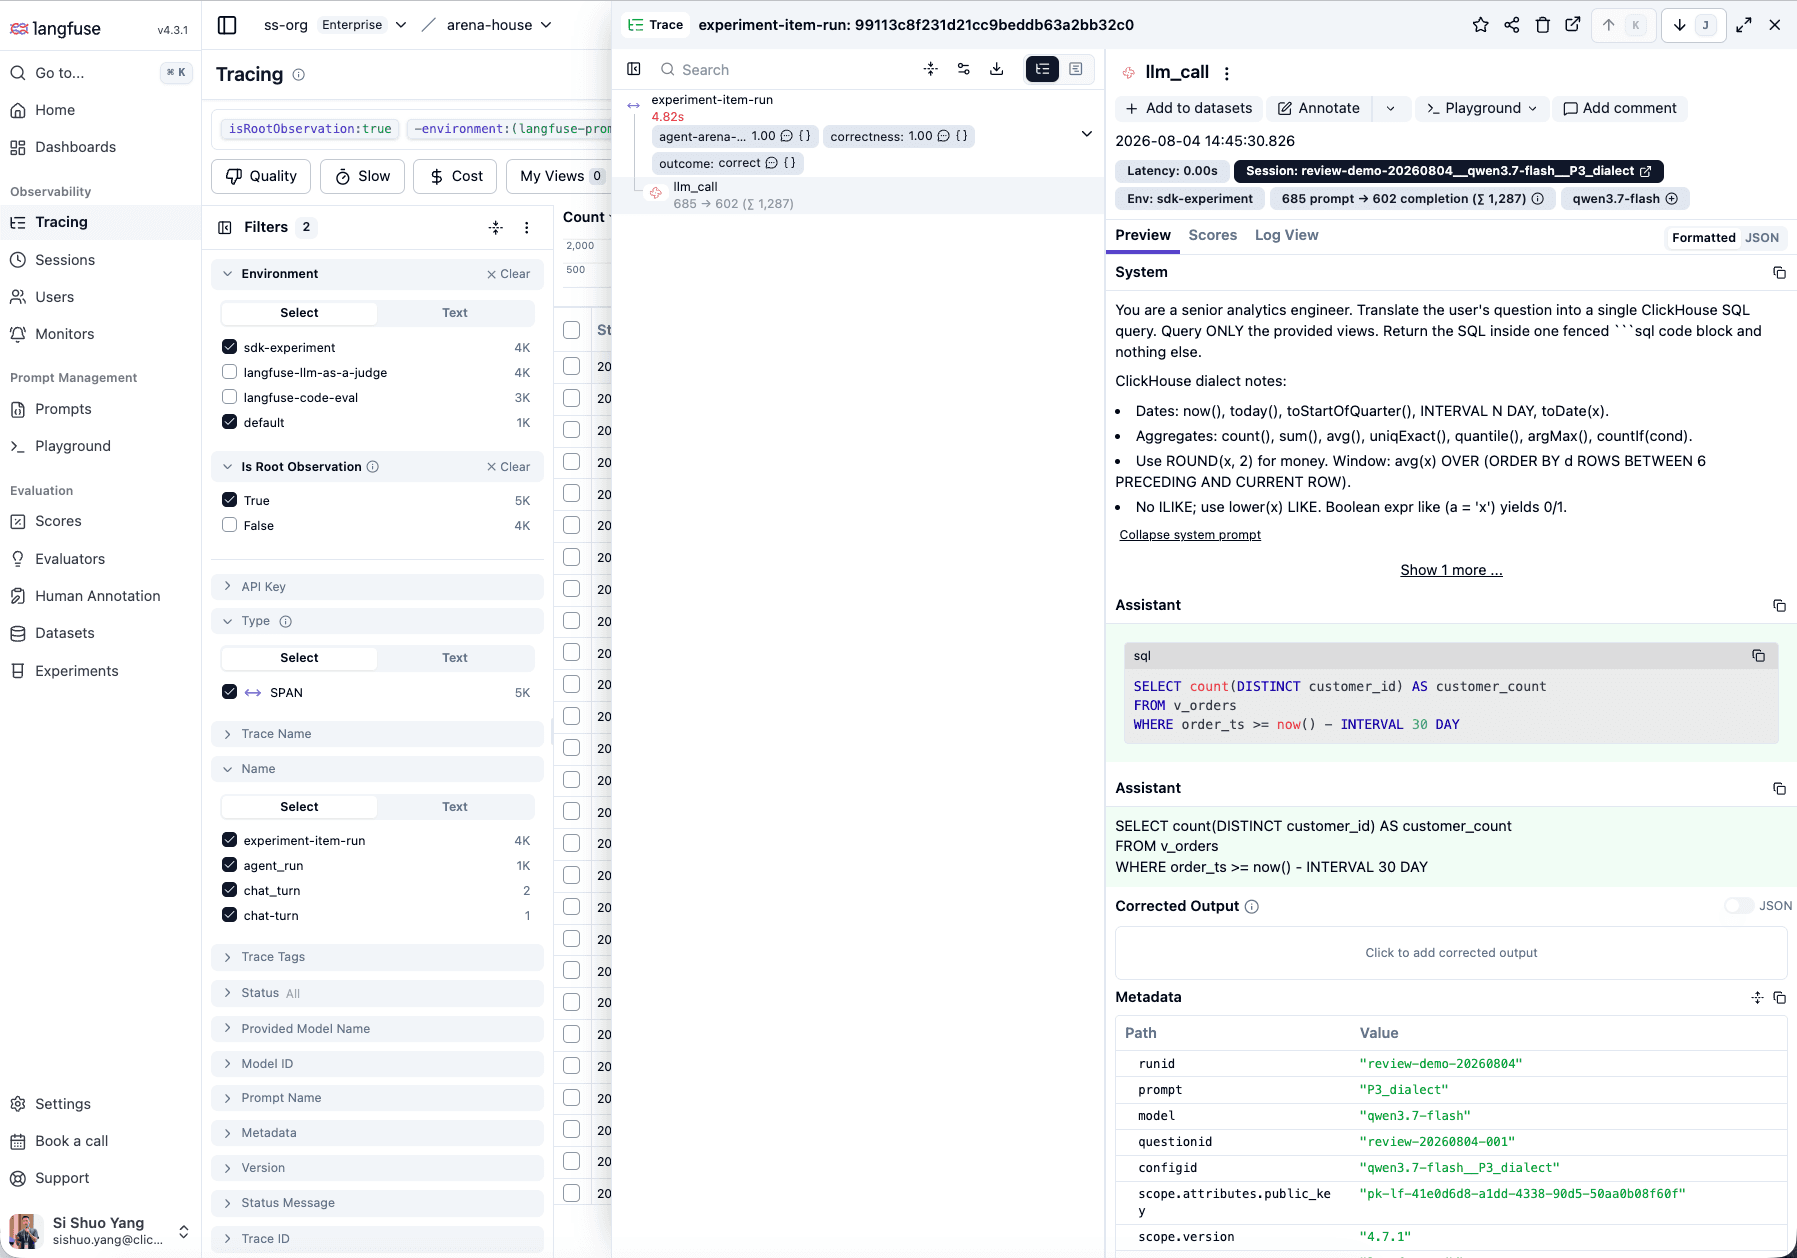
Un Experiment Item relie les scores en haut de la trace au llm_call exact. Le panneau affiche prompt, SQL, tokens, latence et métadonnées permettant d'expliquer la réussite ou l'échec.
Comment vérifier que vous avez terminé
- Vous pouvez donner la précision du gagnant sur au moins un niveau précis.
- Vous pouvez montrer une question où
correctnessetagent-arena-llm-judgediffèrent, ou expliquer l'absence de désaccord. - Vous avez ouvert une trace et pouvez parcourir prompt → SQL généré → résultat ou erreur.
Exercice — s'entraîner au diagnostic avant publication
Transformez l'étape 3 en artefact écrit avant le Module 03 :
-
Choisissez 2 ou 3 questions du gagnant avec
correctness = 0ou un score faibleagent-arena-llm-judge. -
Ouvrez chaque trace et remplissez une ligne :
Question Ce qui a été généré Cause de l'échec Catégorie de résultat (texte de la question) (SQL produit, en bref) (votre analyse : mauvais join, filtre de date absent, formulation mal comprise, …) ( sql_exec_error/wrong_result/ …) -
Recherchez un motif répété dans les 2 ou 3 lignes : même join, même erreur de date ou même formulation. Vous cherchez un motif, pas une liste de bogues indépendants.
Gardez cette observation comme contexte hors ligne, mais ne la prenez pas pour l'incident de production. Le Module 03 crée une nouvelle trace de production marquée par le feedback ; le Module 04 applique la méthode que vous venez de pratiquer à cet incident précis.
Récapitulatif
Vous savez maintenant non seulement que la configuration a gagné, mais comment : forces, faiblesses et apparence des échecs dans les traces. Ces détails deviennent l'action suivante.
État final
Une vue détaillée de la qualité du gagnant. Passez à 03 Publier et détecter pour publier la configuration et capturer un désaccord réel entre evaluator et signal utilisateur.
01 Sélectionner le modèle de base
L'Arena : exécutez la grille modèle × prompt comme expériences Langfuse et couronnez un gagnant selon le coût par réponse correcte.
03 Publier et détecter
Publiez l'agent sélectionné avec un angle mort connu, puis utilisez l'évaluation opérationnelle et le feedback réel pour le détecter.