01 Sélectionner le modèle de base
L'Arena : exécutez la grille modèle × prompt comme expériences Langfuse et couronnez un gagnant selon le coût par réponse correcte.
Point de départ
Le Module 00 est terminé : .env est chargé, la base arena initialisée, Langfuse connecté et le dashboard local accessible sur http://localhost:5174 avec un onglet Leaderboard vide.
Pourquoi cette décision est fondamentale
Tout l'atelier repose sur cette décision. Avant de publier un agent sérieux, vous devez répondre à une question fondamentale : quel modèle doit l'alimenter ? Les modèles diffèrent énormément en capacités et en prix, et le meilleur choix dépend de votre tâche précise, pas d'un classement public réalisé sur une autre charge. Deviner coûte cher dans les deux sens : surpayer un modèle de pointe inutile ou publier un modèle bon marché qui se trompe silencieusement sur vos vraies questions.
Au lieu de deviner, vous organisez une compétition : l'Arena. Une grille de modèles et de stratégies de prompt répond aux mêmes questions dorées, Langfuse note chaque réponse comme une expérience, et la métrique qui couronne le gagnant n'est pas la précision brute, mais le coût par réponse correcte : la qualité par dollar pour votre cas d'usage. Concrètement, ce module répond par des preuves : quelle configuration de la grille fournit le plus de réponses correctes par dollar ? « Correcte » signifie précision d'exécution : le SQL généré renvoie le même jeu de résultats que le SQL doré, pas seulement un SQL plausible. La notation a lieu dans Langfuse, pas dans le harness. Langfuse héberge les evaluators et conserve chaque Experiment Item, score et trace. Le leaderboard local lit ces enregistrements par l'API publique Langfuse. Tous les modules suivants supposent que ce choix repose sur des preuves.
Concepts — sous le capot
Modèle de données Langfuse pour cette évaluation. Le corpus source contient 20 questions YAML. q019 et q020 sont des exemples few-shot réservés ; dans un projet propre, le Dataset initialisé (arena-golden) contient donc 18 questions d'expérience, chacune avec son jeu de résultats attendu. Chaque configuration model × prompt est une Experiment, c'est-à-dire un Dataset Run Langfuse, sur ces mêmes 18 éléments. Toutes les configurations sont ainsi notées sur exactement les mêmes questions. Les définitions d'evaluator configurées à l'étape 1 sont correctness et llm_judge ; les scores émis sont correctness et agent-arena-llm-judge. Un dataset, plusieurs expériences et un score par élément et expérience permettent une comparaison équitable.
Chaque configuration modèle × prompt s'exécute comme une Experiment (Dataset Run) sur arena-golden, et chaque expérience associe deux scores à chaque élément : correctness (0/1) et agent-arena-llm-judge (0..1).
Les stratégies de prompt participent aussi. La grille ne contient pas seulement des modèles, mais model × prompt, car la manière de demander compte autant que le modèle choisi. D'après config.yaml et agents/prompts.py :
| Prompt | Fonctionnement | Intérêt possible pour NL→SQL |
|---|---|---|
P1_zeroshot | Schéma et question uniquement ; renvoie un bloc SQL délimité. La référence. | Le moins cher par appel ; mesure les capacités du modèle sans aide. |
P2_fewshot | P1 plus deux exemples NL→SQL résolus et réservés hors du jeu de test. | Montre au modèle la forme attendue d'une « bonne » réponse avant qu'il écrive. |
P3_dialect | P1 plus une fiche du dialecte ClickHouse (fonctions de date, uniqExact, argMax, INTERVAL, pas de ILIKE, …). | Corrige l'échec le plus fréquent : un SQL fluide mais invalide en ClickHouse. |
Les concurrents : propriétaires ou à poids ouverts. Les six modèles se répartissent à parts égales selon un second axe aussi important que leur nom : poids fermés, via une API fournisseur, ou ouverts, avec possibilité d'auto-hébergement, de fine-tuning ou de maintien dans votre périmètre de données. Les modèles à poids ouverts sont souvent beaucoup moins chers par token, tandis que les modèles propriétaires de pointe peuvent dominer en capacité brute ; mais c'est précisément ce « peuvent » que l'Arena teste sur votre tâche. Faire passer les deux groupes sur le même dataset permet au coût par réponse correcte de montrer si la frontière vaut son prix. La sélection reste volontairement économique : NL→SQL est assez simple pour que même le modèle le plus cher soit intermédiaire, pas de pointe.
| Modèle | Fournisseur | Ouvert / Propriétaire | Repli indicatif ($/1M entrée · sortie) |
|---|---|---|---|
claude-sonnet-5 | Anthropic | Propriétaire | $2.00 · $10.00 |
gpt-5.6-luna | OpenAI | Propriétaire | $0.50 · $3.00 |
gemini-flash-lite | Propriétaire | $0.30 · $2.50 | |
deepseek-v4-flash | DeepSeek | Poids ouverts | $0.14 · $0.28 |
qwen3.7-flash | Qwen | Poids ouverts | $0.03 · $0.13 |
glm-4.7-flash | Z.ai | Poids ouverts | $0.06 · $0.40 |
Pourquoi le coût par réponse correcte et la précision d'exécution. Une réponse est correcte si l'exécution du SQL généré produit le même jeu de résultats que le SQL doré. Cette mesure honnête ne demande pas des requêtes identiques caractère par caractère, mais la bonne réponse. La métrique principale devient :
cost_per_correct_answer = total cost of the run ($) / number of correct answersElle favorise un modèle presque aussi précis mais beaucoup moins cher par rapport à un modèle de pointe à peine meilleur et bien plus coûteux : la métrique qu'une équipe attentive aux coûts optimiserait réellement.
Objectif
Un Leaderboard contenant plusieurs configurations model × prompt classées par coût par réponse correcte, chaque rang étant adossé à une trace Langfuse consultable, et un gagnant : un config_id.
Étape 1 — Configurer les evaluators Langfuse (une fois)
Suivez une fois eval/langfuse_evaluators/README.md. Initialisez d'abord arena-golden et configurez par l'API le juge adossé à OpenRouter :
python -m scripts.provision_langfuse_evaluatorsConfigurez ensuite l'evaluator de code déterministe dans l'interface Langfuse :
- Evaluator de code
correctness— Evaluators → Set up Evaluator → Code → collezeval/langfuse_evaluators/correctness_evaluator.py→ Target: Experiments → filtre dataset =arena-golden. Il compare le jeu de résultats de l'agent, issu de la trace, au résultat doré de l'élément (expected_output) et émet le scorecorrectness(0/1) ainsi qu'une catégorieoutcome. Il n'a aucun accès réseau : le SQL s'est déjà exécuté dans l'agent ; l'evaluator compare seulement les résultats. - Repli manuel pour la définition
llm_judge— Evaluators → Set up Evaluator → LLM-as-a-judge → Custom → utilisez les prompts système et d'évaluation et les mappings deeval/langfuse_evaluators/llm_judge_prompt.md→ Target: Experiments, datasetarena-golden→ émettez le score numériqueagent-arena-llm-judge. La définition et le score portent volontairement des noms différents. Ce signal secondaire mesure la qualité SQL au-delà de la correction ; vous l'utiliserez au Module 02.
L'utilitaire est recommandé ; l'étape manuelle du juge n'est qu'un repli. L'evaluator de code correctness reste une configuration unique dans l'interface.
Étape 2 — Exécuter la compétition
source .env && python -m eval.harness --run-id demoCe que vous devez voir. Le harness affiche d'abord une ligne de résumé (run_id=demo configs=6x3 ...), puis une ligne par question, par exemple :
claude-sonnet-5__P1_zeroshot q001 pending 812ms $0.00021Chaque ligne commence par pending : le SQL s'est exécuté et le résultat a été enregistré dans la trace, mais les evaluators Langfuse ne l'ont pas encore noté. Une fois toutes les configurations terminées, le harness attend : grading via Langfuse evaluators — waiting on N traces..., affiche un décompte à mesure que les scores correctness/agent-arena-llm-judge arrivent, puis termine par Langfuse scored all N traces; leaderboard ready. Ce passage de pending à noté représente la délégation de la notation à Langfuse ; résultat et verdict y restent réunis comme source de vérité du leaderboard.
La commande exécute toute la grille model × prompt, tous les modèles de config.yaml avec toutes les stratégies de P1_zeroshot à P3_dialect, comme Dataset Runs (Experiments) Langfuse sur arena-golden. Le harness attend les scores exacts correctness et agent-arena-llm-judge sur chaque élément. Le coût OpenRouter exact et la latence de bout en bout sont stockés sur le même Experiment Item.
Une configuration vaut <model>__<prompt>, par exemple claude-sonnet-5__P1_zeroshot. Les noms viennent de config.yaml :
- Modèles : les six concurrents du tableau, trois propriétaires (
claude-sonnet-5,gpt-5.6-luna,gemini-flash-lite) et trois à poids ouverts (deepseek-v4-flash,qwen3.7-flash,glm-4.7-flash). - Prompts :
P1_zeroshot,P2_fewshot,P3_dialect.
Options utiles :
--models qwen3.7-flash,gpt-5.6-luna/--prompts P1_zeroshot,P3_dialect— limiter la grille à un sous-ensemble CSV.--run-id <name>— nommer l'exécution pour la retrouver dans le Leaderboard et Experiments.
Le SDK peut traiter les éléments dans un ordre inversé ou concurrent ; fiez-vous à l'ID de question, pas à un ordre q001, q002, ... Une grille complète de 18 configurations prend généralement 35 à 45 minutes. En atelier, commencez avec deux modèles et un prompt ; n'exécutez l'ensemble que si le temps et les limites fournisseur le permettent.
Les evaluators Langfuse sont obligatoires. Langfuse est l'unique stockage d'évaluation ; il n'existe aucun repli de notation locale ou de résultats ClickHouse. Si le harness atteint son timeout, corrigez l'étape 1 et utilisez un nouveau --run-id.
Étape 3 — Couronner le gagnant
Ouvrez http://localhost:5174 → Leaderboard. Chaque configuration model × prompt est classée selon le coût par réponse correcte. Un graphique coût × précision et un classement « best value » figurent au-dessus du tableau.
Le coût provient des prix OpenRouter en direct : le harness les actualise depuis l'endpoint /models au début de chaque exécution. Il reflète le prix actuel, pas une valeur obsolète dans config.yaml.
Comment le lire. L'ordre est croissant : le gagnant est la ligne du haut, pas celle à la précision maximale. Sur le graphique, cherchez un modèle bon marché proche d'un modèle cher sur l'axe de précision : cet écart pour une fraction du coût justifie cette métrique.
Piège — meilleure précision ≠ gagnant. Une configuration légèrement moins précise mais beaucoup moins chère peut dépasser une configuration plus coûteuse. Consultez $/correct, pas seulement la précision.
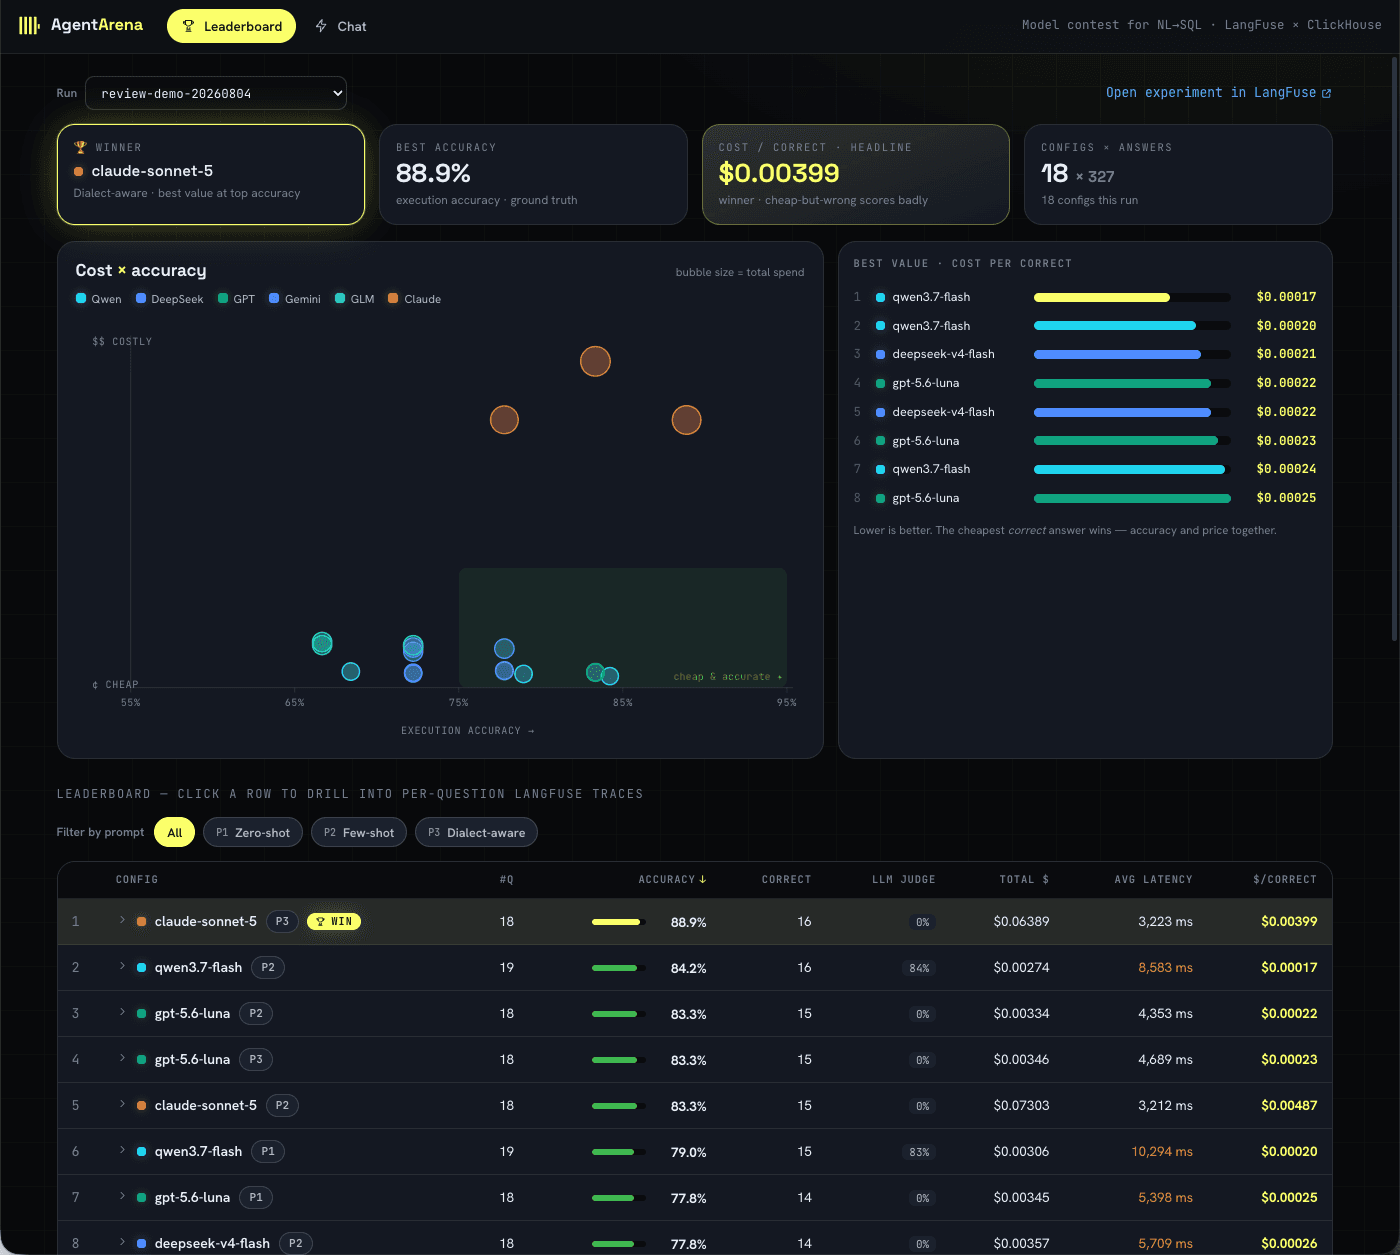
Le Leaderboard juxtapose qualité et prix. Le graphique coût × précision montre le compromis ; la liste best value et la colonne $/correct révèlent les configurations qui transforment le plus efficacement la dépense en bonnes réponses.
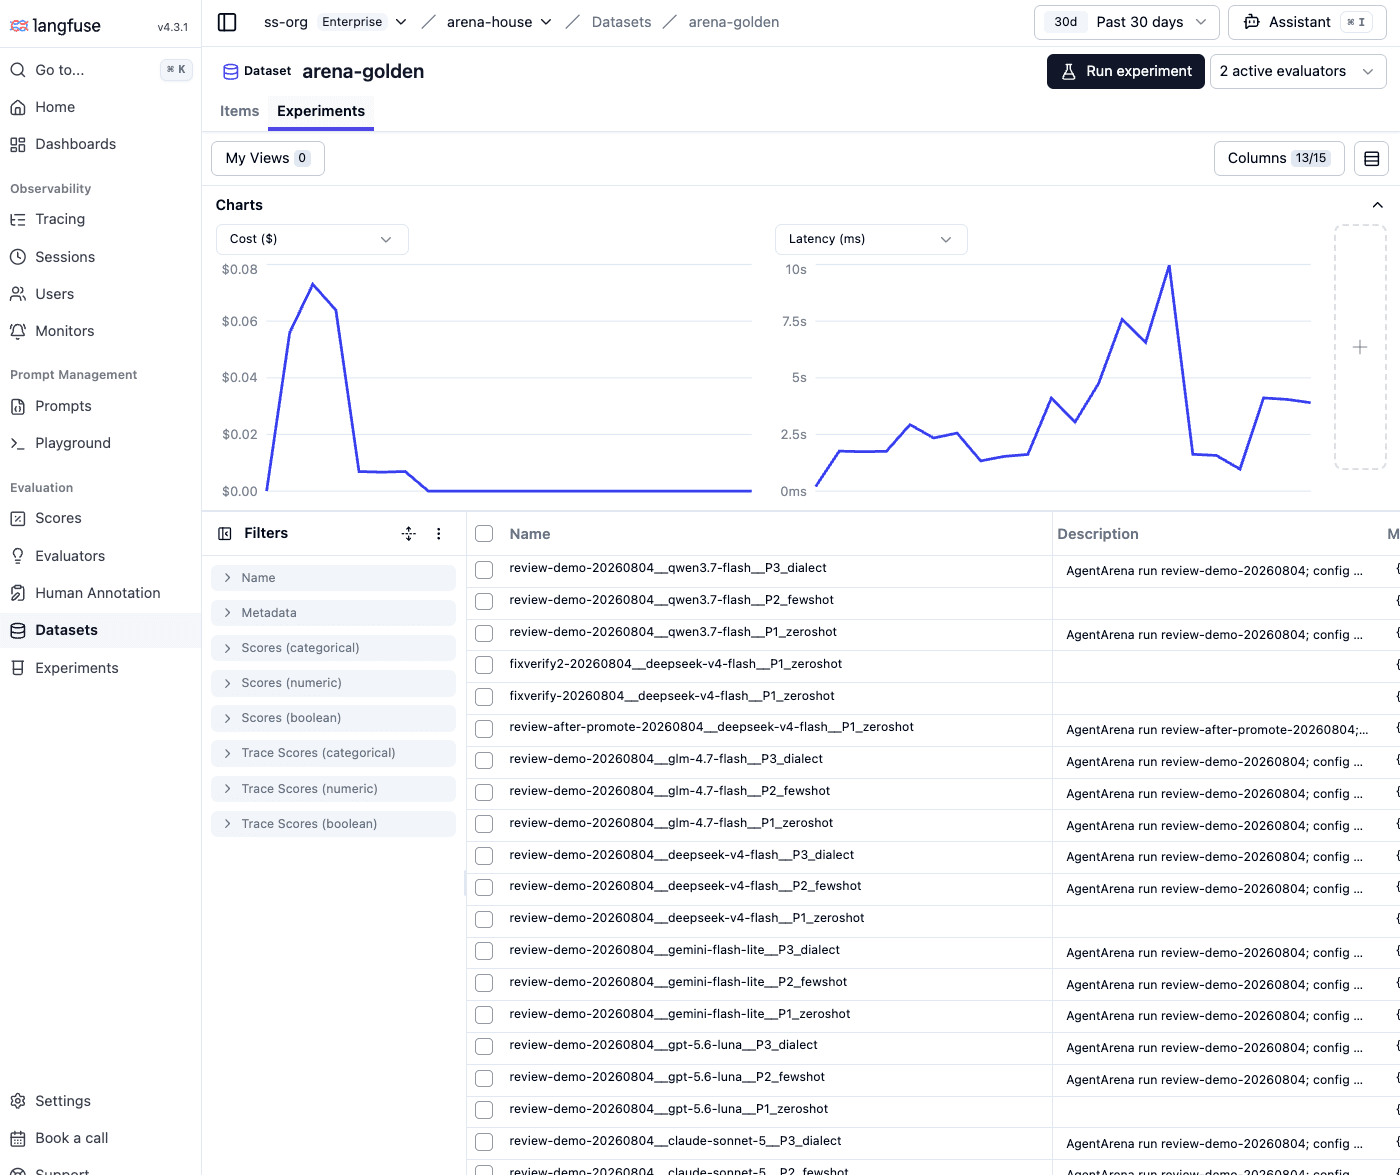
L'onglet Experiments de arena-golden contient un Dataset Run par configuration modèle × prompt. Les graphiques résument coût et latence sur les mêmes questions dorées ; chaque ligne est directement comparable.
La première ligne est votre gagnant : notez son config_id. Le Module 02 analyse sa qualité réelle, au-delà de sa victoire.
Comment vérifier que vous avez terminé
- Le Leaderboard montre au moins une ligne
model × promptavec un coût par réponse correcte. - Une configuration ouvre ses résultats par question, puis une question ouvre sa trace avec le SQL généré.
- Vous pouvez nommer le
config_id(<model>__<prompt>) couronné par l'Arena.
Exercice — prédire, puis vérifier
Avant d'ouvrir le vrai Leaderboard, notez une prédiction :
- À partir de la liste de modèles et du tableau des prompts seulement, devinez quelle configuration
model × promptgagnera. Notez sonconfig_idet une phrase de justification, par exemple « le modèle le moins cher avec le prompt de dialecte, car les échecs portent surtout sur le dialecte ». - Ouvrez le Leaderboard et vérifiez. Aviez-vous raison ?
- Dans tous les cas, un modèle moins cher a-t-il battu ou approché un modèle de pointe ? Si oui, cet écart — bon marché et presque aussi bon face à cher et à peine meilleur — est la raison du classement. Si la frontière gagne nettement, mesurez son avance sur la configuration moins chère suivante : cette marge justifierait son prix en production.
Récapitulatif
Vous disposez désormais de preuves, et non d'une supposition, sur le modèle et le prompt qui valent la peine d'être exécutés, classés par coût par réponse correcte et adossés à des traces Langfuse. Notez le config_id gagnant : vous l'utiliserez désormais partout.
État final
Un leaderboard classé et un config_id couronné. Passez à 02 Mesurer hors ligne pour comprendre la qualité réelle du gagnant.