02 Medir offline
Usa evaluators, datasets y trazas de Langfuse para saber hasta qué punto es bueno el ganador, por pregunta y nivel.
Punto de partida
Módulo 01 completado: la Arena se ha ejecutado, el Leaderboard contiene resultados y tienes un config_id ganador (<model>__<prompt>, por ejemplo, claude-sonnet-5__P1_zeroshot).
Por qué
Ganar la Arena demuestra que una configuración superó al resto en conjunto por coste por respuesta correcta. No explica cómo gana, dónde es más débil ni si su SQL es simplemente correcto o realmente bueno. Antes de publicarla y evaluar el tráfico de producción, conviene comprenderla; del mismo modo, querrías saber no solo que una persona superó una entrevista, sino qué preguntas dominó y cuáles aprobó por poco. Langfuse ya contiene todo lo necesario: los evaluators del Módulo 01 puntuaron cada elemento y cada uno tiene una traza completa. Este módulo consiste en leer esos detalles, no en producir datos nuevos.
Conceptos — bajo el capó
Traza → observaciones → puntuaciones. Langfuse estructura del mismo modo cada ejecución del agente:
- Una traza es una ejecución del agente: una combinación
model × prompt × question, llamadaagent_runy etiquetada con elconfig_id. - Las observaciones son los spans dentro de la traza. La única es
llm_call, una observación de tipo generation que contiene el prompt, la respuesta y el uso de tokens de la llamada al modelo. La salida del elemento de experimento registra el coste exacto de extremo a extremo y la latencia que usa el leaderboard. No existe una observación separada para la ejecución de SQL: se realiza como una llamada normal a ClickHouse sin span propio de Langfuse, y el SQL generado y su conjunto de resultados se guardan en la entrada y salida de la raíz. - Las puntuaciones son las que los evaluators del Módulo 01 asocian después a la traza o elemento de dataset:
correctness(precisión binaria de ejecución),agent-arena-llm-judge(calidad SQL graduada por un LLM-as-a-judge) y una categoríaoutcome. La definición del evaluator en Langfuse esllm_judge; la puntuación que emite y que espera el harness se llama exactamenteagent-arena-llm-judge.
Cada traza contiene un agent_run con una única observación hija, la generación llm_call, y las tres puntuaciones que asocian después los evaluators de Langfuse: correctness, agent-arena-llm-judge y outcome.
Niveles. El corpus fuente contiene 20 preguntas YAML, pero q019 y q020 son ejemplos few-shot reservados. En un proyecto limpio, cada una de las 18 preguntas experimentales de arena-golden tiene un tier del 1 (las más sencillas: recuentos y filtros de una sola tabla) al 5 (las más difíciles: joins de varias tablas, embudos y cálculos de margen). La precisión por nivel existe porque la cifra general de una configuración puede ocultar un desplome en el nivel 5 detrás de buenos resultados en los niveles 1 y 2.
Categorías de resultado. El Code Evaluator correctness de Langfuse (eval/langfuse_evaluators/correctness_evaluator.py) clasifica cada elemento de experimento completado en una de estas categorías, ordenadas según hasta dónde llegó la respuesta:
| Resultado | Qué significa |
|---|---|
correct | El conjunto de resultados coincide con el dorado. |
model_error | La llamada a OpenRouter falló antes de generar SQL (clave errónea o caducada, límite de solicitudes, interrupción del proveedor). |
sql_policy_rejected | agents/sqlguard.py bloqueó el SQL antes de llegar a ClickHouse (no era una única sentencia SELECT o contenía una palabra prohibida). |
sql_exec_error | El SQL llegó a ClickHouse, pero la consulta no se pudo ejecutar (sintaxis incorrecta, columna desconocida, etc.). |
empty_but_expected | La consulta se ejecutó y devolvió cero filas, pero la respuesta dorada contiene filas. |
wrong_result | La consulta devolvió filas, pero no coinciden con el conjunto de resultados dorado. |
Cada categoría exige una corrección distinta: sql_policy_rejected necesita un prompt de sistema más claro sobre el modo de solo lectura; sql_exec_error suele indicar una carencia de dialecto (consulta P3_dialect); empty_but_expected y wrong_result suelen señalar un error de filtro, join o agregación.
Objetivo
Saber interpretar la precisión por nivel y el desglose de resultados de la configuración ganadora, comprender qué aporta la señal secundaria agent-arena-llm-judge además de la corrección bruta y poder pasar de una fila del leaderboard a la traza exacta de Langfuse que respalda cualquier pregunta.
Paso 1 — Leer la precisión por nivel y el desglose de resultados
Abre http://localhost:5174 → Leaderboard y entra en la fila de la configuración ganadora. Además de precisión, latencia y coste por respuesta correcta, cada configuración muestra:
- Precisión por nivel — las preguntas de
arena-goldense agrupan por dificultad. Una configuración sólida en conjunto puede ser inestable en el nivel más difícil, justo el tipo de carencia que oculta una cifra agregada. - Desglose de resultados — no todas las respuestas incorrectas fallan igual. Algunas consultas son rechazadas por el sandbox, otras producen un error de ClickHouse, devuelven un resultado vacío o simplemente un conjunto equivocado. Cada problema necesita una solución distinta.
Cómo interpretarlo. La precisión por nivel aparece como una pequeña tabla o conjunto de barras con una fila por nivel del 1 al 5. Busca de derecha a izquierda dónde cae la cifra: una configuración casi perfecta en los niveles 1 y 2 que se desploma en el 4 o 5 maneja bien las búsquedas sencillas, pero tiene dificultades con joins y agregaciones de varios pasos. El desglose cuenta cada categoría (correct, sql_policy_rejected, sql_exec_error, empty_but_expected, wrong_result): muchos sql_exec_error apuntan al dialecto, mientras que muchos wrong_result apuntan a la lógica; requieren soluciones distintas.
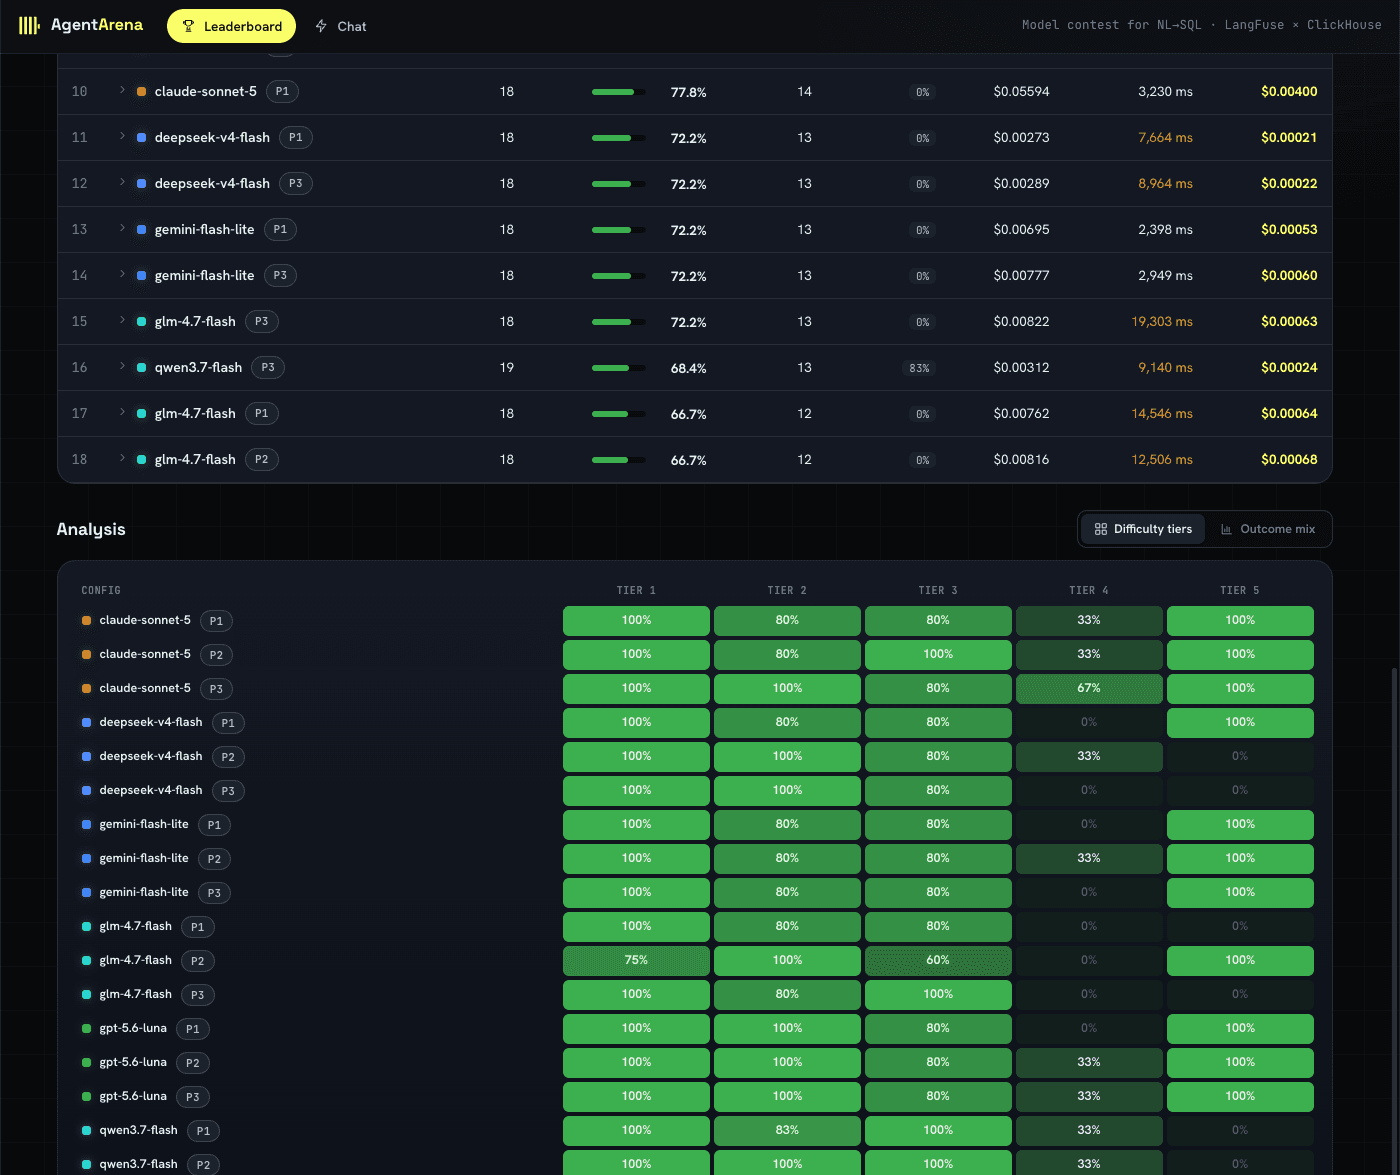
La vista Difficulty tiers revela patrones ocultos por la precisión general. En esta ejecución, la mayoría de las configuraciones son sólidas en los niveles 1–3, mientras que el 4 es la debilidad compartida más clara; compara filas para ver si la ganadora sufre la misma caída.
Paso 2 — Leer la señal secundaria agent-arena-llm-judge
La puntuación correctness es binaria: el conjunto coincide o no. agent-arena-llm-judge, emitida por la definición llm_judge que configuraste en el Módulo 01, es una señal secundaria más detallada: una valoración LLM-as-a-judge de la calidad SQL además del resultado binario. Una configuración puede ser correcta por precisión de ejecución y aun así escribir SQL que un revisor cuestionaría: una subconsulta innecesaria, una comparación frágil de fechas o un join que funciona con estos datos pero no generaliza. Usa agent-arena-llm-judge para detectar la diferencia entre «aprueba» y «está bien escrito».
Paso 3 — Analizar trazas individuales
Desde una fila del leaderboard, abre sus resultados por pregunta y selecciona una para ver la traza de Langfuse. Cada traza contiene todo el recorrido: el prompt enviado, el SQL generado, la generación llm_call (prompt, respuesta y uso de tokens), el coste exacto y la latencia de extremo a extremo del elemento de experimento y, si falló, el error devuelto por ClickHouse. Es la misma destreza de lectura de trazas que volverás a usar durante la investigación humana del Módulo 04, cuando las preguntas procedan de usuarios reales en vez del dataset dorado.
Elige dos o tres preguntas que la configuración ganadora respondió mal —o que recibieron una puntuación baja en agent-arena-llm-judge— y lee sus trazas de principio a fin. Busca un patrón: una formulación, un join o un filtro de fecha que el modelo maneje mal repetidamente.
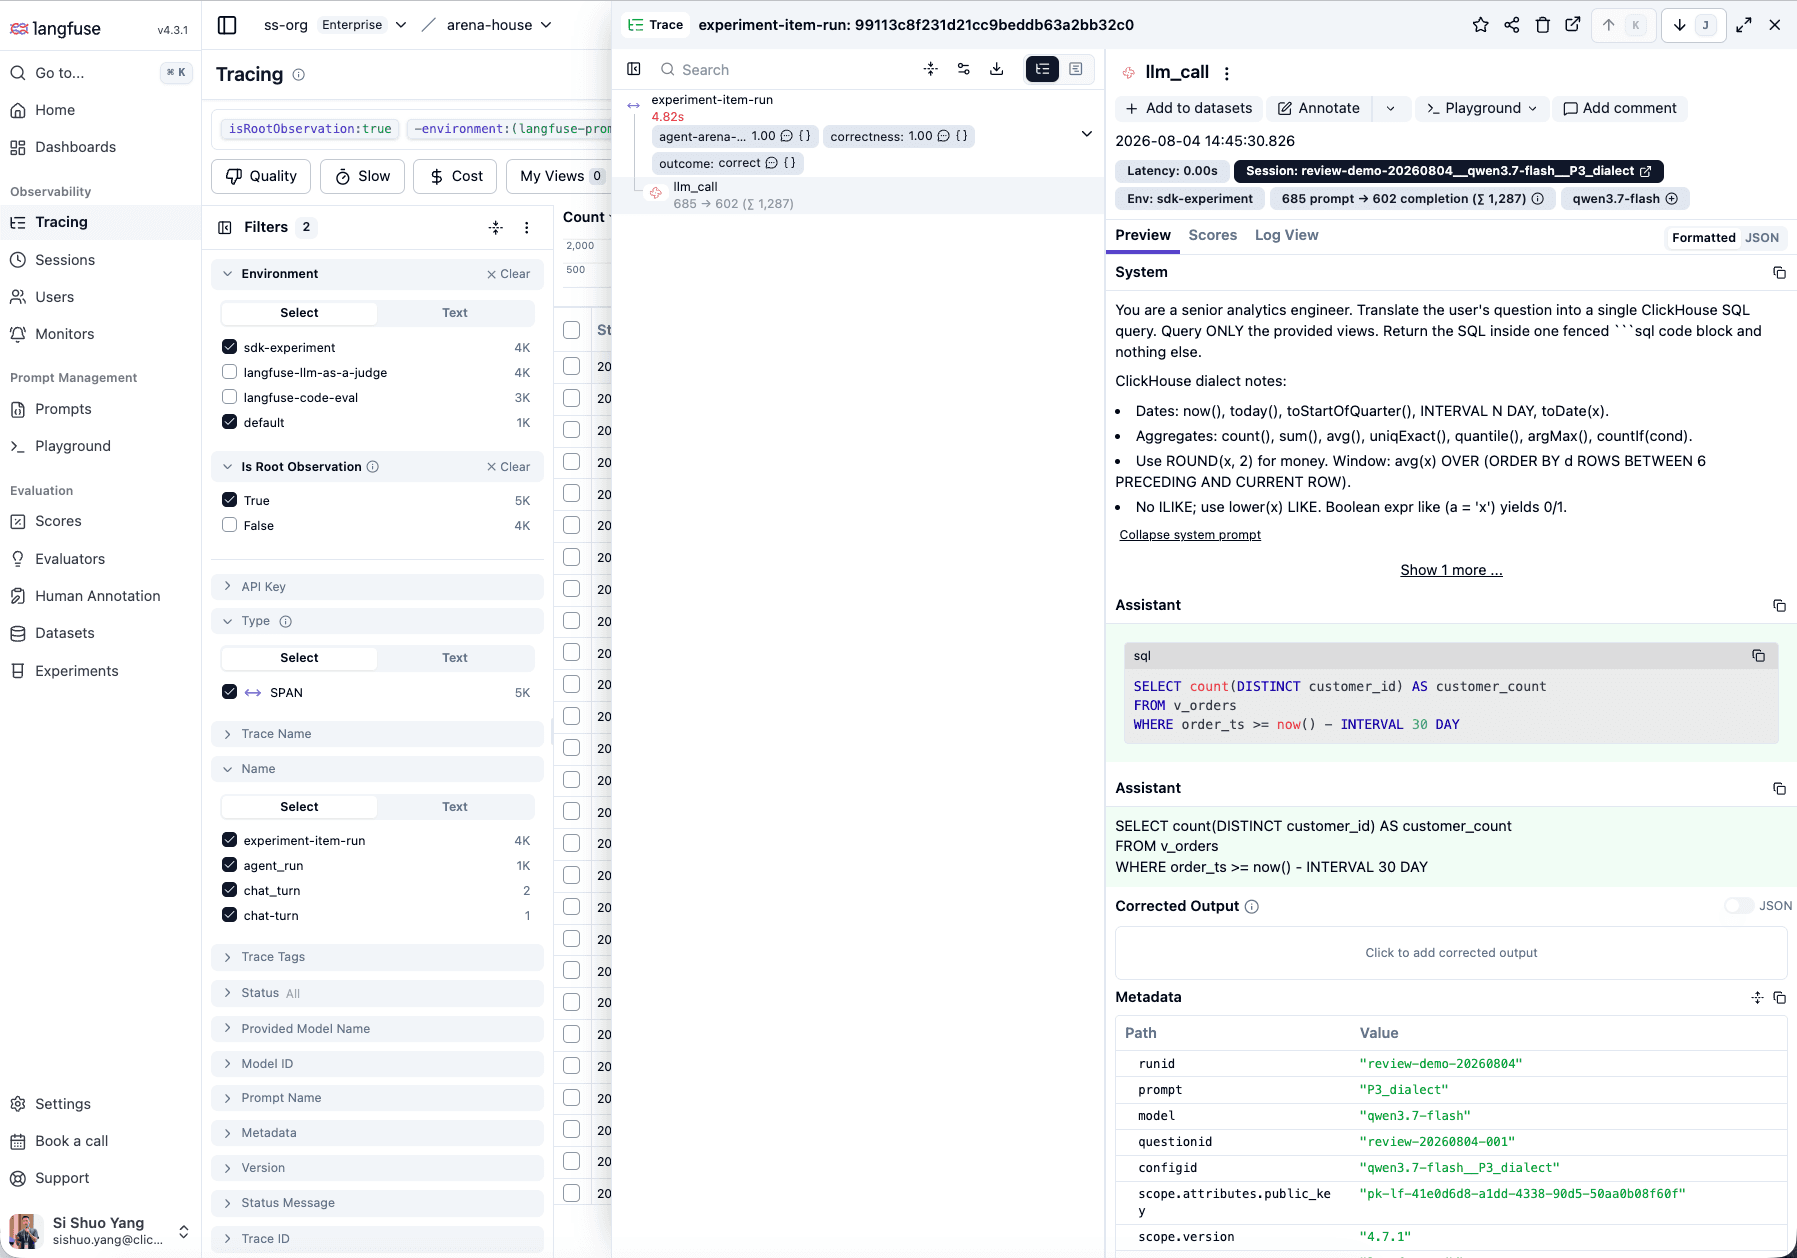
Un elemento de experimento de Langfuse conecta las puntuaciones de la parte superior de la traza con el llm_call exacto. El panel muestra el prompt, el SQL generado, el uso de tokens, la latencia y los metadatos necesarios para explicar por qué la pregunta se aprobó o falló.
Cómo verificar que has terminado
- Puedes indicar la precisión de la configuración ganadora en al menos un nivel concreto, no solo la cifra general.
- Puedes señalar al menos una pregunta en la que
correctnessyagent-arena-llm-judgediscrepen, o explicar por qué no lo hacen en tu ejecución. - Has abierto al menos una traza de Langfuse y puedes recorrer prompt → SQL generado → resultado o error.
Ejercicio — practicar el diagnóstico de trazas antes de publicar
Convierte la lectura de trazas del paso 3 en un artefacto escrito antes de publicar la configuración seleccionada en el Módulo 03:
-
En los resultados por pregunta de la configuración ganadora, elige 2 o 3 preguntas con
correctness = 0o una puntuación baja deagent-arena-llm-judge. -
Abre la traza de cada una y completa una fila de esta tabla:
Pregunta Qué generó Por qué falló Categoría de resultado (texto de la pregunta) (resumen del SQL producido) (tu interpretación: join equivocado, filtro de fecha ausente, formulación mal interpretada, …) ( sql_exec_error/wrong_result/ …) -
Busca en las 2 o 3 filas un patrón repetido: el mismo tipo de join, el mismo error de fechas o la misma formulación que el modelo interpreta mal. Lo que buscas es un patrón, no una lista de errores sin relación.
Conserva esta observación como contexto offline, pero no la trates como el incidente de producción. El Módulo 03 crea una nueva traza de producción marcada por feedback, y el Módulo 04 usa el método de lectura que has practicado para investigar ese incidente exacto.
Resumen
Ahora sabes no solo que tu configuración ganó, sino cómo: dónde es sólida, dónde es débil y qué aspecto tienen realmente sus fallos en las trazas. Ese detalle es justo lo que se convierte en acción a continuación.
Estado final
Una imagen detallada de la calidad de la configuración ganadora. Continúa con 03 Publicar y detectar para publicar la configuración seleccionada y capturar una discrepancia real entre el evaluator y la señal del usuario.
01 Seleccionar el modelo base
La Arena: ejecuta la cuadrícula de modelo × prompt como experimentos de Langfuse y corona a un ganador por coste por respuesta correcta.
03 Publicar y detectar
Publica el agente seleccionado con un punto ciego conocido de política y usa después la evaluación operativa y feedback real para detectarlo.