01 Seleccionar el modelo base
La Arena: ejecuta la cuadrícula de modelo × prompt como experimentos de Langfuse y corona a un ganador por coste por respuesta correcta.
Punto de partida
Módulo 00 completado: .env cargado, base de datos arena preparada, Langfuse conectado y dashboard local accesible en http://localhost:5174 con la pestaña Leaderboard vacía.
Por qué esta es la decisión fundamental
Todo el taller se apoya en esta decisión. Antes de publicar un agente serio, debes responder una pregunta fundamental: ¿qué modelo debe impulsarlo? Los modelos difieren enormemente en capacidad y precio, y la mejor elección depende de tu tarea concreta, no de una clasificación pública que otra persona ejecutó con una carga distinta. Adivinar sale caro en ambas direcciones: pagar de más por un modelo de frontera que no necesitas o publicar uno barato que se equivoca silenciosamente con tus preguntas reales.
En vez de adivinar, organizas una competición: la Arena. Una cuadrícula de modelos y estrategias de prompt responde a las mismas preguntas doradas, Langfuse puntúa cada respuesta como un experimento y la métrica que corona al ganador no es la precisión bruta, sino el coste por respuesta correcta: calidad por dólar para tu caso de uso. En concreto, este módulo responde con pruebas: ¿qué configuración de una cuadrícula de modelos y estrategias de prompt obtiene más respuestas correctas por dólar? «Correcta» significa precisión de ejecución: el SQL generado devuelve el mismo conjunto de resultados que el SQL dorado, no solo un SQL de aspecto plausible. La puntuación se realiza dentro de Langfuse, no dentro del harness. Langfuse aloja los evaluators y conserva cada elemento de experimento, puntuación y traza. El leaderboard local lee esos registros mediante la API pública de Langfuse. Todo lo que sigue —medir offline, publicar y detectar, investigar con una persona, y demostrar y monitorizar la mejora— presupone que has tomado esta decisión basándote en pruebas.
Conceptos — bajo el capó
Modelo de datos de Langfuse para esta evaluación. El corpus fuente del repositorio contiene 20 preguntas YAML. q019 y q020 son ejemplos few-shot reservados, por lo que en un proyecto limpio el dataset preparado (arena-golden) contiene 18 preguntas experimentales, cada una con su conjunto de resultados esperado. Cada configuración model × prompt que ejecutas constituye un experimento, es decir, un Dataset Run de Langfuse, sobre ese mismo dataset de 18 elementos. Así, todas las configuraciones se puntúan con exactamente las mismas preguntas. Las definiciones de evaluator que configuras en el paso 1 son correctness y llm_judge; las puntuaciones que emiten para los experimentos son correctness y agent-arena-llm-judge. Un dataset, muchos experimentos y una puntuación por elemento y experimento: eso permite comparar configuraciones en igualdad de condiciones.
Cada configuración de modelo × prompt se ejecuta como un experimento (Dataset Run) sobre el dataset arena-golden, y cada experimento asocia dos puntuaciones a cada elemento: correctness (0/1) y agent-arena-llm-judge (0..1).
Las estrategias de prompt también compiten. La cuadrícula no contiene solo modelos, sino model × prompt, porque importa tanto cómo preguntas como a quién. Según config.yaml y agents/prompts.py:
| Prompt | Qué hace | Por qué puede ayudar con NL→SQL |
|---|---|---|
P1_zeroshot | Solo esquema y pregunta; devuelve un bloque SQL delimitado. La referencia. | Es la opción más barata por llamada y mide lo que hace el modelo sin ayuda. |
P2_fewshot | P1 más dos ejemplos NL→SQL resueltos, reservados fuera del conjunto de prueba. | Muestra al modelo la forma esperada de una «buena» respuesta antes de escribirla. |
P3_dialect | P1 más una chuleta del dialecto de ClickHouse (funciones de fecha, uniqExact, argMax, INTERVAL, sin ILIKE, …). | Corrige el fallo más común: SQL fluido que no es SQL válido de ClickHouse. |
La selección: propietarios frente a pesos abiertos. Los seis participantes se dividen por igual según otro eje tan importante como el nombre del modelo: si sus pesos son cerrados (una API del proveedor que solo puedes invocar) o abiertos (un modelo que podrías alojar, ajustar o mantener dentro de tu propio perímetro de datos). Los modelos de pesos abiertos suelen ser mucho más baratos por token, mientras que los modelos propietarios de frontera pueden destacar en capacidad bruta; pero ese «pueden» es precisamente lo que la Arena prueba para tu tarea en vez de darlo por supuesto. Ejecutar ambos grupos con el mismo dataset dorado permite que el coste por respuesta correcta revele si necesitas pagar por un modelo de frontera o si uno barato y abierto resuelve la tarea por una fracción del precio. La selección es deliberadamente económica: NL→SQL es suficientemente sencillo para que incluso el participante más caro sea de nivel medio, no de frontera.
| Modelo | Proveedor | Abierto / Propietario | Alternativa orientativa ($/1M entrada · salida) |
|---|---|---|---|
claude-sonnet-5 | Anthropic | Propietario | $2.00 · $10.00 |
gpt-5.6-luna | OpenAI | Propietario | $0.50 · $3.00 |
gemini-flash-lite | Propietario | $0.30 · $2.50 | |
deepseek-v4-flash | DeepSeek | Pesos abiertos | $0.14 · $0.28 |
qwen3.7-flash | Qwen | Pesos abiertos | $0.03 · $0.13 |
glm-4.7-flash | Z.ai | Pesos abiertos | $0.06 · $0.40 |
Por qué coste por respuesta correcta y por qué precisión de ejecución. La corrección se decide mediante la precisión de ejecución: ¿al ejecutar el SQL generado se obtiene el mismo conjunto de resultados que con el SQL dorado? Es la señal honesta: no importa que ambas consultas sean distintas carácter por carácter, sino que respondan correctamente. La principal métrica de clasificación es:
cost_per_correct_answer = total cost of the run ($) / number of correct answersEsta métrica recompensa a un modelo casi igual de preciso pero mucho más barato frente a otro de frontera apenas mejor y mucho más caro: justo lo que optimizaría un equipo real consciente del coste.
Objetivo
Un Leaderboard con al menos varias configuraciones model × prompt clasificadas por coste por respuesta correcta, con cada posición respaldada por una traza de Langfuse que puedas inspeccionar, y un ganador coronado: un config_id.
Paso 1 — Configurar los evaluators de Langfuse (una vez)
Hazlo una sola vez siguiendo eval/langfuse_evaluators/README.md en el repositorio. Primero prepara arena-golden y configura mediante la API el juez respaldado por OpenRouter:
python -m scripts.provision_langfuse_evaluatorsDespués configura el evaluator de código determinista en la interfaz de Langfuse:
- Evaluator de código
correctness— Evaluators → Set up Evaluator → Code → pegaeval/langfuse_evaluators/correctness_evaluator.py→ Target: Experiments → filtra por dataset =arena-golden. Compara el conjunto de resultados del agente, tomado de la traza, con el conjunto dorado del elemento (expected_output) y emite una puntuación de precisión de ejecucióncorrectness(0/1), además de una categoríaoutcome. No tiene acceso de red: el SQL ya se ejecutó dentro del agente y el evaluator solo compara resultados. - Alternativa manual para la definición
llm_judge— Evaluators → Set up Evaluator → LLM-as-a-judge → Custom → usa los prompts de sistema y evaluación y los mapeos de variables deeval/langfuse_evaluators/llm_judge_prompt.md→ Target: Experiments, datasetarena-golden→ emite la puntuación numéricaagent-arena-llm-judge. La definición del evaluator y la puntuación emitida tienen nombres distintos de forma deliberada. Esta señal secundaria evalúa la calidad del SQL además de la corrección principal; la usarás en el Módulo 02.
El auxiliar es la ruta recomendada; el paso manual del juez es solo una alternativa. El evaluator de código determinista correctness sigue siendo una configuración única en la interfaz.
Paso 2 — Ejecutar la competición
source .env && python -m eval.harness --run-id demoQué debes ver. Primero, el harness muestra una línea de resumen (run_id=demo configs=6x3 ...) y después una línea por pregunta, por ejemplo:
claude-sonnet-5__P1_zeroshot q001 pending 812ms $0.00021Todas las filas empiezan como pending: el SQL se ejecutó y el conjunto de resultados se guardó en la traza, pero los evaluators de Langfuse aún no lo han puntuado. Cuando terminan todas las configuraciones, el harness pasa a esperar: grading via Langfuse evaluators — waiting on N traces...,
muestra una cuenta atrás mientras llegan las puntuaciones correctness/agent-arena-llm-judge,
y termina con Langfuse scored all N traces; leaderboard ready. El cambio de pendiente a puntuado representa la entrega de la puntuación a Langfuse; allí permanecen juntos el resultado y el veredicto como fuente de verdad del leaderboard.
Esto ejecuta toda la cuadrícula model × prompt —todos los modelos de config.yaml con todas las estrategias, de P1_zeroshot a P3_dialect— como Dataset Runs (Experiments) de Langfuse sobre el dataset arena-golden. El harness espera las puntuaciones exactas correctness y agent-arena-llm-judge para cada elemento. El coste exacto de OpenRouter y la latencia de extremo a extremo se almacenan en el mismo elemento de experimento.
Una configuración se representa como <model>__<prompt>, por ejemplo, claude-sonnet-5__P1_zeroshot. Los nombres disponibles proceden directamente de config.yaml:
- Modelos: los seis participantes de la tabla anterior: tres propietarios (
claude-sonnet-5,gpt-5.6-luna,gemini-flash-lite) y tres de pesos abiertos (deepseek-v4-flash,qwen3.7-flash,glm-4.7-flash). - Prompts:
P1_zeroshot,P2_fewshot,P3_dialect.
Indicadores útiles:
--models qwen3.7-flash,gpt-5.6-luna/--prompts P1_zeroshot,P3_dialect— limita la cuadrícula a un subconjunto CSV en vez de ejecutarla entera.--run-id <name>— etiqueta la ejecución para encontrarla fácilmente en el Leaderboard y en la vista Experiments de Langfuse.
El SDK puede procesar los elementos en orden inverso o concurrente; usa el ID de la pregunta de cada línea en vez de esperar el orden q001, q002, ... Una cuadrícula completa de 18 configuraciones suele tardar entre 35 y 45 minutos. En un taller, comienza con un subconjunto de dos modelos y un prompt; ejecuta la cuadrícula completa solo si el horario y los límites del proveedor lo permiten.
Los evaluators de Langfuse son obligatorios. Langfuse es ahora el único almacén de evaluación, por lo que no existe una alternativa de puntuación local ni de resultados en ClickHouse. Si el harness agota el tiempo de espera, corrige la configuración del paso 1 y usa un --run-id nuevo.
Paso 3 — Coronar al ganador
Abre http://localhost:5174 → Leaderboard. Todas las configuraciones model × prompt se clasifican por coste por respuesta correcta, la métrica principal. Sobre la tabla aparecen un gráfico de coste × precisión y una clasificación «best value».
El coste se calcula con los precios en vivo de OpenRouter: al comenzar cada ejecución, el harness actualiza los precios desde el endpoint /models de OpenRouter, por lo que el coste por respuesta correcta refleja lo que cuesta el modelo hoy, no una cifra obsoleta incluida en config.yaml.
Cómo interpretarlo. El orden es ascendente por coste por respuesta correcta; el ganador es la fila superior, no la de mayor precisión. En el gráfico de coste × precisión, busca un modelo barato cerca de otro caro en el eje de precisión: lograrlo por una fracción del coste es la razón de que usemos esta métrica y no una clasificación de precisión sencilla.
Problema — mayor precisión ≠ ganador. Es tentador mirar la columna de precisión y suponer que gana quien más puntúa. La Arena clasifica por coste por respuesta correcta, así que una configuración algo menos precisa y mucho más barata puede superar —y a menudo supera— a otra algo más precisa y cara. Comprueba la columna $/correct, no solo la precisión.
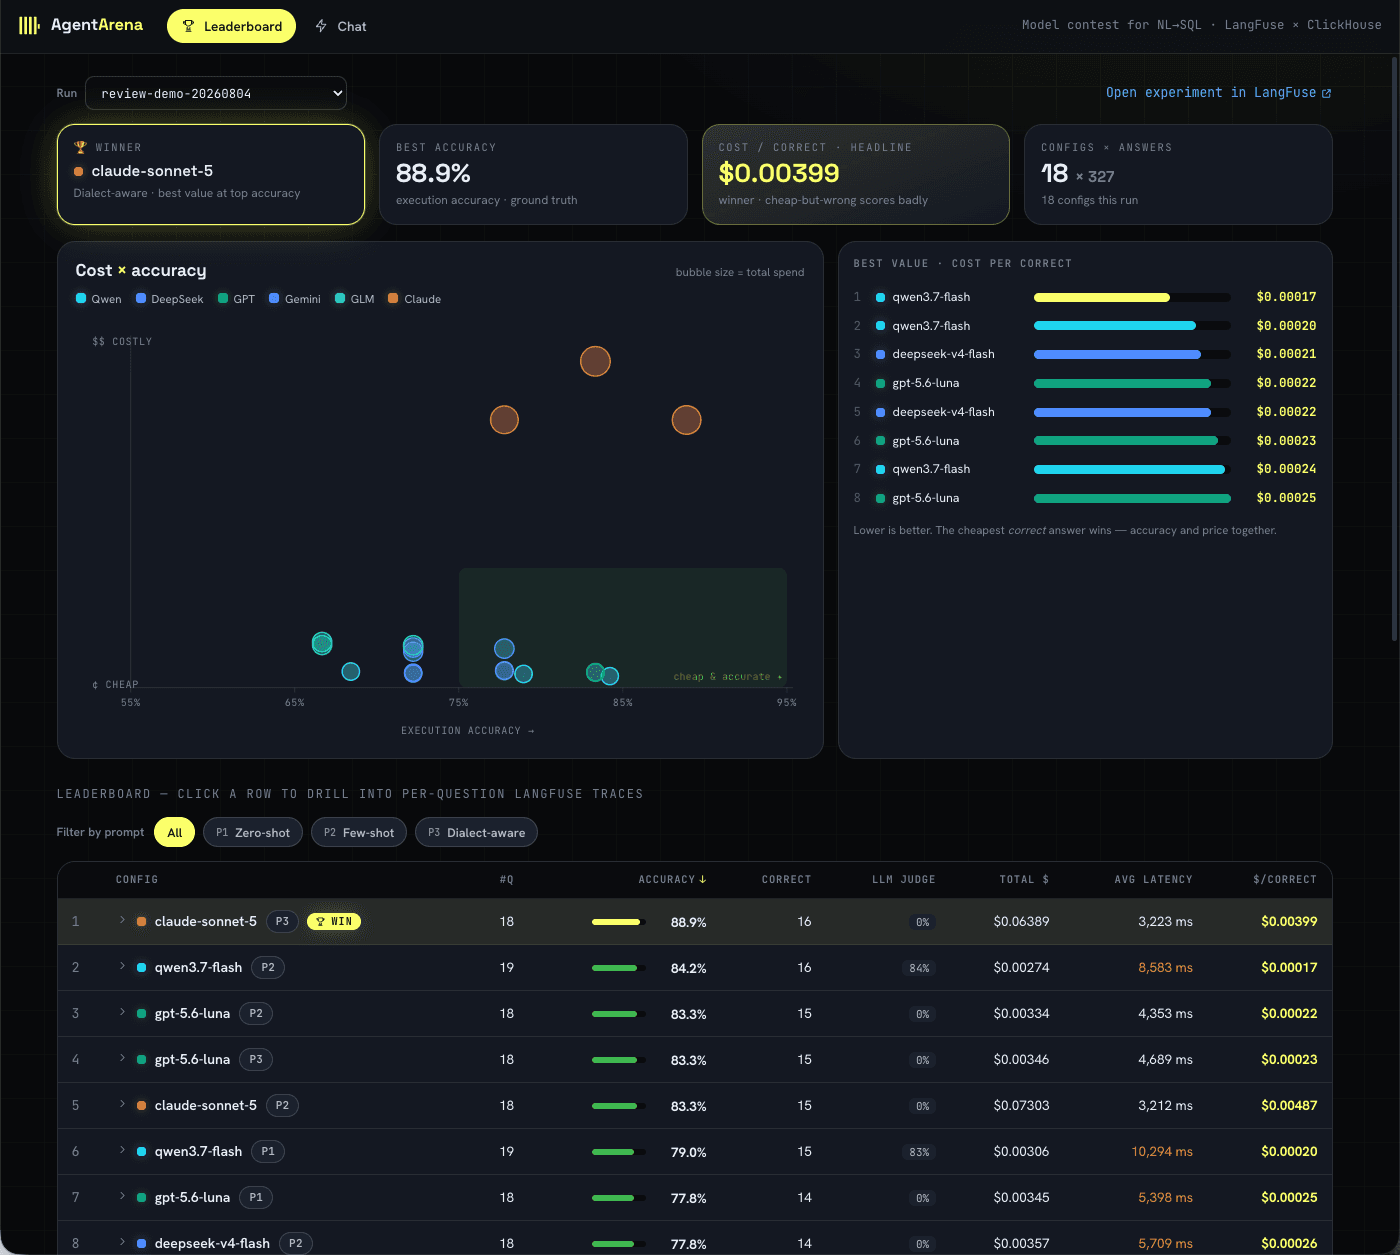
El Leaderboard muestra juntos calidad y precio. El gráfico de coste × precisión representa visualmente el equilibrio, y la lista «best value» y la columna $/correct muestran qué configuraciones convierten el gasto en respuestas correctas con más eficiencia.
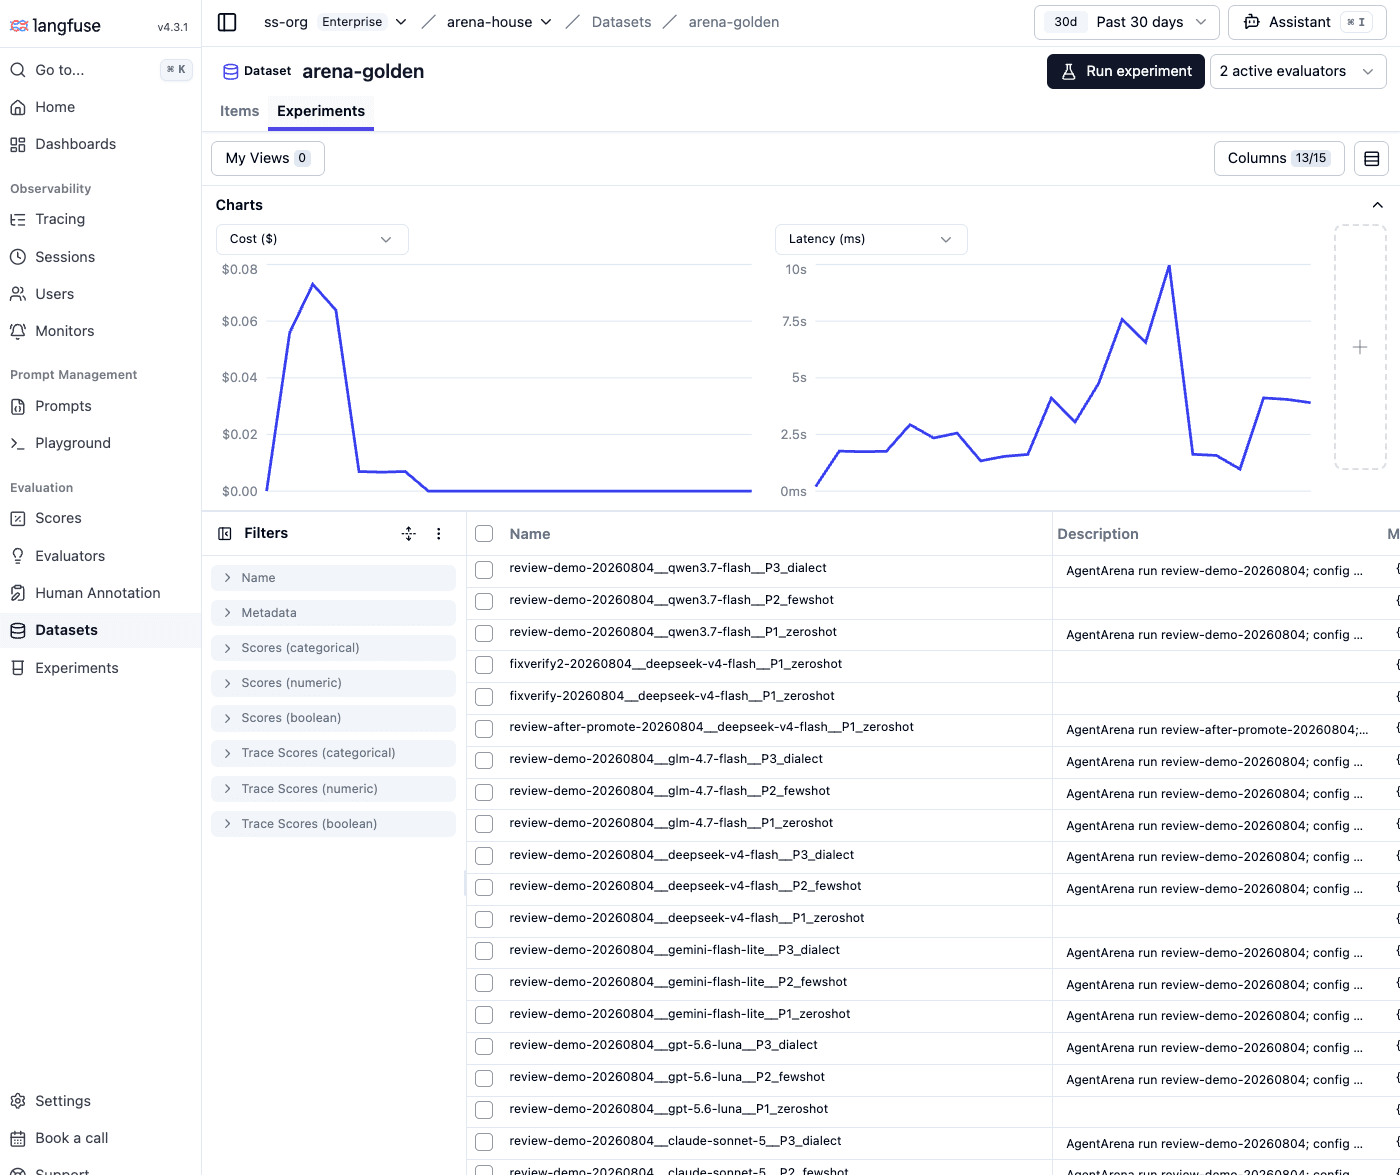
La pestaña Experiments de arena-golden en Langfuse contiene un Dataset Run por configuración de modelo × prompt. Los gráficos resumen coste y latencia sobre las mismas preguntas doradas, así que las filas son directamente comparables.
La fila superior es tu ganadora: anota su config_id. El Módulo 02 profundiza en su calidad real, no solo en el hecho de que ganó.
Cómo verificar que has terminado
- La tabla del Leaderboard muestra al menos una fila
model × promptcon un valor de coste por respuesta correcta. - Al hacer clic en una configuración aparecen los resultados por pregunta, y al abrir una pregunta se muestra su traza de Langfuse con el SQL generado.
- Puedes nombrar el
config_id(<model>__<prompt>) que la Arena coronó ganador.
Ejercicio — predecir y después verificar
Antes de abrir el Leaderboard real, haz una predicción y anótala:
- Basándote solo en la lista de modelos y la tabla de prompts, no en el Leaderboard, adivina qué configuración
model × promptganará por coste por respuesta correcta. Escribe elconfig_idy una frase que explique por qué (por ejemplo, «el modelo más barato con el prompt de dialecto, porque la mayoría de fallos son del dialecto y no de razonamiento»). - Abre el Leaderboard y compruébalo. ¿Acertaste?
- Sea cual sea el resultado, responde: ¿un modelo barato superó o se acercó a uno de frontera? Si es así, esa diferencia —barato y casi igual de bueno frente a caro y ligeramente mejor— es la razón para clasificar por coste por respuesta correcta y no por precisión bruta. Si ganó claramente uno de frontera, anota cuánto superó a la siguiente configuración más barata: ese margen justificaría su precio en una decisión real de publicación.
Resumen
Ahora tienes pruebas, no una suposición, de qué modelo y estrategia de prompt merece la pena ejecutar, clasificados por coste por respuesta correcta y respaldados por trazas de Langfuse. Anota el config_id ganador; lo usarás en todos los módulos siguientes.
Estado final
Un leaderboard clasificado y un config_id ganador. Continúa con 02 Medir offline para descubrir hasta qué punto es bueno el ganador.