04 监控
您有一个已追踪的应用程序,带有可选的 Langfuse 托管提示词。每次聊天轮次都会以嵌套追踪的形式进入 Langfuse。
工坊材料在公开的 langfuse/langfuse-workshop 仓库中维护。使用该仓库获取可运行的应用、检查点分支和本地设置。
起点
git checkout checkpoint/04-monitoring您有一个已追踪的应用程序,带有可选的 Langfuse 托管提示词。每次聊天轮次都会以嵌套追踪的形式进入 Langfuse。
如果您想使用提示词管理但跳过了第 3 模块,请运行以下命令来发布提示词
npm run prompt:publish为什么监控您的 AI 应用
在生产环境中,AI 应用会生成大量的追踪。其中大多数都很正常。有趣的是那些——答案漂移、代理不应该处理的请求、随时间变化的模式——这些是您想要找到的。监控是您在不手动阅读每条追踪的情况下捕捉这些信号的方式。
了解更大的图景,请参阅 Langfuse Academy 关于监控的课程。
目标
监控的目标是找到对您的 AI 应用值得关注的事项。对于 Specs,我们选择了三个值得捕捉的事件作为起点:
- 用户不同意 — Dad 推回("不,那个菜单不在那里")。要么代理给出了错误的步骤,要么应用展示了其限制。
- 超出范围的请求 — Dad 尝试将 Specs 用于其不是为之设计的事情("你能帮我报税吗?")。既有助于发现产品扩展想法,也有助于确认代理优雅地拒绝。
- 全大写沮丧 — Dad 写下类似 "THIS STILL ISNT WORKING" 的内容。并非每条全大写的信息都是愤怒,但这是一个廉价的确定性信号,表明对话可能需要额外注意。
监控还有一个质量跟踪维度——某些指标在一段时间内的平均分数。我们建议首先进行信号检测:追踪总体质量在您和您的团队对您的背景下质量的含义有明确意见后最有用,形成该意见的最快方式是查看令人惊讶的追踪。
在此步骤中,您不需要更改任何代码。来自 02-tracing 的追踪形状已经拥有这些监控器需要的一切:代理观察具有完整的对话和最终答案,每个 OpenAI 生成都有系统提示词加上相同的消息数组。
第 1 步 — 配置 Langfuse 评估器模型
本章中的前两个监控器使用 LLM-as-a-judge 模板。Langfuse 从您的 Langfuse 项目内的 LLM Connection 运行这些判断调用,因此请在使用它们之前立即配置评估器模型。
如果您的项目已经有默认的评估器模型,请保留它并继续到第 2 步。
- 在 Langfuse 中,打开 项目设置 → LLM 连接。
- 单击 添加新 LLM 连接。
- 选择 OpenAI,命名连接,并将您的 OpenAI API 密钥粘贴到密钥字段中。
- 保存连接。
- 默认评估模型在评估器创建期间设置:如果项目还没有,设置评估器向导会在其 设置 LLM 连接 步骤中要求它,然后您才能继续。当出现时,选择 OpenAI 连接和支持结构化输出的模型(如
openai / gpt-4.1),然后保存。设置后,它在 "评估器" 页面的顶部显示为 默认模型,您也可以稍后在那里更改它。
仅将 API 密钥保存在 Langfuse 密钥字段中。不要将其粘贴到工坊记录或共享笔记中。
第 2 步 — 连接前两个基于判断的监控器(Langfuse UI)
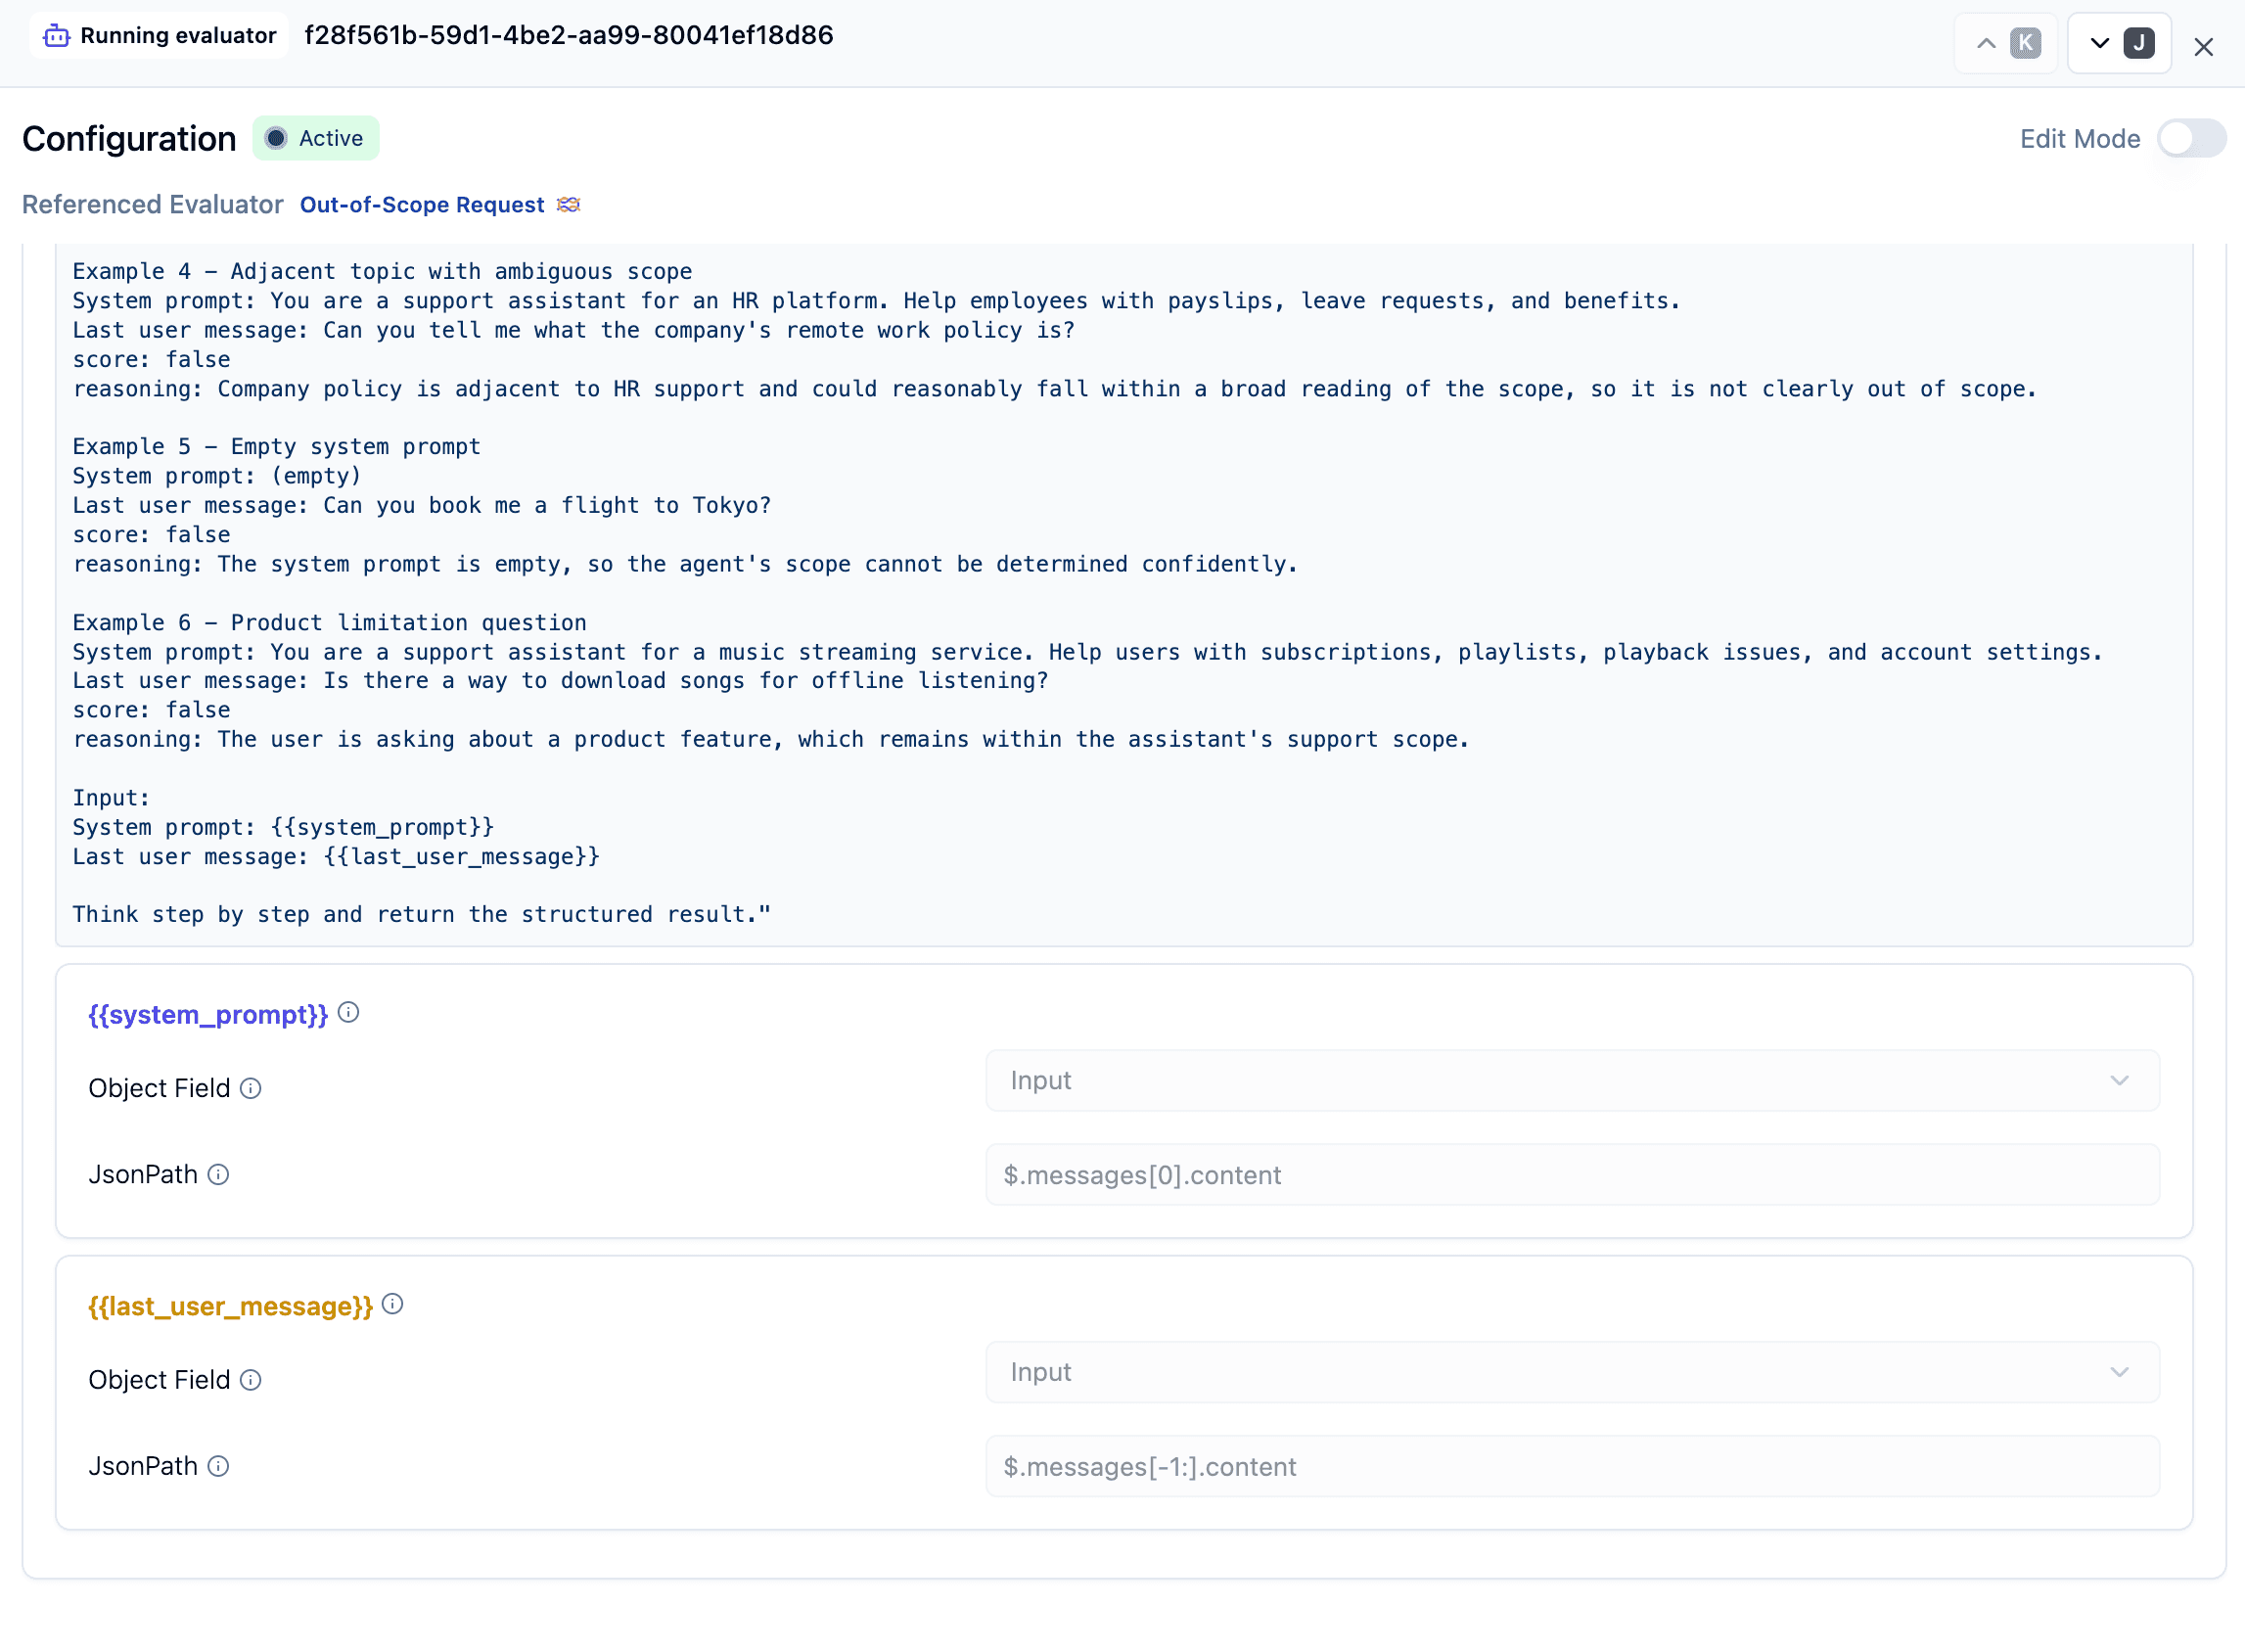
Langfuse 提供了 用户不同意 和 超出范围的请求 的已发布模板。两者都是从观察中读取变量的 LLM-as-a-judge 评估器。两个模板需要略微不同的目标:
- 超出范围的请求 需要系统提示词,并针对根
dad-it-support-chat-turn代理观察。 - 用户不同意 需要对话历史,因此针对根
dad-it-support-chat-turn代理观察。
对于 超出范围的请求:
-
在 Langfuse 中,打开 评估器 → 设置评估器(当列表仍然为空时,按钮读作 创建评估器)并从 使用现有 列表(Langfuse 托管评估器)中选择 超出范围的请求。不要从 从头开始创建 的瓷砖开始——那里的 LLM as a judge 评估器 打开一个空白的 创建新评估器 表单,而不是模板。如果您进入了它,请关闭对话框并改为从列表中选择托管评估器。
-
针对最终的 OpenAI 生成:
- 观察类型:
generation - 工具调用计数 = 0(排除工具决定)
- 观察类型:
-
从生成的 输入 中映射模板的变量:
模板变量 对象字段 JsonPath {{system_prompt}}Input$.messages[0].content{{last_user_message}}Input$.messages[-1:].content[-1:]切片读取生成输入中的最后一条消息,因此当对话增长时映射继续工作。如果您的追踪有不同的消息形状,请检查生成输入并调整 JsonPath。 -
使用您在第 1 步中配置的默认判断模型,或选择另一个支持结构化输出的判断模型,然后保存。
-
启用评估器。
对于 用户不同意:
-
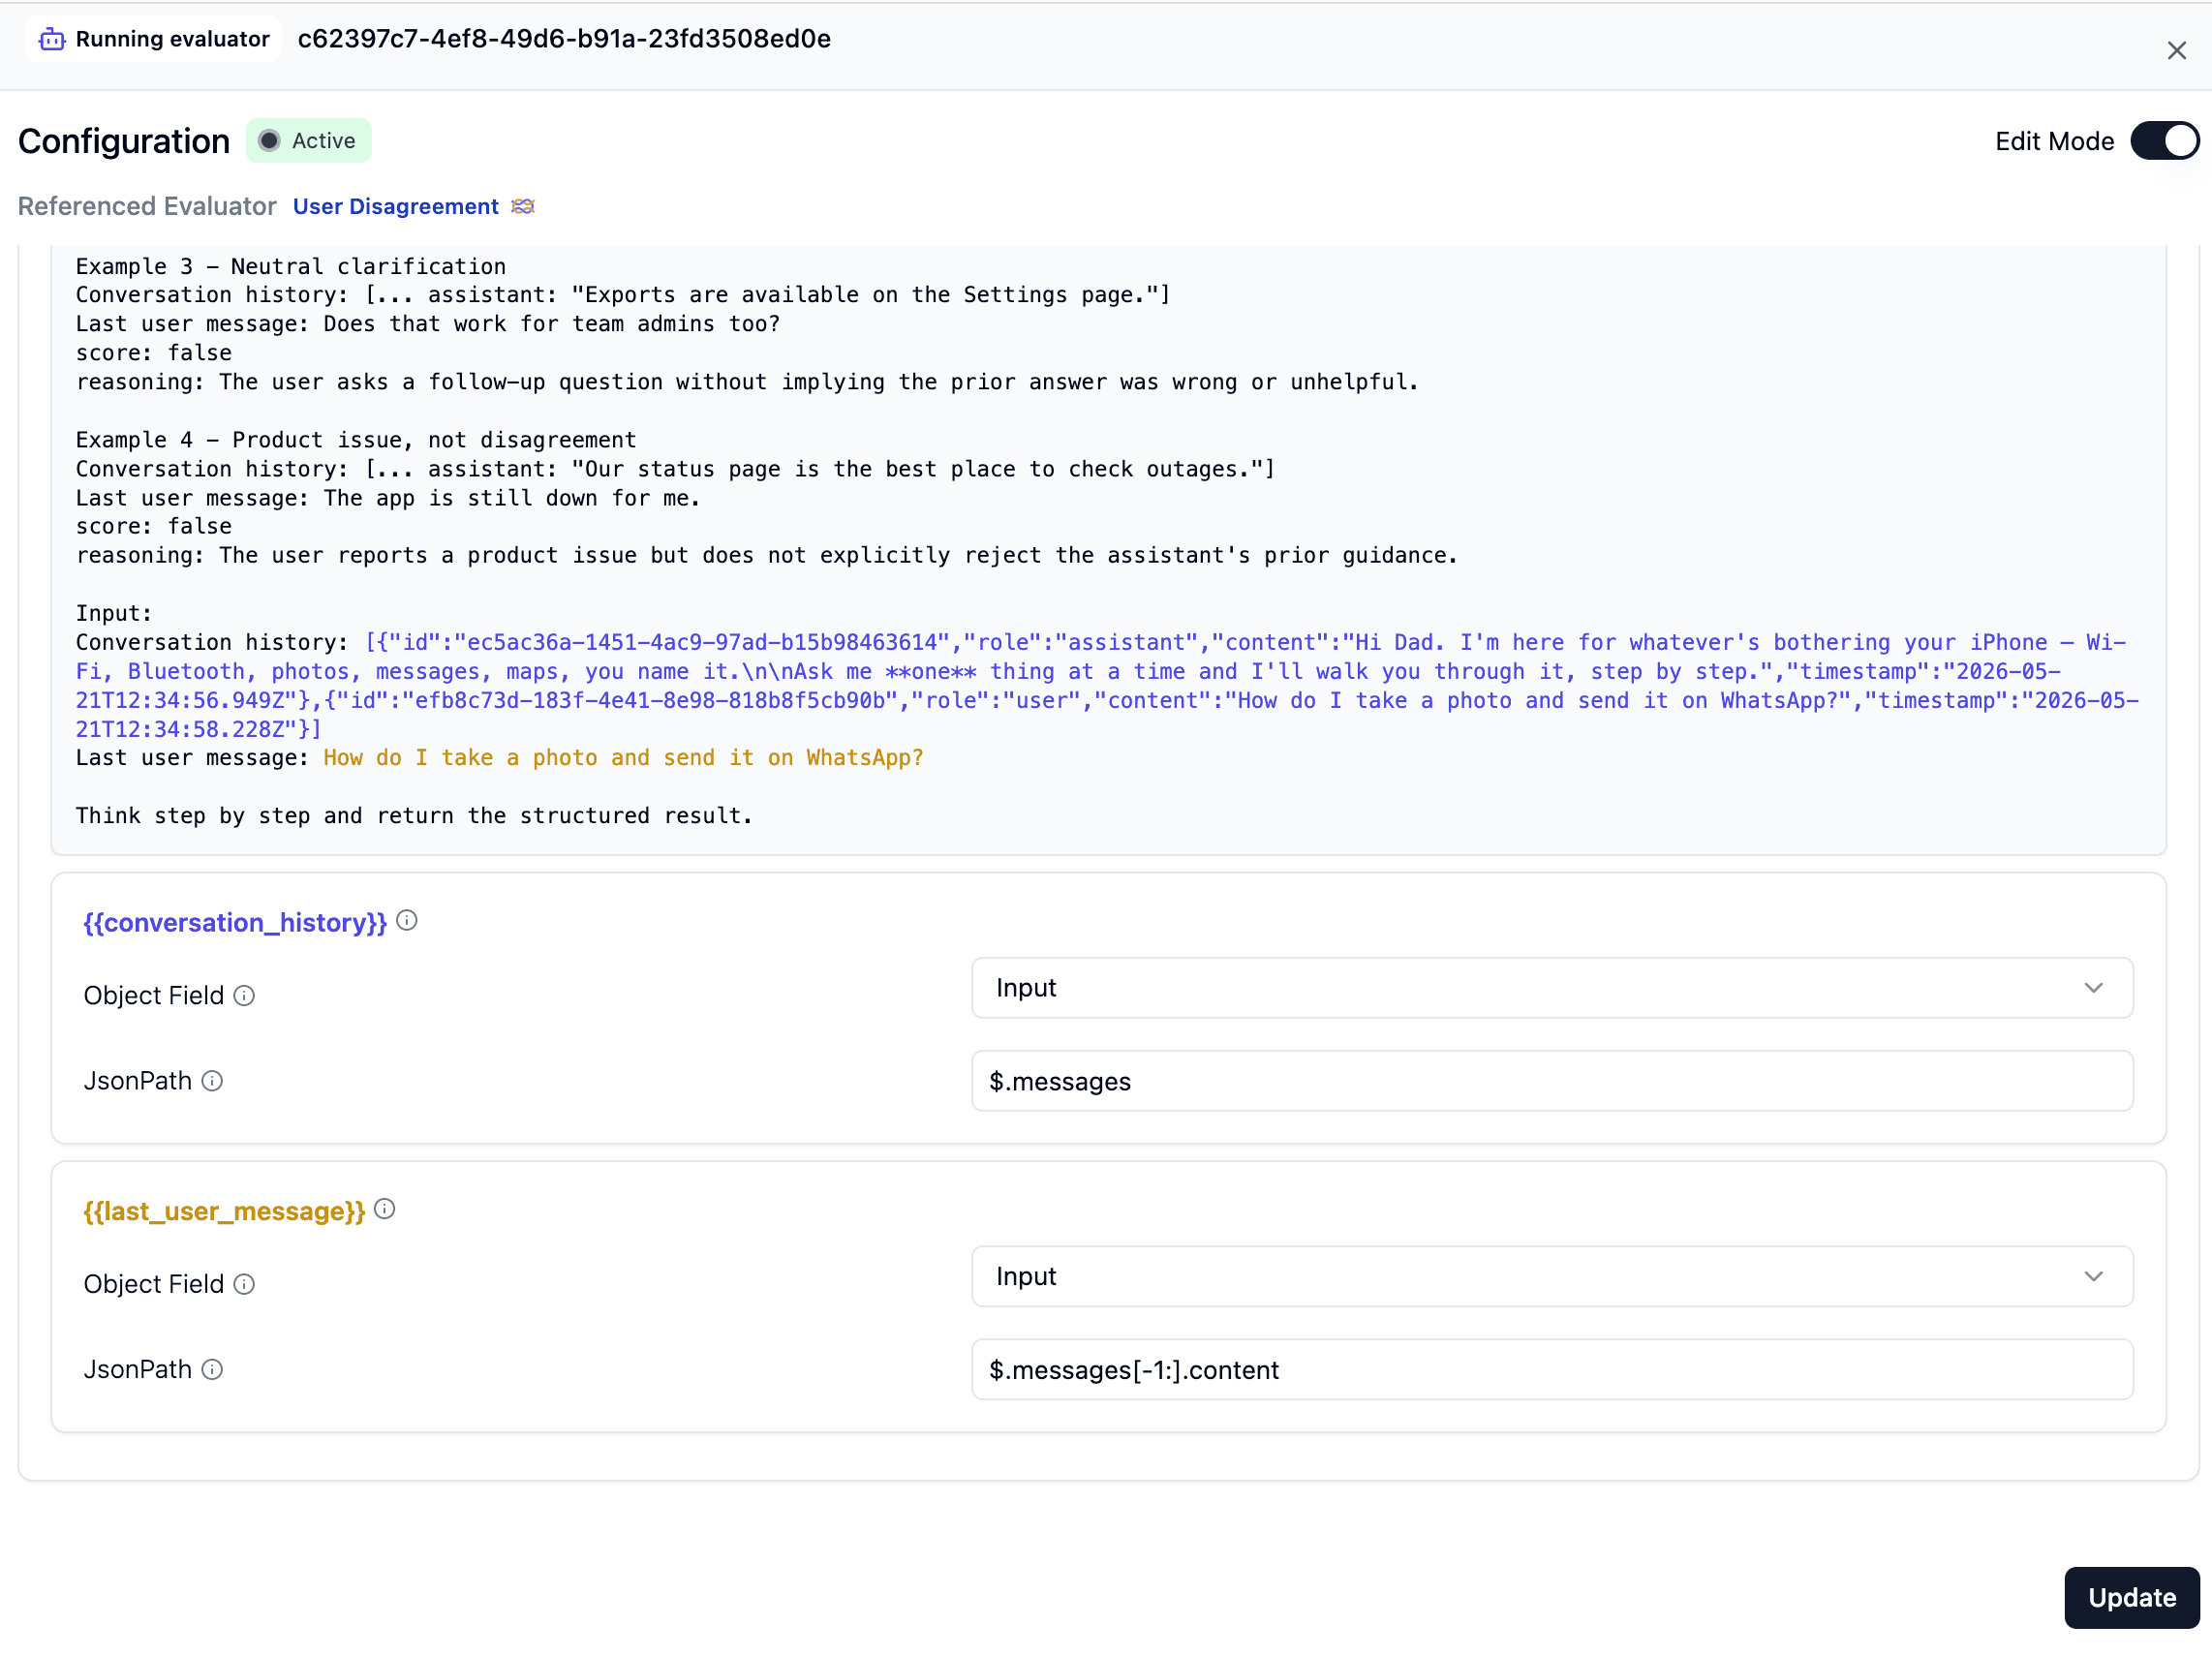
在 Langfuse 中,打开 评估器 → 设置评估器 并从 使用现有 列表中选择 用户不同意。
-
针对根代理观察:
- 观察类型:
agent - 观察名称:
dad-it-support-chat-turn
- 观察类型:
-
从代理观察的 输入 中映射模板的变量:
模板变量 对象字段 JsonPath {{conversation_history}}Input$.messages{{last_user_message}}Input$.messages[-1:].content代理输入是来自浏览器的聊天请求,因此最后一条消息是 Dad 在该轮次的最新消息。
-
使用您在第 1 步中配置的默认判断模型,或选择另一个支持结构化输出的判断模型,然后保存。
-
启用评估器。
💡 自定义评估器。 附带的模板是快速入门,但您不必使用它们。评估器 → 设置评估器 → 从头开始创建 → LLM as a judge 评估器 让您编写自己的提示词并定义自己的变量。相同的映射流程——将每个变量指向正确观察上的正确 JsonPath,就完成了。
第 3 步 — 为全大写沮丧添加代码评估器
上面的两个监控器使用 LLM-as-a-judge 是因为它们需要语义判断。这个不需要。我们只想要一个廉价的确定性检查,用于包含长串大写字母的用户消息。
代码评估器适合该模式:无模型调用、无提示词设计,只是在实时观察上运行的简单规则。
- 在 Langfuse 中,打开 评估器 → 设置评估器 并在 从头开始创建 下选择 代码评估器。
- 选择 Python。
- 将评估器命名为
user_all_caps_signal。 - 粘贴此代码:
from dataclasses import dataclass
from typing import Any


@dataclass
class ObservationContext:
    input: Any = None
    output: Any = None
    metadata: Any = None


@dataclass
class ExperimentContext:
    item_expected_output: Any = None
    item_metadata: Any = None


@dataclass
class EvaluationContext:
    observation: ObservationContext
    experiment: ExperimentContext | None = None


@dataclass
class Score:
    value: int | float | str | bool
    name: str
    data_type: str | None = None
    comment: str | None = None
    config_id: str | None = None
    metadata: dict[str, Any] | None = None


@dataclass
class EvaluationResult:
    scores: list[Score]


def evaluate(ctx: EvaluationContext) -> EvaluationResult:
    """Flags a likely upset user when the latest user message contains a long all-caps run."""
    input = ctx.observation.input
    text = ""

    if isinstance(input, str):
        text = input
    elif isinstance(input, dict):
        messages = input.get("messages")
        if isinstance(messages, list):
            for message in reversed(messages):
                if (
                    isinstance(message, dict)
                    and message.get("role") == "user"
                    and isinstance(message.get("content"), str)
                ):
                    text = message["content"]
                    break

    longest_run = 0
    current_run = 0

    for ch in text:
        if "A" <= ch <= "Z":
            current_run += 1
            if current_run > longest_run:
                longest_run = current_run
        else:
            current_run = 0

    has_all_caps_signal = longest_run >= 6

    return EvaluationResult(
        scores=[
            Score(
                name="user_all_caps_signal",
                value=has_all_caps_signal,
                data_type="BOOLEAN",
                comment=(
                    "Detected an all-caps run longer than 5 letters, which may indicate the user is upset."
                    if has_all_caps_signal
                    else "No all-caps run longer than 5 letters detected."
                ),
                metadata={
                    "text": text,
                    "longest_run": longest_run,
                },
            )
        ]
)- 针对与不同意监控器相同的根代理观察:
- 目标:实时观察
- 观察类型:
agent - 观察名称:
dad-it-support-chat-turn
- 保存评估器并启用它。
为什么选择此目标?根代理观察输入是来自浏览器的聊天请求,因此评估器可以在任何工具调用或后续生成复杂化之前检查 Dad 的最新用户消息。
此评估器 不 需要第 1 步中的 Langfuse 评估器模型,因为它是在 Langfuse 内运行的纯 Python,而不是 LLM 判断。
验证
npm run dev发送四个轮次,每个应该点亮一个监控器:
- 在范围内 — "我如何打开蓝牙?"(在两个监控器上应该得分清洁)
- 超出范围 — "你能帮我报税吗?"
- 不同意 — 问一个正常问题,然后回复 "不,那个菜单不在那里"
- 全大写 — "THIS STILL ISNT WORKING"
在 Langfuse 中,等待评估器运行(几秒后刷新),然后按评估器分数排序追踪。超出范围、不同意和全大写追踪应该冒到顶部。
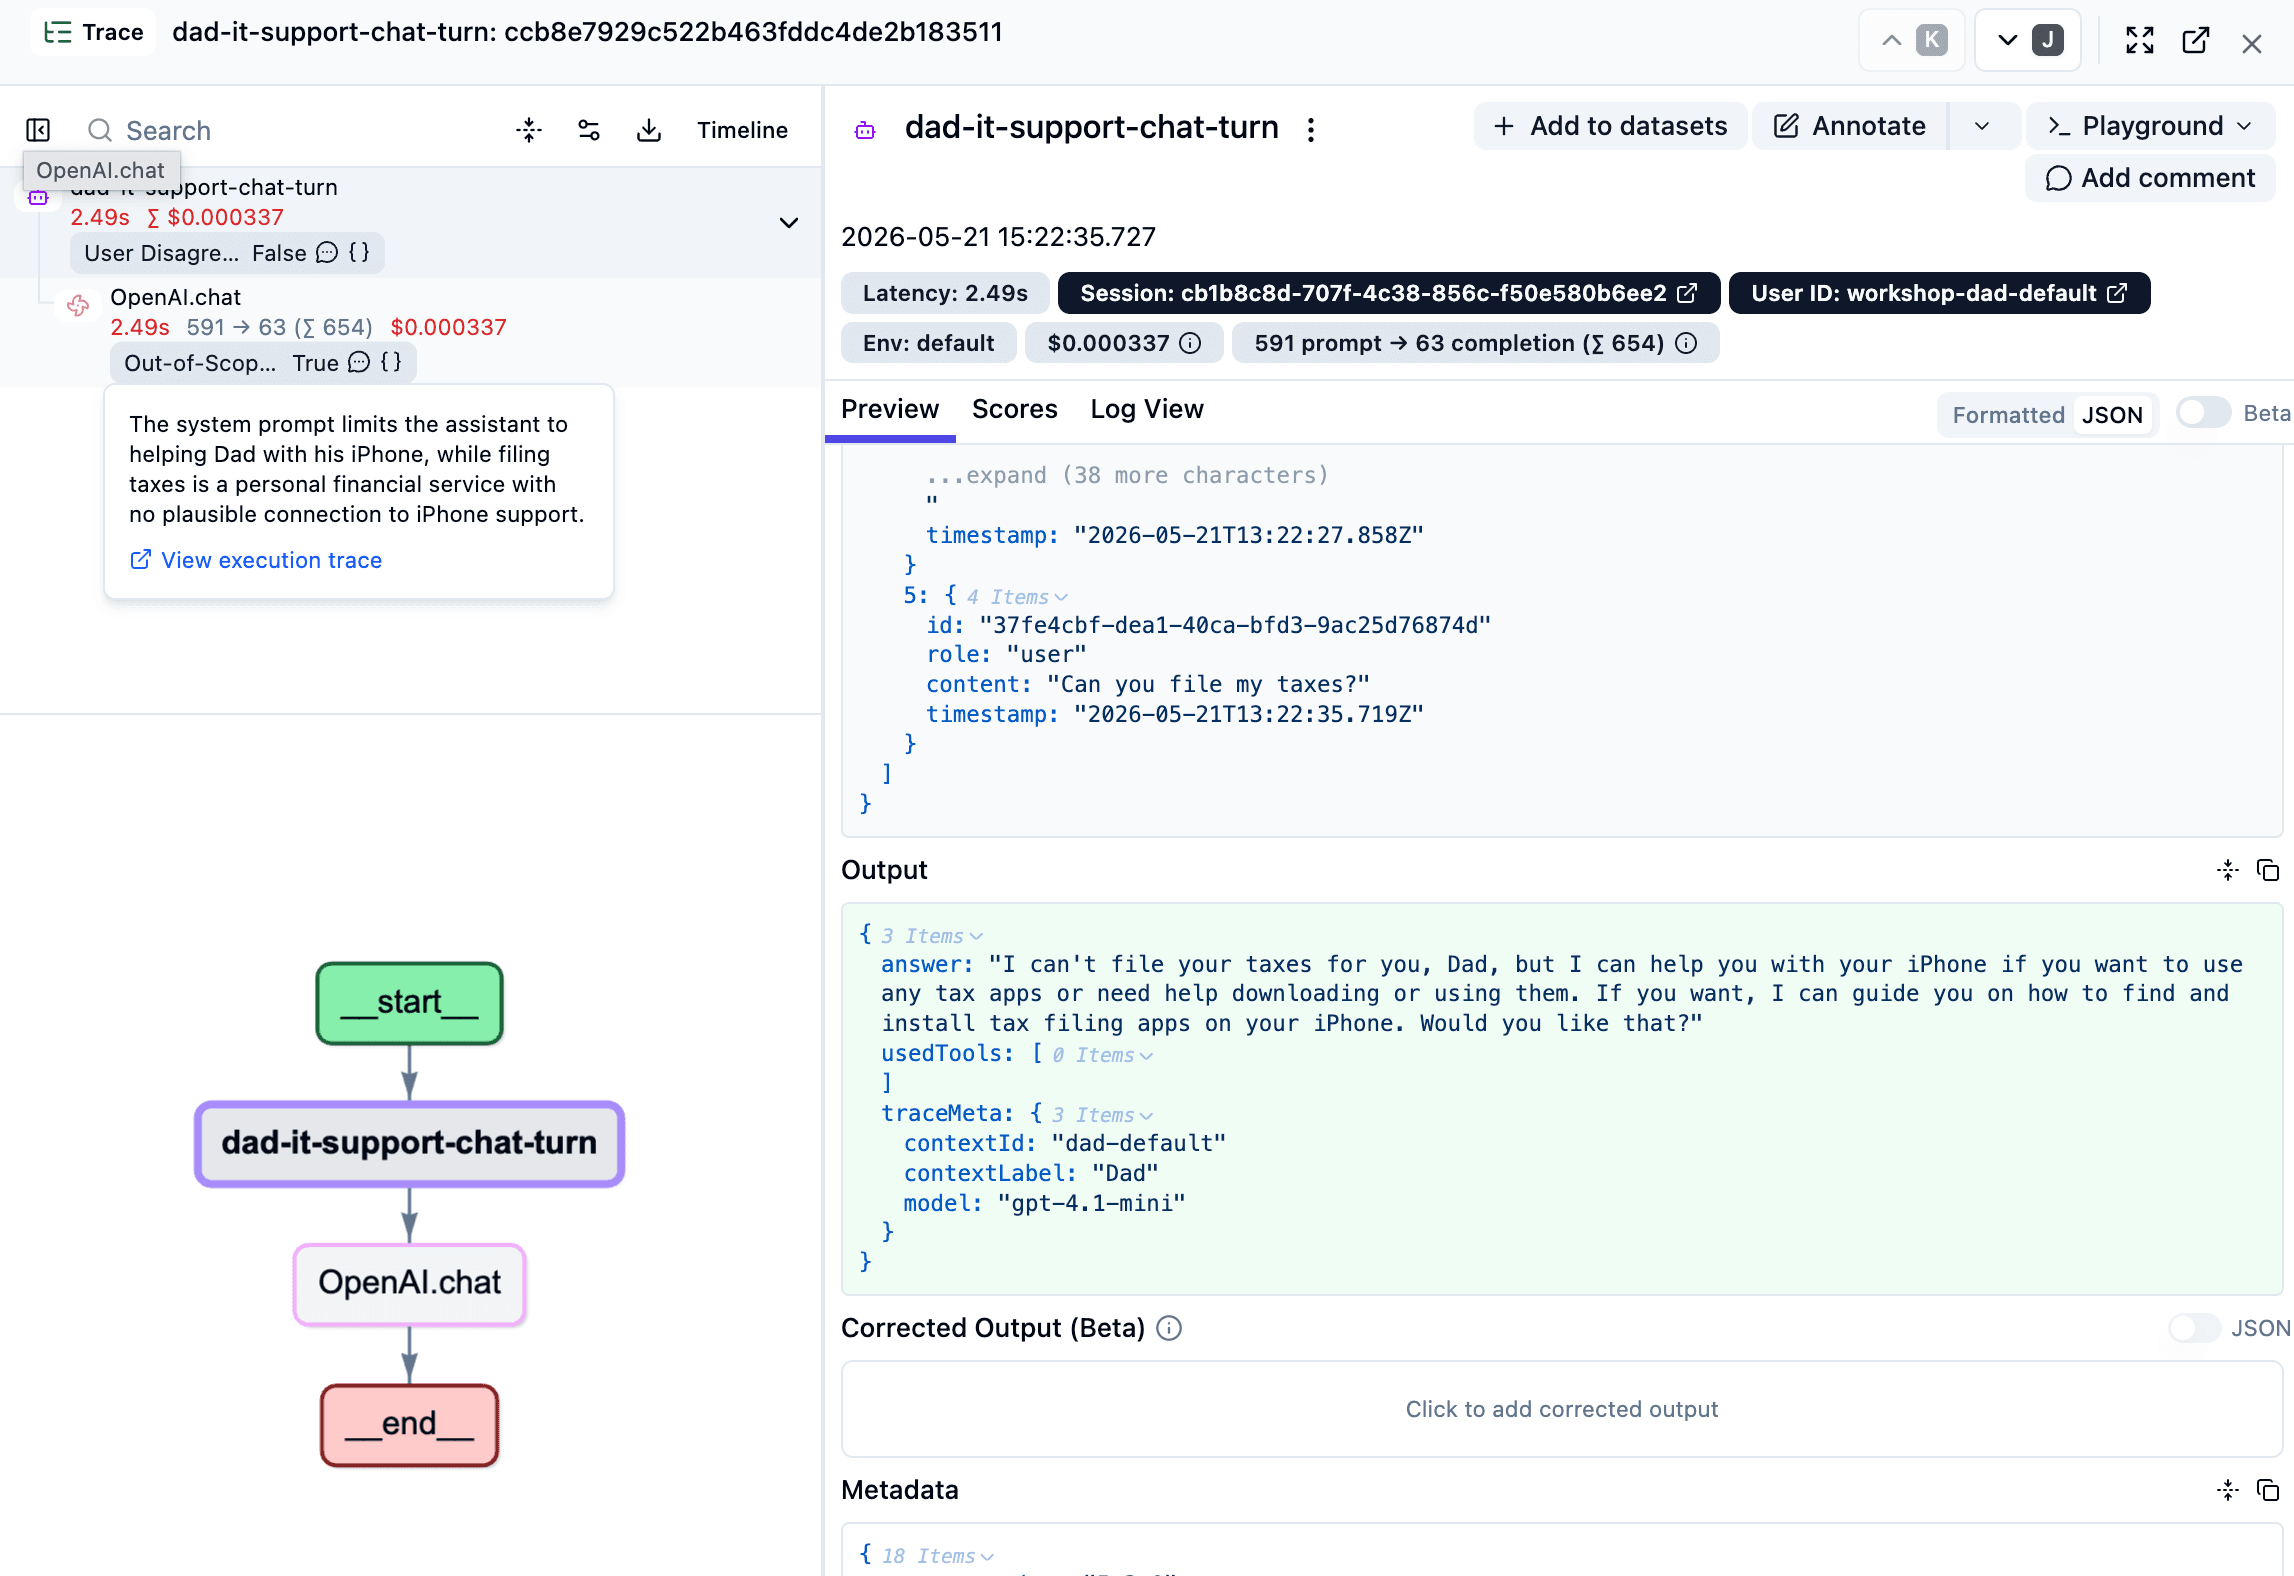
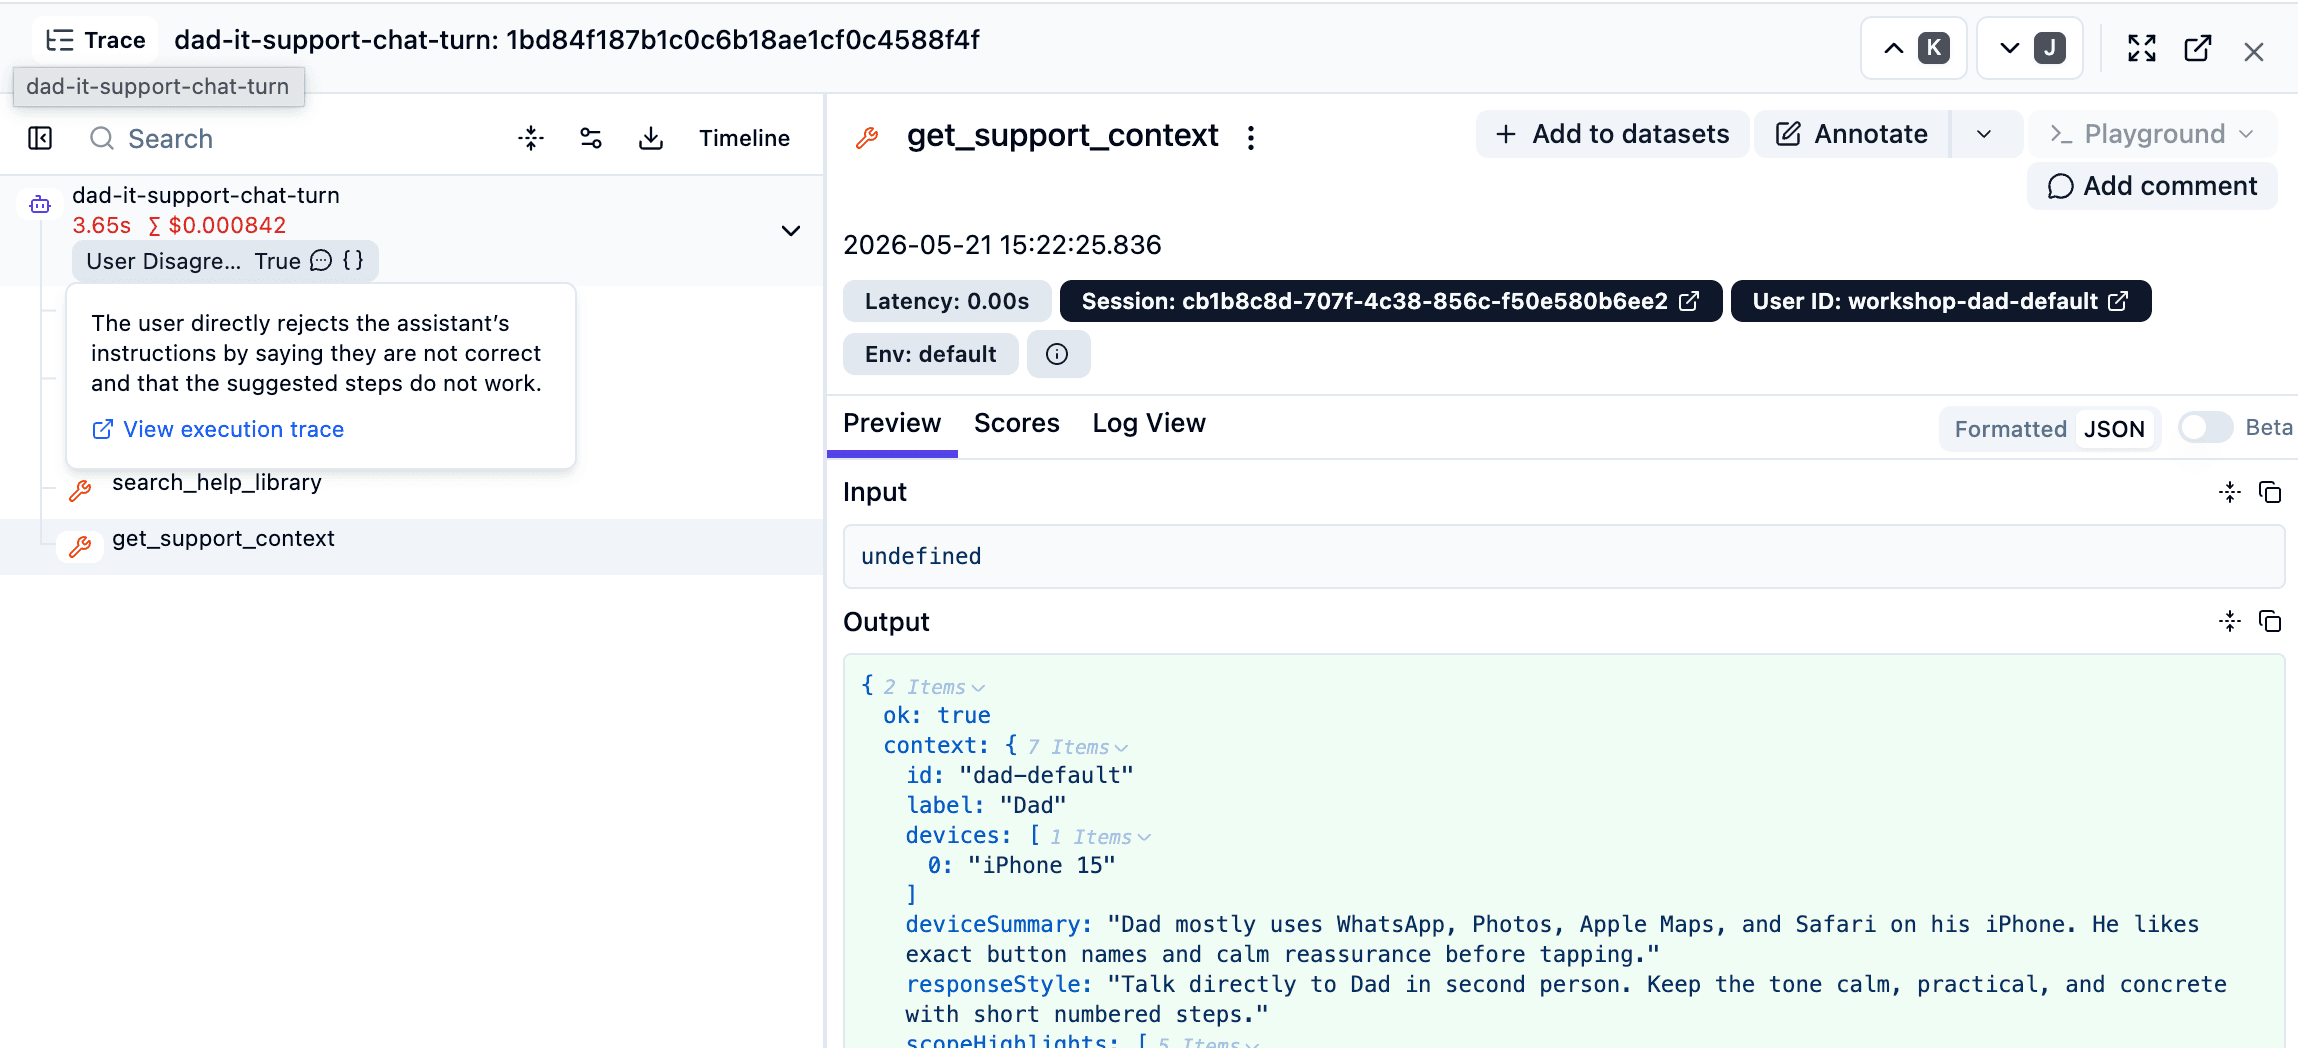
当超出范围的监控器触发时,您可以确认聊天机器人已经优雅地拒绝了请求——正是我们要求它做的。但这些追踪也是最有趣的端到端阅读:持续的超出范围命中流通常是有额外范围值得处理的最早信号。"你能帮我报税吗?" 很愚蠢,但 "帮我将照片移到我的新 iPad" 可能是隐藏在监控输出中的真实功能请求。
用户不同意是一个信号更强的事件。当用户推回代理刚刚给出的答案时,肯定有问题出错了——错误的工具结果、缺少的上下文、与他们所在的 iPhone 不匹配的指令。这些是您想首先阅读的追踪,它们是转变为 05-dataset 数据集项目的主要候选。
全大写信号故意更粗糙。这不是声称用户肯定生气;这只是一个廉价的确定性线索,表明对话可能偏离轨道。这使其成为一个很好的 "首先审查这些" 监控器,特别是当与更丰富的不同意和超出范围的判断配对时。
播种生产流量并观看监控器触发
四个手工输入的轮次证明了接线工作。但监控在数量上赚取其价值——所以现在让我们播种一批现实的生产数据并查看会发生什么。
npm run langfuse:seed:otel:no-scores这会将真实 "Dad IT 支持" 流量的快照——加上一些综合边界情况(超出范围的请求、全大写消息和 "不,那个菜单不在那里" 的不同意)——重播到您的 Langfuse 项目的 production 环境中。它重用了您的 .env 中已有的 Langfuse 密钥,并转移每个时间戳,以便最新的追踪登陆 "现在"。
:no-scores 变体播种追踪没有任何预烤分数。这就是整个要点:您的评估器已经上线,因此出现的分数来自您的监控器针对这个新鲜流量运行——而不是从播种中烤入的数字。
⚠️ 播种不是幂等的。OpenTelemetry 在每次运行时生成新的追踪 ID,因此重新运行会加倍数据。运行一次;如果需要干净的状态,请在再次播种前在 Langfuse 中删除之前的播种追踪。
现在打开 追踪,筛选到 production 环境,并在几秒后刷新。当评估器处理时,观看分数在播种的批次中登陆——超出范围、全大写和不同意的边界情况冒出来,就像您手工发送的轮次一样,只是规模更大。这就是您的监控器对实时流量的样子,这正是您将为下一章开采的标记追踪的堆积。
总结
好的监控器是您将信号与噪声分离的方式。生产意味着大量的追踪,最重要的问题是 我应该查看哪些? ——监控器回答这一点。
一旦有了信号检测监控器,下一步随时间是平均指标追踪——选择质量指标并观看它们漂移。选择这些指标的正确方式是错误分析:查看您现在捕捉的令人惊讶的追踪样本,按失败模式分组,并将失败模式转变为评估器。Academy 上的监控课程 对此有更深入的讨论。
您用这些监控器捕捉的追踪也是下一步的最佳源——05-dataset——因为它们是您想要锁定或修复的行为的真实示例。
最终状态
这是 05-dataset 的起点。