01 Chọn model nền
Arena — chạy lưới model × prompt dưới dạng experiments của Langfuse và chọn người thắng theo chi phí trên mỗi câu trả lời đúng.
Điểm khởi đầu
Module 00 đã hoàn tất: .env đã được source, database arena đã seed, Langfuse đã kết nối, và
dashboard cục bộ mở được tại http://localhost:5174 với tab Leaderboard còn trống.
Vì sao đây là quyết định nền tảng
Đây là quyết định mà cả workshop này được xây quanh nó. Trước khi bạn đưa một agent nghiêm túc lên production, bạn phải trả lời một câu hỏi nền tảng: model nào nên là động cơ của nó? Các model khác nhau rất nhiều cả về năng lực và giá, và lựa chọn tốt nhất phụ thuộc vào bài toán cụ thể của bạn — không phụ thuộc vào một bảng xếp hạng công khai mà người khác chạy trên một khối lượng công việc khác. Đoán thì tốn kém theo cả hai hướng: trả quá nhiều cho một model tiên phong bạn không cần, hoặc đưa lên production một model rẻ rồi nó âm thầm trả lời sai những câu hỏi thật của bạn.
Vậy nên thay vì đoán, bạn chạy một cuộc thi: Arena. Một lưới các model và chiến lược prompt cùng trả lời đúng các câu hỏi golden đó, Langfuse chấm điểm từng câu trả lời dưới dạng một experiment, và chỉ số chọn ra người thắng không phải độ chính xác thuần mà là chi phí trên mỗi câu trả lời đúng — chất lượng trên mỗi đô la cho use case của bạn. Cụ thể, module này trả lời bằng bằng chứng: trên một lưới các model và chiến lược prompt, cấu hình nào cho nhiều câu trả lời đúng nhất trên mỗi đô la? "Đúng" nghĩa là độ chính xác khi thực thi — SQL được sinh ra trả về đúng tập kết quả như SQL golden, không phải SQL chỉ trông có vẻ hợp lý. Việc chấm điểm diễn ra bên trong Langfuse, không phải bên trong harness — Langfuse chứa các evaluator và giữ mọi Experiment Item, score và trace. Leaderboard cục bộ đọc những bản ghi đó qua Langfuse Public API. Mọi thứ sau module này (đo, cải thiện, phát hành) đều giả định bạn đã đưa ra lựa chọn này dựa trên bằng chứng.
Khái niệm — bên dưới lớp vỏ
Mô hình dữ liệu của Langfuse cho phần đánh giá này. Bộ nguồn trong repo có 20 câu hỏi YAML.
q019 và q020 được giữ lại làm few-shot prompt holdout, vì vậy trong một project sạch Dataset đã seed
(arena-golden) chứa 18 câu hỏi experiment, mỗi câu kèm tập kết quả mong đợi. Mỗi cấu hình model × prompt
bạn chạy là một Experiment — một Dataset Run của Langfuse — trên cùng
dataset đó, nên mọi cấu hình đều được chấm trên đúng cùng bộ câu hỏi. Các evaluator bạn
có tên definition là correctness và llm_judge; các score chúng phát ra là
correctness và agent-arena-llm-judge, rồi được gắn vào từng dataset
item trong lần chạy đó. Một dataset, nhiều experiment, một score cho mỗi item trong mỗi experiment
— đó là điều cho phép Leaderboard so sánh các cấu hình một cách tương đương.
Mỗi cấu hình model × prompt chạy như một Experiment (Dataset Run) trên dataset arena-golden, và mỗi experiment gắn hai score vào từng dataset item: correctness (0/1) và agent-arena-llm-judge (0..1).
Các chiến lược prompt cũng là thí sinh. Lưới này không chỉ gồm model — nó là
model × prompt, bởi cách bạn hỏi quan trọng không kém việc bạn hỏi ai. Từ
config.yaml và agents/prompts.py:
| Prompt | Nó làm gì | Vì sao nó có thể giúp NL→SQL |
|---|---|---|
P1_zeroshot | Chỉ schema + câu hỏi, trả về một khối SQL trong fence. Đường cơ sở. | Rẻ nhất mỗi lệnh gọi; đo xem model làm được gì khi không được trợ giúp. |
P2_fewshot | P1 cộng thêm 2 ví dụ NL→SQL đã giải sẵn (được giữ ngoài tập kiểm tra). | Cho model thấy hình dạng mong đợi của một câu trả lời "tốt" trước khi nó tự viết. |
P3_dialect | P1 cộng thêm một bảng tra nhanh về dialect ClickHouse (hàm ngày tháng, uniqExact, argMax, INTERVAL, không có ILIKE, …). | Sửa kiểu lỗi phổ biến nhất: SQL đọc trôi chảy nhưng không phải SQL ClickHouse hợp lệ. |
Danh sách thí sinh: proprietary so với open-weight. Sáu thí sinh chia đều theo một trục thứ hai quan trọng không kém tên model — trọng số là đóng (một API của nhà cung cấp mà bạn chỉ có thể gọi) hay mở (một model bạn có thể tự host, fine-tune, hoặc giữ hoàn toàn trong ranh giới dữ liệu của mình). Model open-weight thường rẻ hơn rất nhiều trên mỗi token, còn các model tiên phong proprietary có thể dẫn đầu về năng lực thuần — nhưng "có thể" chính là điều Arena này được dựng lên để kiểm chứng cho bài toán của bạn, thay vì mặc định tin. Cho cả hai bên chạy qua cùng bộ dữ liệu golden để chi phí trên mỗi câu trả lời đúng nói cho bạn biết liệu bạn có thực sự cần trả tiền cho lớp tiên phong, hay một model open-weight giá rẻ cũng đưa bạn tới đó với một phần nhỏ chi phí. Danh sách dưới đây có chủ ý chọn mức giá thấp: NL→SQL là một bài toán đủ đơn giản đến mức thí sinh đắt nhất ở đây cũng chỉ là model tầm trung, không phải tiên phong.
| Model | Nhà cung cấp | Open / Proprietary | Giá tham chiếu dự phòng ($/1M in · out) |
|---|---|---|---|
claude-sonnet-5 | Anthropic | Proprietary | $2.00 · $10.00 |
gpt-5.6-luna | OpenAI | Proprietary | $0.50 · $3.00 |
gemini-flash-lite | Proprietary | $0.30 · $2.50 | |
deepseek-v4-flash | DeepSeek | Open-weight | $0.14 · $0.28 |
qwen3.7-flash | Qwen | Open-weight | $0.03 · $0.13 |
glm-4.7-flash | Z.ai | Open-weight | $0.06 · $0.40 |
Vì sao dùng chi phí trên mỗi câu đúng, và vì sao dùng độ chính xác khi thực thi. "Đúng" được quyết định bởi độ chính xác khi thực thi: chạy SQL được sinh ra có cho ra cùng tập kết quả như SQL golden hay không? Đó là tín hiệu trung thực — nó không quan tâm SQL có khác từng byte so với truy vấn golden hay không, chỉ quan tâm nó có trả lời đúng câu hỏi hay không. Chỉ số xếp hạng chính khi đó là
cost_per_correct_answer = total cost of the run ($) / number of correct answerschỉ số này thưởng cho một model gần như chính xác bằng nhưng rẻ hơn nhiều so với một model tiên phong tốt hơn chút ít nhưng đắt hơn rất nhiều — đúng chỉ số mà một đội thực sự quan tâm chi phí sẽ tối ưu theo.
Mục tiêu
Một Leaderboard đã có dữ liệu, xếp hạng ít nhất vài cấu hình model × prompt theo
chi phí trên mỗi câu trả lời đúng, với mọi thứ hạng đều được chống lưng bởi một trace Langfuse bạn có thể
đào vào, và một người thắng được chọn: một config_id.
Bước 1 — Thiết lập các evaluator Langfuse (một lần duy nhất)
Làm việc này một lần, theo eval/langfuse_evaluators/README.md trong repo. Trước tiên seed
arena-golden và cấu hình judge chạy trên OpenRouter thông qua API:
python -m scripts.provision_langfuse_evaluatorsSau đó cấu hình code evaluator tất định trong UI của Langfuse:
- Code evaluator
correctness— Evaluators → Set up Evaluator → Code → dán nội dungeval/langfuse_evaluators/correctness_evaluator.pyvào → Target: Experiments → lọc dataset =arena-golden. Evaluator này so sánh tập kết quả của agent (lấy từ trace) với tập kết quả golden (giá trịexpected_outputcủa dataset item) và phát ra scorecorrectnessvề độ chính xác khi thực thi (0/1) cộng thêm một hạng mụcoutcome. Nó không có kết nối mạng đi ra — SQL đã chạy bên trong agent; evaluator chỉ so sánh các tập kết quả. - Phương án dự phòng làm thủ công cho evaluator definition
llm_judge— Evaluators → Set up Evaluator → LLM-as-a-judge → Custom → dùng các prompt system/eval và phần ánh xạ biến từeval/langfuse_evaluators/llm_judge_prompt.md→ Target: Experiments, datasetarena-golden→ phát score dạng sốagent-arena-llm-judge. Tên evaluator definition và tên score phát ra được chủ ý đặt khác nhau. Đây là tín hiệu thứ cấp đánh giá chất lượng SQL, bên cạnh score correctness là chính — bạn sẽ dựa vào nó ở Module 02.
Script hỗ trợ là con đường được khuyến nghị; bước làm judge thủ công chỉ là phương án dự phòng. Code
evaluator tất định correctness vẫn là một bước làm một lần trong UI.
Bước 2 — Chạy cuộc thi
source .env && python -m eval.harness --run-id demoBạn sẽ thấy gì. Harness trước tiên in một dòng tóm tắt
(run_id=demo configs=6x3 ...), rồi in một dòng cho mỗi câu hỏi khi nó chạy, ví dụ:
claude-sonnet-5__P1_zeroshot q001 pending 812ms $0.00021Mọi dòng đều bắt đầu ở pending — SQL đã chạy và tập kết quả đã được ghi lên trace,
nhưng các evaluator của Langfuse chưa chấm điểm. Khi mọi cấu hình đã chạy
xong, harness chuyển sang chờ: grading via Langfuse evaluators — waiting on N traces..., in dần đếm ngược khi các score correctness/agent-arena-llm-judge về, và
kết thúc bằng Langfuse scored all N traces; leaderboard ready. Bước chuyển từ pending →
đã chấm điểm chính là lúc harness giao việc chấm điểm cho Langfuse; kết quả và phán quyết
nằm cùng nhau ở đó, làm nguồn sự thật cho leaderboard.
Lệnh này chạy toàn bộ lưới model × prompt (mọi model trong config.yaml với mọi
chiến lược prompt, từ P1_zeroshot đến P3_dialect) dưới dạng Dataset Runs
(Experiments) của Langfuse trên dataset arena-golden. Harness chờ các
các score phát ra có tên chính xác correctness và agent-arena-llm-judge trên mọi item. Chi phí OpenRouter chính xác và
độ trễ đầu-cuối được lưu trên cùng Experiment Item đó.
Một cấu hình đơn lẻ là <model>__<prompt>, ví dụ claude-sonnet-5__P1_zeroshot. Các
tên khả dụng lấy trực tiếp từ config.yaml:
- Models: sáu thí sinh trong bảng danh sách ở trên — ba proprietary
(
claude-sonnet-5,gpt-5.6-luna,gemini-flash-lite) và ba open-weight (deepseek-v4-flash,qwen3.7-flash,glm-4.7-flash) - Prompts:
P1_zeroshot,P2_fewshot,P3_dialect
Các flag hữu ích:
--models qwen3.7-flash,gpt-5.6-luna/--prompts P1_zeroshot,P3_dialect— giới hạn lưới về một tập con dạng CSV thay vì chạy tất cả.--run-id <name>— gắn nhãn cho lần chạy để dễ tìm trên Leaderboard và trong màn hình Experiments của Langfuse.
SDK có thể xử lý các dataset item theo thứ tự ngược hoặc song song; hãy dùng ID câu hỏi
trên mỗi dòng thay vì trông đợi thứ tự output q001, q002, ... Một lưới đầy đủ 18 cấu
hình thường mất 35–45 phút. Hãy bắt đầu workshop bằng một tập con hai model, một prompt
và chỉ chạy toàn bộ lưới khi thời lượng và giới hạn của nhà cung cấp cho phép.
Bắt buộc phải có các evaluator của Langfuse. Langfuse giờ là nơi lưu đánh giá duy nhất, nên
không có phương án dự phòng chấm điểm cục bộ hay lấy kết quả từ ClickHouse. Nếu harness hết thời gian chờ
score, hãy sửa cấu hình evaluator ở Bước 1 và dùng một --run-id mới.
Bước 3 — Chọn ra người thắng
Mở http://localhost:5174 → Leaderboard. Mọi cấu hình model × prompt được
xếp hạng theo chi phí trên mỗi câu trả lời đúng — chỉ số chính. Một biểu đồ chi phí × độ chính xác và
một bảng xếp hạng "best value" nằm phía trên bảng.
Chi phí được tính từ giá OpenRouter thời gian thực — harness làm mới giá model
từ endpoint /models của OpenRouter ở đầu mỗi lần chạy, nên
chi phí trên mỗi câu trả lời đúng phản ánh chi phí thực của model hôm nay, không phải một con số
cũ cứng hóa trong config.yaml.
Cách đọc nó. Thứ tự sắp xếp là chi phí trên mỗi câu đúng tăng dần — người thắng là dòng trên cùng, không phải dòng có độ chính xác cao nhất. Hãy để ý biểu đồ chi phí × độ chính xác xem có một model rẻ nằm gần một model đắt trên trục độ chính xác không: khoảng cách đó, với một phần nhỏ chi phí, chính là toàn bộ lý do chỉ số này tồn tại thay vì một bảng xếp hạng độ chính xác thuần.
Bẫy — độ chính xác cao nhất ≠ người thắng. Rất dễ nhìn nhanh cột độ chính xác
và cho rằng ai điểm cao nhất là thắng. Arena xếp hạng theo chi phí trên mỗi câu đúng, nên một
cấu hình chính xác kém hơn chút ít nhưng rẻ hơn nhiều có thể (và thường là) xếp trên một cấu hình đắt hơn,
chính xác hơn chút ít. Hãy xem cột $/correct, không chỉ độ chính xác.
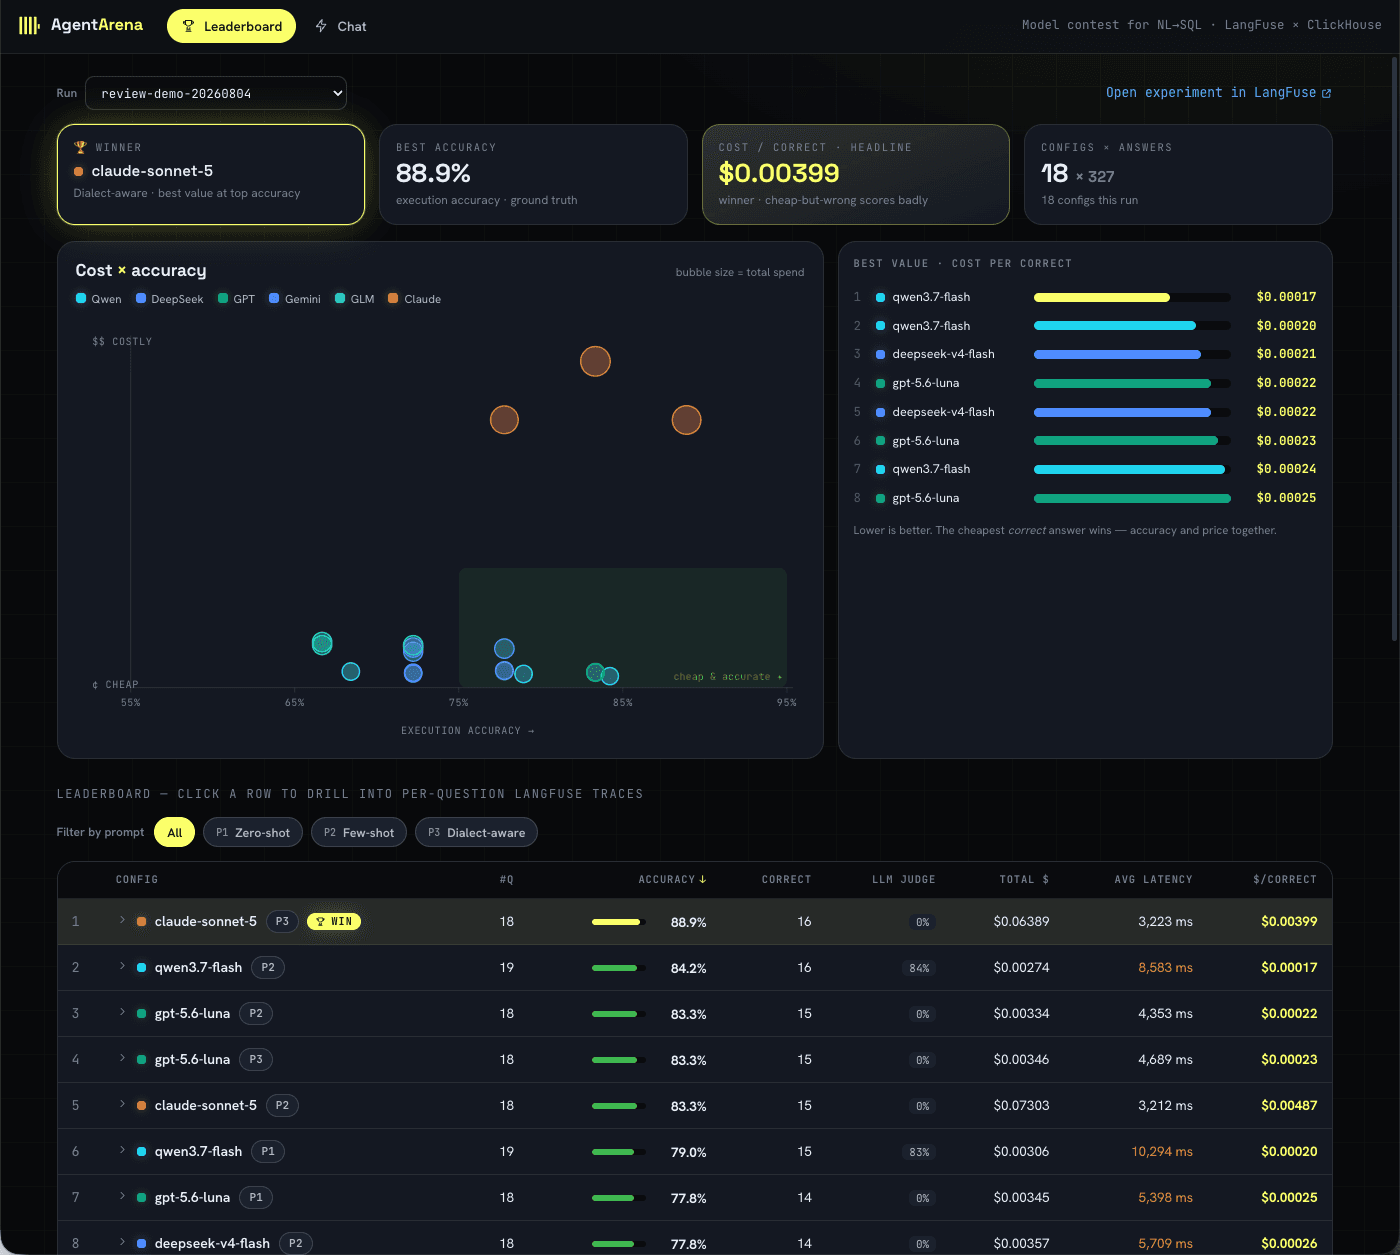
Leaderboard đặt chất lượng và giá cạnh nhau. Biểu đồ chi phí × độ chính xác cho thấy
sự đánh đổi một cách trực quan, còn danh sách best-value và cột $/correct tiết lộ những
cấu hình nào biến chi tiêu thành câu trả lời đúng hiệu quả nhất.
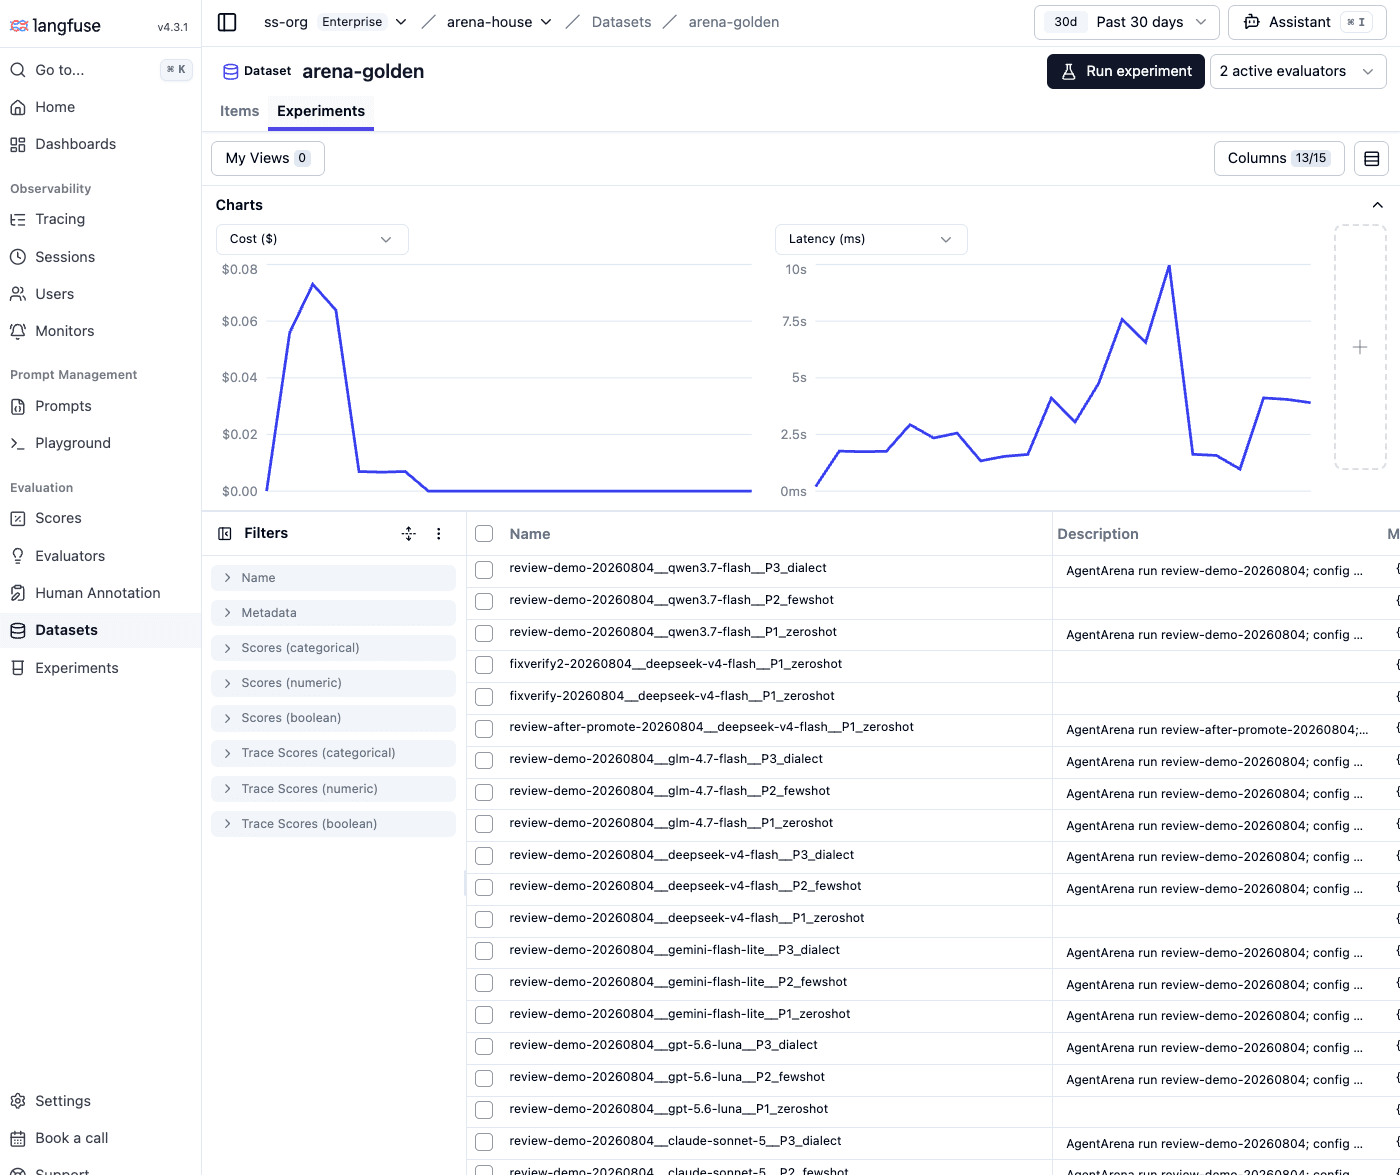
Tab Experiments của arena-golden trong Langfuse chứa một Dataset Run cho mỗi cấu hình model ×
prompt. Các biểu đồ tổng hợp chi phí và độ trễ trên cùng bộ câu hỏi golden,
nên từng dòng đều so sánh được trực tiếp với nhau.
Dòng trên cùng là người thắng của bạn: ghi lại config_id của nó. Module 02
sẽ đi sâu vào chuyện nó tốt đến mức nào, chứ không chỉ là nó đã thắng.
Cách xác nhận bạn đã xong
- Bảng Leaderboard hiển thị ít nhất một dòng
model × promptcó giá trị chi phí trên mỗi câu trả lời đúng (không trống). - Bấm vào dòng của một cấu hình cho thấy kết quả theo từng câu hỏi, và bấm vào một câu hỏi mở trace Langfuse của nó với phần SQL được sinh ra hiện rõ.
- Bạn nêu được
config_id(<model>__<prompt>) mà Arena đã chọn làm người thắng.
Bài tập — dự đoán, rồi kiểm chứng
Trước khi mở Leaderboard thật, hãy đưa ra một dự đoán và viết nó ra:
- Chỉ nhìn vào danh sách model và bảng prompt ở trên (không nhìn Leaderboard),
đoán xem cấu hình
model × promptnào sẽ thắng về chi phí trên mỗi câu trả lời đúng. Viết raconfig_idvà một câu lý do (ví dụ "model rẻ nhất ghép với prompt dialect, vì phần lớn lỗi là lỗi dialect, không phải lỗi suy luận"). - Giờ mở Leaderboard và kiểm tra. Bạn đoán đúng không?
- Dù kết quả thế nào, hãy trả lời điều này: một model rẻ hơn có đánh bại (hoặc tiến sát) một model tiên phong không? Nếu có, khoảng cách đó — rẻ-mà-gần-bằng đánh bại đắt-mà-tốt-hơn-chút-ít — chính là lý do xếp hạng theo chi phí trên mỗi câu trả lời đúng thay vì theo độ chính xác thuần. Nếu một model tiên phong thắng dứt điểm, hãy ghi lại nó thắng cấu hình rẻ kế tiếp bao nhiêu — biên độ đó là điều sẽ biện minh cho giá của nó trong một quyết định triển khai thật.
Tổng kết
Giờ bạn đã có bằng chứng, không phải phỏng đoán, cho việc model và chiến lược prompt nào đáng
để chạy — xếp hạng theo chi phí trên mỗi câu trả lời đúng và được chống lưng bởi trace Langfuse cho mọi
lần chạy. Hãy ghi lại config_id thắng của bạn; bạn sẽ dùng nó trong mọi module từ đây trở đi.
Trạng thái kết thúc
Một leaderboard đã xếp hạng và một config_id đã được chọn. Tiếp tục sang
02 Đo chất lượng để xem người thắng đó thực sự tốt đến đâu.