01 เลือกโมเดลฐาน
Arena — รันตาราง โมเดล × prompt เป็น Langfuse experiments และคัดผู้ชนะด้วยต้นทุนต่อคำตอบที่ถูกต้อง
จุดเริ่มต้น
โมดูล 00 เสร็จแล้ว: source .env แล้ว, seed ฐานข้อมูล arena แล้ว, เชื่อมต่อ Langfuse แล้ว และ
dashboard ในเครื่องเข้าถึงได้ที่ http://localhost:5174 โดยแท็บ Leaderboard ยังว่างเปล่า
ทำไมนี่จึงเป็นการตัดสินใจที่เป็นรากฐาน
นี่คือการตัดสินใจที่เวิร์กช็อปทั้งหมดสร้างขึ้นรอบ ๆ มัน ก่อนที่คุณจะปล่อย agent แบบจริงจัง คุณต้องตอบคำถามที่เป็นรากฐานข้อหนึ่ง: โมเดลไหนควรเป็นเครื่องยนต์ของมัน โมเดลต่างกันมหาศาลทั้งด้านความสามารถ และ ราคา และตัวเลือกที่ดีที่สุดขึ้นอยู่กับ งานเฉพาะของคุณ — ไม่ใช่ leaderboard สาธารณะที่คนอื่นรันบนงานอีกแบบ การเดามีราคาแพงทั้งสองทาง: จ่ายแพงเกินไปสำหรับโมเดล frontier ที่คุณไม่ต้องการ หรือ ปล่อยโมเดลราคาถูกที่ตอบคำถามจริงของคุณผิดแบบเงียบ ๆ
ดังนั้นแทนที่จะเดา คุณจัดการแข่งขัน: Arena ตารางของโมเดลและกลยุทธ์ prompt ทั้งหมดตอบ golden question ชุดเดียวกัน Langfuse ให้คะแนนทุกคำตอบในรูปของ experiment และเมตริกที่คัดผู้ชนะไม่ใช่ความแม่นยำดิบ แต่เป็น ต้นทุนต่อ คำตอบที่ถูกต้อง — คุณภาพต่อเงินหนึ่งดอลลาร์สำหรับ use case ของ คุณ ในทางรูปธรรม โมดูลนี้ ตอบด้วยหลักฐานว่า: ในตารางของโมเดลและกลยุทธ์ prompt คอนฟิกไหนได้คำตอบที่ ถูกต้องมากที่สุดต่อเงินหนึ่งดอลลาร์ "ถูกต้อง" หมายถึงความแม่นยำเชิงการรัน (execution accuracy) — SQL ที่ถูกสร้างขึ้นคืน result set เดียวกับ golden SQL ไม่ใช่ SQL ที่แค่ดูเข้าเค้า การให้คะแนนเกิดขึ้น ภายใน Langfuse ไม่ใช่ภายใน harness — Langfuse เป็นที่อยู่ของ evaluator และเก็บทุก Experiment Item, score และ trace leaderboard ในเครื่องอ่านบันทึกเหล่านั้นผ่าน Langfuse Public API ทุกอย่างหลัง โมดูลนี้ (วัด พัฒนา ปล่อย) สมมติว่าคุณได้ตัดสินใจเรื่องนี้บนหลักฐานแล้ว
แนวคิด — เบื้องหลังการทำงาน
โมเดลข้อมูลของ Langfuse สำหรับการประเมินนี้ คลังต้นทางใน repo มีคำถาม YAML 20 ข้อ
โดย q019 และ q020 กันไว้เป็น few-shot prompt holdout ดังนั้นในโปรเจกต์ที่สะอาด Dataset
(arena-golden) ที่ seed แล้วจึงมีคำถามสำหรับ experiment 18 ข้อ แต่ละข้อมี result set ที่คาดหวังไว้ ทุกคอนฟิก model × prompt
ที่คุณรันคือหนึ่ง Experiment — หนึ่ง Dataset Run ของ Langfuse — เทียบกับ dataset
เดียวกันนั้น ดังนั้นทุกคอนฟิกถูกให้คะแนนบนคำถามชุดเดียวกันเป๊ะ ๆ evaluator ที่คุณ
ตั้งค่าในขั้นที่ 1 มีชื่อ definition ว่า correctness และ llm_judge; score ที่ปล่อยออกมาคือ
correctness และ agent-arena-llm-judge ซึ่งจะแนบ Scores ไปที่แต่ละ dataset
item ภายในการรันนั้น หนึ่ง dataset หลาย experiment หนึ่ง score ต่อหนึ่ง item ต่อหนึ่ง experiment
— ซึ่งเป็นสิ่งที่ทำให้ Leaderboard เทียบคอนฟิกกันได้ตรง ๆ
ทุกคอนฟิก โมเดล × prompt รันเป็นหนึ่ง Experiment (Dataset Run) เทียบกับ dataset arena-golden และแต่ละ experiment แนบสอง score ไปที่ทุก dataset item: correctness (0/1) และ agent-arena-llm-judge (0..1)
กลยุทธ์ prompt ก็เป็นผู้เข้าแข่งขันด้วย ตารางนี้ไม่ได้มีแค่โมเดล — มันคือ
model × prompt เพราะวิธีที่คุณถามสำคัญไม่แพ้ว่าคุณถามใคร จาก
config.yaml และ agents/prompts.py:
| Prompt | มันทำอะไร | ทำไมมันอาจช่วยงาน NL→SQL |
|---|---|---|
P1_zeroshot | schema + คำถามเท่านั้น คืนบล็อก SQL ในรั้วโค้ดหนึ่งบล็อก เป็นเส้นฐาน | ถูกที่สุดต่อการเรียกหนึ่งครั้ง; วัดว่าโมเดลทำอะไรได้เมื่อไม่มีตัวช่วยเลย |
P2_fewshot | P1 บวกตัวอย่าง NL→SQL ที่ทำไว้แล้ว 2 ตัวอย่าง (กันไว้นอกชุดทดสอบ) | แสดงให้โมเดลเห็นรูปทรงที่คาดหวังของคำตอบที่ "ดี" ก่อนที่มันจะเขียนเอง |
P3_dialect | P1 บวกชีตสรุป dialect ของ ClickHouse (ฟังก์ชันวันที่, uniqExact, argMax, INTERVAL, ไม่มี ILIKE, …) | แก้รูปแบบความล้มเหลวที่พบบ่อยที่สุด: SQL ที่ลื่นไหลแต่ไม่ใช่ SQL ของ ClickHouse ที่ถูกต้อง |
รายชื่อผู้เข้าแข่งขัน: proprietary เทียบกับ open-weight ผู้เข้าแข่งขันหกรายแบ่งเท่ากันตามแกน ที่สองซึ่งสำคัญไม่แพ้ชื่อโมเดล — ว่าน้ำหนักของมันปิด (API ของผู้ขายที่คุณ เรียกได้เท่านั้น) หรือเปิด (โมเดลที่คุณ self-host, fine-tune หรือเก็บไว้ในขอบเขตข้อมูลของคุณเองทั้งหมดได้) โมเดล open-weight มักถูกกว่ามากต่อ token ขณะที่โมเดล frontier แบบ proprietary อาจนำหน้าด้านความสามารถดิบ — แต่ "อาจ" คือสิ่งที่ Arena นี้ถูกสร้างมาเพื่อทดสอบสำหรับงานของ คุณ ไม่ใช่เพื่อสมมติเอา การรัน ทั้งสองฝ่ายผ่าน golden dataset เดียวกันทำให้ต้นทุนต่อคำตอบที่ถูกต้องบอกคุณได้ว่า คุณจำเป็นต้องจ่ายค่า frontier จริงหรือไม่ หรือโมเดล open-weight ราคาถูกจะพาคุณไปถึงจุดนั้น ด้วยราคาเพียงเสี้ยวเดียว รายชื่อด้านล่างตั้งใจให้ต้นทุนต่ำ: NL→SQL เป็น งานที่ง่ายพอที่แม้แต่ผู้เข้าแข่งขันที่แพงที่สุดตรงนี้ก็ยังเป็นโมเดลระดับกลาง ไม่ใช่ frontier
| โมเดล | ผู้ให้บริการ | Open / Proprietary | ราคาสำรองเพื่อการอ้างอิง ($/1M in · out) |
|---|---|---|---|
claude-sonnet-5 | Anthropic | Proprietary | $2.00 · $10.00 |
gpt-5.6-luna | OpenAI | Proprietary | $0.50 · $3.00 |
gemini-flash-lite | Proprietary | $0.30 · $2.50 | |
deepseek-v4-flash | DeepSeek | Open-weight | $0.14 · $0.28 |
qwen3.7-flash | Qwen | Open-weight | $0.03 · $0.13 |
glm-4.7-flash | Z.ai | Open-weight | $0.06 · $0.40 |
ทำไมต้องต้นทุนต่อคำตอบที่ถูกต้อง และทำไมต้องความแม่นยำเชิงการรัน "ถูกต้อง" ตัดสินด้วย ความแม่นยำเชิงการรัน: การรัน SQL ที่สร้างขึ้นให้ result set เดียวกับ golden SQL หรือไม่? นั่นคือสัญญาณที่ตรงไปตรงมา — มันไม่สนว่า SQL จะ ต่างจาก golden query แบบทีละไบต์หรือไม่ สนแค่ว่ามันตอบคำถามได้ ถูกต้องหรือเปล่า เมตริกจัดอันดับหลักจึงเป็น
cost_per_correct_answer = total cost of the run ($) / number of correct answersซึ่งให้รางวัลกับโมเดลที่แม่นยำ เกือบ เท่ากันแต่ถูกกว่ามาก เหนือกว่าโมเดล frontier ที่ดีกว่าเล็กน้อยแต่แพงกว่ามาก — เมตริกที่ทีมซึ่งใส่ใจต้นทุน จริง ๆ จะเลือกปรับให้ดีที่สุด
เป้าหมาย
Leaderboard ที่มีข้อมูล จัดอันดับคอนฟิก model × prompt อย่างน้อยสองสามชุดด้วย
ต้นทุนต่อคำตอบที่ถูกต้อง โดยทุกอันดับมี Langfuse trace รองรับให้คุณเจาะ
ดูได้ และมีผู้ชนะที่ถูกคัดออกมา: config_id หนึ่งชุด
ขั้นที่ 1 — ตั้งค่า Langfuse evaluator (ครั้งเดียว)
ทำครั้งเดียว โดยทำตาม eval/langfuse_evaluators/README.md ของ repo ก่อนอื่น seed
arena-golden แล้วตั้งค่า judge ที่ใช้ OpenRouter ผ่าน API:
python -m scripts.provision_langfuse_evaluatorsแล้วตั้งค่า code evaluator แบบกำหนดผลแน่นอนใน UI ของ Langfuse:
- Code evaluator
correctness— Evaluators → Set up Evaluator → Code → วางeval/langfuse_evaluators/correctness_evaluator.pyลงไป → Target: Experiments → กรอง dataset =arena-goldenevaluator นี้เทียบ result set ของ agent (จาก trace) กับ golden result set (expected_outputของ dataset item) แล้วปล่อยคะแนนcorrectnessแบบความแม่นยำเชิงการรัน (0/1) บวกกับหมวดoutcomeมันไม่มี network egress — SQL รันไปแล้วภายใน agent; evaluator แค่เทียบ result set - ทางสำรองแบบทำมือสำหรับ evaluator definition
llm_judge— Evaluators → Set up Evaluator → LLM-as-a-judge → Custom → ใช้ system/eval prompt และการแมปตัวแปรจากeval/langfuse_evaluators/llm_judge_prompt.md→ Target: Experiments, datasetarena-golden→ ปล่อยคะแนนตัวเลขagent-arena-llm-judgeชื่อ evaluator definition กับชื่อ score ที่ปล่อยออกมาจงใจใช้คนละชื่อ นี่คือสัญญาณรองที่ให้คะแนน คุณภาพ SQL เพิ่มเติมจากคะแนน correctness ที่เป็นตัวหลัก — คุณจะพึ่งมันใน โมดูล 02
ตัวช่วยคือเส้นทางที่แนะนำ; ขั้นตั้ง judge แบบทำมือเป็นเพียงทางสำรอง
code evaluator correctness แบบกำหนดผลแน่นอนยังคงเป็นขั้นตอนบน UI ที่ทำครั้งเดียว
ขั้นที่ 2 — รันการแข่งขัน
source .env && python -m eval.harness --run-id demoสิ่งที่คุณควรเห็น harness พิมพ์บรรทัดสรุปก่อน
(run_id=demo configs=6x3 ...) แล้วพิมพ์หนึ่งบรรทัดต่อคำถามขณะที่มันรัน เช่น:
claude-sonnet-5__P1_zeroshot q001 pending 812ms $0.00021ทุกแถวเริ่มด้วย pending — SQL รันไปแล้วและ result set ถูกบันทึกไว้บน trace
แต่ evaluator ของ Langfuse ยังไม่ได้ให้คะแนน เมื่อทุกคอนฟิกรันเสร็จ
harness จะเปลี่ยนไปรอ: grading via Langfuse evaluators — waiting on N traces... พิมพ์นับถอยหลังไปเรื่อย ๆ ขณะที่คะแนน correctness/agent-arena-llm-judge เข้ามา และ
จบด้วย Langfuse scored all N traces; leaderboard ready การส่งไม้ต่อจาก pending →
scored นั้นคือ harness ส่งงานให้คะแนนต่อให้ Langfuse; ผลลัพธ์และคำตัดสิน
อยู่ด้วยกันที่นั่นในฐานะแหล่งข้อมูลจริงของ leaderboard
ขั้นนี้รันตาราง model × prompt เต็ม (ทุกโมเดลใน config.yaml เทียบกับทุก
กลยุทธ์ prompt ตั้งแต่ P1_zeroshot ถึง P3_dialect) เป็น Dataset Runs
(Experiments) ของ Langfuse เทียบกับ dataset arena-golden harness รอให้
score ที่ปล่อยออกมาชื่อตรงเป๊ะว่า correctness และ agent-arena-llm-judge ครบทุก item ต้นทุนจริงของ OpenRouter และ
latency ตั้งแต่ต้นจนจบถูกเก็บไว้บน Experiment Item เดียวกัน
คอนฟิกหนึ่งชุดคือ <model>__<prompt> เช่น claude-sonnet-5__P1_zeroshot ชื่อ
ที่ใช้ได้มาจาก config.yaml ตรง ๆ:
- โมเดล: ผู้เข้าแข่งขันหกรายในตารางรายชื่อด้านบน — สามรายเป็น proprietary
(
claude-sonnet-5,gpt-5.6-luna,gemini-flash-lite) และสามรายเป็น open-weight (deepseek-v4-flash,qwen3.7-flash,glm-4.7-flash) - Prompt:
P1_zeroshot,P2_fewshot,P3_dialect
flag ที่มีประโยชน์:
--models qwen3.7-flash,gpt-5.6-luna/--prompts P1_zeroshot,P3_dialect— จำกัดตารางให้เป็นชุดย่อยแบบ CSV แทนที่จะรันทั้งหมด--run-id <name>— ติดป้ายการรันเพื่อให้หาได้ง่ายบน Leaderboard และในมุมมอง Experiments ของ Langfuse
SDK อาจประมวลผล dataset item ในลำดับย้อนกลับหรือแบบขนาน; ให้ใช้ ID ของคำถาม
ในแต่ละบรรทัดแทนที่จะคาดหวังลำดับเอาต์พุต q001, q002, ... ตารางเต็ม 18 คอนฟิก
โดยทั่วไปใช้เวลา 35–45 นาที เริ่มเวิร์กช็อปด้วยชุดย่อยสองโมเดลหนึ่ง prompt
และรันตารางเต็มเฉพาะเมื่อตารางเวลาและลิมิตของผู้ให้บริการเอื้ออำนวย
Langfuse evaluator เป็นสิ่งจำเป็น ตอนนี้ Langfuse เป็นที่เก็บการประเมินเพียงแห่งเดียว ดังนั้น
จึงไม่มีทางสำรองแบบให้คะแนนในเครื่องหรือเก็บผลใน ClickHouse ถ้า harness timeout ขณะรอ
คะแนน ให้แก้การตั้งค่า evaluator จากขั้นที่ 1 แล้วใช้ --run-id ใหม่
ขั้นที่ 3 — คัดผู้ชนะ
เปิด http://localhost:5174 → Leaderboard ทุกคอนฟิก model × prompt ถูก
จัดอันดับด้วย ต้นทุนต่อคำตอบที่ถูกต้อง — เมตริกหลัก กราฟ cost × accuracy และ
อันดับ "best value" อยู่เหนือตาราง
ต้นทุนคำนวณจาก ราคาจริงของ OpenRouter — harness รีเฟรชราคาโมเดล
จาก endpoint /models ของ OpenRouter ตอนเริ่มการรันแต่ละครั้ง ดังนั้น
ต้นทุนต่อคำตอบที่ถูกต้องสะท้อนว่าโมเดลมีราคาเท่าไรจริงในวันนี้ ไม่ใช่ตัวเลข
เก่าที่ฝังไว้ใน config.yaml
วิธีอ่าน ลำดับการเรียงคือต้นทุนต่อคำตอบที่ถูกต้องจากน้อยไปมาก — ผู้ชนะคือ แถว บนสุด ไม่ใช่แถวที่ความแม่นยำสูงสุด จับตากราฟ cost × accuracy หา โมเดลราคาถูกที่อยู่ใกล้โมเดลราคาแพงบนแกนความแม่นยำ: ช่องว่างนั้นในราคาเพียง เสี้ยวเดียว คือเหตุผลทั้งหมดที่เมตริกนี้มีอยู่แทนที่จะเป็น leaderboard ความแม่นยำเปล่า ๆ
หลุมพราง — ความแม่นยำสูงสุด ≠ ผู้ชนะ มันน่าดึงดูดที่จะกวาดตามองคอลัมน์ความแม่นยำ
แล้วสมมติว่าคนคะแนนสูงสุดชนะ Arena จัดอันดับด้วยต้นทุนต่อคำตอบที่ถูกต้อง ดังนั้น
คอนฟิกที่แม่นยำน้อยกว่าเล็กน้อยแต่ถูกกว่ามากสามารถ (และมักจะ) แซงคอนฟิกที่แพงกว่าและ
แม่นยำกว่าเล็กน้อย ให้ดูคอลัมน์ $/correct ไม่ใช่แค่ความแม่นยำ
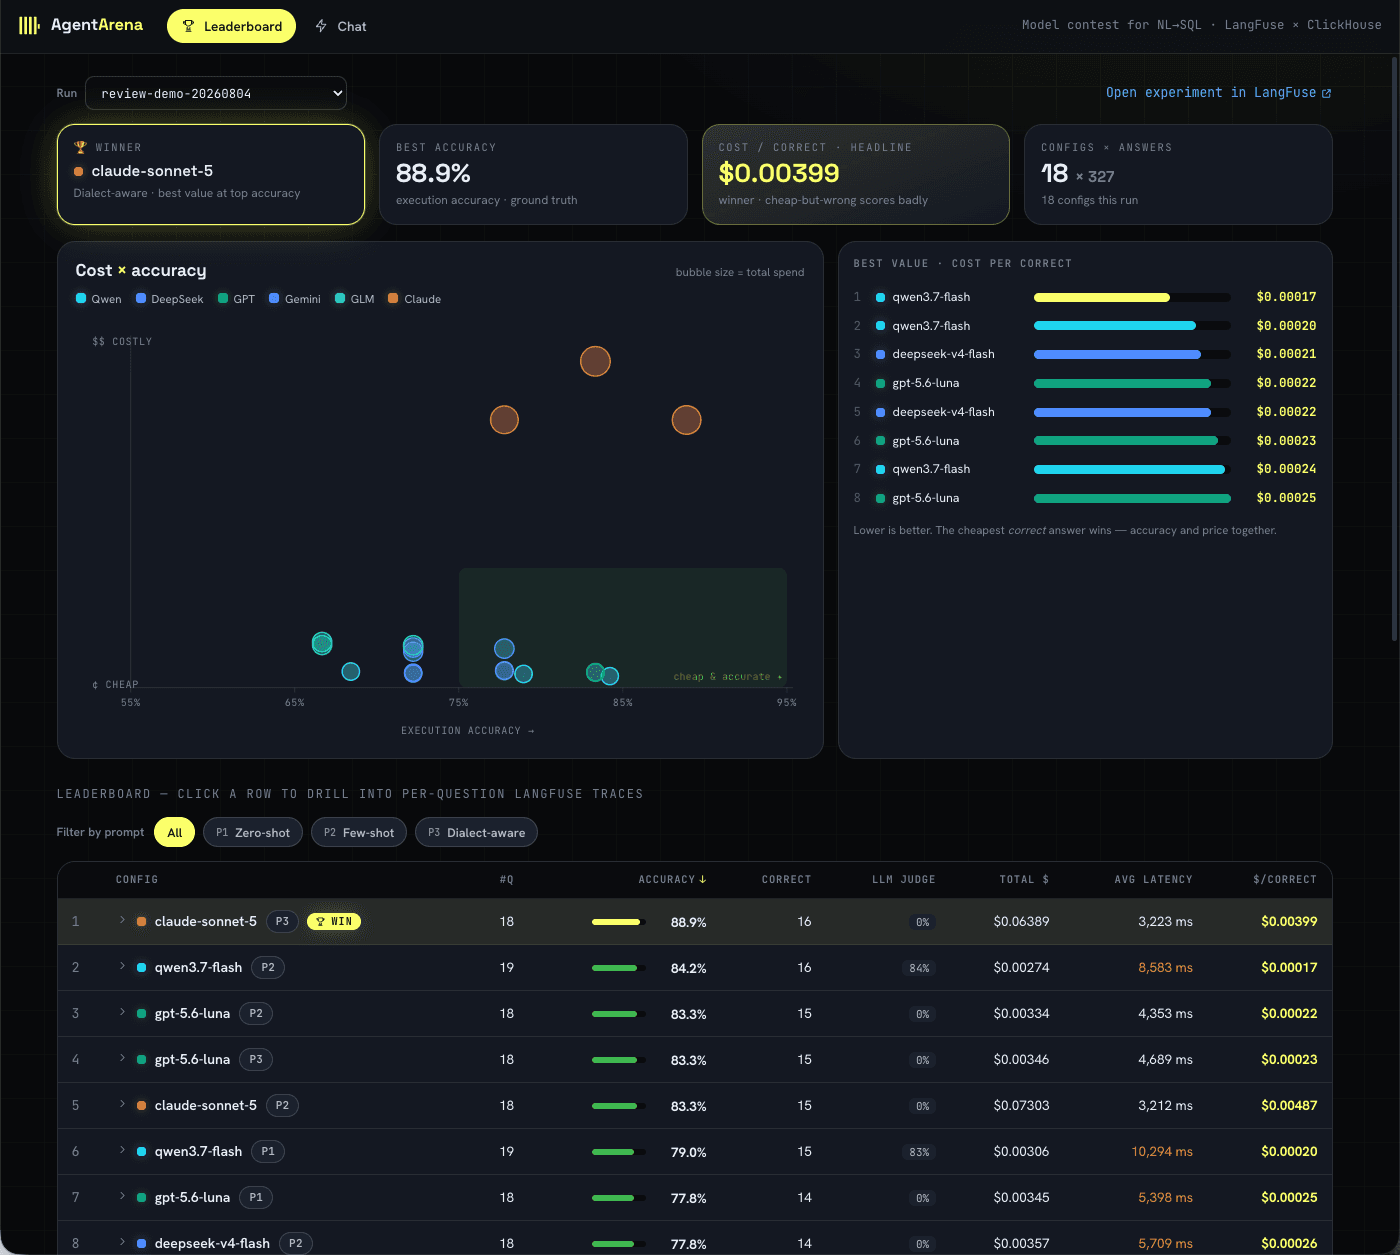
Leaderboard วางคุณภาพและราคาไว้เคียงกัน กราฟ cost × accuracy แสดง
การแลกเปลี่ยนนั้นให้เห็นด้วยตา ขณะที่รายการ best-value และคอลัมน์ $/correct เผยว่าคอนฟิก
ไหนเปลี่ยนเงินที่จ่ายให้เป็นคำตอบที่ถูกต้องได้มีประสิทธิภาพที่สุด
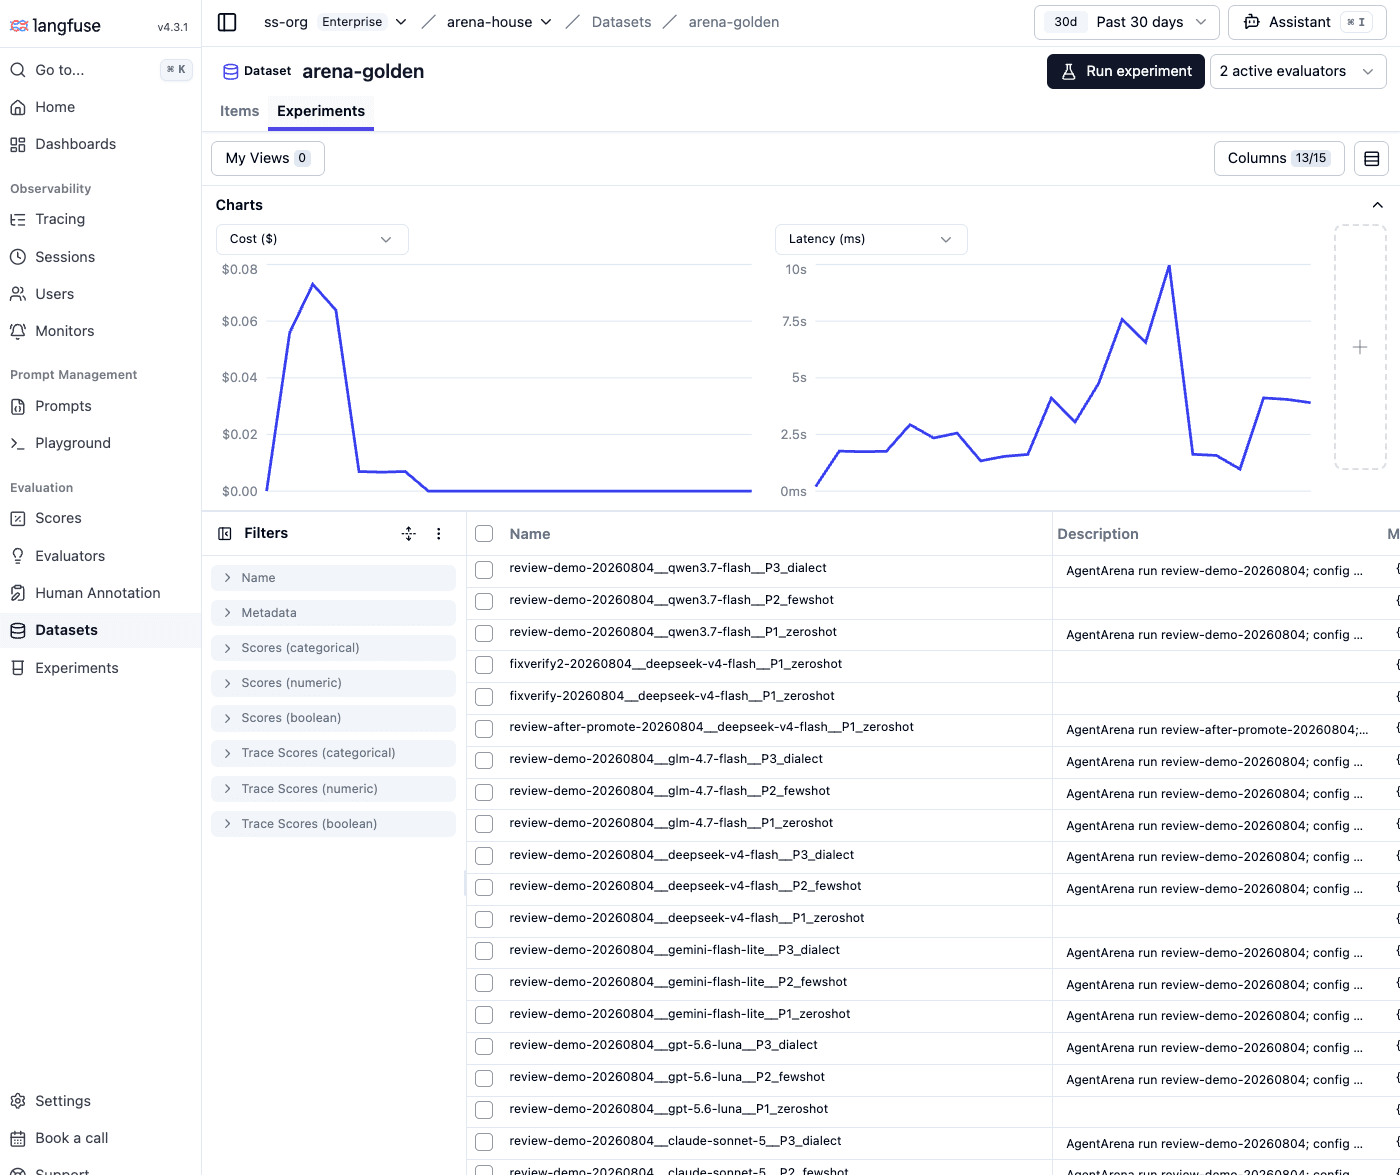
แท็บ Experiments ของ arena-golden ใน Langfuse มี Dataset Run หนึ่งชุดต่อทุกคอนฟิก โมเดล ×
prompt กราฟสรุปต้นทุนและ latency บน golden question ชุดเดียวกัน
ดังนั้นแต่ละแถวเทียบกันได้ตรง ๆ
แถวบนสุดคือผู้ชนะของคุณ: จด config_id ของมันไว้ โมดูล 02
จะเจาะลึกว่ามันดีแค่ไหนจริง ๆ ไม่ใช่แค่ว่ามันชนะ
วิธีตรวจสอบว่าคุณทำเสร็จแล้ว
- ตาราง Leaderboard แสดงแถว
model × promptอย่างน้อยหนึ่งแถวที่มีค่า ต้นทุนต่อคำตอบที่ถูกต้อง (ไม่ว่างเปล่า) - คลิกแถวของคอนฟิกแล้วเห็นผลลัพธ์รายคำถาม และคลิกคำถามแล้วเปิด Langfuse trace ของมันโดยเห็น SQL ที่ถูกสร้างขึ้น
- คุณบอกชื่อ
config_id(<model>__<prompt>) ที่ Arena คัดให้เป็นผู้ชนะได้
แบบฝึกหัด — ทำนายก่อน แล้วตรวจ
ก่อนที่คุณจะเปิด Leaderboard จริง ๆ ให้ทำนายแล้วจดไว้:
- โดยดูแค่รายชื่อโมเดลและตาราง prompt ด้านบน (ไม่ดู Leaderboard)
เดาว่าคอนฟิก
model × promptไหนที่คุณคิดว่าจะชนะด้านต้นทุนต่อคำตอบที่ถูกต้อง จดconfig_idไว้พร้อมเหตุผลหนึ่งประโยค (เช่น "โมเดลที่ถูกที่สุดจับคู่กับ prompt แบบ dialect เพราะความล้มเหลวส่วนใหญ่เป็นความผิดพลาดเรื่อง dialect ไม่ใช่ความผิดพลาด เรื่องการให้เหตุผล") - ตอนนี้เปิด Leaderboard แล้วตรวจดู คุณทายถูกไหม
- ผลจะเป็นอย่างไรก็ตาม ให้ตอบข้อนี้: โมเดลที่ถูกกว่าเอาชนะ (หรือเข้าใกล้) โมเดล frontier หรือไม่? ถ้าใช่ ช่องว่างนั้น — ถูกและเกือบดีเท่ากันเอาชนะ แพงและดีกว่าเล็กน้อย — คือ ประเด็นของการจัดอันดับด้วยต้นทุนต่อคำตอบที่ถูกต้อง แทนที่จะใช้ความแม่นยำดิบ ถ้าโมเดล frontier ชนะขาด ให้จดว่ามันชนะคอนฟิก ที่ถูกรองลงมาไปเท่าไร — ส่วนต่างนั้นคือสิ่งที่จะทำให้ราคาของมันสมเหตุสมผลในการ ตัดสินใจ deploy จริง
สรุปปิดท้าย
ตอนนี้คุณมีหลักฐาน ไม่ใช่การเดา ว่าโมเดลและกลยุทธ์ prompt ไหนคุ้มที่จะ
รัน — จัดอันดับด้วยต้นทุนต่อคำตอบที่ถูกต้องและมี Langfuse trace รองรับทุก
การรัน จด config_id ที่ชนะของคุณไว้; คุณจะใช้มันในทุกโมดูลจากนี้ไป
สถานะสุดท้าย
leaderboard ที่จัดอันดับแล้วและ config_id ที่ถูกคัดเป็นผู้ชนะ ไปต่อที่
02 วัดคุณภาพ เพื่อดูว่าผู้ชนะนั้นดีแค่ไหนจริง ๆ