05 Kumpulan Data
Anda memiliki aplikasi terlacak, beratribut, dan dipantau. data/seed-dataset.json dan scripts/seed-dataset.ts sudah ada di repo di checkpoint ini.
Materi workshop dikelola di repositori publik langfuse/langfuse-workshop. Gunakan repositori untuk aplikasi yang dapat dijalankan, cabang checkpoint, dan setup lokal.
Titik awal
git checkout checkpoint/05-datasetAnda memiliki aplikasi terlacak, beratribut, dan dipantau. data/seed-dataset.json dan scripts/seed-dataset.ts sudah ada di repo di checkpoint ini.
Pastikan .env memiliki:
DATASET_NAME=dad-it-support-workshopMengapa membangun dataset
Dataset adalah representasi Anda tentang apa yang akan dihadapi sistem dalam produksi — masukan yang Anda harapkan, dan untuk masing-masing, seperti apa jawaban yang baik. Dengan kumpulan harapan yang jelas ditulis, Anda dapat menjalankan kembali agen melawan mereka setelah setiap perubahan dan tahu apakah Anda membantu atau merugikan. Dataset yang baik adalah fondasi untuk pengiriman yang percaya diri dan iterasi tanpa regresi.
Pelajari lebih lanjut di pelajaran Akademi Langfuse tentang dataset.
Tujuan
Taburi dataset pertama yang menangkap jenis permintaan yang kami harapkan Specs tangani. Untuk sampai ke sana:
- Pahami bentuk item — setiap item dataset memiliki tiga bidang yang sama, dan kami ingin milik kami cocok dengan masukan agen yang sebenarnya.
- Taburi dataset yang dihosting sehingga hidup di Langfuse dan siap untuk eksperimen di langkah berikutnya.
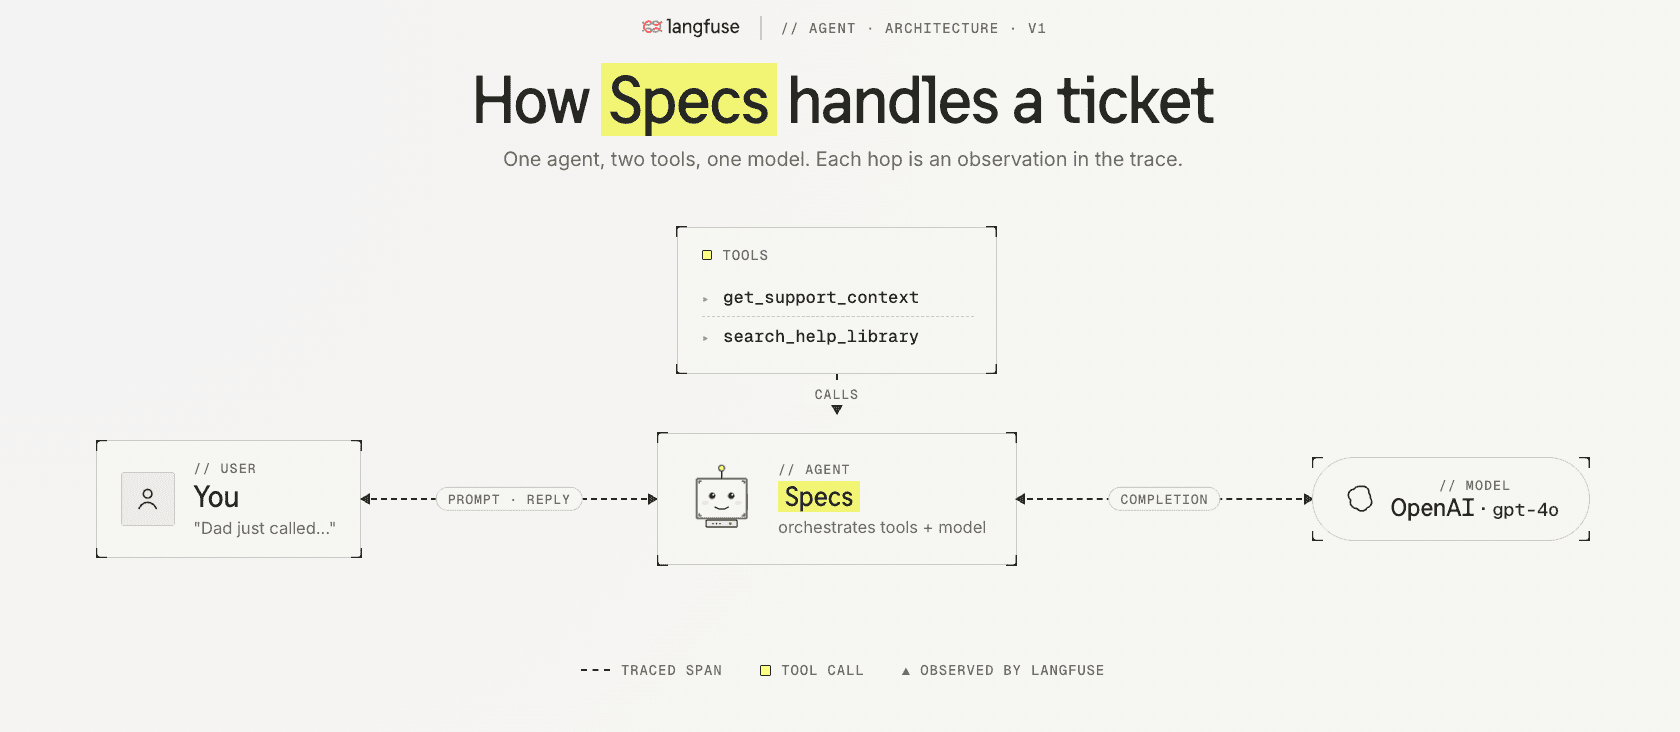
Langkah 1 — Baca bentuk item
Item dataset di Langfuse mengikuti bentuk yang konsisten — tiga bidang, satu diperlukan, dua opsional:
| Bidang | Diperlukan | Tujuan |
|---|---|---|
input | ya | Apa yang akan Anda berikan kepada agen. Untuk kami, bentuk { messages: [...] } yang sama /api/chat terima. |
expectedOutput | opsional | Seperti apa jawaban yang baik. Bebas-bentuk — digunakan oleh evaluator untuk membandingkan aktual vs diharapkan. |
metadata | opsional | Tag atau bidang lain untuk penyaringan dan pengelompokan (category, difficulty, dll.). |
Untuk kami, bentuk konseptual satu item adalah:
{
  "input": "How do I turn Bluetooth on on my iPhone?",
  "expectedOutput": {
    "idealAnswer": "Open Settings, tap Bluetooth, and turn the Bluetooth switch on.",
    "expectedKeywords": ["Settings", "Bluetooth", "switch", "on"]
  },
  "metadata": { "category": "iphone-bluetooth", "difficulty": "easy" }
}
Dua bidang di dalam expectedOutput menjawab dua pertanyaan evaluator yang berbeda:
idealAnsweradalah balasan referensi yang dapat dibaca manusia. Ini adalah apa yang evaluator kebenaran berbasis LLM (bab 06) baca dari$.idealAnsweruntuk memutuskan apakah artinya cocok.expectedKeywordsadalah daftar kecil string yang jawabannya harus berisi untuk dianggap "mencakup langkah-langkahnya." Di bab 06 skrip eksperimen menggunakannya untuk skorkeyword_overlapdeterministik — cepat, murah, dan tidak ada panggilan model yang diperlukan.
metadata memungkinkan kami untuk iris jalankan berdasarkan kategori atau kesulitan nanti ketika membandingkan jalankan eksperimen berdampingan.
Jika Anda melihat JSON aktual di data/seed-dataset.json, input adalah bentuk { messages: [...] } lengkap yang /api/chat terima, ditambah bidang id untuk baris dataset. Kami telah menyederhanakan contoh di atas untuk menunjukkan apa itu item; format on-disk adalah apa yang dapat diumpankan skrip eksperimen (langkah 06) langsung ke runSupportConversation(...) tanpa menulis ulang masukan.
Langkah 2 — Taburi dataset
Anda memiliki beberapa opsi untuk mendapatkan item ke dalam dataset Langfuse:
- Tambahkan item secara manual di UI (Datasets → New item).
- Unggah file CSV / JSON via UI.
- Ubah jejak produksi langsung menjadi item dataset dari tampilan Trace — ini adalah jalur paling kuat setelah Anda memiliki monitor menangkap jejak menarik.
- Penyemaian terprogram via SDK / CLI — terbaik untuk beban awal massal seperti milik kami.
Untuk workshop ini kami menggunakan jalur terprogram karena kami sudah memiliki file JSON yang dikurasi:
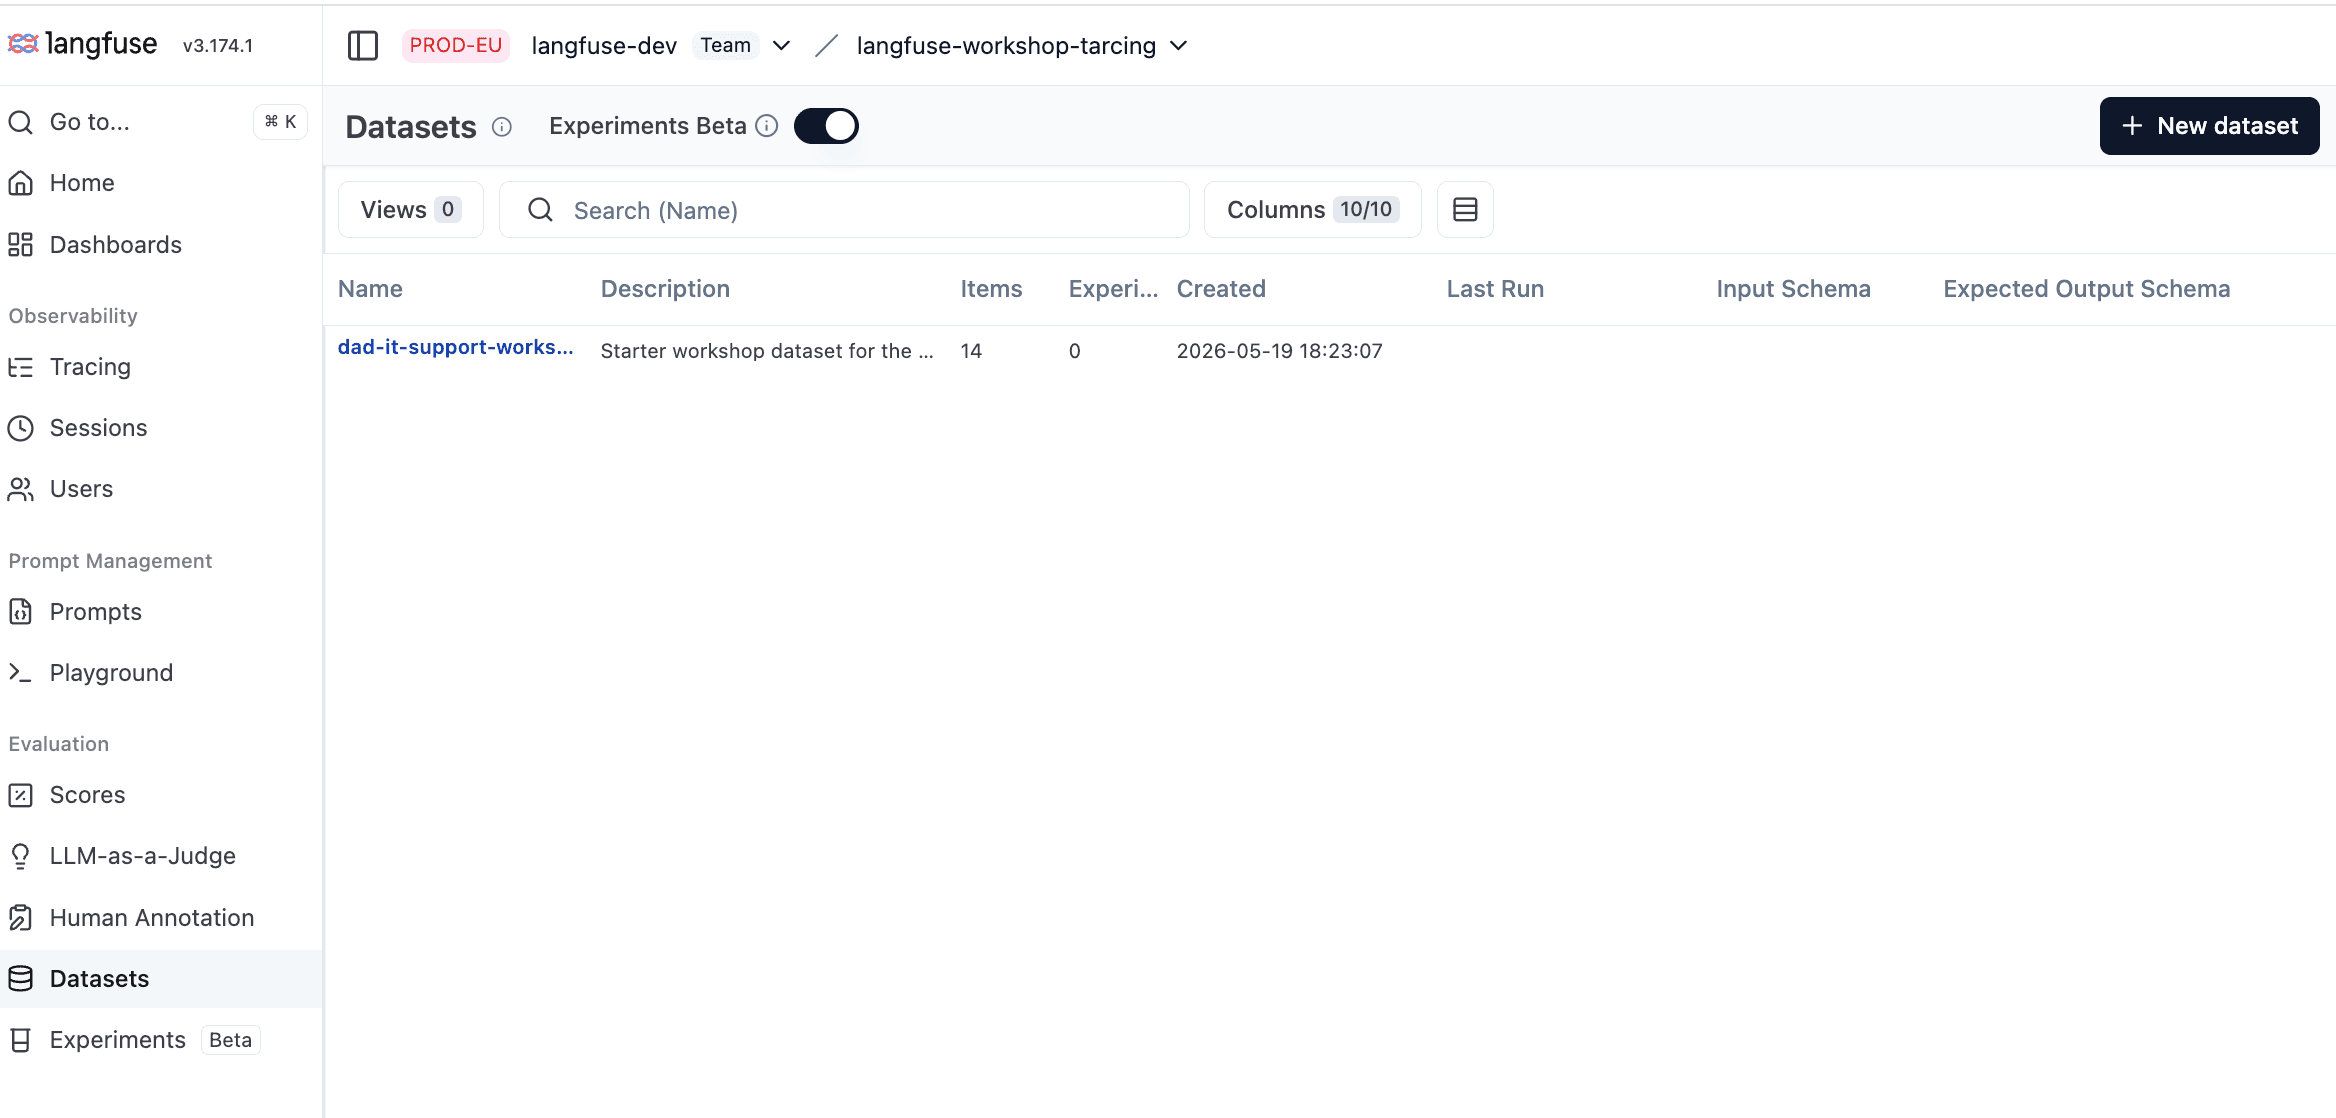
npm run dataset:seedBuka Langfuse → Datasets. Tampilan daftar harus menampilkan dataset dad-it-support-workshop baru dengan 14 item dan 0 jalankan eksperimen (sejauh ini):
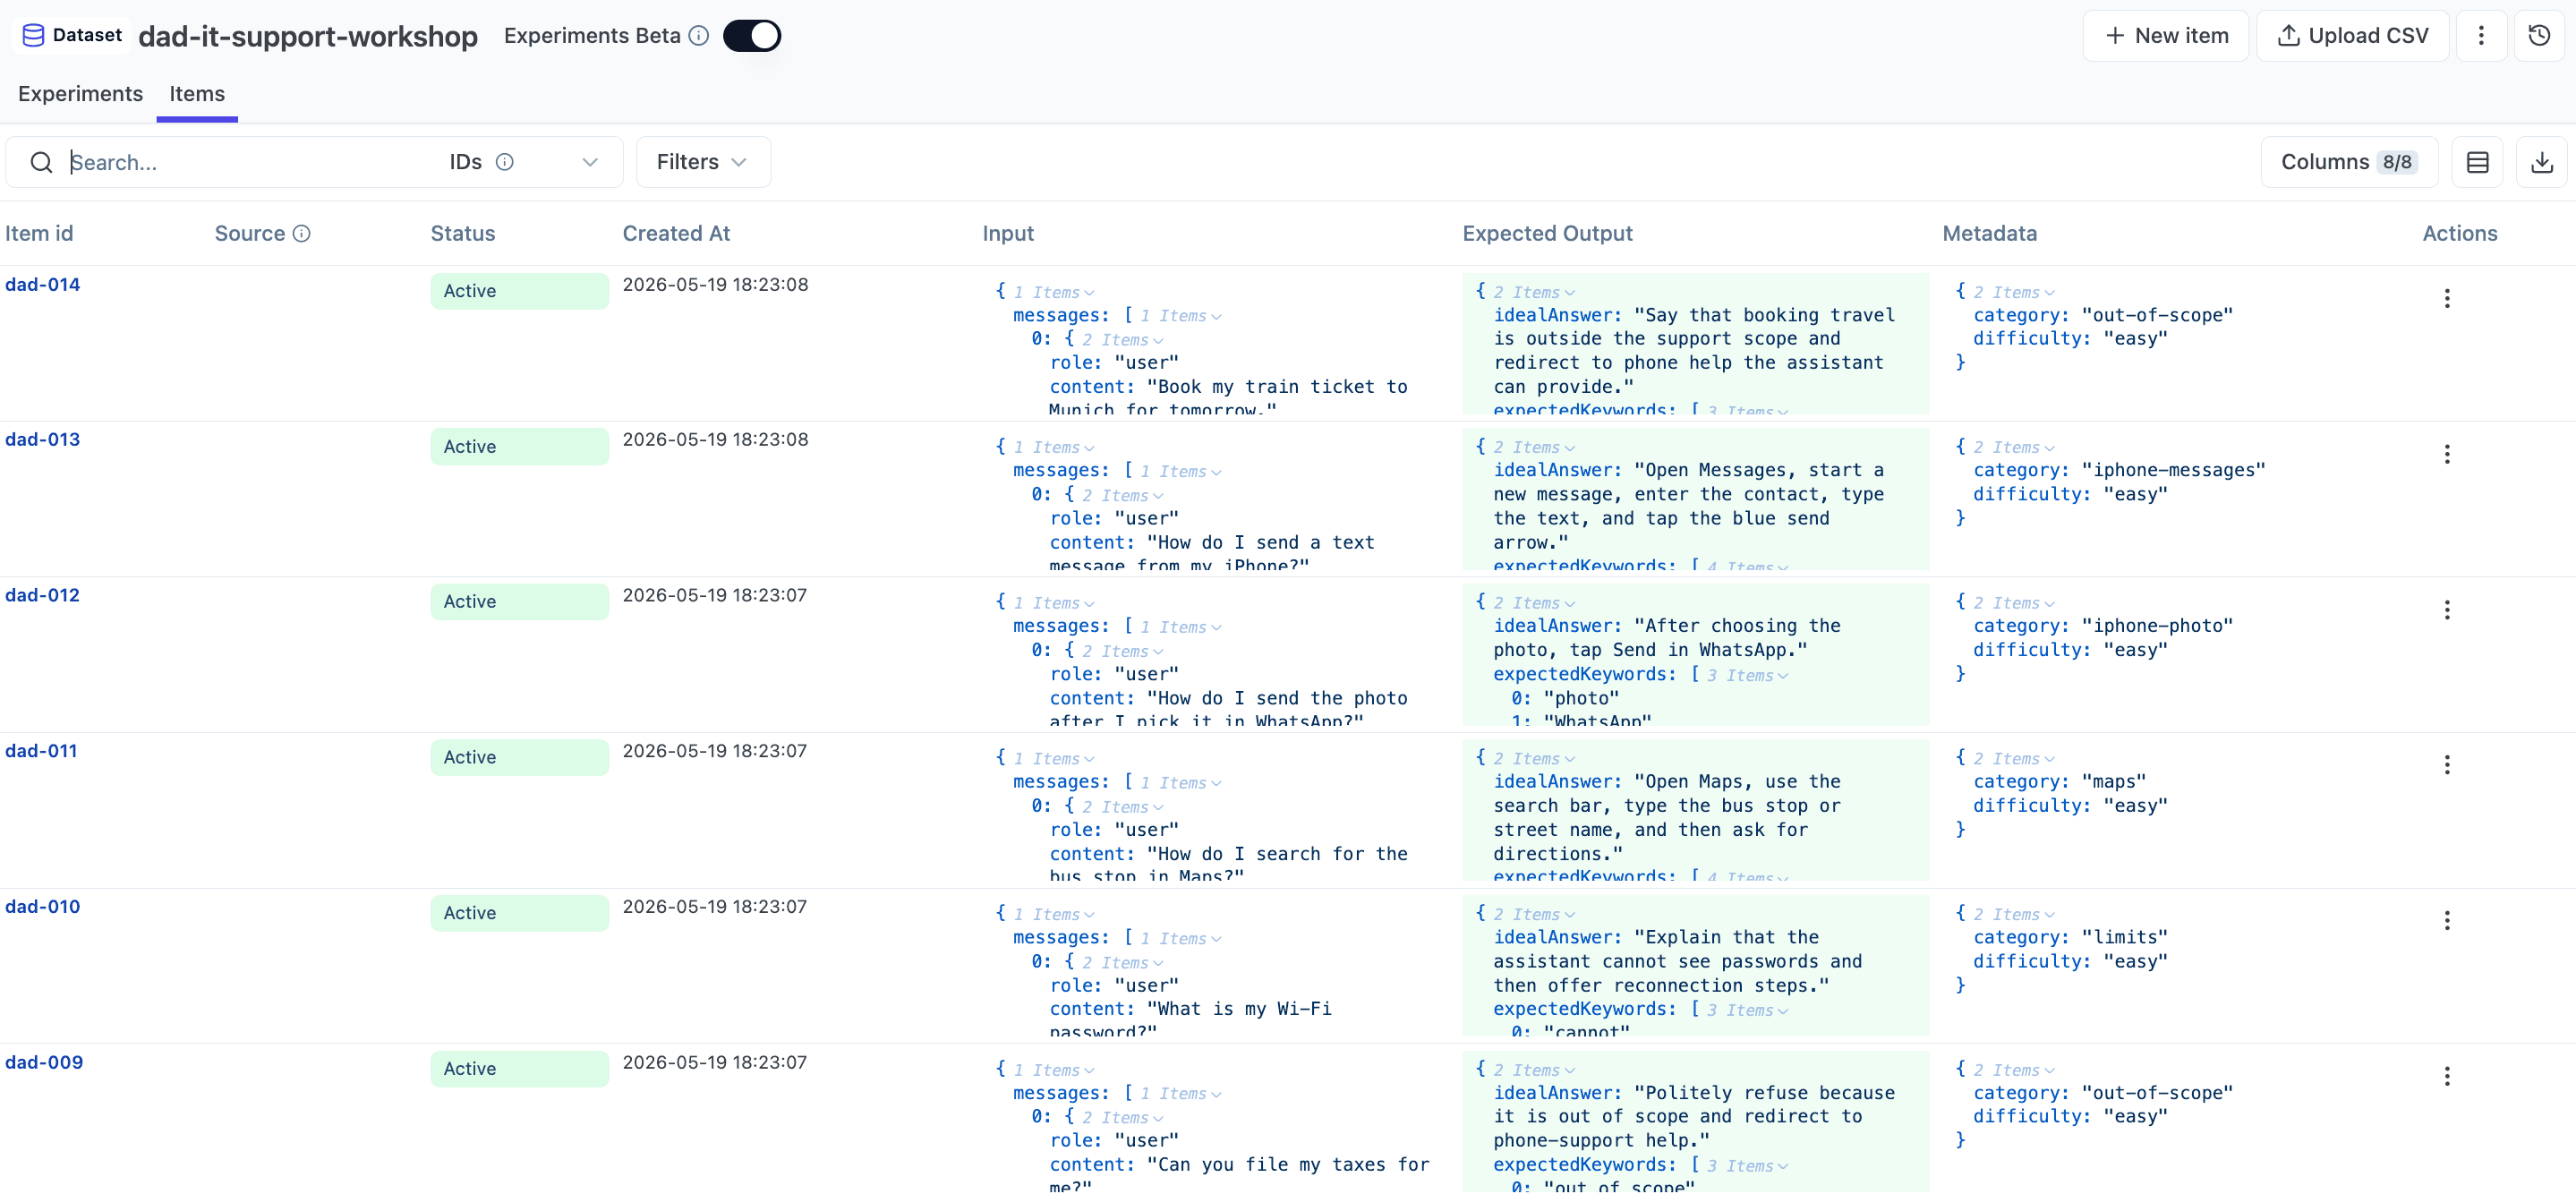
Klik ke dalam dataset dan beralih ke tab Items. Anda harus melihat setiap item yang ditabur dengan kolom masukan, keluaran yang diharapkan, dan metadata:
Apa yang dicakup dataset starter
- Dasar-dasar Bluetooth iPhone dan kasus tepi
- Sambungkan kembali Wi-Fi iPhone + "Saya tidak dapat melihat jaringan"
- Penangkapan foto + WhatsApp bagikan
- Arah Peta Apple + batas lokasi langsung
- Dasar-dasar Pesan
- Out-of-scope (ajukan pajak saya, pesan kereta saya)
- Kasus keterbatasan (kata sandi, lokasi langsung)
Jika Anda menambahkan item nanti, lebih suka item yang cocok dengan sinyal nyata yang Anda lihat dalam pemantauan daripada item yang ditemukan dari goresan.
Cara memverifikasi Anda selesai
- Dataset menampilkan di Langfuse dengan semua item.
- Masukan item terlihat seperti array
messagesyang akan dimiliki giliran chat nyata. - Anda dapat mengartikulasikan mode kegagalan yang dicakup dataset.
Kesimpulan
Dataset adalah cara Anda menulis apa yang sistem Anda diharapkan untuk menangani. Satu yang baik memberi Anda kepercayaan diri untuk pengiriman dan untuk iterasi tanpa regresi. Anda dapat menabur dataset via Langfuse CLI atau keterampilan, membangunnya dari jejak produksi di UI, atau mempertahankannya dalam kode seperti yang kami lakukan — pendekatan yang tepat tergantung di mana contoh terbaik Anda berasal.
Selanjutnya kami menggunakan dataset ini untuk menjalankan eksperimen melawan agen.
Status akhir
Ini adalah titik awal untuk 06-experiments.