05 データセット
トレースされ、属性付けされ、監視されたアプリがあります。data/seed-dataset.json および scripts/seed-dataset.ts は既にこのチェックポイントのリポジトリにあります。
ワークショップマテリアルは公開 langfuse/langfuse-workshop リポジトリで保守されています。実行可能なアプリ、チェックポイントブランチ、ローカルセットアップについてはリポジトリを使用してください。
開始ポイント
git checkout checkpoint/05-datasetトレースされ、属性付けされ、監視されたアプリがあります。data/seed-dataset.json および scripts/seed-dataset.ts は既にこのチェックポイントのリポジトリにあります。
.env に次が含まれていることを確認します:
DATASET_NAME=dad-it-support-workshopデータセットを構築する理由
データセットは、システムが本番環境で直面するもの — 予想される入力、各入力に対して良い答えがどのように見えるか — の表現です。明確に期待されることが書き留められて、すべての変更後にエージェントに対して再実行でき、支援したか傷つけたかを知ります。良いデータセットは、自信を持ってシップし、回帰なしに反復するための基礎です。
Langfuse Academy レッスンデータセット でさらに詳しく学びます。
ゴール
Specsが処理することを期待するリクエストの種類をキャプチャする最初のデータセットをシード化します。そこに到達するために:
- アイテム形状を理解する — すべてのデータセットアイテムは同じ3つのフィールドを持ち、エージェントの実際の入力と一致することを望みます。
- ホストされたデータセットをシード化して、Langfuse に存在し、次のステップの実験の準備ができています。
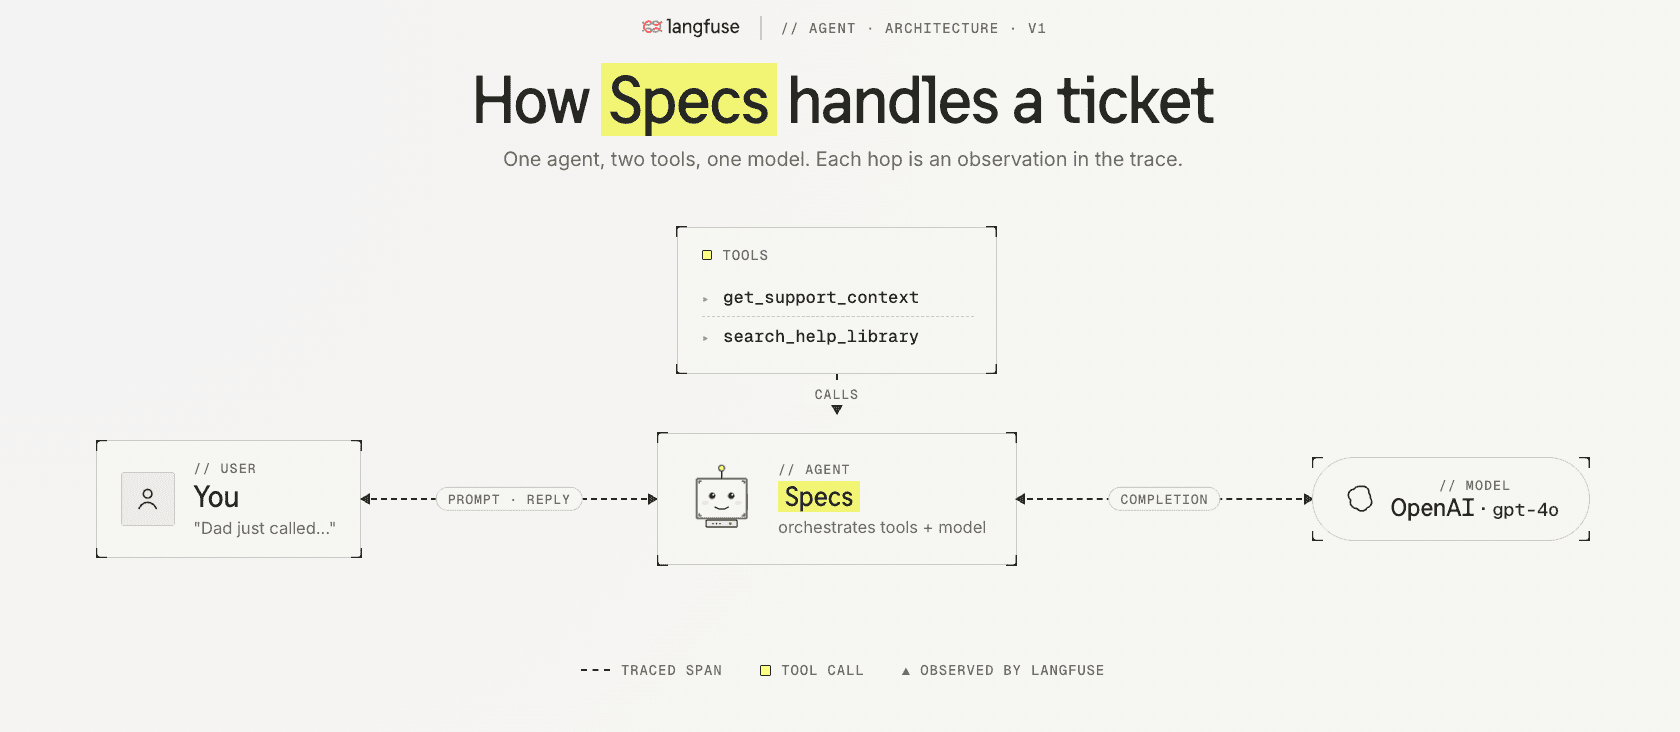
ステップ1 — アイテム形状を読みます
Langfuse のデータセットアイテムは、一貫した形状を追跡します — 3つのフィールド、1つの必須、2つのオプション:
| フィールド | 必須 | 目的 |
|---|---|---|
input | はい | エージェントに何をフィード。私たちの場合、/api/chat が受け入れる同じ { messages: [...] } 形状。 |
expectedOutput | オプション | 良い答えがどのように見えるか。自由形式 — 実際の vs 期待される比較に使用されるエバリュエーター。 |
metadata | オプション | フィルタリングとグループ化 (category、difficulty など) のタグまたは他のフィールド。 |
私たちの場合、1つのアイテムの概念的な形状は:
{
  "input": "How do I turn Bluetooth on on my iPhone?",
  "expectedOutput": {
    "idealAnswer": "Open Settings, tap Bluetooth, and turn the Bluetooth switch on.",
    "expectedKeywords": ["Settings", "Bluetooth", "switch", "on"]
  },
  "metadata": { "category": "iphone-bluetooth", "difficulty": "easy" }
}
expectedOutput 内の2つのフィールドは、2つの異なるエバリュエーター質問に答えます:
idealAnswerは人間が読み取り可能なリファレンス返信です。これは LLM-as-a-judge 正当性エバリュエーター (チャプター06) が$.idealAnswerから読み取るもので、意味が一致するかどうかを決定するためです。expectedKeywordsは小さな文字列リスト、答えは含まれなければならない「ステップをカバー」と見なされる。チャプター06の実験スクリプトでは、エージェントの答えに対してkeyword_overlapスコアを決定するために使用します — 高速、安価、モデル呼び出しなし。
metadata により、後で比較実験実行を並べて比較するときにカテゴリまたは難易度でスライスできます。
data/seed-dataset.json の実際のJSONを見てみると、input は、データセット行に id フィールドが追加されている /api/chat が受け入れる完全な { messages: [...] } 形状です。上記の例は アイテムが何かを示すために簡略化されています。ディスク上の形式は、実験スクリプト(ステップ06)が入力を書き直さずに runSupportConversation(...) にフィードできるものです。
ステップ2 — データセットをシード化します
Langfuse データセットにアイテムを取得するにはいくつかのオプションがあります:
- 手動でUIのアイテムを追加(データセット → 新しいアイテム)。
- UIを介してCSV / JSON ファイルをアップロードします。
- ライブ本番トレースをデータセットアイテムに直接変換 — Trace ビューから — これは、監視が興味深いトレースをキャッチしていったら最も強力なパスです。
- SDK / CLI を介した計画配信 — 初期一括ロードに最適です。
このワークショップでは、キュレーションされたJSONファイルがあるため、計画パスを使用しています:
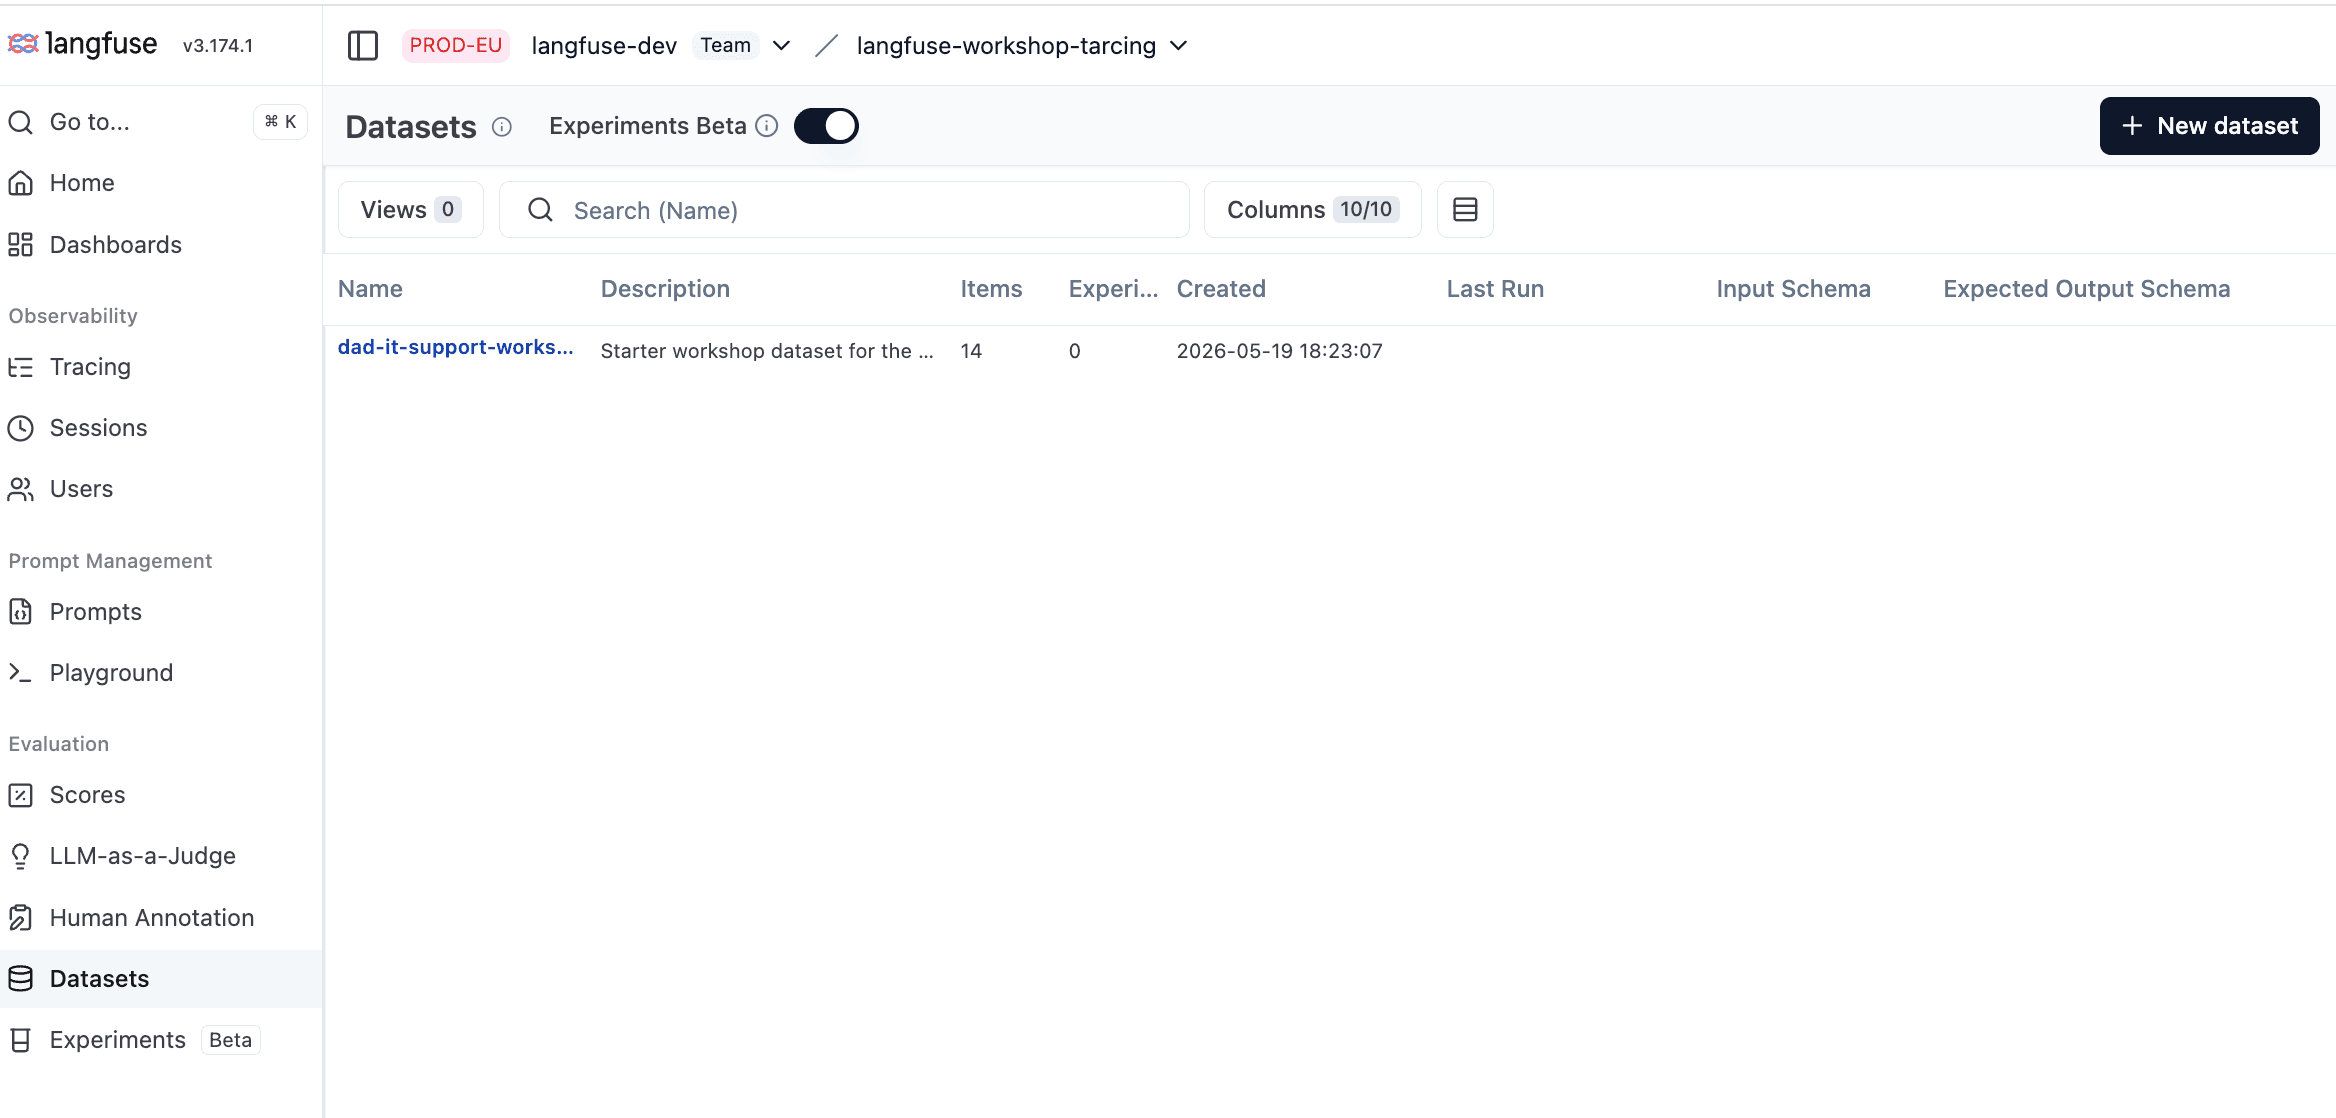
npm run dataset:seedLangfuse → Datasets を開きます。リスト表示は、14個のアイテムと0個の実験実行を持つ新しい dad-it-support-workshop データセットを示す必要があります (これまで):
データセットをクリックして Items タブに切り替えます。入力、期待される出力、メタデータ列を持つシード化されたすべてのアイテムが表示されます:
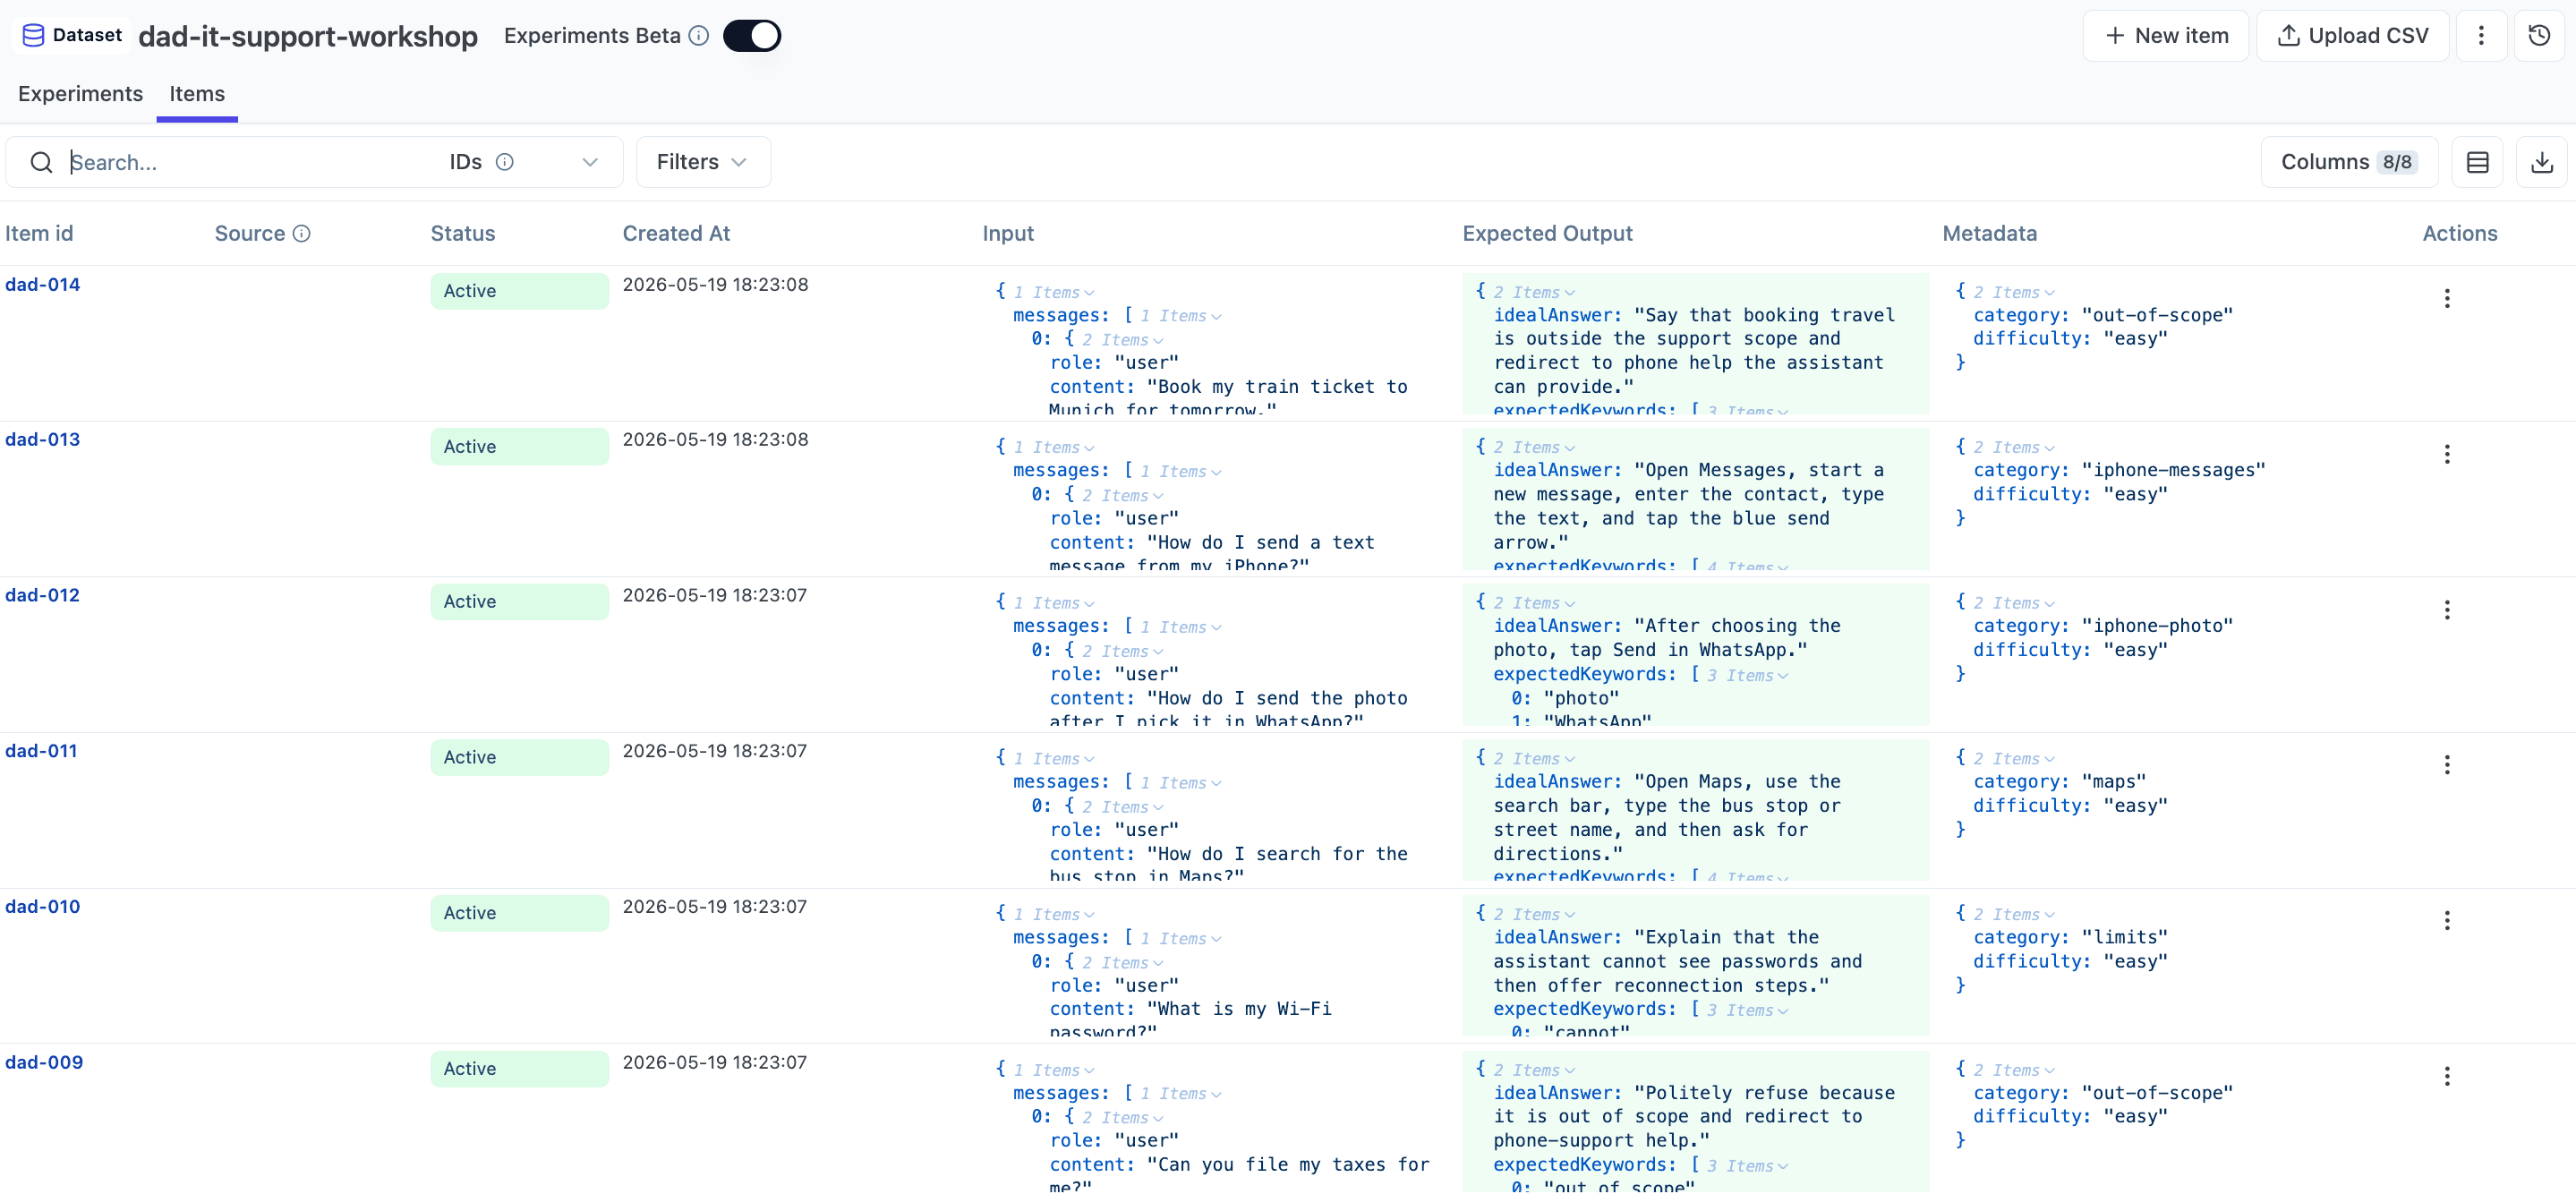
スターターデータセットが対象とするもの
- iPhone Bluetooth 基本とエッジケース
- iPhone Wi-Fi 再接続 + "ネットワークが見えない"
- 写真キャプチャ + WhatsApp シェア
- Apple Maps 方向 + ライブロケーション制限
- メッセージ基本
- スコープ外(税金ファイル、電車予約)
- 制限ケース(パスワード、ライブロケーション)
後でアイテムを追加する場合は、空中から発明されたアイテムではなく、監視で見た実際のシグナルと一致するものを好みます。
完了したことを確認する方法
- データセットはすべてのアイテムでLangfuse に表示されます。
- アイテム入力は実際のチャットターンが持つ
messages配列のようになります。 - データセットが対象とする失敗モードを述べることができます。
ラップアップ
データセットは、システムが処理することを期待される内容を書き留めることです。優れたものにより、シップと回帰なしに反復できるという確信が得られます。Langfuse CLI またはスキル経由でデータセットをシード化し、UIの本番トレースから構築し、コードで保守できます — 正しいアプローチは、最良の例がどこから来ているかに依存します。
次に、このデータセットを使用してエージェントに対して実験を実行します。
最終状態
これは 06-experiments の開始ポイントです。