01 选出基座模型
Arena,以 Langfuse experiments 的形式跑模型 × prompt 网格,并按每个正确答案的成本选出冠军。
起点
模块 00 已完成:.env 已 source,arena 数据库已初始化,Langfuse 已接通,
本地 dashboard 可在 http://localhost:5174 打开,Leaderboard 标签页为空。
为什么这是最基础的决策
整门课程都围绕这个决策展开。在你把一个正式的 agent 上线之前, 你必须回答一个根本问题:该由哪个模型来驱动它? 各个模型在能力和价格上差异巨大,而最佳选择取决于你 自己的具体任务,而不是别人在另一种工作负载上跑出来的公开榜单。 靠猜在两个方向上都很贵:为一个你并不需要的前沿模型多花钱,或者 上线一个便宜模型,却在你真实的问题上悄悄答错。
所以不要猜,而是跑一场竞赛:Arena。 由模型和 prompt 策略组成的网格 全都回答同一批黄金问题,Langfuse 把每个答案作为一次 experiment 打分,而决定冠军的指标不是原始准确率,而是每个正确 答案的成本,也就是你的用例下的每美元质量。具体地说,本模块 用证据回答:在由模型和 prompt 策略组成的网格里,哪个 配置在每美元内拿到最多正确答案?"正确"指的是执行 准确率,生成的 SQL 返回与黄金 SQL 相同的结果集,而不是 仅仅看起来像那么回事的 SQL。打分发生在 Langfuse 内部,而不是在 harness 内部, Langfuse 托管 evaluators,并保存每一个 Experiment Item、score 和 trace。 本地 leaderboard 通过 Langfuse Public API 读取这些记录。本模块之后的一切 (衡量、改进、发布)都假定你已经基于证据做出了这个选择。
概念:底层原理
Langfuse 为这次评测提供的数据模型。 仓库的源语料包含 20 个 YAML 问题。
q019 和 q020 是 few-shot 提示词的保留样例,因此在全新项目中,初始化后的 Dataset
(arena-golden)包含 18 个实验问题。你运行的每一个 model × prompt 配置都是一次
Experiment,也就是一次 Langfuse Dataset Run,跑在相同的 18 个条目上。
步骤 1 中配置的 evaluator 定义是 correctness 和 llm_judge;它们实际写出的
Experiment score 是 correctness 和 agent-arena-llm-judge。一个数据集可以对应多次 experiment。
因此,Leaderboard 可以在相同条件下横向比较各个配置。
每个 model × prompt 配置都以一次 Experiment(Dataset Run)的形式跑在 arena-golden 数据集上, 每次 experiment 都会为每个数据集条目附上两个 score:correctness (0/1) 和 agent-arena-llm-judge (0..1)。
prompt 策略同样是参赛者。 这个网格不只有模型,它是
model × prompt,因为你怎么问和你问谁一样重要。摘自
config.yaml 和 agents/prompts.py:
| 提示词 | 作用 | 为什么可能有助于自然语言转 SQL |
|---|---|---|
P1_zeroshot | 只给 schema + 问题,返回一个围栏包裹的 SQL 块。基线。 | 每次调用最便宜;衡量模型在毫无帮助下的能力。 |
P2_fewshot | 在 P1 的基础上增加 2 个完整的自然语言转 SQL 示例(不在测试集内)。 | 让模型在生成答案前先了解理想答案的结构。 |
P3_dialect | P1 加上一份 ClickHouse 方言速查表(日期函数、uniqExact、argMax、INTERVAL、不要用 ILIKE……)。 | 修掉最常见的失败模式:流畅但不是合法ClickHouse SQL 的 SQL。 |
参赛阵容:闭源 vs 开放权重。 六位参赛者在第二个维度上正好一半一半, 而这个维度和模型名字一样重要,权重是 封闭的(一个你只能调用的厂商 API),还是开放的(一个你可以自行部署、微调, 或完全留在自己数据边界内的模型)。开放权重模型每 token 往往便宜得多, 而闭源前沿模型在原始能力上可能领先,但 "可能"正是这个 Arena 要针对你的任务去验证、而不是想当然的地方。让 两边跑同一份黄金数据集,就能让每个正确答案的成本告诉你,你是否 真的需要为前沿模型付费,还是一个便宜的开放权重模型只要一小部分价钱 就能满足需求。下面这份阵容特意选择了低成本模型,因为自然语言转 SQL 是 一个足够简单的任务,这里最贵的参赛者也只是中档模型,而不是 前沿模型。
| 模型 | 厂商 | 开放 / 闭源 | 示意性兜底价格($/1M 输入 · 输出) |
|---|---|---|---|
claude-sonnet-5 | Anthropic | 闭源 | $2.00 · $10.00 |
gpt-5.6-luna | OpenAI | 闭源 | $0.50 · $3.00 |
gemini-flash-lite | 闭源 | $0.30 · $2.50 | |
deepseek-v4-flash | DeepSeek | 开放权重 | $0.14 · $0.28 |
qwen3.7-flash | Qwen | 开放权重 | $0.03 · $0.13 |
glm-4.7-flash | Z.ai | 开放权重 | $0.06 · $0.40 |
为什么用每个正确答案的成本,为什么用执行准确率。 "正确"由 执行准确率判定:运行生成的 SQL,是否产生与黄金 SQL 相同的结果集? 这才是诚实的信号,它不在乎 SQL 是否 与黄金查询逐字节不同,只在乎它有没有把问题答对。而首要的排名指标是
cost_per_correct_answer = total cost of the run ($) / number of correct answers它会让一个准确率接近但便宜很多的模型胜过一个稍微更好、 却贵得多的前沿模型,这正是一个真正在意成本的团队实际会优化的 指标。
目标
一个填好数据的 Leaderboard,至少把几个 model × prompt 配置按
每个正确答案的成本排名,每一行排名背后都有一条你能深入查看的 Langfuse
trace,并选出一位冠军:一个 config_id。
步骤 1:配置 Langfuse evaluators(一次性)
按照仓库里的 eval/langfuse_evaluators/README.md 做一次即可。先初始化
arena-golden,并通过 API 配置由 OpenRouter 支撑的 judge:
python -m scripts.provision_langfuse_evaluators然后在 Langfuse UI 里配置确定性的 code evaluator:
- Code evaluator
correctness:Evaluators → Set up Evaluator → Code → 粘贴eval/langfuse_evaluators/correctness_evaluator.py→ Target: Experiments → 过滤条件 dataset =arena-golden。这个 evaluator 会把 agent 的结果集(来自 trace)与黄金结果集(数据集 条目的expected_output)比较,产出一个执行准确率correctnessscore(0/1) 以及一个outcome类别。它没有任何网络出口,SQL 已经在 agent 内部跑过了;evaluator 只负责比较结果集。 - evaluator 定义
llm_judge的手动兜底方案:Evaluators → Set up Evaluator → LLM-as-a-judge → Custom → 使用eval/langfuse_evaluators/llm_judge_prompt.md里的 system/eval prompt 和变量映射 → Target: Experiments,dataset 为arena-golden→ 输出数值型 scoreagent-arena-llm-judge。evaluator 定义和实际 score 的名称有意不同。这是在首要的 correctness score 之上评价 SQL 质量的辅助信号,你会在 模块 02 里用到它。
推荐走脚本这条路;手动配置 judge 只是兜底。
确定性的 correctness code evaluator 仍然需要在 UI 里手动配置一次。
步骤 2:跑竞赛
source .env && python -m eval.harness --run-id demo你应该看到什么。 harness 先打印一行摘要
(run_id=demo configs=6x3 ...),然后在运行过程中每个问题一行,例如:
claude-sonnet-5__P1_zeroshot q001 pending 812ms $0.00021每一行都以 pending 开头,SQL 已执行,结果集已记录在 trace 上,
但 Langfuse evaluators 还没给它打分。等所有配置都跑完之后,
harness 转入等待状态:grading via Langfuse evaluators,waiting on N traces...,随着 correctness/agent-arena-llm-judge score 陆续到位打印倒计时,
最后以 Langfuse scored all N traces; leaderboard ready 结束。这个从 pending 到
scored 的交接,就是 harness 把打分工作交给 Langfuse;结果和判定
一起留在那里,作为 leaderboard 的事实来源。
这一步会把完整的 model × prompt 网格(config.yaml 里的每个模型对每个
prompt 策略,从 P1_zeroshot 到 P3_dialect)作为 Langfuse Dataset Runs
(Experiments) 跑在 arena-golden 数据集上。harness 会等待
每个条目上出现精确的 correctness 和 agent-arena-llm-judge score。精确的 OpenRouter 成本和
端到端延迟都存在同一个 Experiment Item 上。
一个配置写作 <model>__<prompt>,例如 claude-sonnet-5__P1_zeroshot。
可用的名字直接来自 config.yaml:
- 模型: 上面阵容表里的六位参赛者,三个闭源
(
claude-sonnet-5、gpt-5.6-luna、gemini-flash-lite) 和三个开放权重(deepseek-v4-flash、qwen3.7-flash、glm-4.7-flash) - Prompt:
P1_zeroshot、P2_fewshot、P3_dialect
有用的参数:
--models qwen3.7-flash,gpt-5.6-luna/--prompts P1_zeroshot,P3_dialect: 把网格限制为一个 CSV 子集,而不是全部跑一遍。--run-id <name>:给这次运行打标签,便于在 Leaderboard 和 Langfuse 的 Experiments 视图里找到它。
SDK 可能以逆序或并发顺序处理数据集条目;请以每行上的问题 ID
为准,不要期待 q001、q002……这样的输出顺序。跑完整的 18 个配置
网格通常需要 35–45 分钟。课程开始时用两个模型、一个 prompt 的子集,
只在时间安排和 provider 限额允许时才跑完整网格。
Langfuse evaluators 是必需的。 Langfuse 现在是唯一的评测存储,因此
不存在本地打分或 ClickHouse 结果表的兜底路径。如果 harness 在等待 score 时
超时,请修好步骤 1 里的 evaluator 配置,并换一个新的 --run-id。
步骤 3:选出冠军
打开 http://localhost:5174 → Leaderboard。每个 model × prompt 配置都按
每个正确答案的成本排名,这是首要指标。表格上方是一张成本 × 准确率图和
一份"best value"排名。
成本是根据 OpenRouter 实时价格计算的,harness 会在每次运行开始时从
OpenRouter 的 /models 端点刷新模型价格,所以
每个正确答案的成本反映的是模型今天实际的价钱,而不是写死在
config.yaml 里的过期数字。
怎么读它。 排序是每个正确答案的成本升序,冠军是 最上面那一行,而不是准确率最高的那一行。在成本 × 准确率图上留意那些在准确率轴上 贴近昂贵模型的便宜模型:这种以极低成本达到的接近, 正是这个指标存在、而非用一份纯准确率 榜单的全部理由。
坑,准确率最高 ≠ 冠军。 人很容易只盯着准确率那一列,
就假定分最高的赢了。Arena 是按每个正确答案的成本排名的,所以一个
准确率略低、但便宜很多的配置可以(而且经常)排在更贵、
准确率略高的配置前面。要看 $/correct 这一列,不要只看准确率。
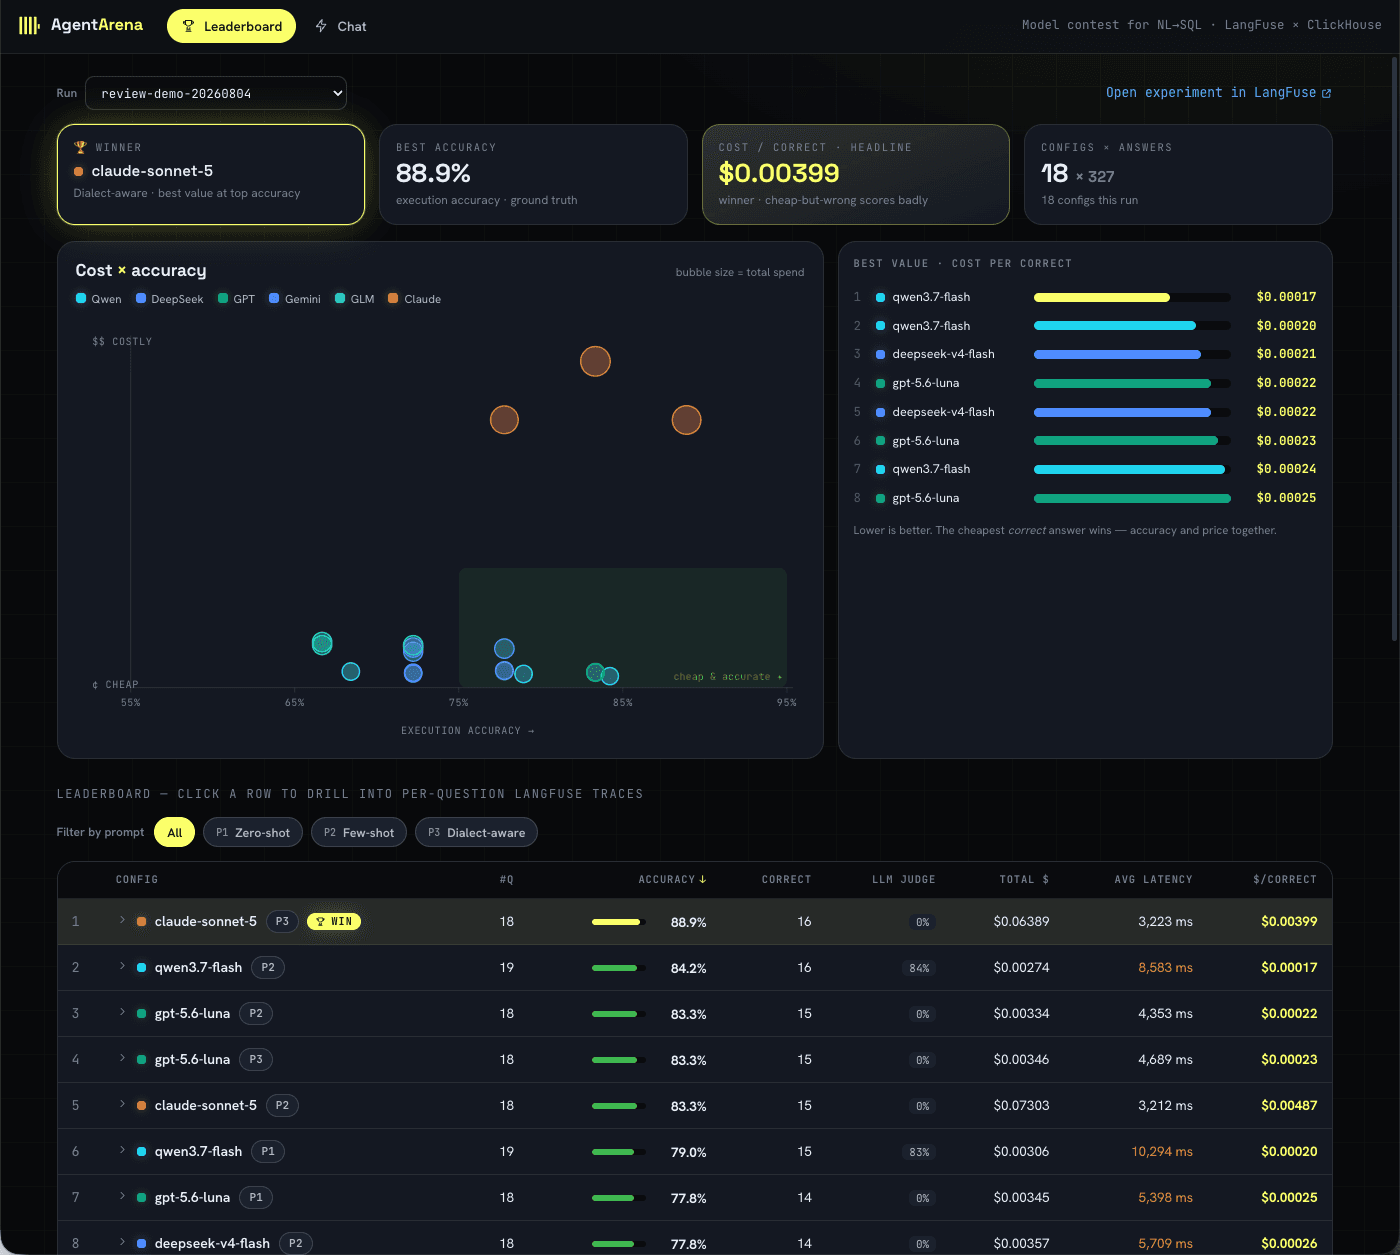
Leaderboard 把质量和价格并排放在一起。成本 × 准确率图直观展示了这种
取舍,而 best-value 列表和 $/correct 列则揭示哪些
配置把花的钱最高效地转化成了正确答案。
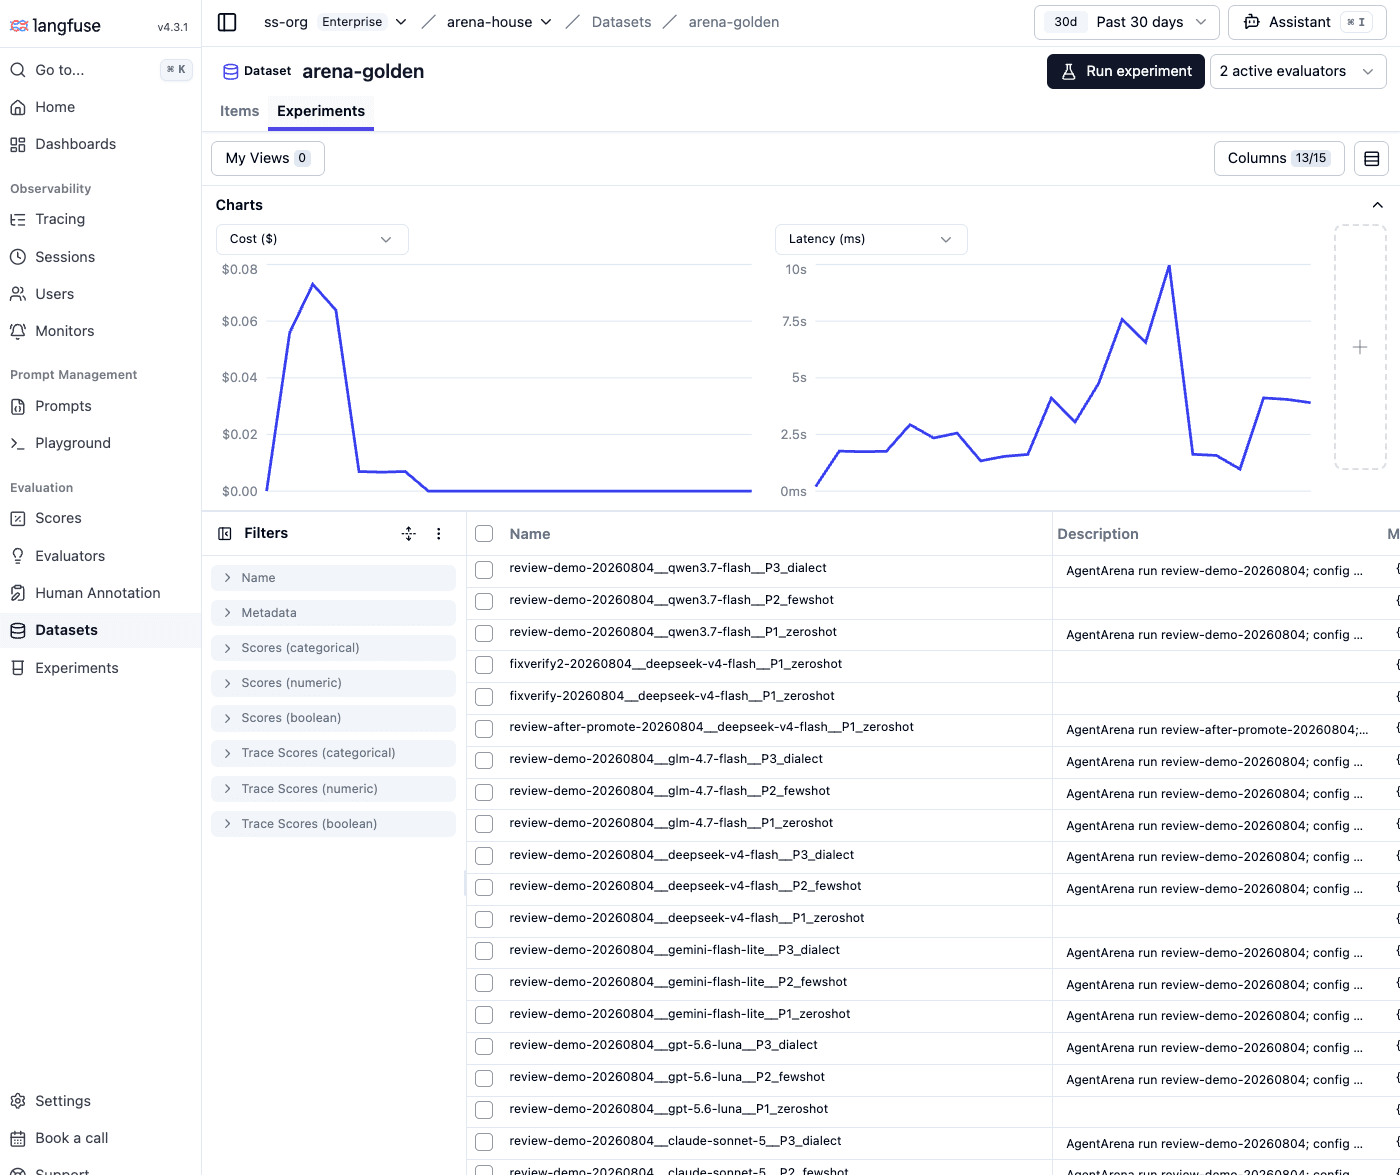
Langfuse 的 arena-golden Experiments 标签页里,每个 model ×
prompt 配置都有一次 Dataset Run。图表在同一批黄金问题上汇总了成本和延迟,
因此每一行都可以直接对比。
最上面那一行就是你的冠军:记下它的 config_id。模块 02
会深入探究它到底有多好,而不只是它赢了这件事。
如何确认你已完成
- Leaderboard 表格里至少有一行
model × prompt,带有 每个正确答案的成本值(不为空)。 - 点开某个配置那一行能看到逐题结果,点开某个问题能打开 它的 Langfuse trace,其中可以看到生成的 SQL。
- 你能说出 Arena 选出的冠军
config_id(<model>__<prompt>)。
练习:先预测,再验证
在你真正打开 Leaderboard 之前,先做个预测并写下来:
- 只看上面的模型列表和 prompt 表格(不看 Leaderboard),
猜猜你认为哪个
model × prompt配置会在每个正确答案的成本上取胜。 写下这个config_id和一句理由(例如"最便宜的模型配上 方言 prompt,因为大多数失败是方言错误,而不是推理 错误")。 - 现在打开 Leaderboard 核对。你猜对了吗?
- 无论结果如何,回答这个问题:有没有更便宜的模型打败(或接近) 前沿模型?如果有,这种差距,便宜且几乎一样好打败 昂贵且略好一点,就是按每个正确答案的成本排名、 而不是按原始准确率排名的意义所在。如果某个前沿模型完胜,记下它 领先次便宜配置多少,这个差距才是在真实 部署决策中为它的价格买单的理由。
小结
现在,关于哪个模型和 prompt 策略值得投产,你有的是证据,而不是
猜测,按每个正确答案的成本排名,每次运行都有 Langfuse trace 佐证。
记下你获胜的 config_id;从这里开始的每个模块都会用到它。
终态
一份排好名的 leaderboard 和一个加冕的 config_id。继续前往
02 衡量质量,看看那位冠军到底有多好。