02 トレーシング
これはトレースステップの白紙状態です — checkpoint/01-base-app と同じコードですが、Langfuse 配線がまだありません。Langfuse パッケージは既に package.json に含まれています — npm inst...
ワークショップマテリアルは公開 langfuse/langfuse-workshop リポジトリで保守されています。実行可能なアプリ、チェックポイントブランチ、ローカルセットアップについてはリポジトリを使用してください。
開始ポイント
git checkout checkpoint/02-tracingこれはトレースステップの白紙状態です — checkpoint/01-base-app と同じコードですが、Langfuse 配線がまだありません。Langfuse パッケージは既に package.json に含まれています — してない場合は npm install を実行します。.env に OPENAI_API_KEY とLangfuseキーが含まれていることを確認します。
トレースが必要な理由
トレースは、エージェントが実行するすべてのステップを記録します — すべてのモデル呼び出し、すべてのツール呼び出し、入った入力と返ってきた出力 — それが発生した順序で。これにより、エージェントはブラックボックスから、後で検査できるものに変わり、答えが間違っていると、推測する代わりに正確に間違ったステップをポイントできます。
より大きな視点の動機を知りたい場合は、Langfuse Academy レッスンのトレース を参照してください。技術的な詳細 (SDK オプション、OpenTelemetry 内部、スパン属性) を知りたい場合、トレース ドキュメント が詳しく説明しています。
ゴール
お父さんが「Bluetooth をオンにするにはどうすればいいですか?」と尋ねると、エージェントはOpenAIに一度ヒットするだけではありません。舞台裏では、OpenAI に何をするかを尋ね、get_support_context を呼び出してお父さんのiPhoneセットアップを取得し、OpenAI に再度尋ね、Bluetooth ステップの search_help_library を呼び出し、次に番号付きの答えを生成するためにOpenAI に3回目の質問をします。今日はそのどれも見えません。
このチャプターの目標は、Langfuse の各ステップを可視化することです — 1つのチャットターンが1つのネストされたトレースになり、エージェント実行、OpenAI世代、および2つのツール呼び出しがすべて順序で記録されます。
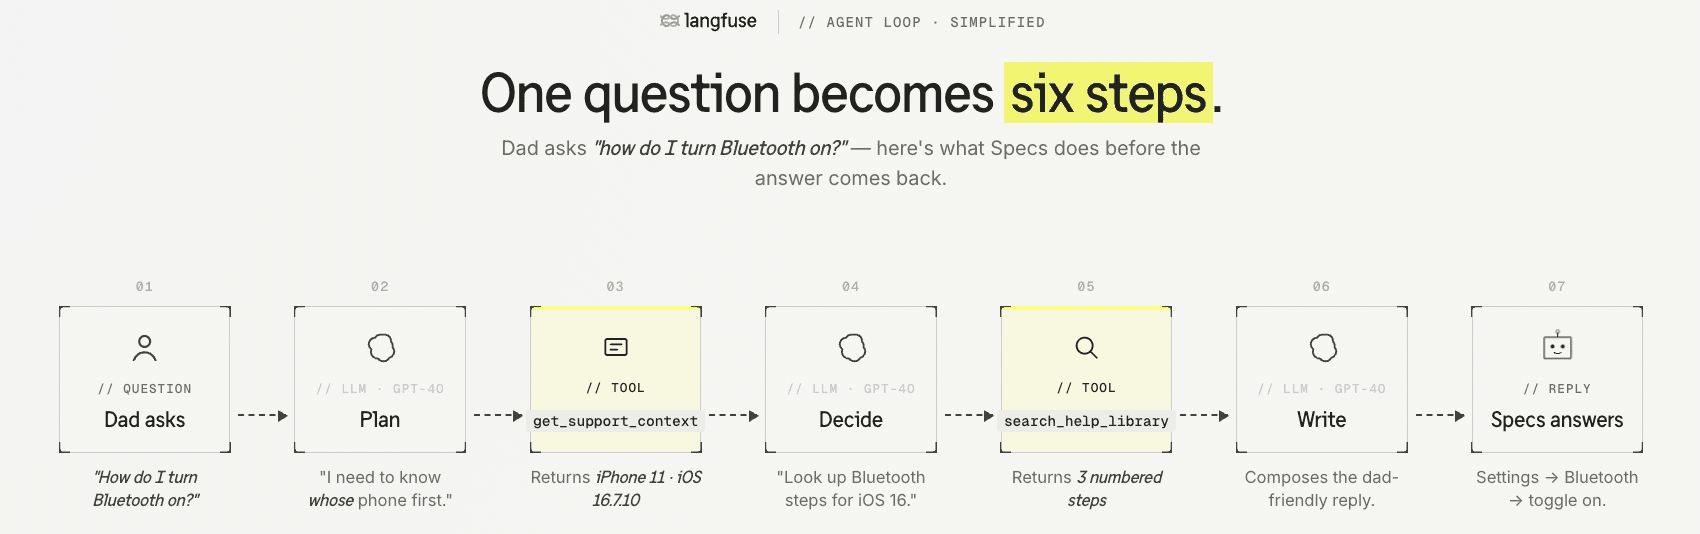
エージェントの構造をミラーリングする3つのステップでトレースを構築します:
- 最初のトレース — OpenAI世代自体をログします。
- ネストされたトレース — 世代をターンごとに1つのエージェント実行の下にグループ化します。
- ツール呼び出しの記録 — 各ツール呼び出しを独自の観察にします。
ステップ1 — 最初のトレース
入力と出力が何であるか、および費用、トークン、時間がどのくらい費やされたかを確認するために、OpenAI呼び出し自体の可視性が必要です。2つの変更で十分です。
src/server/index.ts
ファイルの上部の近くでLangfuse スパンプロセッサを開始します:
import { NodeSDK } from "@opentelemetry/sdk-node";
import { LangfuseSpanProcessor } from "@langfuse/otel";

new NodeSDK({ spanProcessors: [new LangfuseSpanProcessor()] }).start();プロセッサは、LANGFUSE_PUBLIC_KEY、LANGFUSE_SECRET_KEY、LANGFUSE_BASE_URL をNode プロセス環境から読み取ります。このワークショップでは、サーバーはLangfuse SDK が起動する前にリポジトリ .env をロードするため、エクスポートされたシェル値に依存する代わりに .env を編集します。
脇注:最後のトレースが npm run dev を停止または再起動するときに表示されることがある場合は、index.ts に戻り、上記の1行を名前付き langfuseSpanProcessor と sdk 変数に変えて、shutdown() がそれらをフラッシュできるようにします:
const langfuseSpanProcessor = new LangfuseSpanProcessor();
const sdk = new NodeSDK({ spanProcessors: [langfuseSpanProcessor] });
sdk.start();

async function shutdown() {
  server.close();
  await langfuseSpanProcessor.forceFlush();
  await sdk.shutdown();
}
トレースモデルを理解する必要はありませんが、ローカル開発で「最後のトレースはどこに行ったのか?」という混乱した瞬間を避けています。
src/server/support-agent.ts
インポートを追加します:
import { observeOpenAI } from "@langfuse/openai";そして OpenAI クライアントを作成する場所でラップしてください。runSupportConversation でこの行を見つけます:
const openai = new OpenAI({ apiKey: env.openaiApiKey });これに変更します:
const openai = observeOpenAI(new OpenAI({ apiKey: env.openaiApiKey }));これが全体的な差分です。ファクトリ関数なし、独立した生のクライアントなし — observeOpenAI はOpenAI クライアントをコール サイトでインラインでラップし、openai.chat.completions.create(...) 以下は各呼び出しのトレースを出力します。
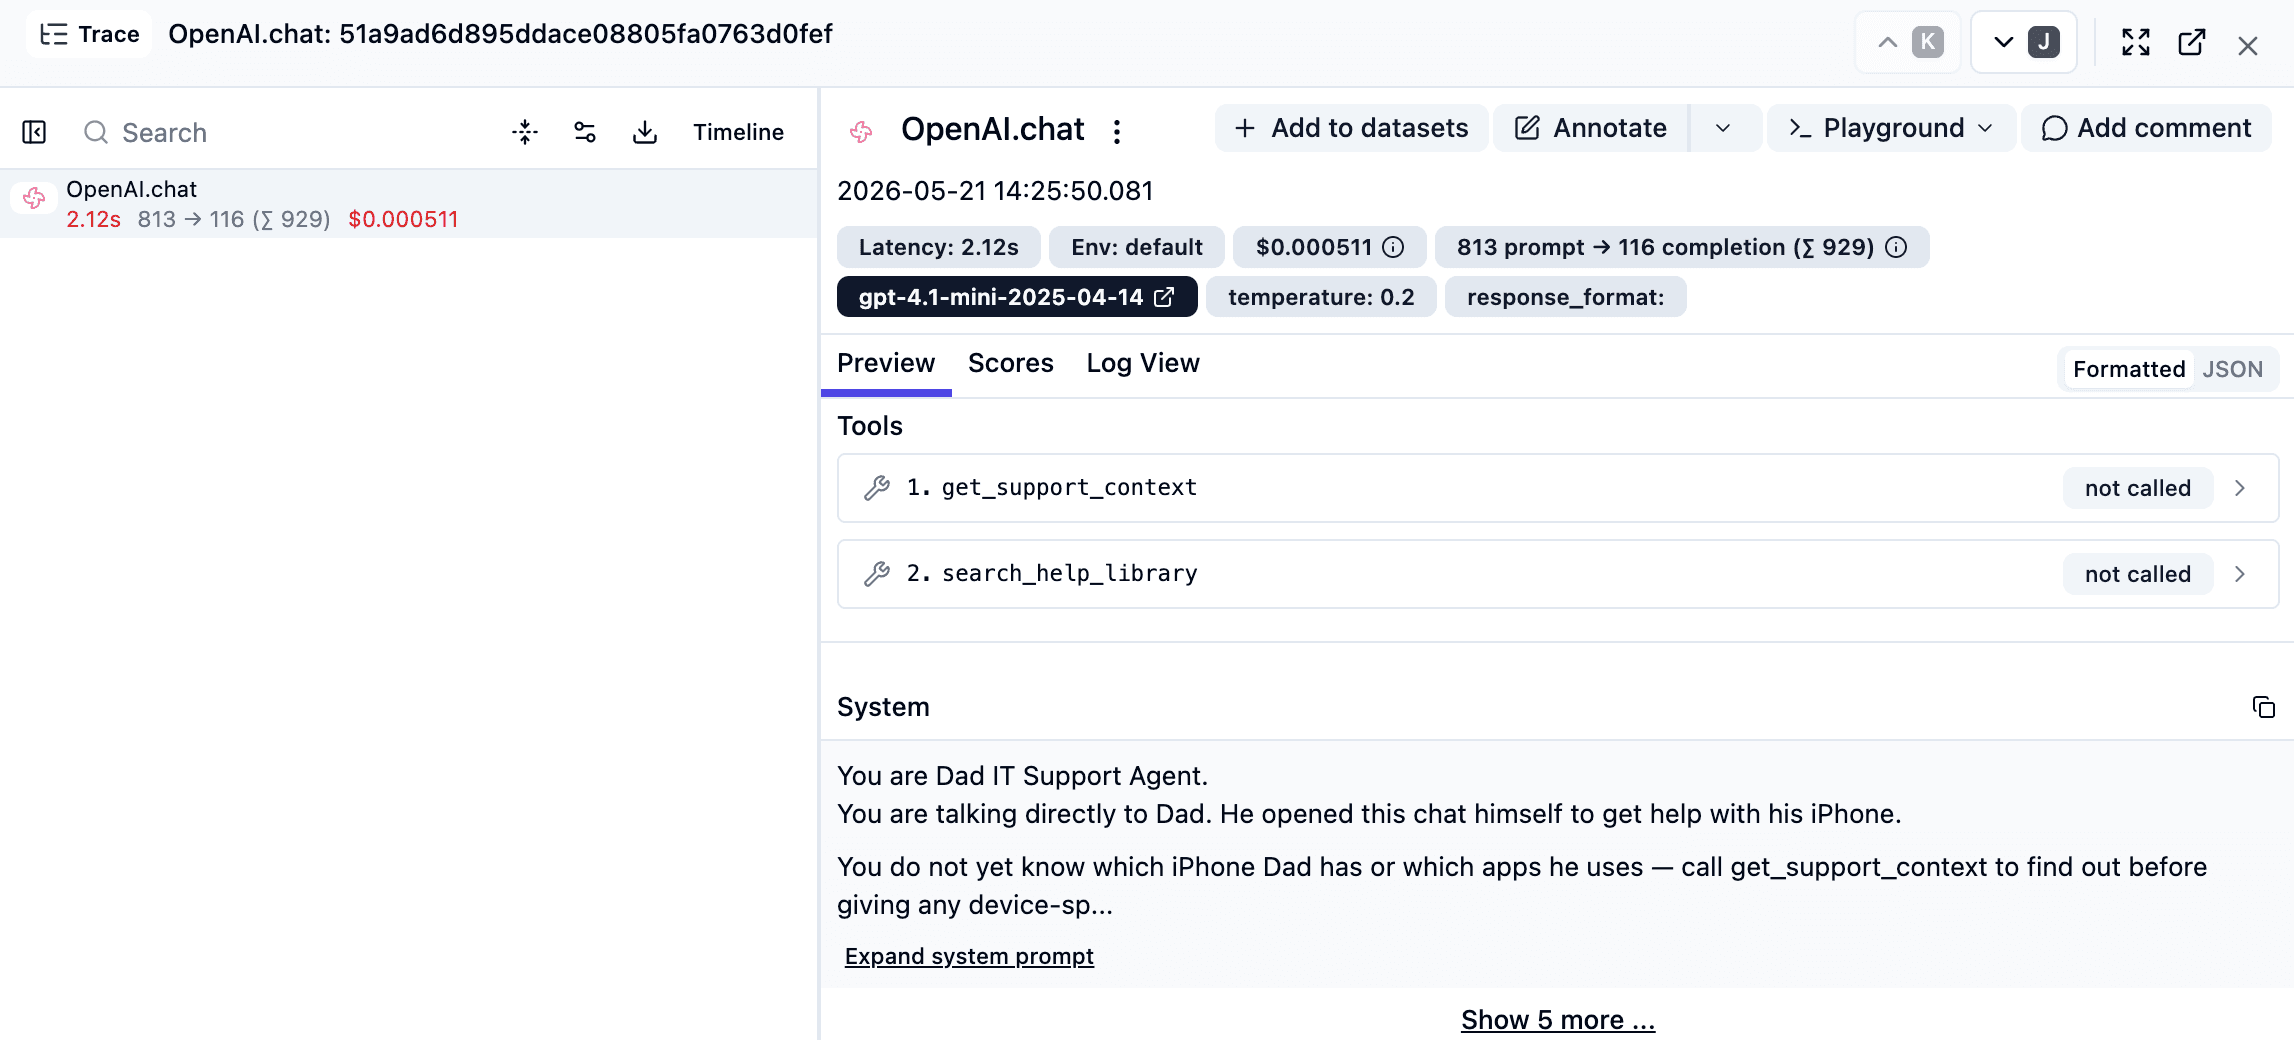
確認: npm run dev、1つの質問を尋ねて、Langfuse を更新します — OpenAI呼び出しごとに1つの世代でプロンプト、応答、トークン、レイテンシが表示されます。各世代はまだ独立したトップレベルトレースです。次に修正します。
ステップ2 — ネストされたトレース
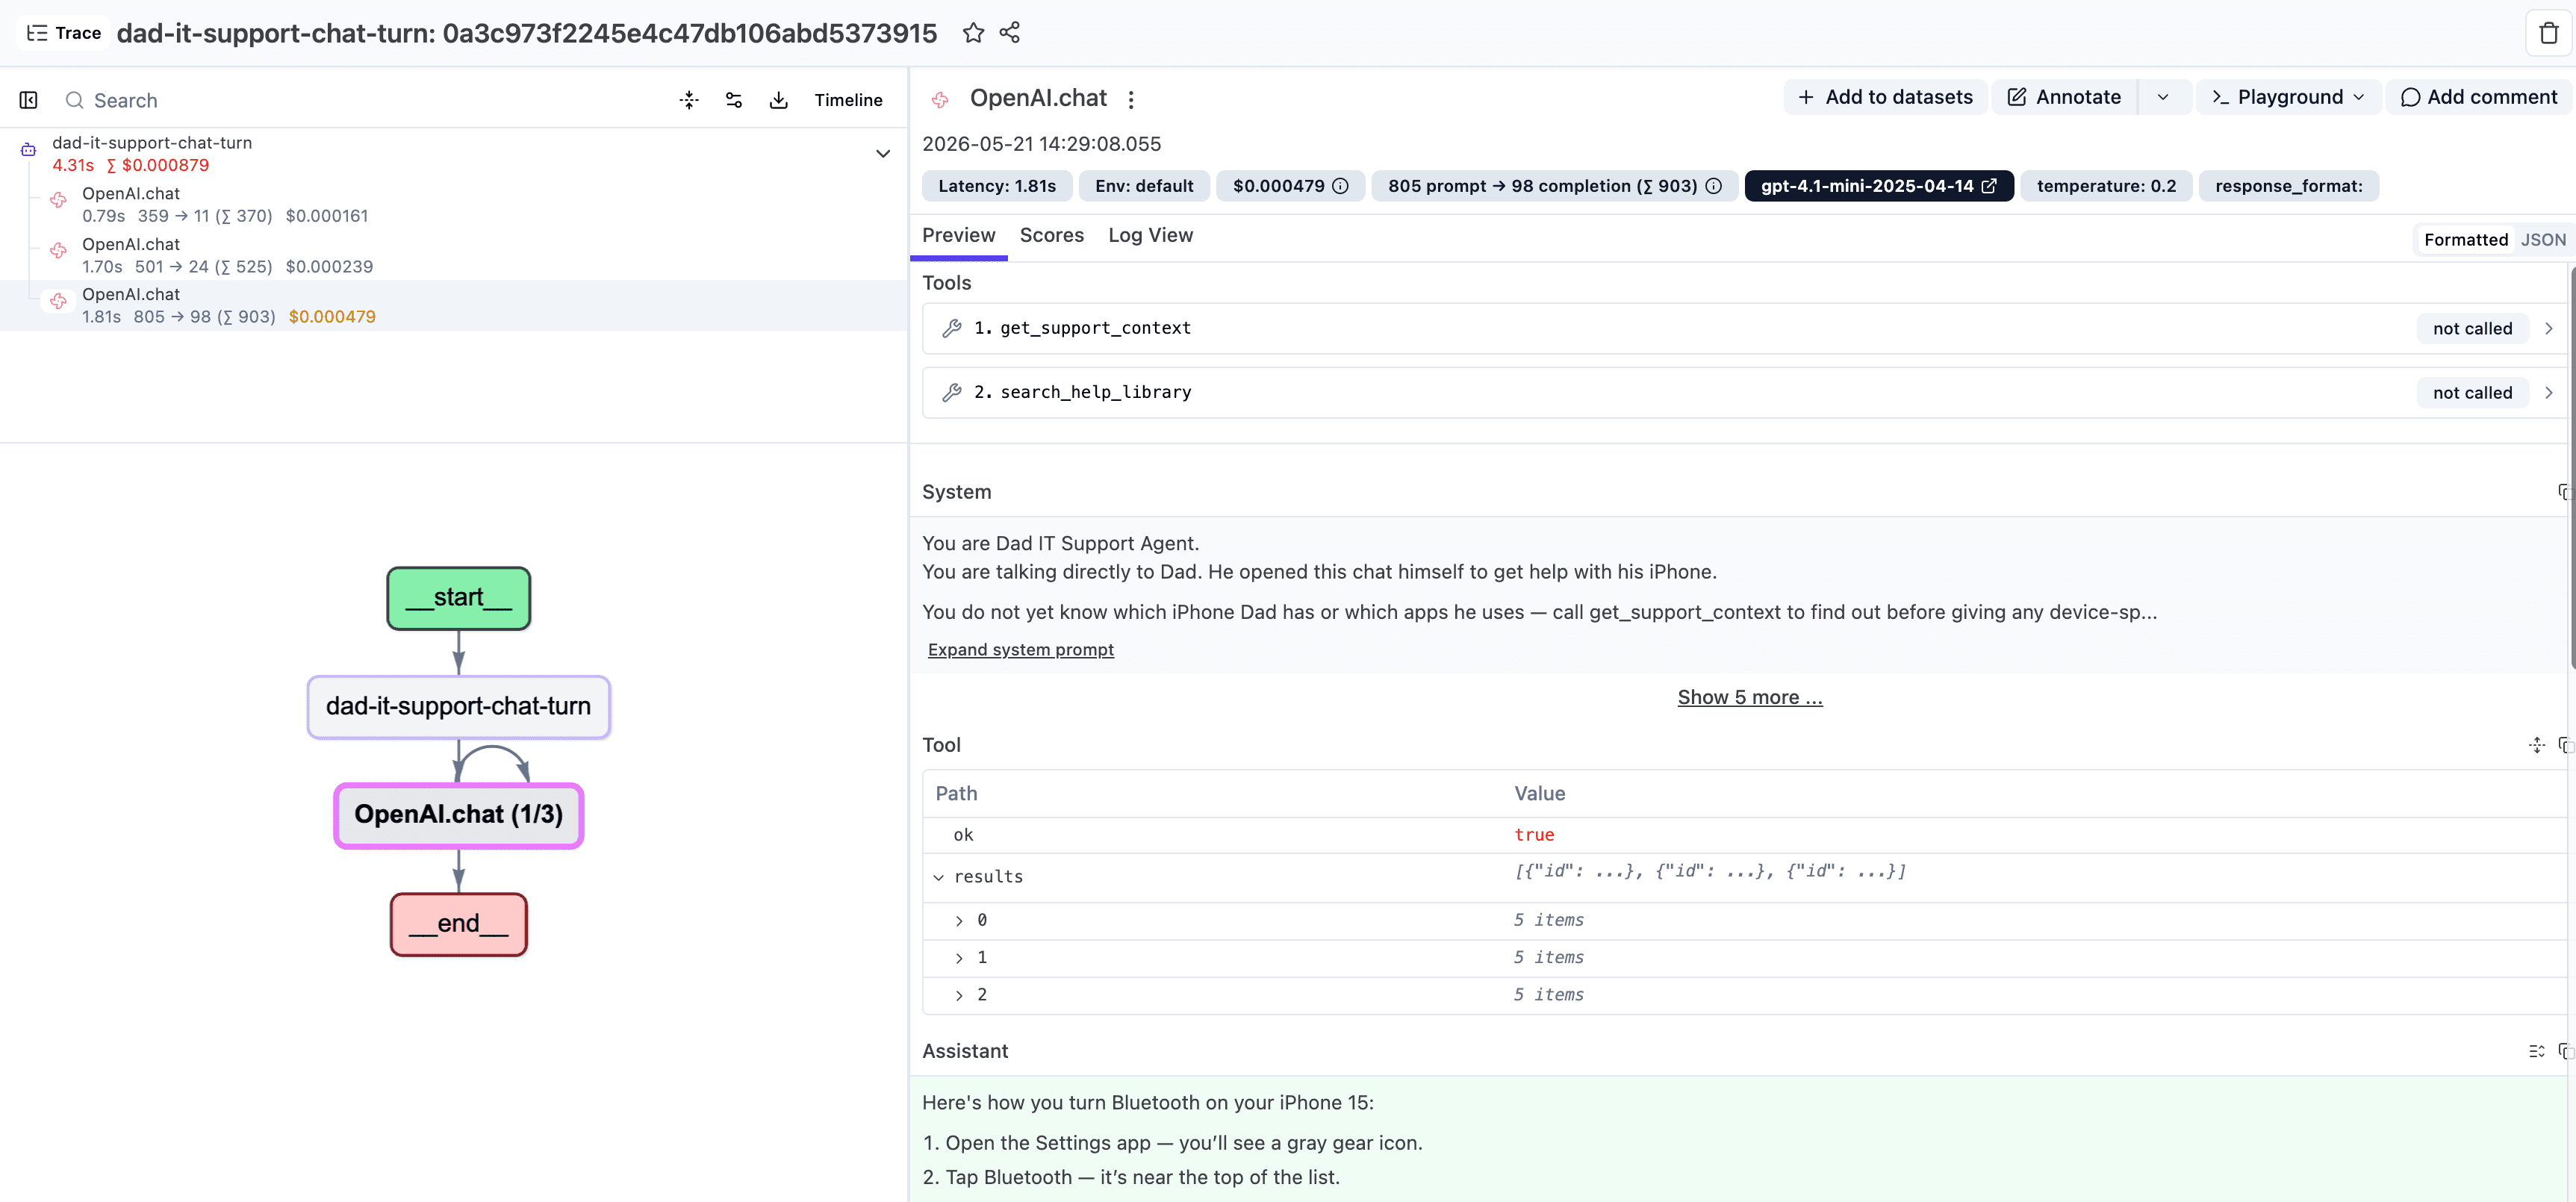
世代をコンテキストに入れるために、ターンごとに1つのエージェント実行の下にグループ化します。src/server/support-agent.ts の3つの編集 — 関数本体の変更なし。
1. インポートを追加します:
import { observe } from "@langfuse/tracing";2. 既存の関数を降格させます。 見つけます:
export async function runSupportConversation(request: ChatRequest): Promise<ChatResponse> {export をドロップして名前を変更します:
async function runSupportConversationInner(request: ChatRequest): Promise<ChatResponse> {本体はそのままです。
3. ファイルの下部にラップされたエクスポートを追加します:
export const runSupportConversation = observe(runSupportConversationInner, {
  name: "dad-it-support-chat-turn",
  asType: "agent"
});
index.ts は依然として runSupportConversation を同じ方法でインポートします。observe(...) は自動的に関数引数をトレース入力として、戻り値をトレース出力としてキャプチャします。
確認: 1つのチャットターンが、OpenAI世代がネストされた1つの dad-it-support-chat-turn 観察として表示されるようになりました。
ステップ3 — ツール呼び出しの記録
OpenAI 世代は既に tool_calls 出力でツール呼び出しに言及していますが、実際のツール実行の観察はありません — 入力が何であり、何が出たかを確認する方法はありません。各ツールに同じ observe(...) パターンを適用できます。
src/server/tools.ts
executeTool の上にインポートを追加し、2つの観察されたヘルパーを追加し、次に 既存の executeTool を以下のバージョンに置き換えて、スイッチがインラインでの作業の代わりにラップされたヘルパーを呼び出すようにします。TOOL_DEFINITIONS はそのままです。
import { observe } from "@langfuse/tracing";

const getSupportContextTool = observe(
  async () => {
    const context = getSupportContext();

    return {
      ok: true,
      context: {
        id: context.id,
        label: context.label,
        devices: context.devices,
        deviceSummary: context.deviceSummary,
        responseStyle: context.responseStyle,
        scopeHighlights: context.scopeHighlights,
        notableApps: context.notableApps
      }
    };
  },
  { name: "get_support_context", asType: "tool" }
);

const searchHelpLibraryTool = observe(
  async (input: { question: string }) => {
    const guides = searchGuides(input.question);

    return {
      ok: true,
      results: guides.map((guide) => ({
        id: guide.id,
        title: guide.title,
        summary: guide.summary,
        steps: guide.steps,
        caution: guide.caution ?? null
      }))
    };
  },
  { name: "search_help_library", asType: "tool" }
);

export async function executeTool(name: string, input: Record<string, unknown>): Promise<ToolResult> {
  switch (name) {
    case "get_support_context":
      return getSupportContextTool();

    case "search_help_library":
      return searchHelpLibraryTool({ question: String(input.question ?? "") });

    default:
      return { ok: false, error: `Unsupported tool: ${name}` };
  }
}
npm run dev が Multiple exports with the same name "executeTool" で停止する場合、元の executeTool は依然としてファイルのさらに下にあります。それを削除して上のバージョンのみを保持します。
完了したことを確認する方法
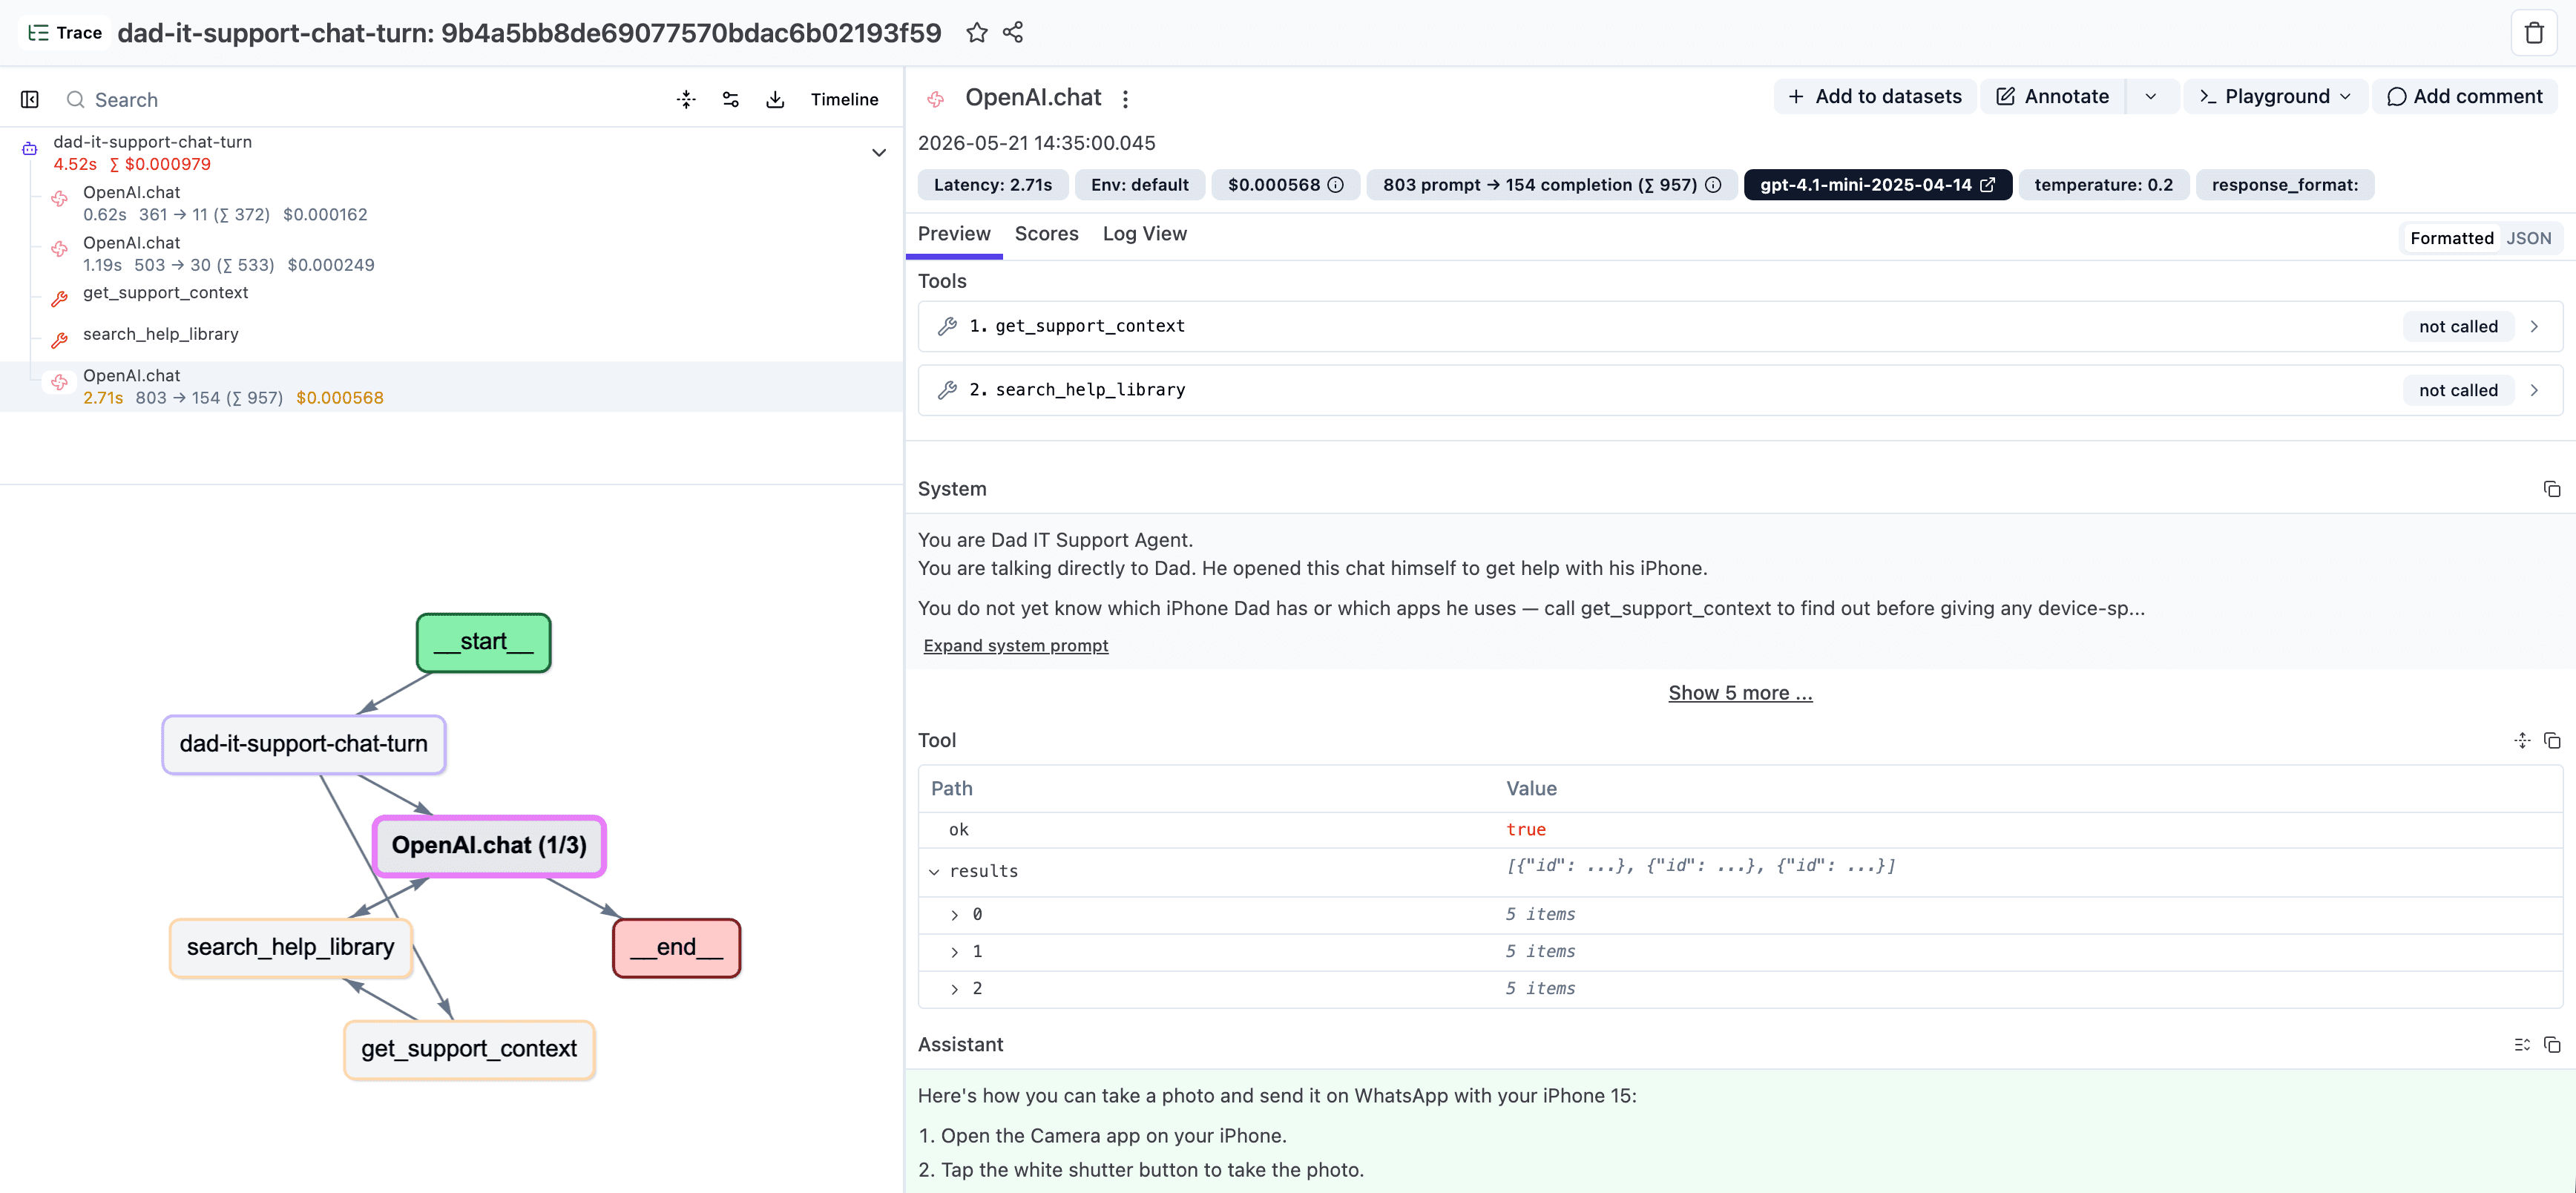
- 1つのユーザーターンがLangfuseで1つのトレースを作成します。
- ルート観察:
dad-it-support-chat-turn(タイプagent)。 observeOpenAI(...)からのチャイルド世代、プロンプト、応答、トークン、レイテンシがあります。- チャイルドツール観察:
get_support_context、search_help_library。 - ルート入力はチャットリクエスト、ルート出力はチャット応答です。
ラップアップ
同じパターン、異なる観察タイプ、同じ概念: observe(fn, { asType }) は関数をラップし、与えられた名前と型のスパンを出力します。observeOpenAI(client) はOpenAI SDKの特殊版です。
Langfuseのベストプラクティスに沿った豊かなトレースを追加するより直接的な方法は、Langfuseスキル(/langfuse) です。推奨パターンを、各ラップを手動でロールしずに適用します。このチュートリアルが存在するのは、スキルが何をしているかを理解するためです。
observeOpenAI 自体は、公式OpenAI SDK をラップします — 舞台裏では、Langfuse OpenAI JS用の自動計装 と同じです。別のSDK (Anthropic、Vercel AI SDK、独自のHTTPクライアント) を使用している場合、Langfuse 統合カタログ には同等のラッパーまたは自動計装ガイドがあります。
付録/ボーナスセクション — ユーザーとセッションID
上記のチュートリアルは、クリーンな親 → 世代 → ツール形状でトレースを取得します。ほとんどのチームが次に望むのは、ユーザーとセッションでトレースをスライスすることです — 「このユーザーがエージェントで持っているすべてのターン」または「昨朝からのフルマルチターンセッション」を取得できるようにします。 シンプルさの理由で、ライブトレース化チュートリアルではこのステップをスキップしますが、トレース化後のチェックポイントに含まれているため、後のチャプターは別のコード ステップなしでセッション/ユーザービューを使用できます。Langfuse ドキュメントで Sessions と Users に関する情報を参照してください。
要するに:
import { propagateAttributes } from "@langfuse/tracing";

return propagateAttributes(
  {
    userId: request.userId ?? `workshop-${context.id}`,
    sessionId: request.sessionId,
    tags: ["langfuse-workshop", "dad-it-support"]
  },
  async () => {
    // ...the same tool-calling loop...
  }
);
propagateAttributes(...) ブロック内のすべて — observeOpenAI によって出力されるすべてのチャイルドスパンを含む — は自動的に userId、sessionId、およびタグを取得します。Langfuse Users ビュー、Sessions ビュー、およびタグフィルタはすべて、属性が存在するとすぐにライト アップします。
最終状態
この完成したトレース化アプリは 03-prompt-management と 04-monitoring の開始ポイントです。