03 加载数据,两种方式
同样的 2650 万条 tick 加载两遍:先用 ClickPipes,也就是你在生产环境里会用的托管管道,再用 s3() 一行搞定,以及什么时候该用哪一种。
数据存放在一个公开的 S3 存储桶里,因此不需要任何密钥或凭证,你只要指向那个 URL。 传输在服务端从 S3 直达 ClickHouse,所以既不会让 2650 万行数据经过你的笔记本, 也不依赖会场的 Wi-Fi。
你会用两种不同的方式加载同样的 2650 万条 tick,好把两者都体验一遍。方式 1 是
ClickPipes,一个托管的、点几下就能配好的管道,也是你在生产环境里会用的。方式 2 是一行
SQL,在演示中把数据灌进去的最快办法。请按顺序做;两者之间用一次 TRUNCATE 保证行数干净。
方式 1:ClickPipes,托管的生产级做法
ClickPipes 是一个完全托管的数据摄取服务:把它指向对象存储或某个流,它就会持续加载, 不用你自己写连接器。整个流程如下。
- 在左侧菜单点击 Data sources,然后点 Create ClickPipe 按钮。
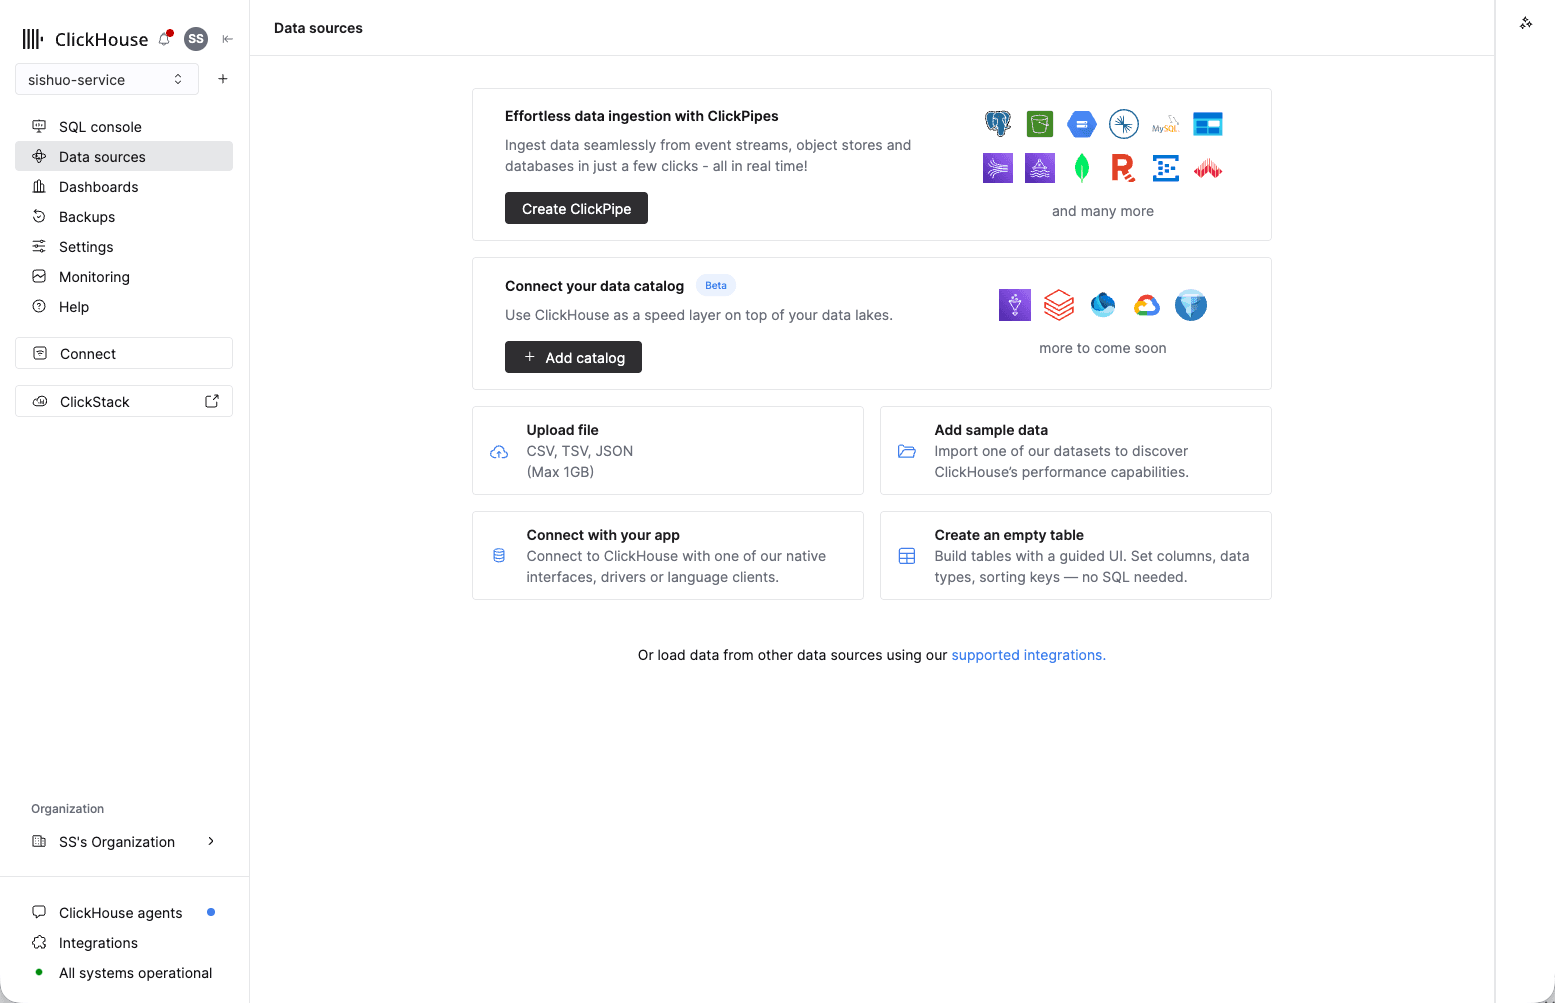
Data sources 页面里也有 "Upload file" 和 "Add sample data"。
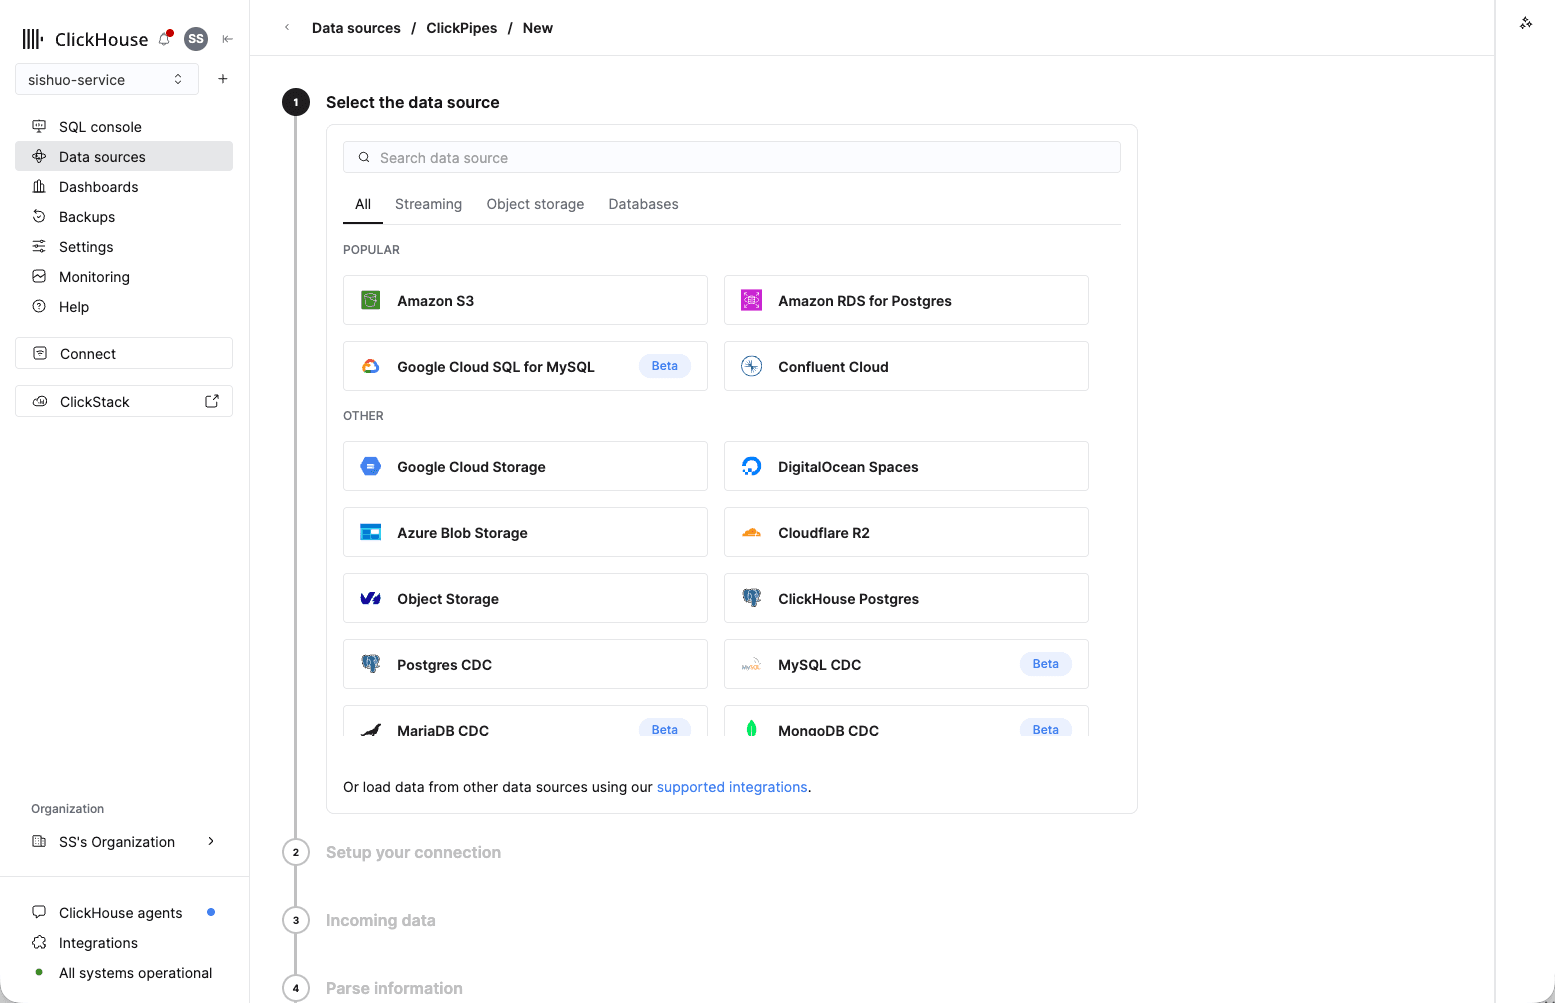
- 在 Select the data source 下,选择 Amazon S3(Popular 列表最上面那个)。
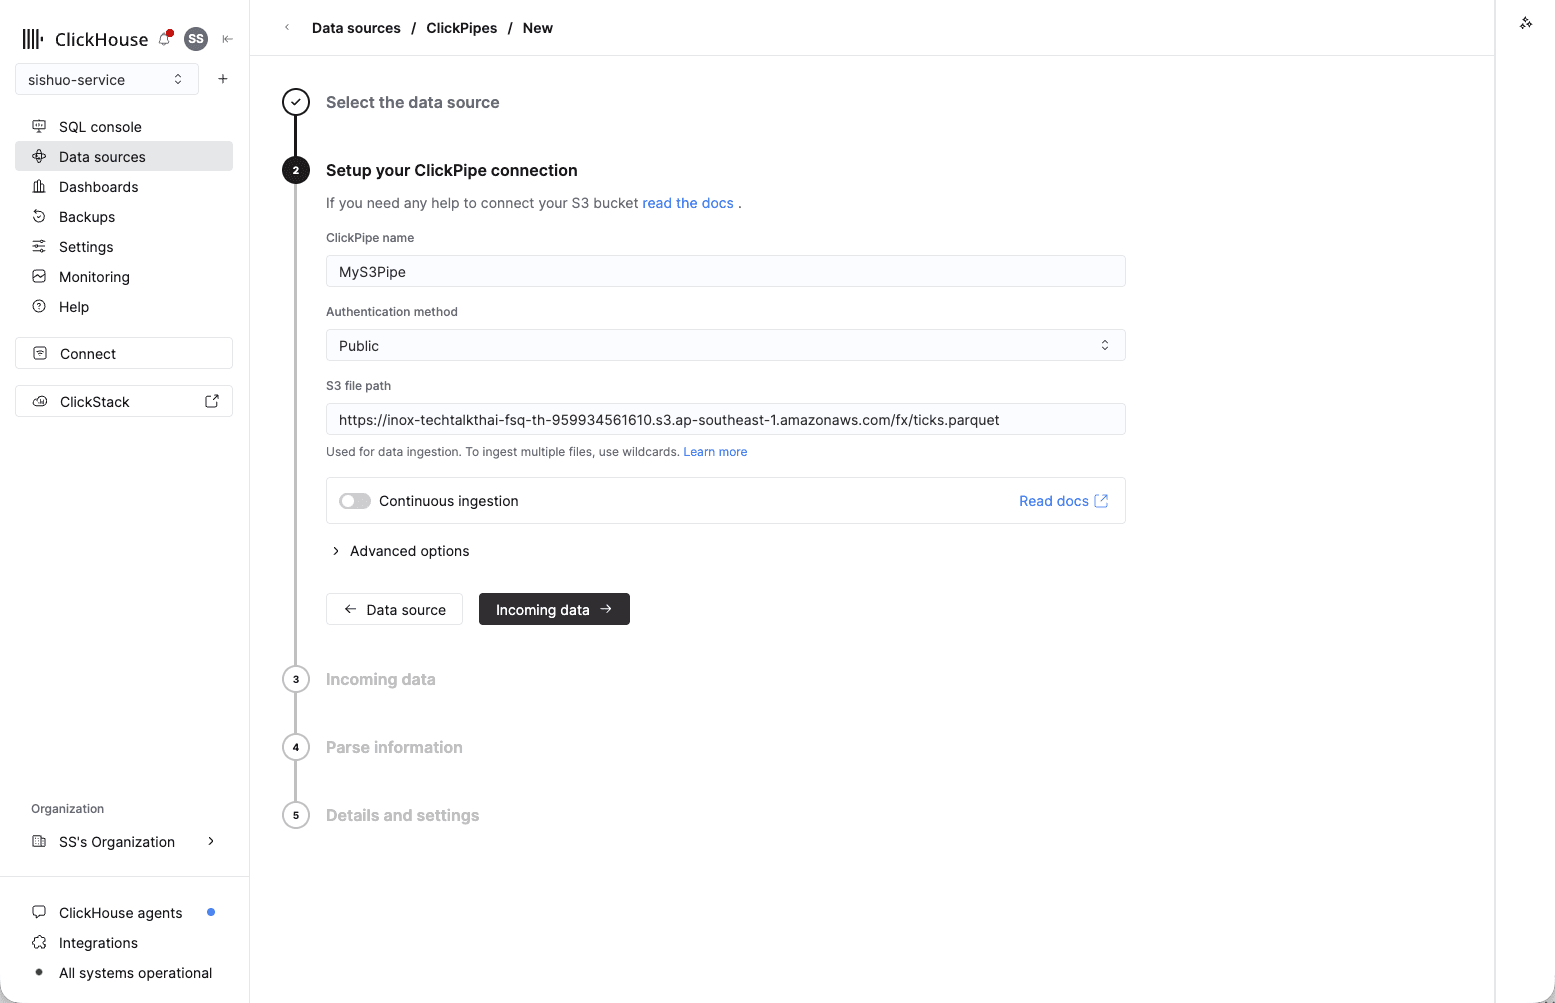
- 在 Setup your ClickPipe connection 页面,随便起一个名字,把 Authentication method → Public(这个存储桶是公开的),然后把下面这行粘贴到 S3 file path:
https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquet保持 Continuous ingestion 关闭,这是一次性的文件,然后点 Incoming data →。
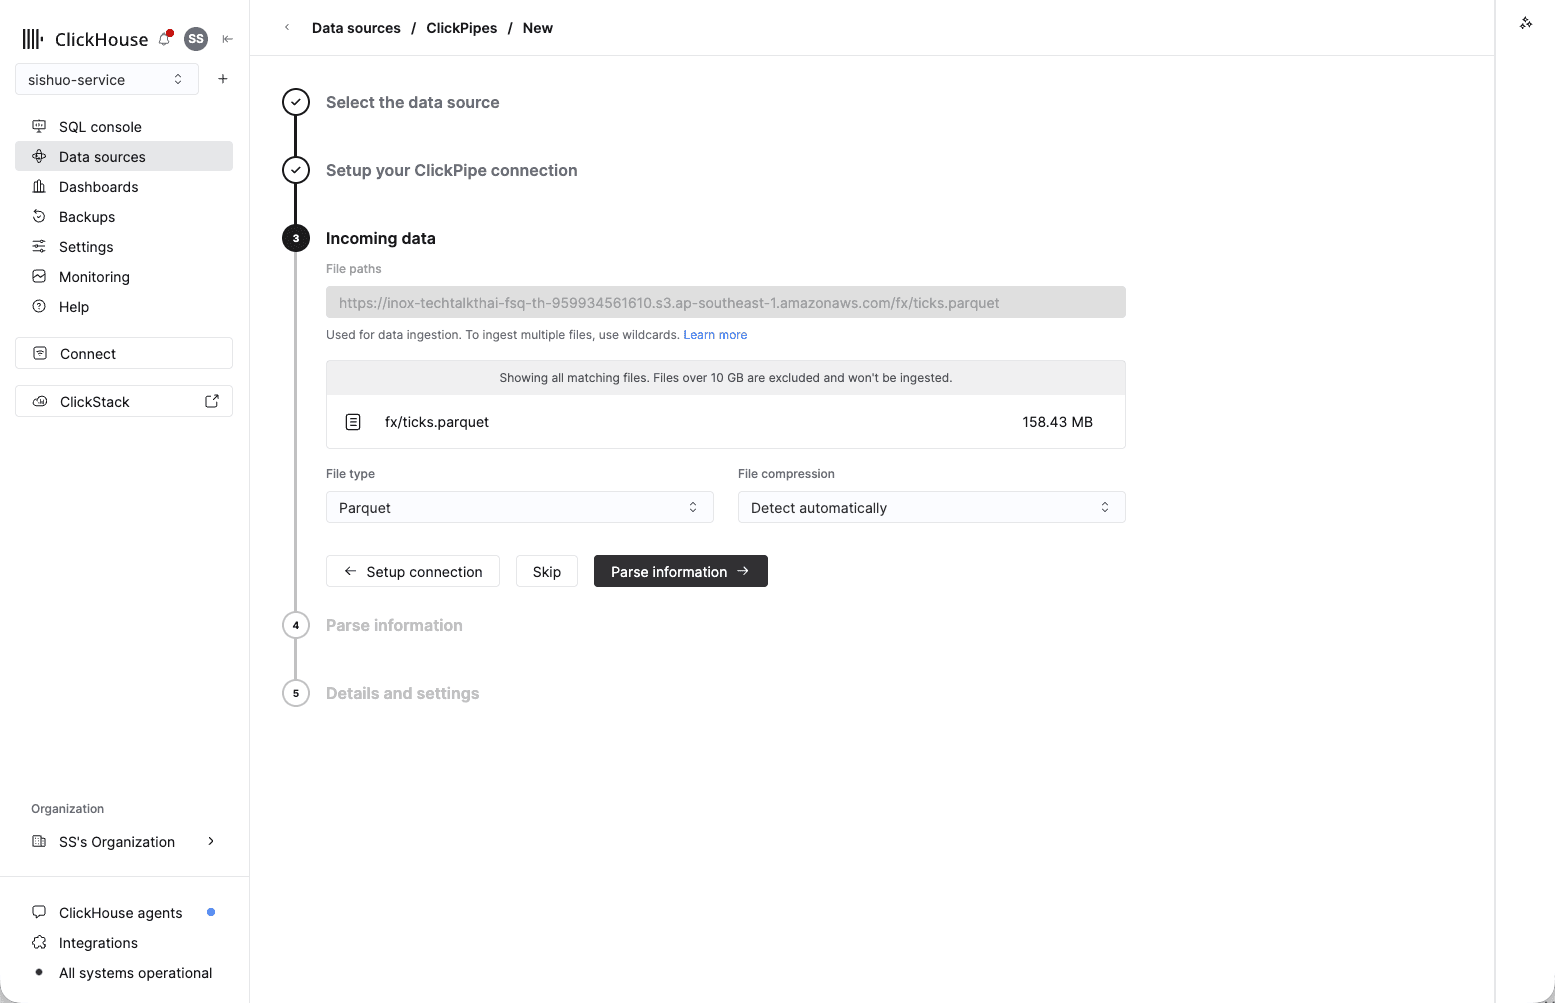
- 在 Incoming data 页面,ClickHouse 会预览匹配到的文件,你会看到
fx/ticks.parquet,大小 158.43 MB。确认 File type → Parquet,压缩方式保持 Detect automatically,然后点 Parse information →。
- 在 Parse information 页面,ClickHouse 会预览一行样本数据并识别出各列。在
Upload data to 下选择 Existing table,选中存放你那张表的 Database
(通常是
default),并设置 Table →forex。检查源字段(datetime、bid、ask、base、quote)是否与对应的列一一对上,它们应该会自动映射。 多出来的_path/_file/_size字段不用映射。然后点 Details and settings →。
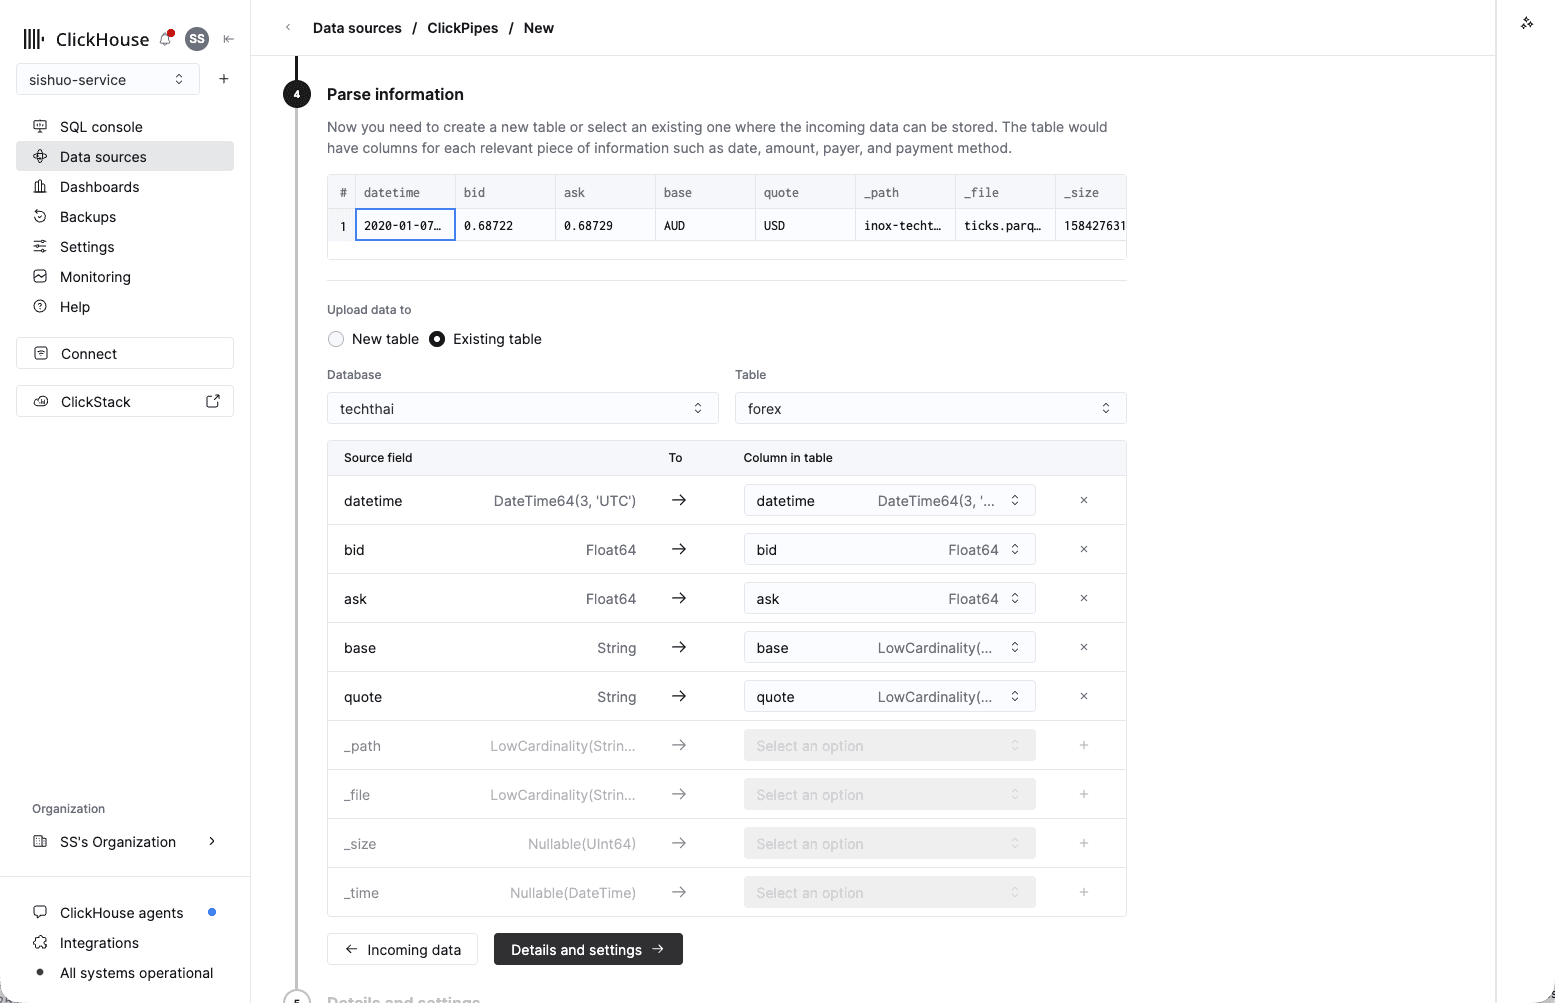
截图里显示的是讲师的 techthai 数据库,你用存放自己那张表的那个即可。
- 在 Details and settings 页面,Permissions 保持默认不动(ClickPipes 会为你创建一个专用的写入用户),然后点 Create ClickPipe。
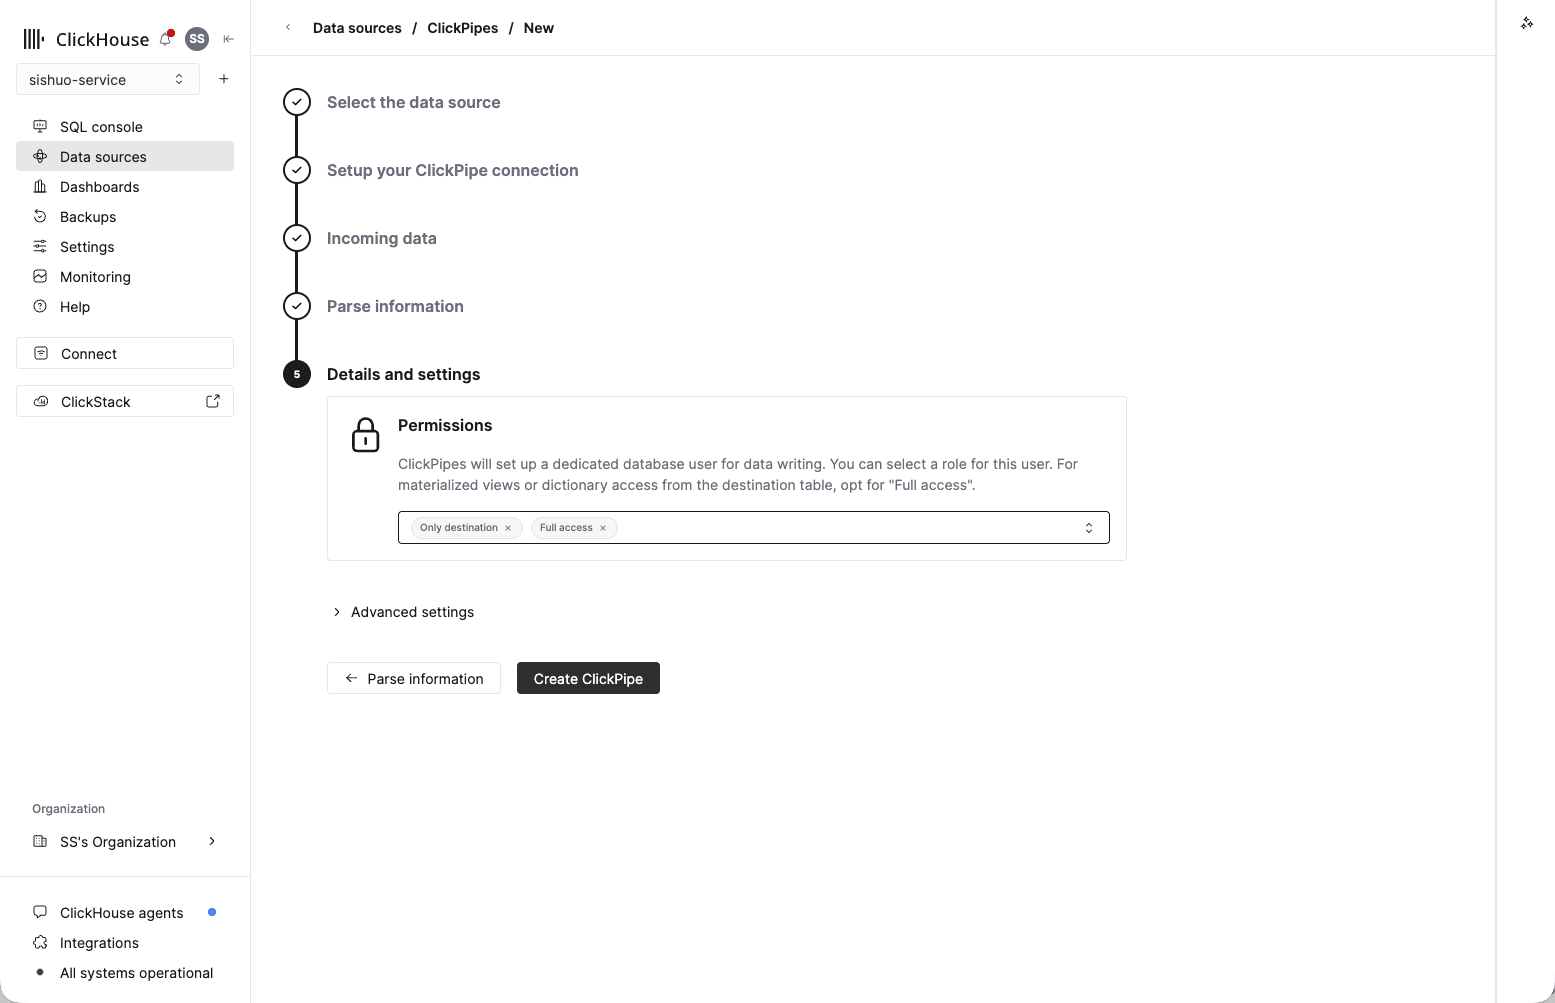
不用写 Spark 作业,也不用自定义加载器。
- 页面会回到 Data sources,你的 ClickPipe 出现在列表里。几秒钟后它的 Status 变成 Completed,Records 显示 26,488,218,所有 tick 都从对象存储加载完成了。
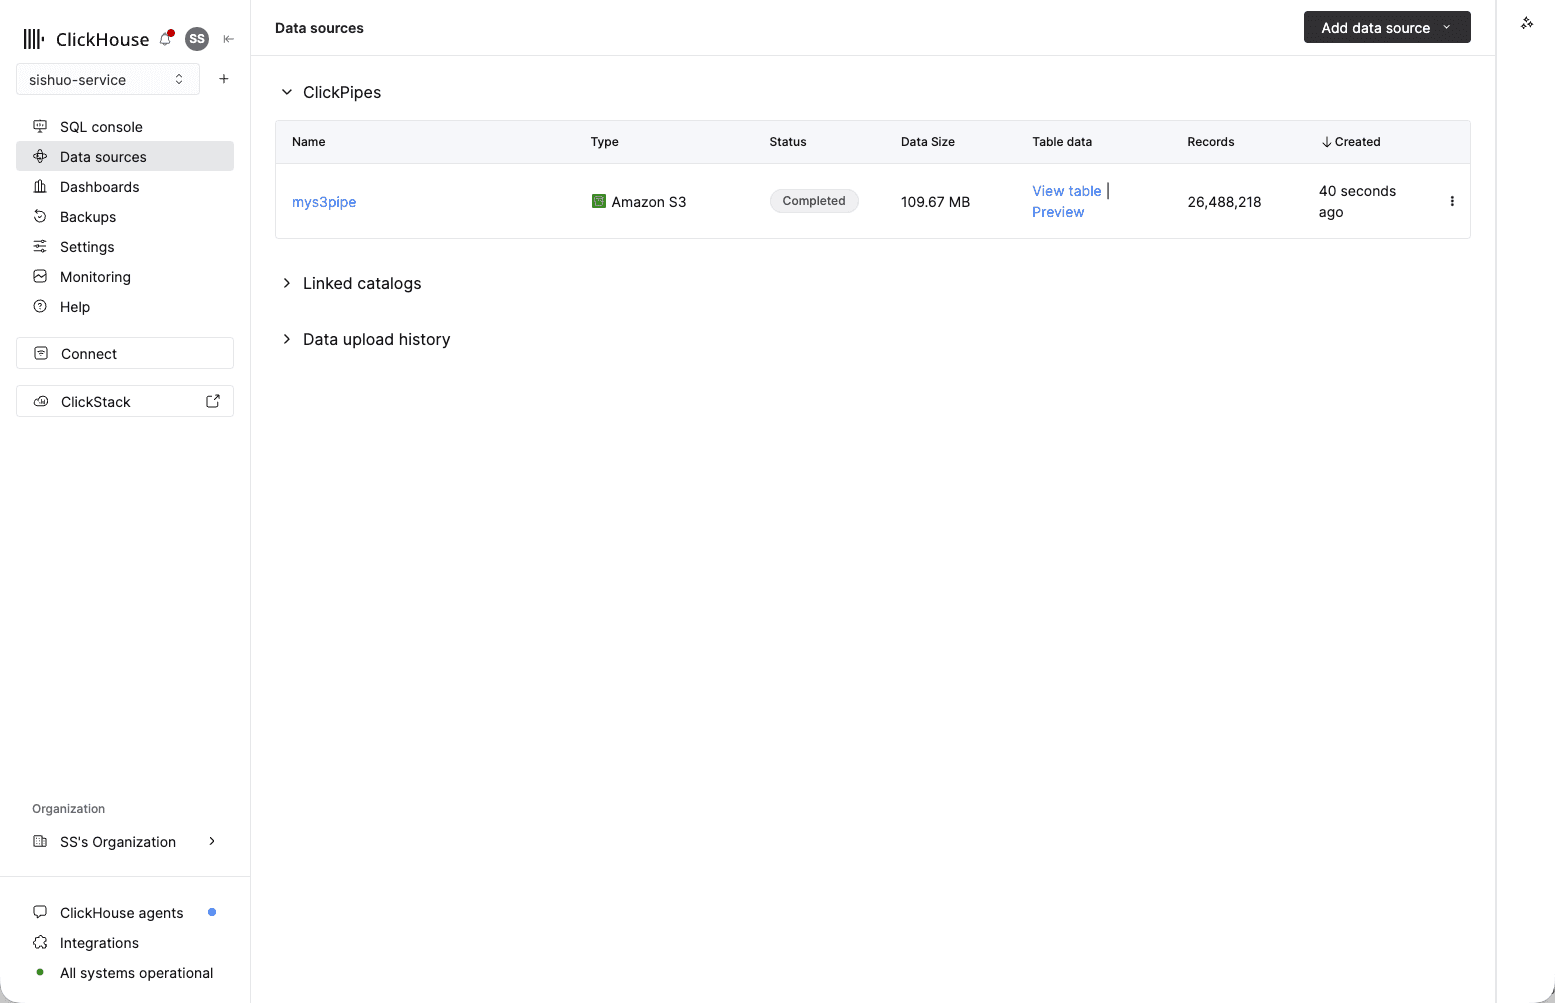
检查加载结果。 在 SQL Console 里运行:
-- expect 26,488,218 ticks across 12 pairs
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;
你应该看到
ticks = 26,488,218 且 pairs = 12。这就是几秒钟内从对象存储加载进来的约 2650 万行数据。
方式 2:s3() 一行搞定,演示时最快
现在用一条 SQL 语句直接从那个公开文件加载完全相同的数据。先清空表,避免行数翻倍,然后插入:
-- clear the rows ClickPipes just loaded so we don't double up
TRUNCATE TABLE forex;

-- load all ~26.5M ticks from the public S3 file in one line (server-side)
INSERT INTO forex
SELECT * FROM s3('https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquet', NOSIGN, 'Parquet');

-- and check again (expect 26,488,218)
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;
NOSIGN 的意思是"不需要凭证",读一个公开存储桶就这么简单。SELECT * 能直接用,
是因为表的列顺序和文件一致。
ClickPipes 与 s3() 函数:什么时候用哪个
同样的 26,488,218 行,两种加载方式。区别在于首次加载之后会发生什么, 你想要的是一条托管的、持续运行的管道,还是一次快速的一次性读取。
| ClickPipes | s3() 表函数 | |
|---|---|---|
| 它是什么 | 在控制台里配置的完全托管摄取服务 | 在查询里内联调用的 SQL 函数 |
| 最适合 | 生产环境和你希望配好就不用管的持续加载 | 快速的一次性加载、临时探索、脚本 |
| 持续 / 新文件 | 可以持续监听存储桶或流,不断加载新数据 | 一次性,每次运行只读取当时存在的内容 |
| 配置方式 | 引导式界面,不用写 SQL | 一条 INSERT … SELECT 语句 |
| 监控与重试 | 内置,控制台里有状态、错误处理和重试 | 没有,失败了要自己重跑 |
| 数据源 | 很多:S3、GCS、Azure、Kafka 和其他流、Postgres/MySQL CDC 等等 | 仅对象存储(同类函数:gcs()、azureBlobStorage()、url()) |
经验法则: 数据会持续到来且你希望有人帮你托管时,选 ClickPipes;
只是想马上把一个文件拉进来时,选 s3()。今天你用了一行搞定的写法,好尽快开始查询,
现在就来查它。