03 데이터 로드하기 — 두 가지 방법
같은 26.5M건의 틱을 두 번 로드합니다: 프로덕션에서 쓰게 될 관리형 파이프라인 ClickPipes, 그리고 s3() 한 줄 — 그리고 각각을 언제 선택할지.
데이터는 퍼블릭 S3 버킷에 있으므로 키나 자격 증명이 전혀 필요하지 않습니다 — URL만 가리키면 됩니다. 전송은 S3에서 ClickHouse로 서버 측에서 실행되므로, 2,650만 행이 여러분의 노트북을 거치지도 않고 행사장 Wi-Fi에 의존하지도 않습니다.
같은 26.5M건의 틱을 두 가지 방법으로 로드해 둘 다 확인합니다. 방법 1은 프로덕션에서 쓰게 될
관리형 클릭 기반 파이프라인 ClickPipes입니다. 방법 2는 SQL 한 줄 — 데모 중에 데이터를 가장 빠르게
넣는 방법입니다. 순서대로 진행하세요. 중간의 TRUNCATE가 행 수를 깔끔하게 유지해 줍니다.
방법 1 — ClickPipes, 관리형 프로덕션 방식
ClickPipes는 완전 관리형 인제스션 서비스입니다. 오브젝트 스토리지나 스트림을 가리키기만 하면 직접 만들 커넥터 없이 계속 로드해 줍니다. 전체 흐름은 다음과 같습니다.
- 왼쪽 메뉴에서 Data sources를 클릭한 뒤 Create ClickPipe 버튼을 누릅니다.
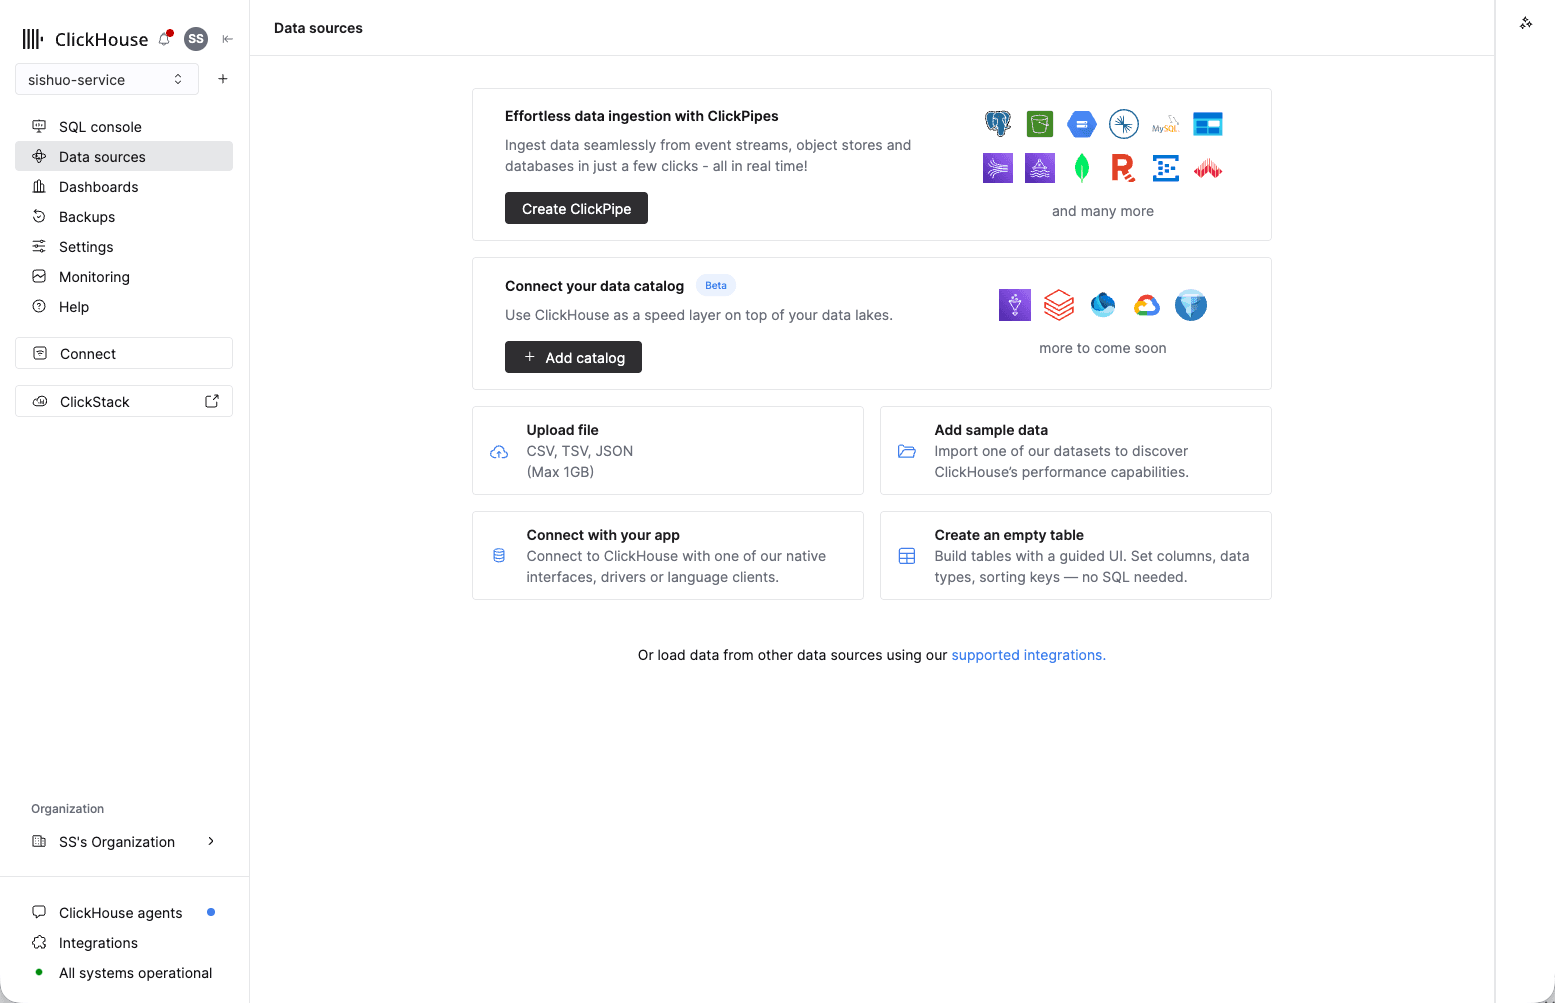
Data sources는 "Upload file"과 "Add sample data"가 있는 곳이기도 합니다.
- Select the data source에서 Amazon S3를 선택합니다(Popular 목록 맨 위).
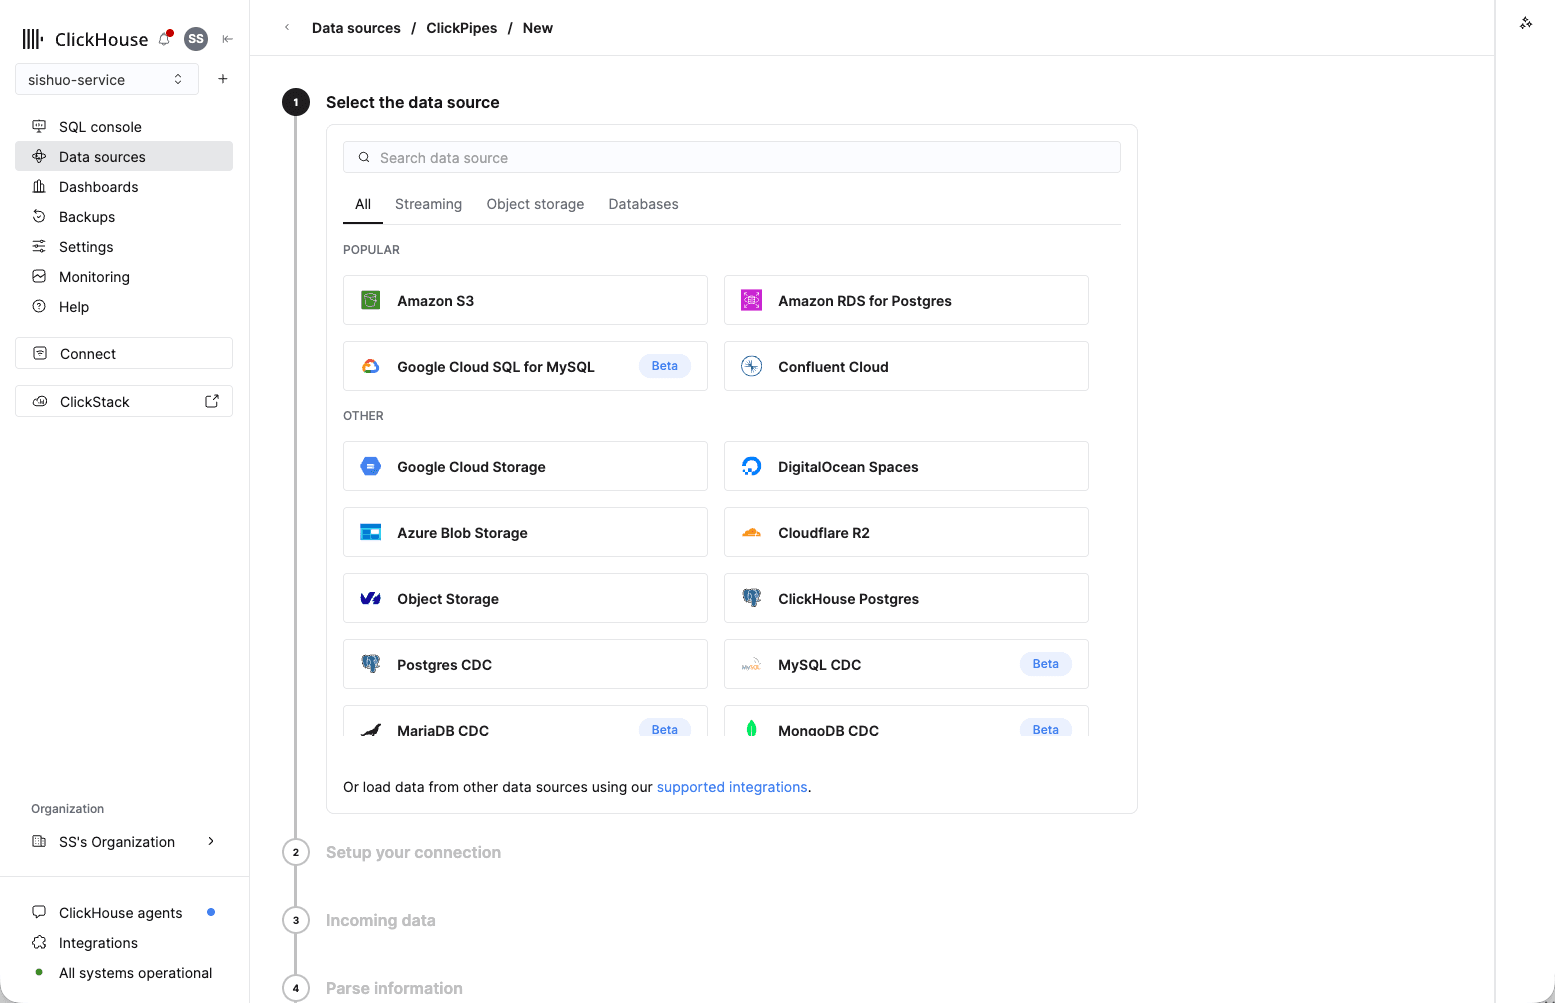
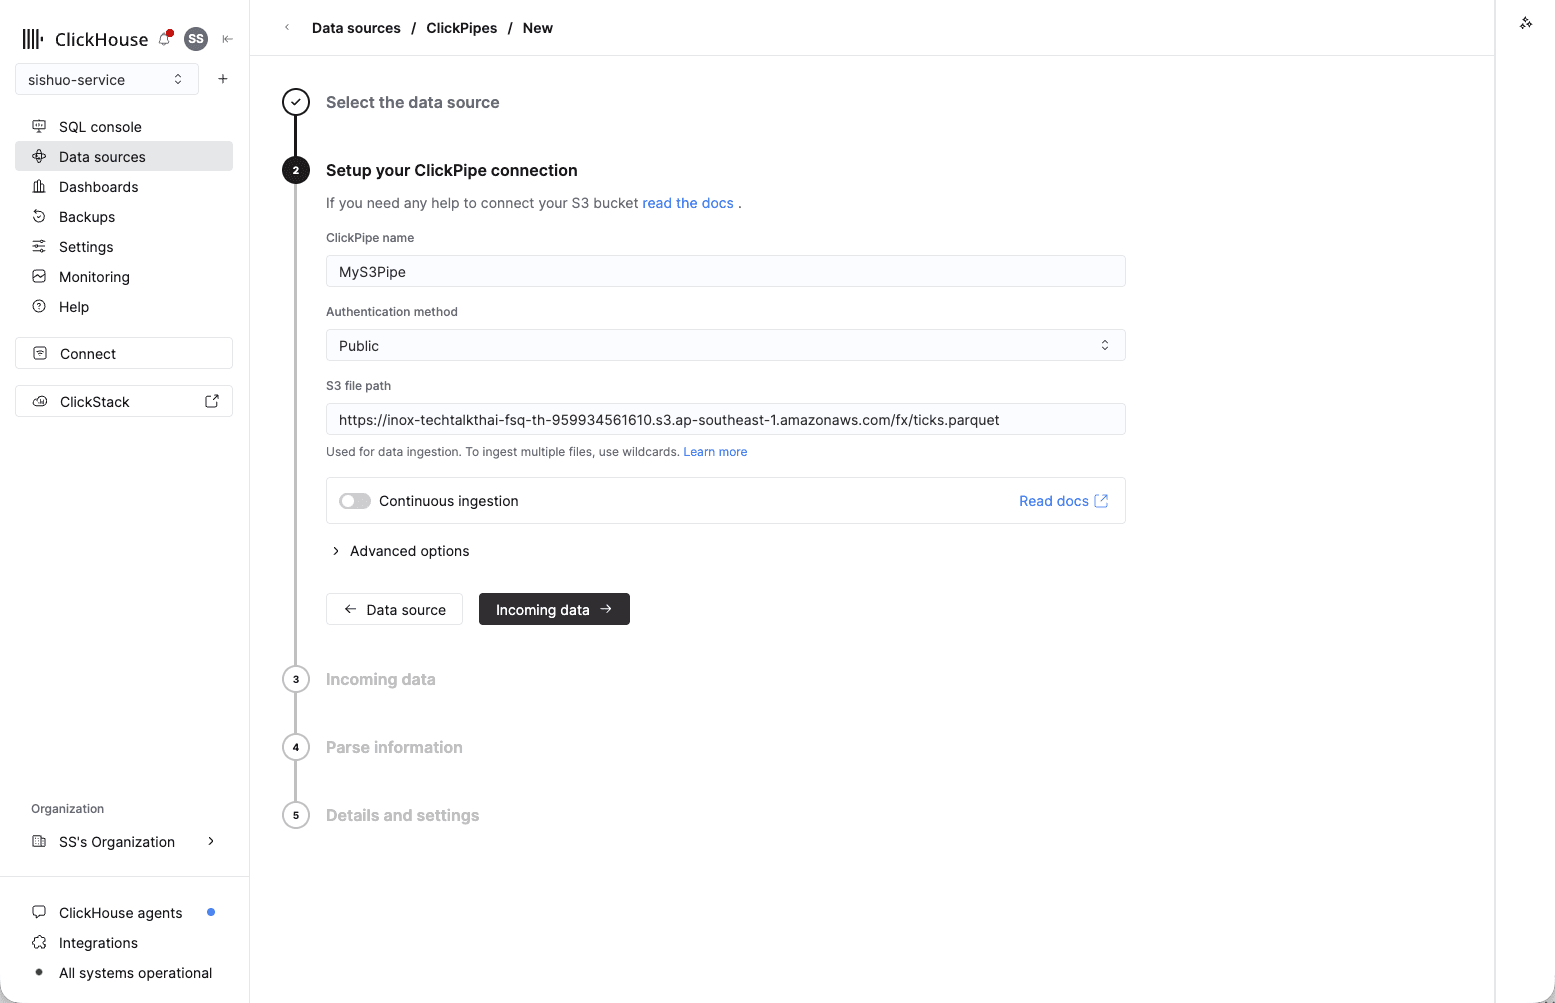
- Setup your ClickPipe connection에서 아무 name이나 지정하고, Authentication method → Public으로 설정한 뒤(버킷이 퍼블릭입니다), S3 file path에 이것을 붙여넣습니다:
https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquetContinuous ingestion은 끈 상태로 둡니다 — 일회성 파일이기 때문입니다 — 그리고 **Incoming data →**를 클릭합니다.
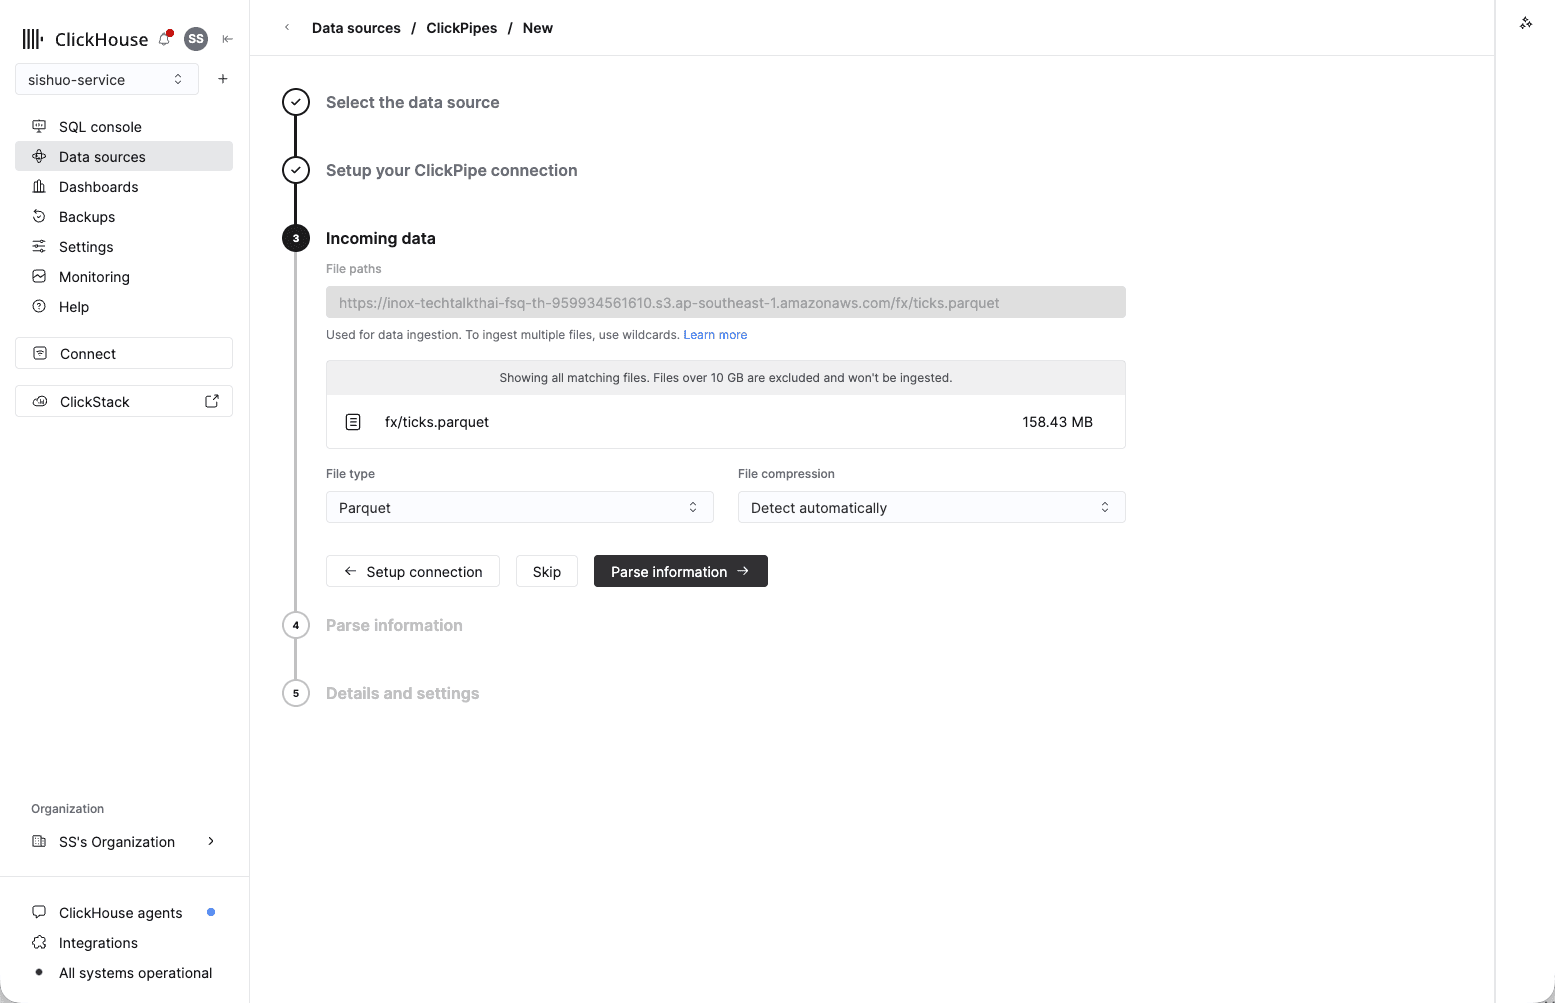
- Incoming data에서 ClickHouse가 일치하는 파일을 미리 보여줍니다 —
fx/ticks.parquet가 158.43 MB로 표시됩니다. File type → Parquet을 확인하고, 압축은 Detect automatically로 둔 채 **Parse information →**을 클릭합니다.
- Parse information에서 ClickHouse가 샘플 행을 미리 보여주고 컬럼을 감지합니다.
Upload data to에서 Existing table을 선택하고, 테이블이 있는 Database를 고른 뒤
(보통
default), **Table →forex**로 설정합니다. 소스 필드(datetime,bid,ask,base,quote)가 해당 컬럼과 맞게 연결되었는지 확인하세요 — 자동으로 매핑될 것입니다. 추가로 나오는_path/_file/_size필드는 매핑하지 않고 둡니다. 그다음 **Details and settings →**를 클릭합니다.
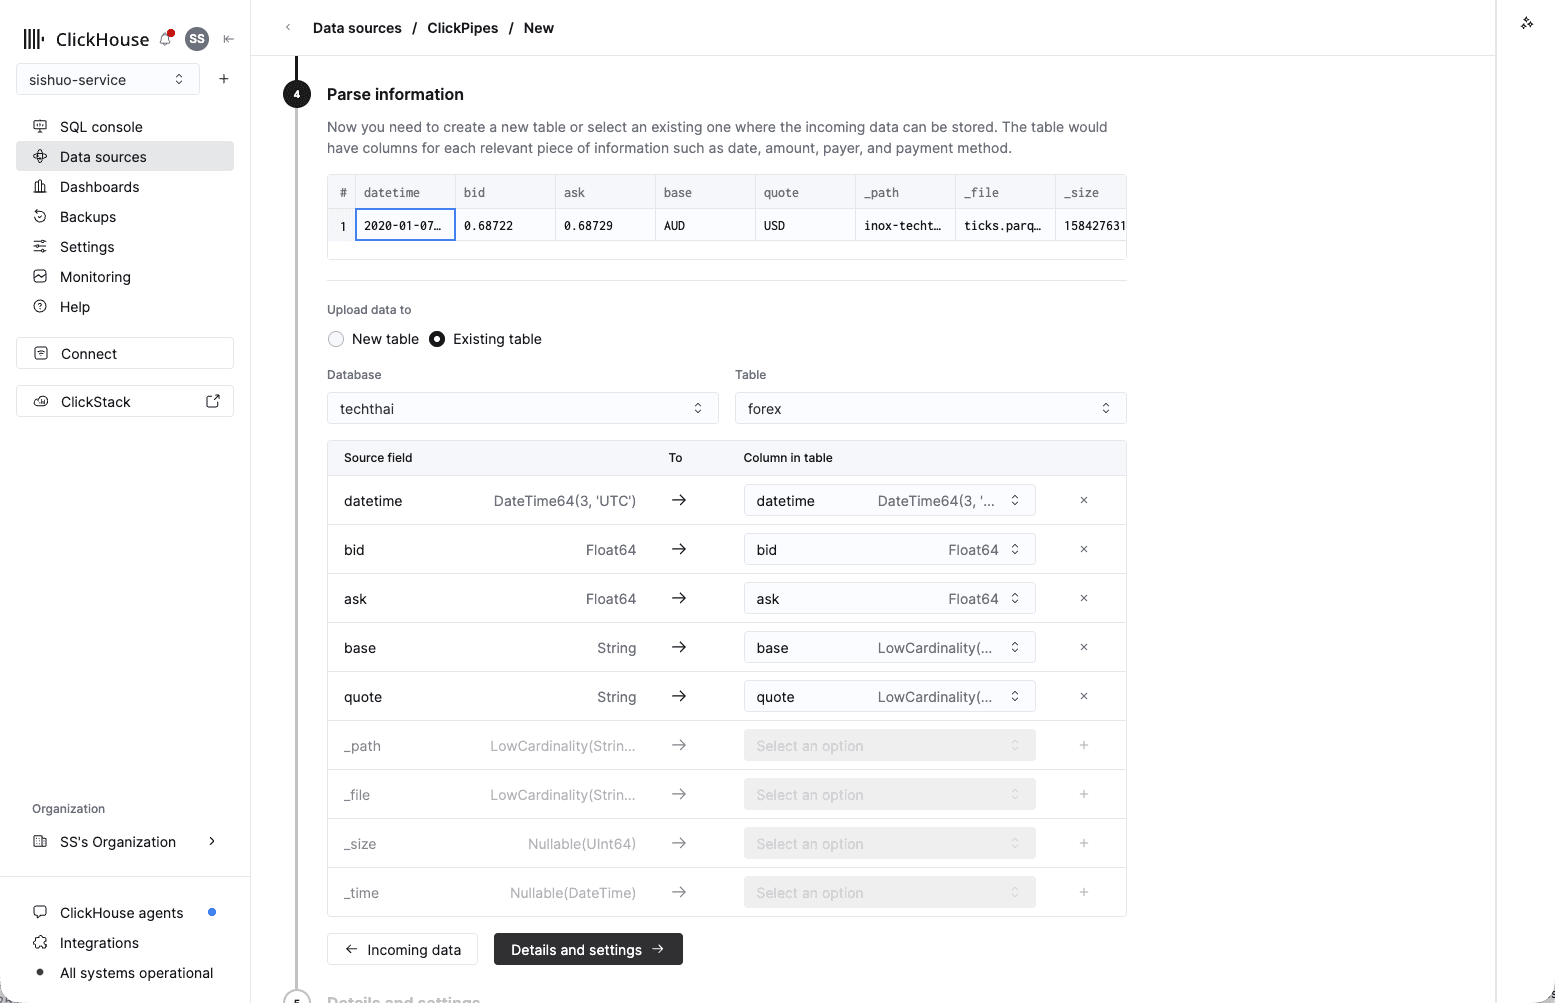
스크린샷에는 발표자의 techthai 데이터베이스가 보입니다 — 여러분의 테이블이 있는 것을 사용하세요.
- Details and settings에서 기본 Permissions를 그대로 둔 뒤(ClickPipes가 전용 writer 사용자를 만들어 줍니다) Create ClickPipe를 클릭합니다.
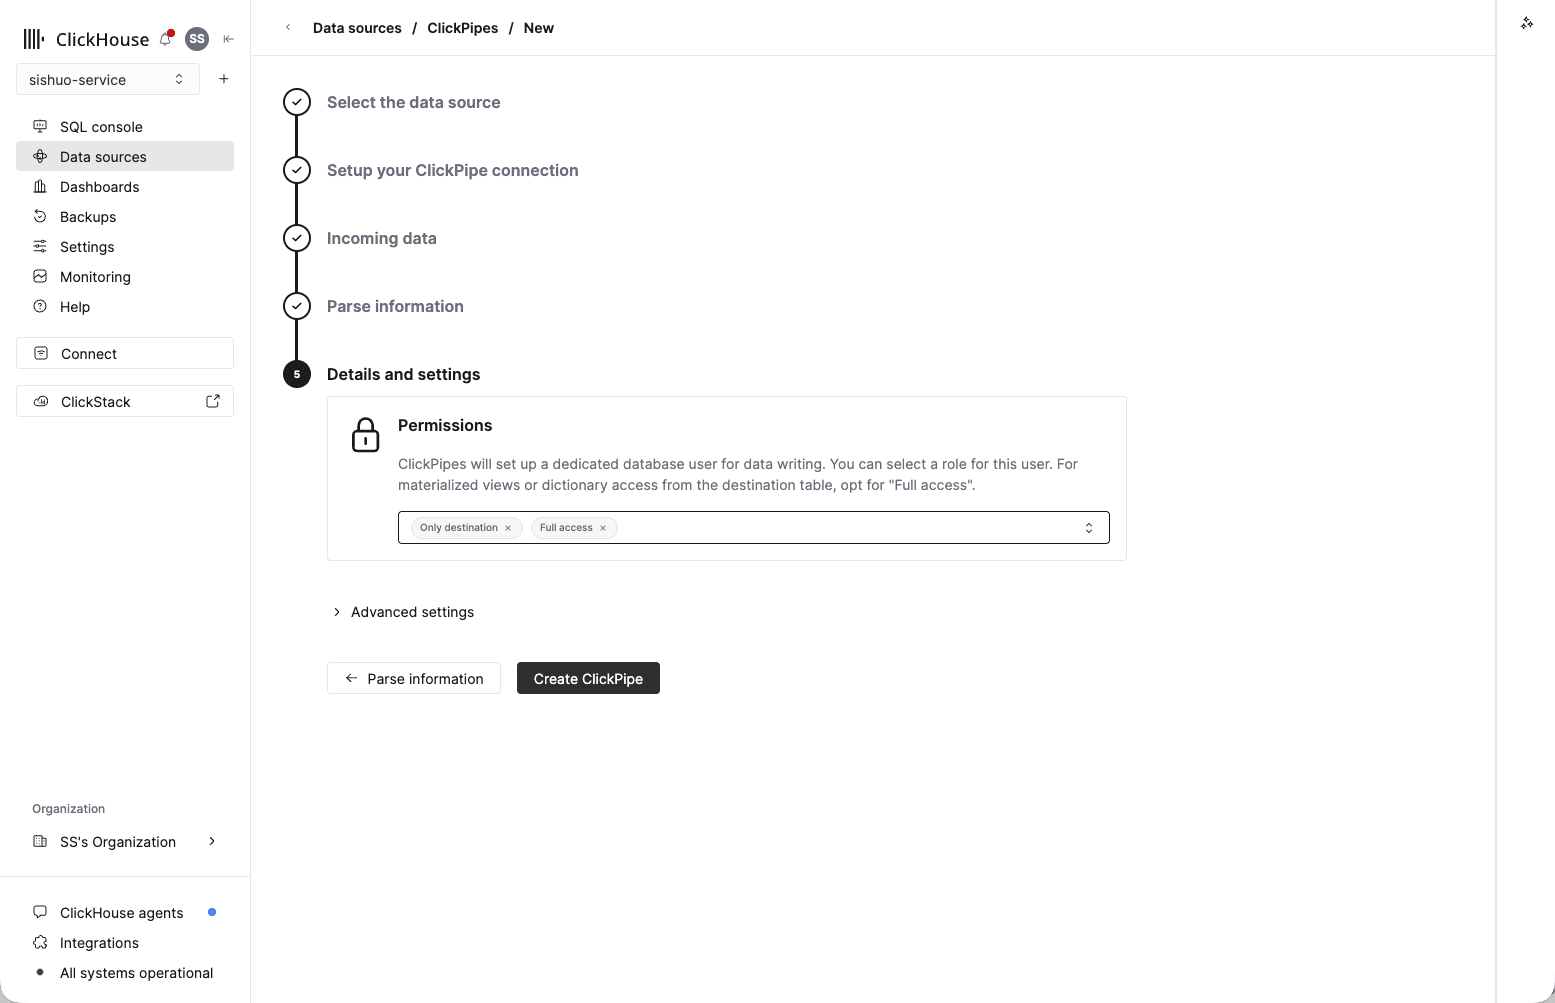
Spark 작업도, 직접 만든 로더도 없습니다.
- 다시 Data sources로 돌아오면 방금 만든 ClickPipe가 보입니다. 몇 초 만에 Status가 Completed로 바뀌고 Records에 26,488,218이 표시됩니다 — 오브젝트 스토리지에서 모든 틱이 로드된 것입니다.
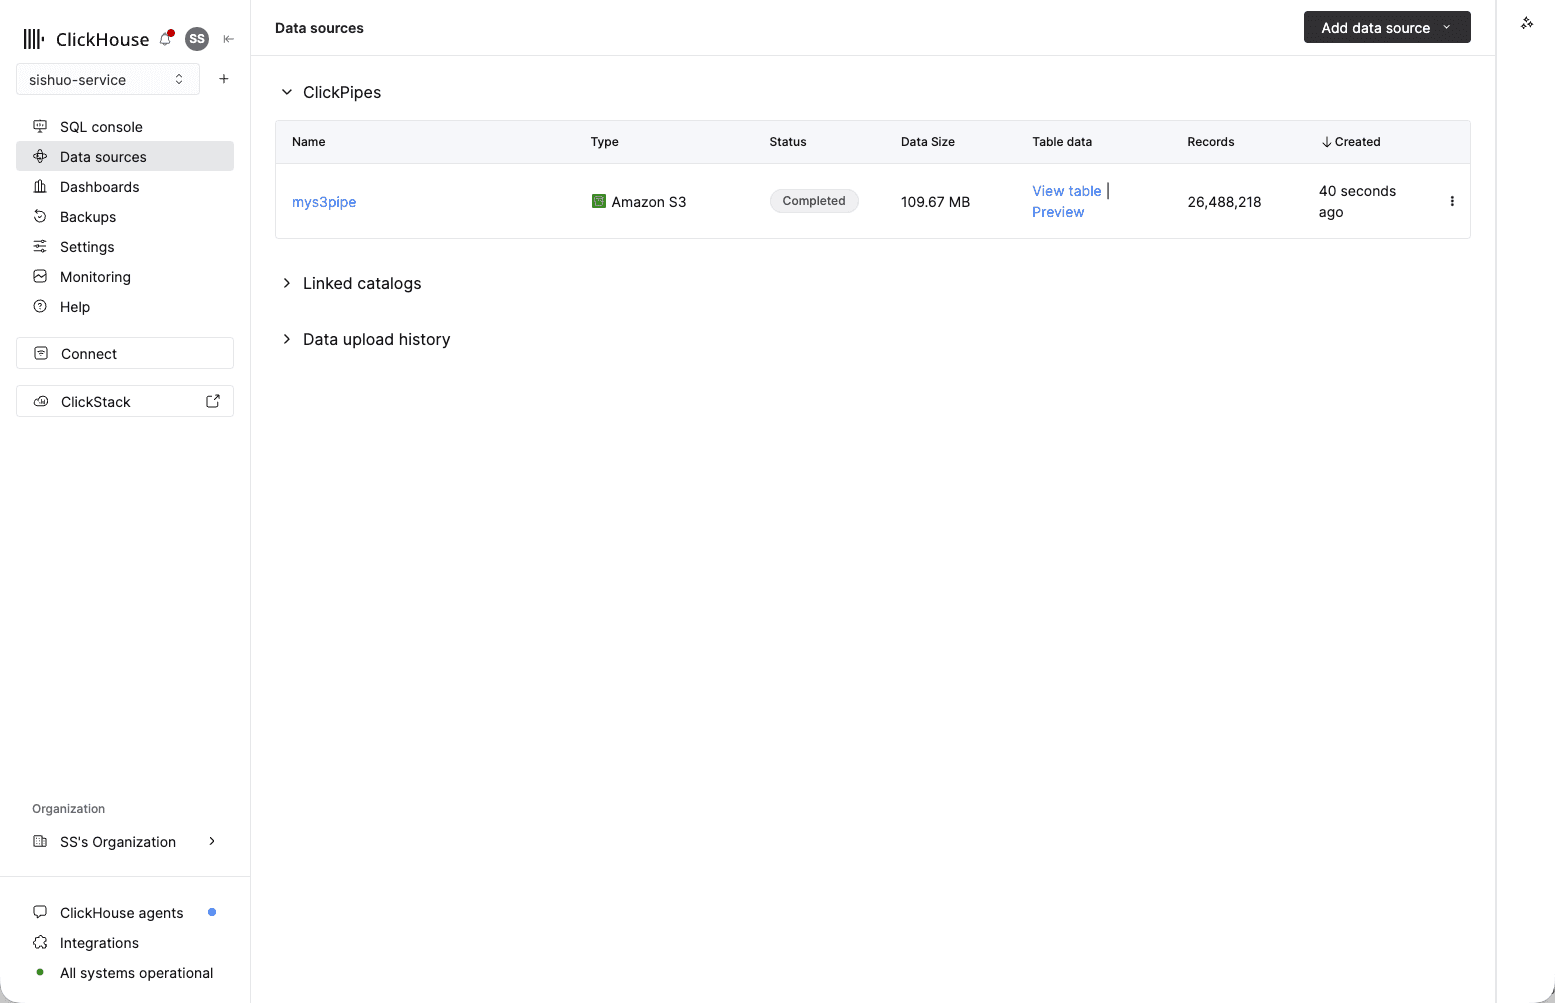
무엇이 로드되었는지 확인하세요. SQL Console에서 이것을 실행합니다:
-- expect 26,488,218 ticks across 12 pairs
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;
이렇게 보여야 합니다
ticks = 26,488,218, 그리고 pairs = 12. 오브젝트 스토리지에서 약 2,650만 행이 몇 초 만에 로드된 것입니다.
방법 2 — s3() 한 줄, 데모에서 가장 빠른 방법
이제 똑같은 데이터를 퍼블릭 파일에서 바로, SQL 문장 하나로 로드합니다. 행 수가 두 배가 되지 않도록 먼저 테이블을 비운 뒤 삽입하세요:
-- clear the rows ClickPipes just loaded so we don't double up
TRUNCATE TABLE forex;

-- load all ~26.5M ticks from the public S3 file in one line (server-side)
INSERT INTO forex
SELECT * FROM s3('https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquet', NOSIGN, 'Parquet');

-- and check again (expect 26,488,218)
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;NOSIGN은 "자격 증명 없음"을 뜻합니다 — 퍼블릭 버킷을 읽는 데 필요한 것은 그것뿐입니다.
테이블의 컬럼 순서가 파일과 일치하기 때문에 SELECT *만으로 동작합니다.
ClickPipes와 s3() 함수 — 언제 무엇을 쓸까
같은 26,488,218 행을 두 가지 방법으로 로드했습니다. 차이는 첫 로드 이후에 무슨 일이 일어나는가, 즉 관리형 상시 파이프라인을 원하는지 아니면 빠른 일회성 읽기를 원하는지입니다.
| ClickPipes | s3() 테이블 함수 | |
|---|---|---|
| 무엇인가 | 콘솔에서 설정하는 완전 관리형 인제스션 서비스 | 쿼리 안에서 인라인으로 호출하는 SQL 함수 |
| 적합한 곳 | 프로덕션, 그리고 설정 후 신경 쓰지 않아도 되는 상시 로드 | 빠른 일회성 로드, 임시 탐색, 스크립트 |
| 상시 / 신규 파일 | 버킷이나 스트림을 계속 감시하며 새 데이터를 연속 로드 가능 | 일회성 — 실행할 때 있는 것만 읽습니다 |
| 설정 | 가이드형 UI, SQL 불필요 | INSERT … SELECT 문장 하나 |
| 모니터링과 재시도 | 내장 — 콘솔에서 상태, 오류 처리, 재시도 | 없음 — 실패하면 직접 다시 실행 |
| 소스 | 다양함: S3, GCS, Azure, Kafka와 다른 스트림, Postgres/MySQL CDC 등 | 오브젝트 스토리지만(형제 함수: gcs(), azureBlobStorage(), url()) |
대략의 기준: 데이터가 계속 들어오고 관리형으로 두고 싶다면 ClickPipes를 쓰고, 지금 당장
파일 하나만 가져오고 싶다면 **s3()**를 쓰세요. 오늘은 빠르게 쿼리로 넘어가기 위해 한 줄짜리를
사용했습니다 — 이제 쿼리해 봅시다.