03 โหลดข้อมูล — สองวิธี
tick 26.5 ล้านรายการชุดเดียวกันโหลดสองครั้ง: ClickPipes ซึ่งเป็นไปป์ไลน์แบบจัดการให้ที่คุณจะใช้บนโปรดักชัน แล้วต่อด้วย s3() แบบบรรทัดเดียว — และควรเลือกใช้อันไหนเมื่อไหร่
ข้อมูลอยู่ในบัคเก็ต S3 แบบ สาธารณะ จึง ไม่ต้องใช้คีย์หรือ credential ใด ๆ — คุณเพียง ชี้ไปที่ URL การถ่ายโอนเกิดขึ้นฝั่งเซิร์ฟเวอร์จาก S3 ไปยัง ClickHouse ดังนั้นมันไม่ได้สตรีม ข้อมูล 26.5 ล้านแถวผ่านแล็ปท็อปของคุณ และไม่ขึ้นกับ Wi-Fi ของสถานที่จัดงาน
คุณจะโหลด tick 26.5 ล้านรายการชุดเดียวกัน สองวิธีที่ต่างกัน เพื่อให้เห็นทั้งสองแบบ วิธีที่ 1 คือ
ClickPipes ไปป์ไลน์แบบจัดการให้ที่กดผ่าน UI ซึ่งคุณจะใช้บนโปรดักชัน วิธีที่ 2 คือ SQL
บรรทัดเดียว — วิธีที่เร็วที่สุดในการนำข้อมูลเข้าตอนเดโม ทำตามลำดับ โดยมี TRUNCATE คั่น
ระหว่างกลางเพื่อให้จำนวนแถวไม่ซ้ำซ้อน
วิธีที่ 1 — ClickPipes แบบจัดการให้ สไตล์โปรดักชัน
ClickPipes คือบริการ ingestion แบบจัดการให้เต็มรูปแบบ: ชี้มันไปที่ object storage หรือสตรีม แล้วมันจะโหลดต่อเนื่องให้เอง โดยไม่ต้องสร้างคอนเนกเตอร์ นี่คือขั้นตอนทั้งหมด
- ในเมนูด้านซ้าย คลิก Data sources แล้วคลิกปุ่ม Create ClickPipe
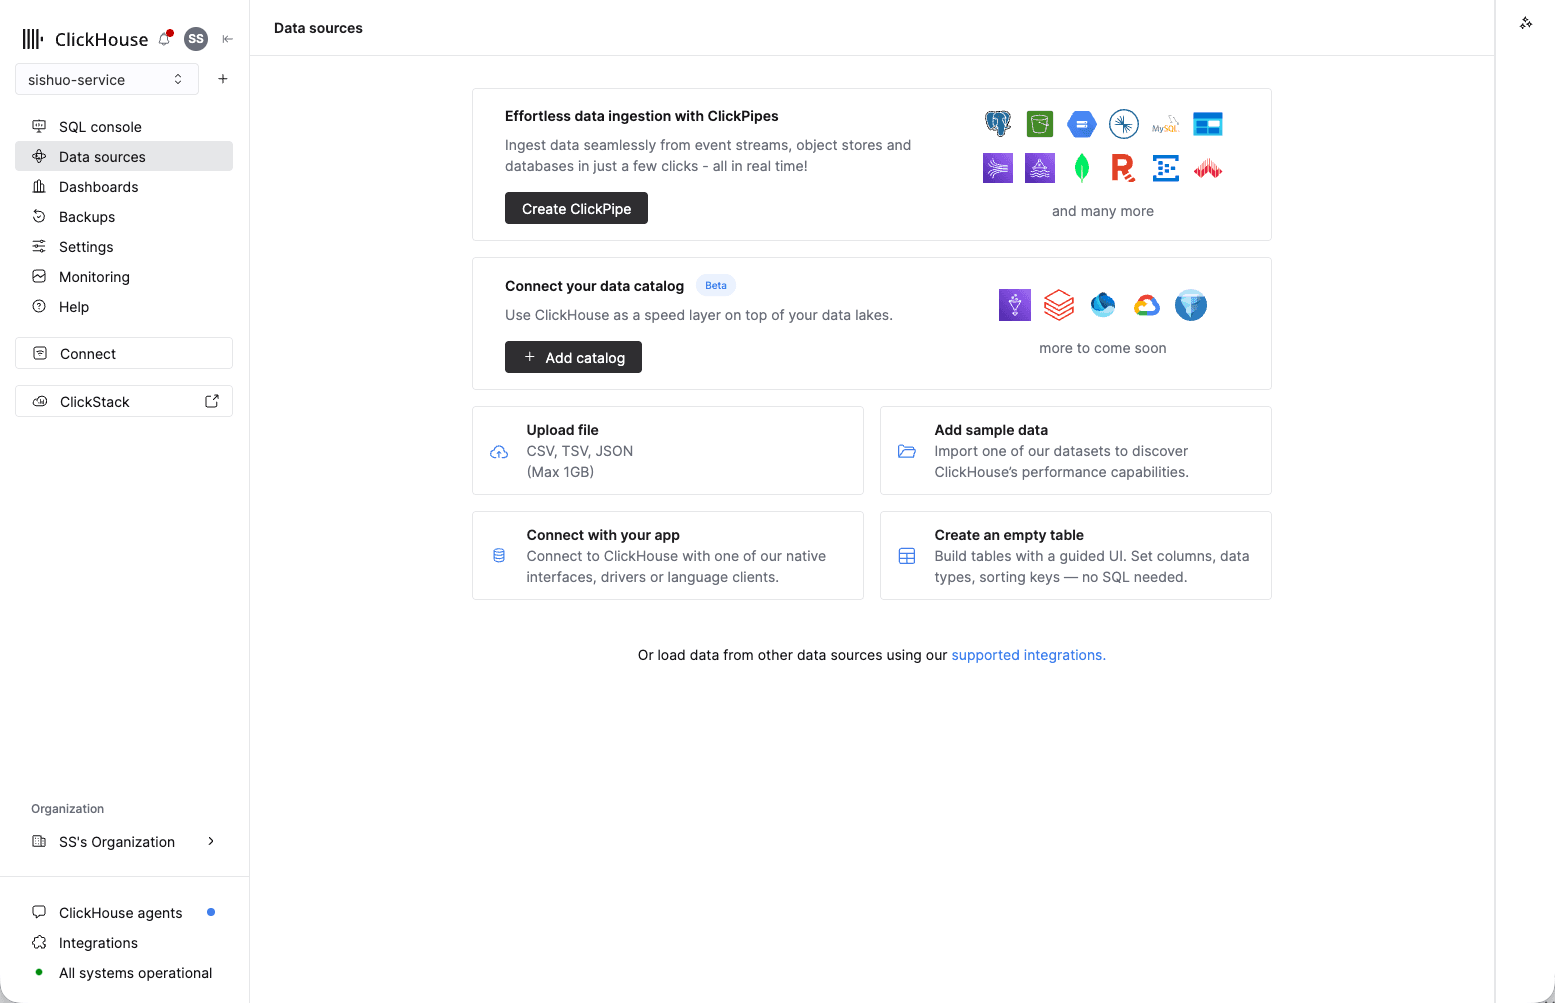
Data sources ยังเป็นที่อยู่ของ "Upload file" และ "Add sample data" ด้วย
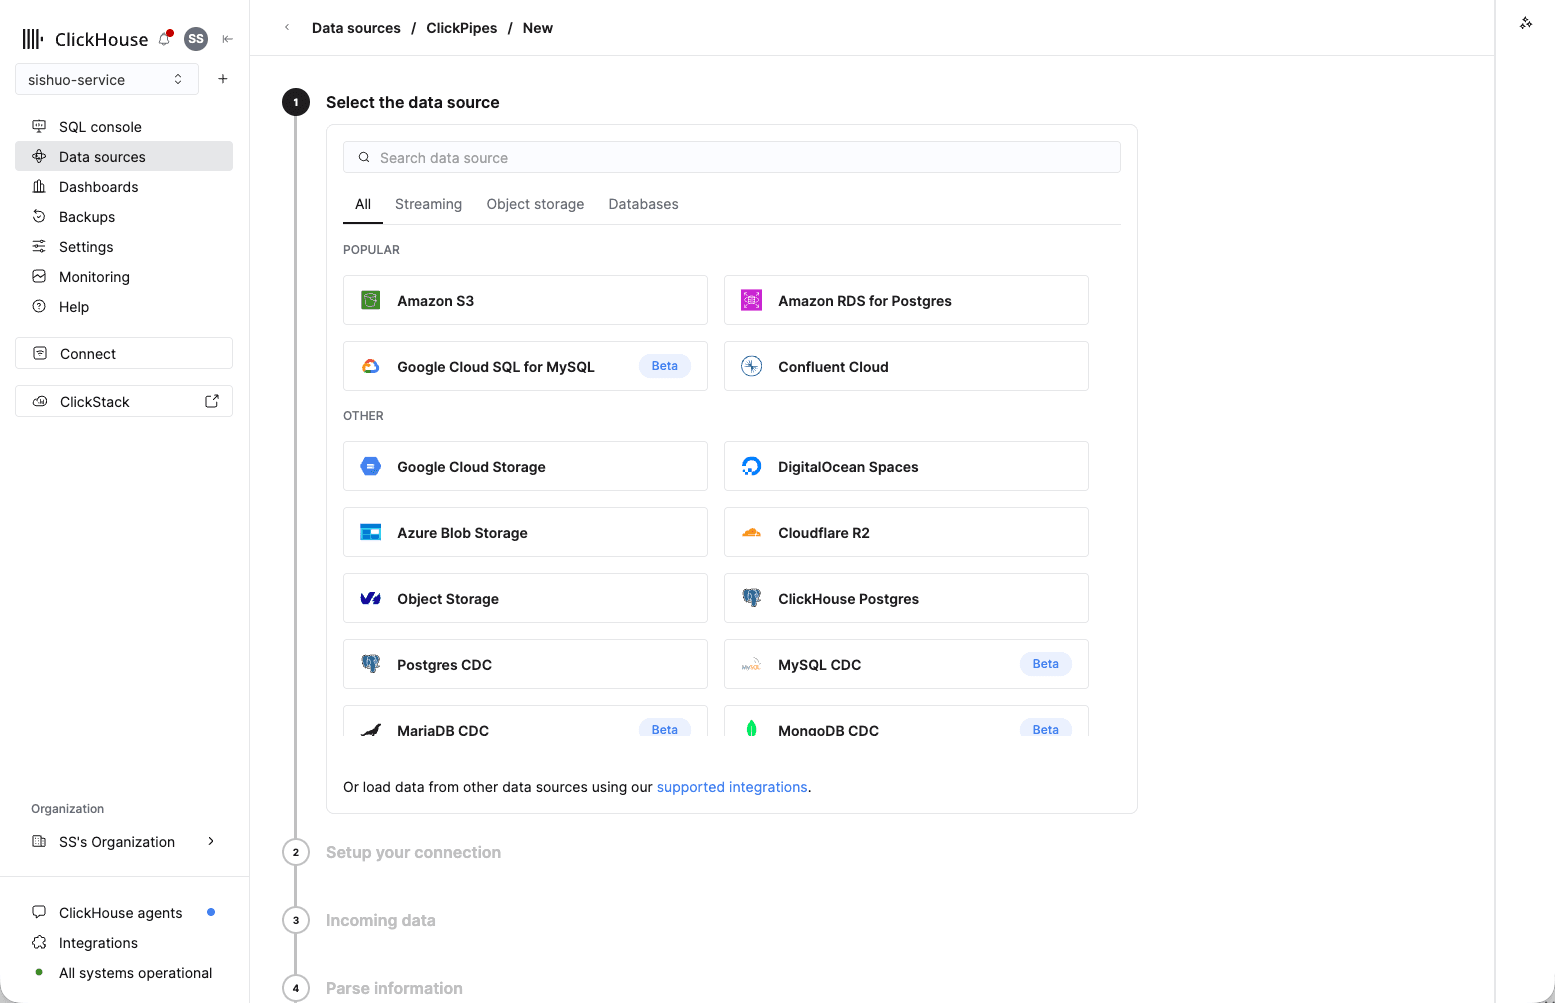
- ใต้หัวข้อ Select the data source เลือก Amazon S3 (อยู่บนสุดของรายการ Popular)
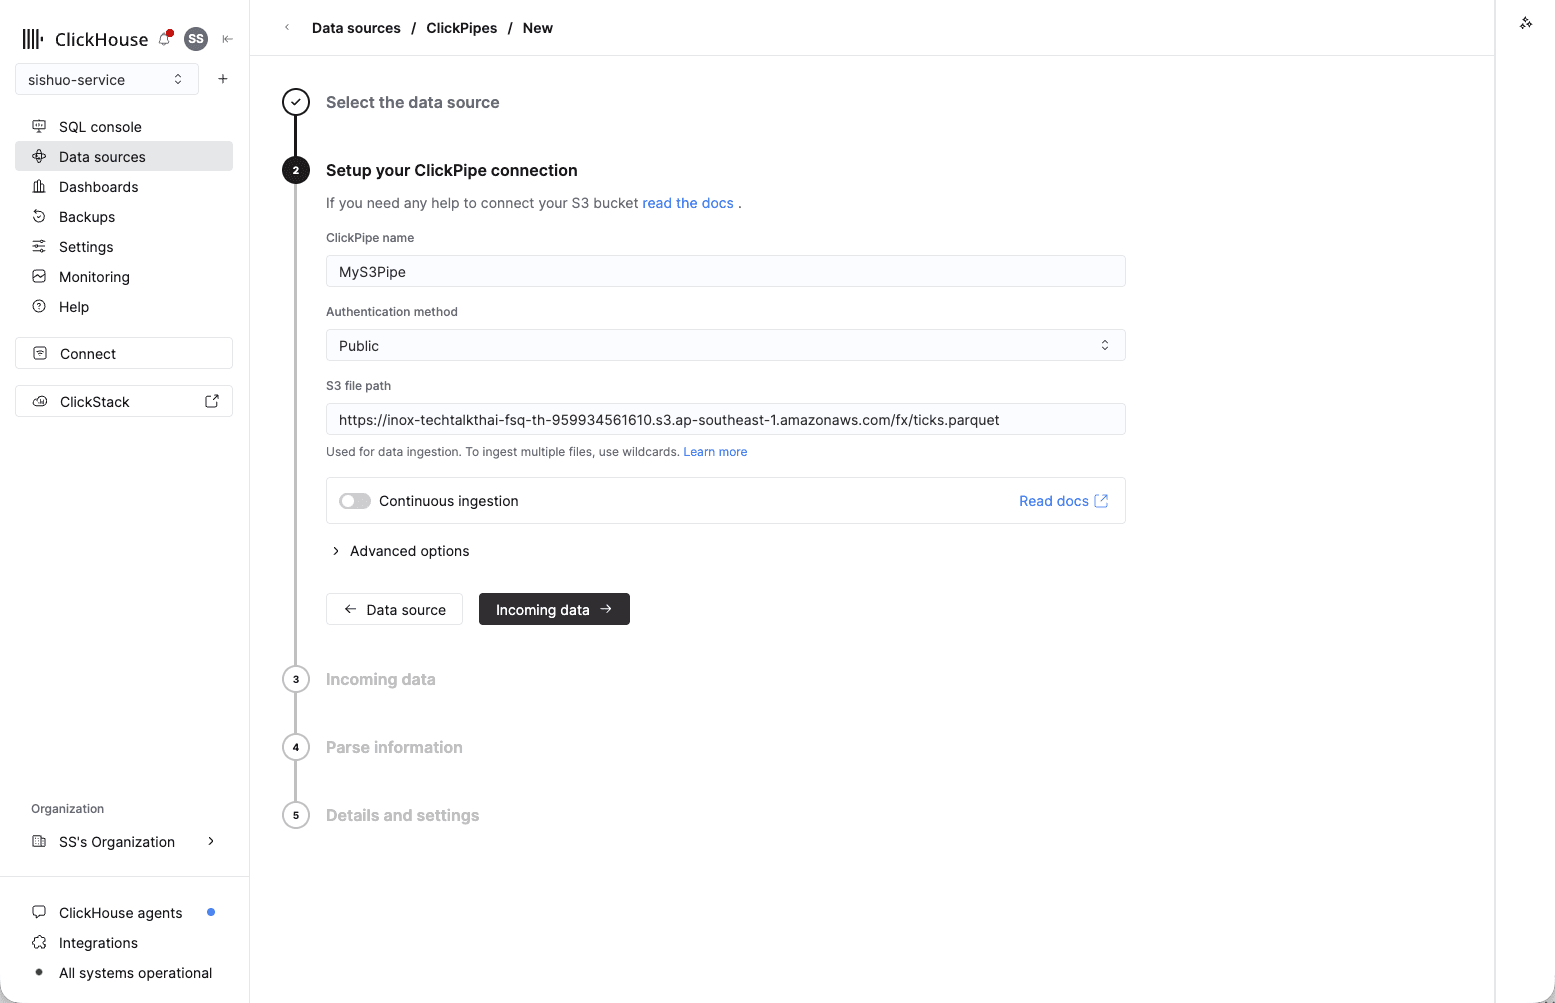
- ที่หน้า Setup your ClickPipe connection ตั้ง name เป็นอะไรก็ได้ ตั้งค่า Authentication method → Public (เพราะบัคเก็ตเป็นแบบสาธารณะ) แล้ววางค่านี้ลงใน S3 file path:
https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquetปล่อย Continuous ingestion ไว้เป็นปิด — เพราะนี่เป็นไฟล์ครั้งเดียว — แล้วคลิก Incoming data →
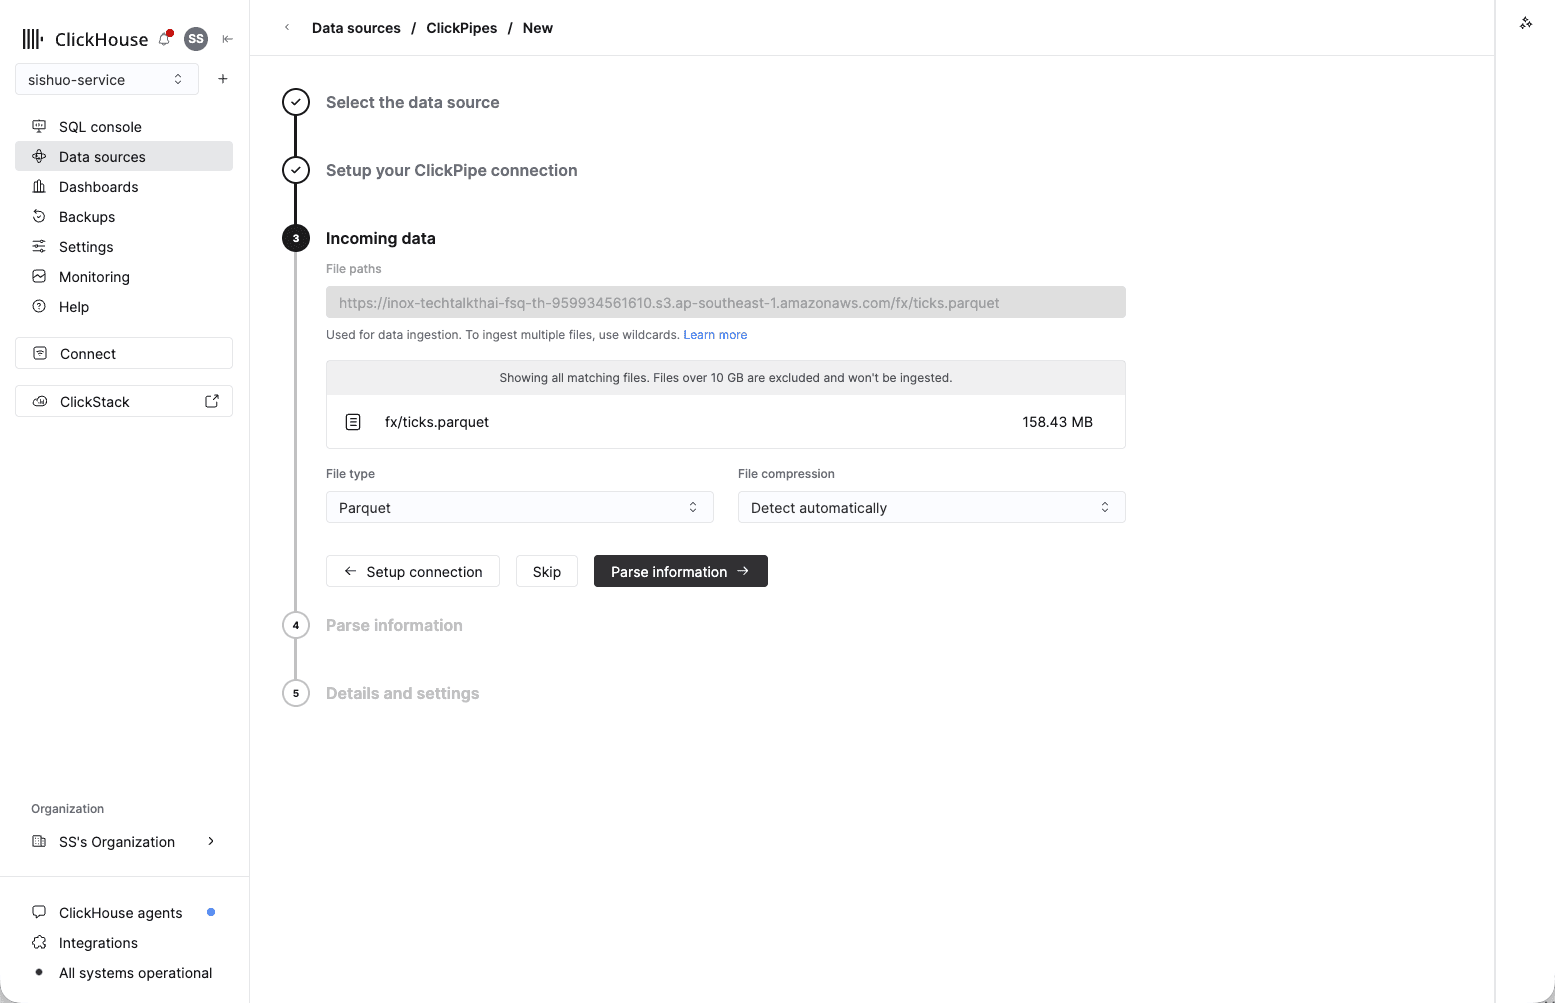
- ที่หน้า Incoming data ClickHouse จะพรีวิวไฟล์ที่ตรงเงื่อนไข — คุณจะเห็น
fx/ticks.parquetขนาด 158.43 MB ยืนยันว่า File type → Parquet ปล่อยการบีบอัดไว้ที่ Detect automatically แล้วคลิก Parse information →
- ที่หน้า Parse information ClickHouse จะพรีวิวแถวตัวอย่างและตรวจจับคอลัมน์ให้ ใต้หัวข้อ
Upload data to เลือก Existing table เลือก Database ที่มีตารางของคุณอยู่
(ปกติคือ
default) แล้วตั้ง Table →forexตรวจดูว่าฟิลด์ต้นทาง (datetime,bid,ask,base,quote) ตรงกับคอลัมน์ที่คู่กัน — โดยปกติมันจะแมป ให้อัตโนมัติ ปล่อยฟิลด์ส่วนเกิน_path/_file/_sizeไว้โดยไม่ต้องแมป แล้วคลิก Details and settings →
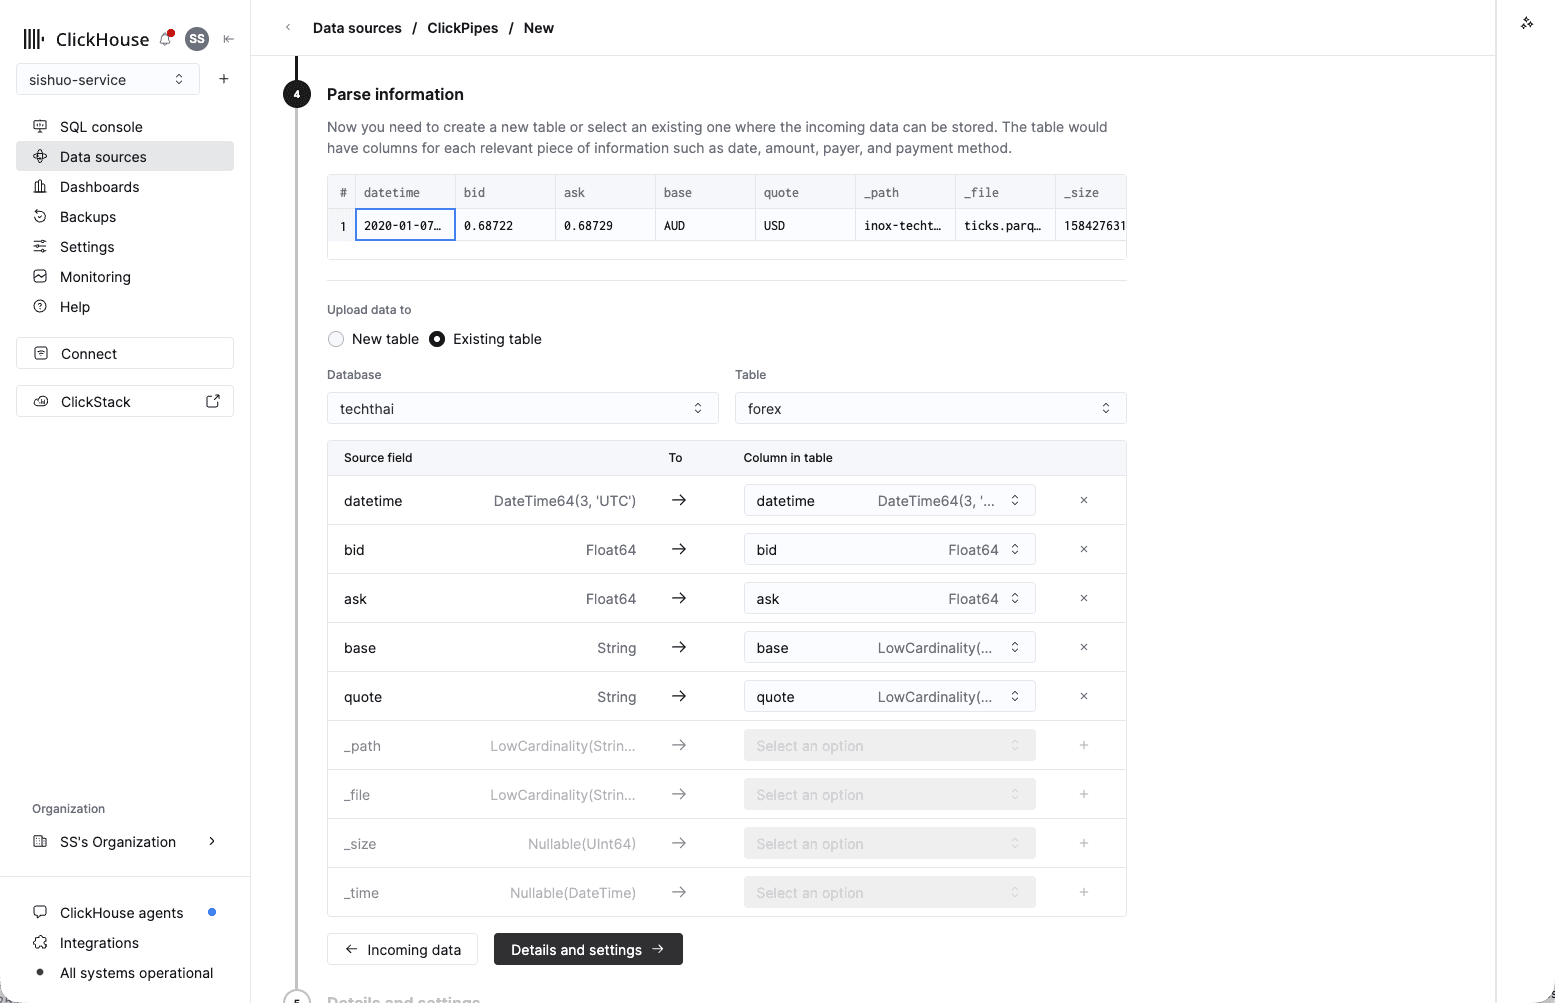
ภาพหน้าจอแสดงฐานข้อมูล techthai ของผู้บรรยาย — ให้ใช้ฐานข้อมูลไหนก็ตามที่มีตารางของคุณอยู่
- ที่หน้า Details and settings ปล่อยค่า Permissions เริ่มต้นไว้ตามเดิม (ClickPipes จะสร้างผู้ใช้สำหรับเขียนข้อมูลโดยเฉพาะให้คุณ) แล้วคลิก Create ClickPipe
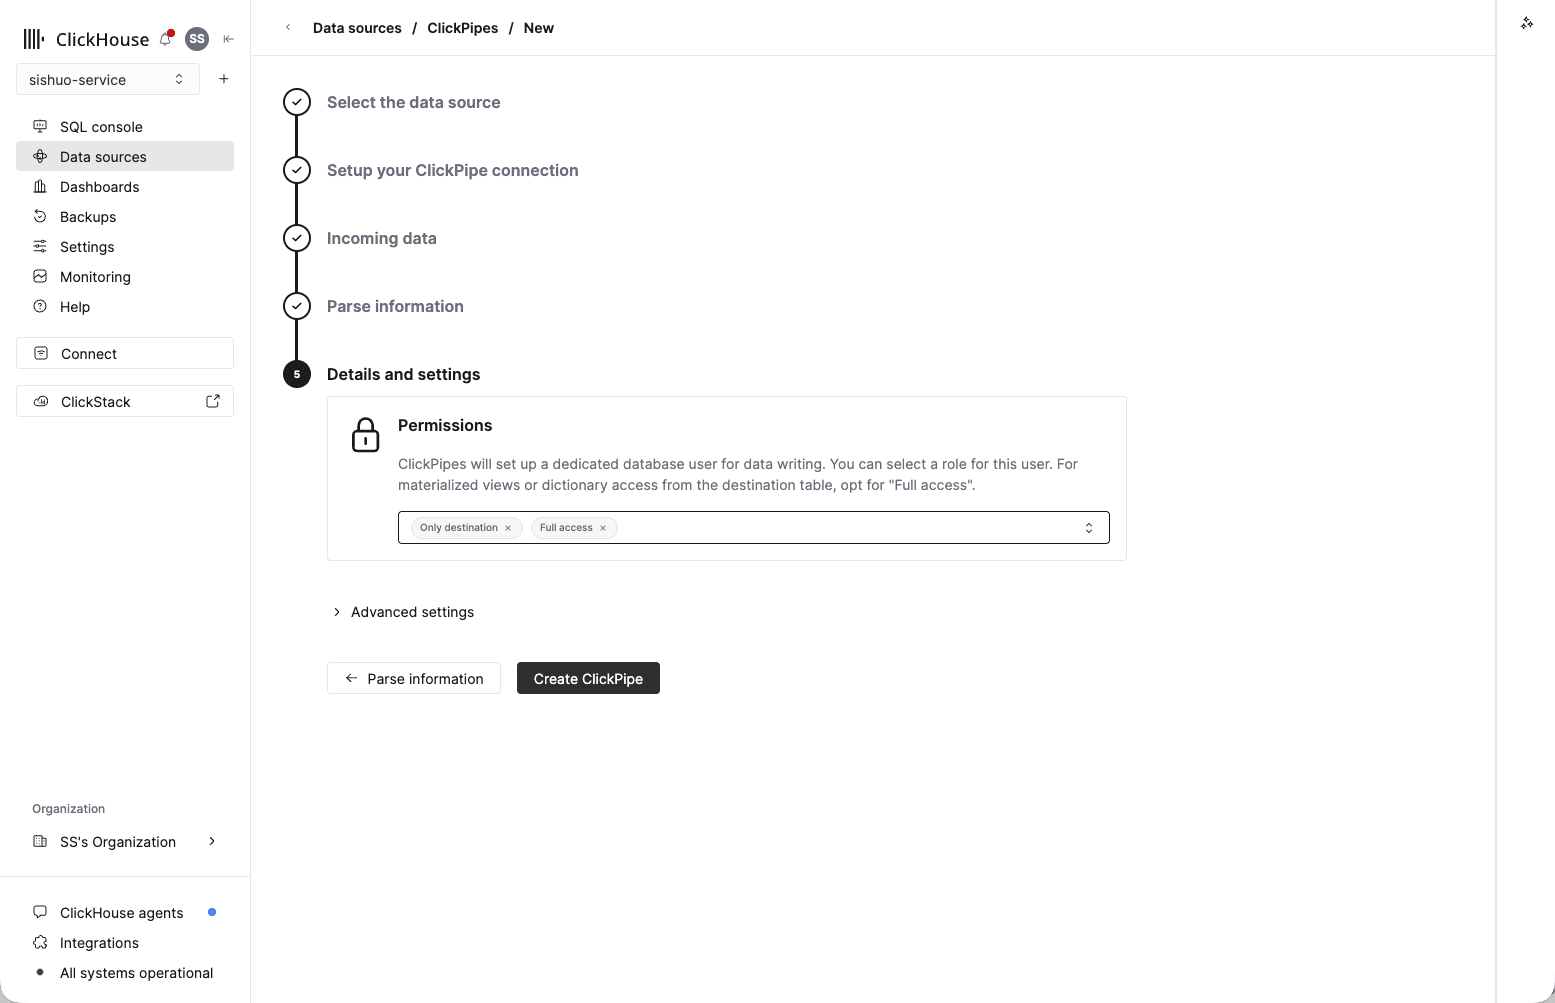
ไม่มี Spark job ไม่มี loader ที่ต้องเขียนเอง
- ระบบจะพากลับไปที่ Data sources ซึ่ง ClickPipe ของคุณจะปรากฏขึ้น ภายในไม่กี่วินาที Status จะเปลี่ยนเป็น Completed และ Records จะแสดง 26,488,218 — tick ทั้งหมดถูกโหลดจาก object storage แล้ว
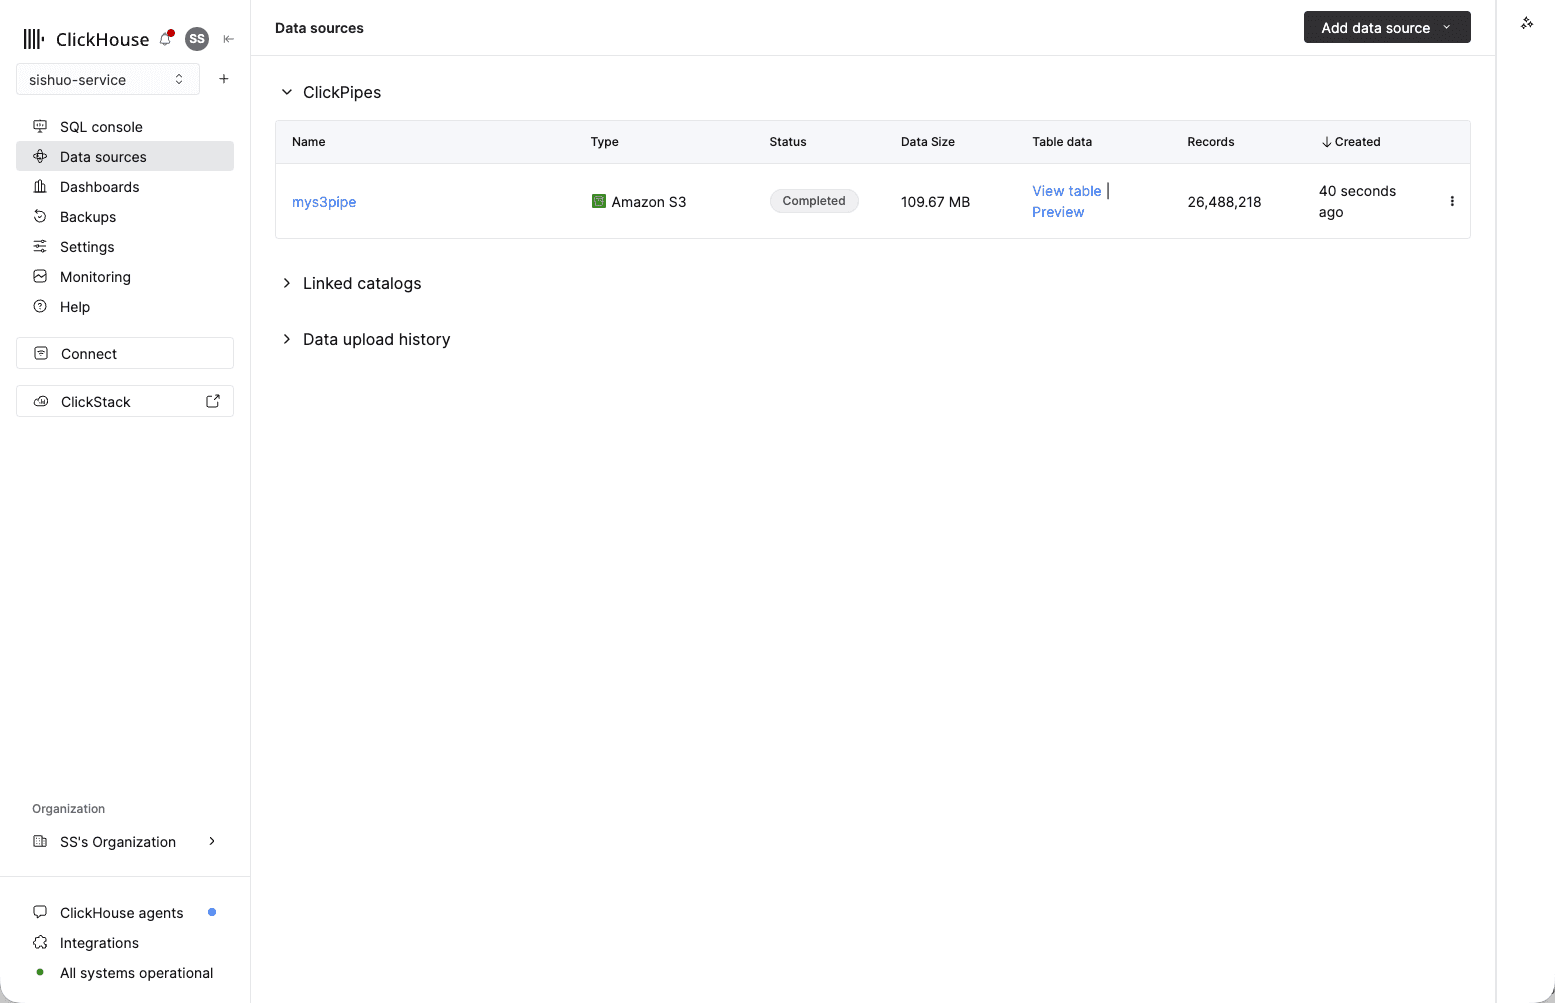
ตรวจดูว่าโหลดอะไรเข้ามา รันคำสั่งนี้ใน SQL Console:
-- expect 26,488,218 ticks across 12 pairs
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;
สิ่งที่คุณควรเห็น
ticks = 26,488,218 และ pairs = 12 นั่นคือประมาณ 26.5 ล้านแถวที่โหลดจาก object storage ในเวลาไม่กี่วินาที
วิธีที่ 2 — s3() บรรทัดเดียว เร็วที่สุดตอนเดโม
ตอนนี้ลองโหลดข้อมูลชุดเดิมทั้งหมดด้วย SQL คำสั่งเดียว ตรงจากไฟล์สาธารณะ เริ่มด้วย การล้างตาราง เพื่อให้จำนวนแถวไม่เพิ่มเป็นสองเท่า แล้วค่อย insert:
-- clear the rows ClickPipes just loaded so we don't double up
TRUNCATE TABLE forex;

-- load all ~26.5M ticks from the public S3 file in one line (server-side)
INSERT INTO forex
SELECT * FROM s3('https://partner-workshop.s3.ap-southeast-1.amazonaws.com/fx/ticks.parquet', NOSIGN, 'Parquet');

-- and check again (expect 26,488,218)
SELECT count() AS ticks, uniqExact(concat(base,'/',quote)) AS pairs FROM forex;
NOSIGN หมายถึง "ไม่ใช้ credential" — เท่านี้ก็อ่านบัคเก็ตสาธารณะได้แล้ว และ SELECT *
ใช้ได้เลยเพราะลำดับคอลัมน์ของตารางตรงกับในไฟล์
ClickPipes กับฟังก์ชัน s3() — ควรใช้อันไหนเมื่อไหร่
ข้อมูล 26,488,218 แถวชุดเดียวกัน โหลดสองวิธี ความต่างอยู่ที่สิ่งที่เกิดขึ้น หลัง การโหลดครั้งแรก — ว่าคุณต้องการไปป์ไลน์แบบจัดการให้ที่ทำงานต่อเนื่อง หรือการอ่านครั้งเดียวแบบเร็ว ๆ
| ClickPipes | ฟังก์ชันตาราง s3() | |
|---|---|---|
| มันคืออะไร | บริการ ingestion แบบจัดการให้เต็มรูปแบบที่คุณตั้งค่าในคอนโซล | ฟังก์ชัน SQL ที่คุณเรียกใช้ในคิวรีได้ตรง ๆ |
| เหมาะกับ | โปรดักชันและการโหลดต่อเนื่องที่คุณอยากตั้งไว้แล้วลืมไปเลย | การโหลดครั้งเดียวแบบเร็ว ๆ การสำรวจข้อมูลเฉพาะกิจ สคริปต์ |
| ไฟล์ใหม่ / ต่อเนื่อง | เฝ้าดูบัคเก็ตหรือสตรีมและโหลดข้อมูลใหม่ต่อเนื่องได้ | ครั้งเดียวจบ — อ่านเฉพาะสิ่งที่มีอยู่ตอนที่คุณรัน |
| การตั้งค่า | UI แบบมีขั้นตอนนำ ไม่ต้องเขียน SQL | คำสั่ง INSERT … SELECT เดียว |
| การมอนิเตอร์และการลองใหม่ | มีมาให้ในตัว — สถานะ การจัดการข้อผิดพลาด และการลองใหม่ในคอนโซล | ไม่มี — ถ้าล้มเหลวคุณต้องรันเองใหม่ |
| แหล่งข้อมูล | มีหลากหลาย: S3, GCS, Azure, Kafka และสตรีมอื่น ๆ, Postgres/MySQL CDC และอื่น ๆ | object storage เท่านั้น (ฟังก์ชันพี่น้อง: gcs(), azureBlobStorage(), url()) |
หลักคิดง่าย ๆ: เลือก ClickPipes เมื่อข้อมูลไหลเข้ามาเรื่อย ๆ และคุณอยากให้มีคนจัดการให้
เลือก s3() เมื่อคุณเพียงต้องการดึงไฟล์เข้ามาเดี๋ยวนี้ วันนี้คุณใช้แบบบรรทัดเดียวเพื่อ
เริ่มคิวรีให้ไว — ตอนนี้ไปคิวรีกันเลย
02 สร้างตาราง
CREATE TABLE เพียงคำสั่งเดียวสำหรับ forex tick 26.5 ล้านรายการ และเหตุผลที่ base กับ quote นำหน้าใน sort key — การตัดสินใจที่คุณจะสัมผัสได้ในโมดูล 04
04 รันคิวรีวิเคราะห์ตลาด
เจ็ดคิวรีบน tick 26.5 ล้านรายการ แต่ละคิวรีแทน SQL ทั้งหน้า: การนับแบบประมาณ, topK, แท่งเทียน OHLC, เปอร์เซ็นไทล์, คอมบิเนเตอร์ -If, argMax และบทสรุปเรื่อง sort key