Provisione o ClickHouse Cloud, faça gravação dupla pelo OpenTelemetry, valide a paridade, explore o ClickStack e realize a transição.
Execute este módulo a partir do diretório de artefatos do workshop:
cd "$(git rev-parse --show-toplevel)/workshops/elasticsearch_migration_lab/part3"
Objetivo: execute o plano de migração desenvolvido na Parte 2. Implante um OTel Collector, crie tabelas otimizadas do ClickHouse, configure o enriquecimento por meio de dicionários, valide a paridade com o ambiente Elasticsearch em execução e faça a transição.
Tempo estimado: 120–180 minutos
Pré-requisitos: Partes 1 e 2 concluídas; o ambiente Docker da Parte 1 está em execução (Elasticsearch, Kibana, geradores de logs e APM Server). As credenciais da sua conta do ClickHouse Cloud estão disponíveis.
Arquivos:
part3/├── exercises/│ ├── setup-checklist.md ← Fill in as you work through each step│ └── sql-exercises.md ← 6 SQL exercises (attempt before checking solutions)├── clickhouse/│ ├── schema.sql ← All DDL (run first)│ ├── dictionaries.sql ← GeoIP dictionary DDL│ ├── geoip-sample-data.csv ← ~400 CIDR rows (no MaxMind account needed)│ ├── alert-tables.sql ← Alert pre-computation + summary MVs│ └── validation-queries.sql ← Spot-checks and parity queries├── configs/│ ├── otel-collector-config.parallel.yaml ← File-based log collector — parallel run (CH + ES dual-write)│ ├── otel-collector-config.cutover.yaml ← File-based log collector — cutover (CH only)│ ├── otelcol-demo-config.parallel.yml ← OTel Demo collector — parallel run (APM + CH)│ └── otelcol-demo-config.cutover.yml ← OTel Demo collector — cutover (CH only)├── docker/│ ├── docker-compose.otel-demo.parallel.yml ← Compose override for parallel-run swap│ └── docker-compose.otel-demo.cutover.yml ← Compose override for cutover swap├── diagrams/│ ├── step3-architecture.mmd ← Mermaid source — post-Step-3 architecture│ ├── step3-architecture.png ← Rendered PNG embedded in Step 3│ └── render.sh ← Re-render *.mmd → *.png via Docker (mermaid-cli)├── images/│ └── *.png ← Screenshots referenced by hyperdx-guide.md└── scripts/ ├── swap-otelcol-demo-config.sh ← Swap otelcol-demo config (parallel|cutover) ├── validate_migration.sh ← Automated parity check └── validate_enrichment.sh ← Enrichment column verification
Observação sobre a arquitetura do ClickHouse Cloud: Diferentemente do Elasticsearch, o ClickHouse Cloud armazena todos os dados em armazenamento de objetos (S3/GCS), com cache local automático. Não existe o conceito de camadas de nós hot/warm/cold — o mecanismo de consultas busca e armazena os dados em cache de modo transparente. Portanto, todo o mecanismo hot→warm→cold do ILM do ES não tem equivalente no ClickHouse Cloud. Você precisa apenas de exclusão baseada em TTL, que será configurada na Etapa 2.
Defina as variáveis de ambiente para o restante do laboratório:
# Copy and fill in once, then source before every sessioncp ../common/env.sh.example ../common/env.sh# edit ../common/env.sh with your CH_HOST and CH_PASSWORD (from Cloud console → Connect → Native protocol)source ../common/env.sh
Banco de dados: Todos os objetos da Parte 3 (tabelas, dicionários e views materializadas) ficam em um banco de dados otel dedicado — criado automaticamente por dictionaries.sql e schema.sql por meio de CREATE DATABASE IF NOT EXISTS otel. Isso mantém as tabelas do laboratório isoladas do restante do serviço. Todas as configurações de collector, scripts de validação e fontes do HyperDX desta parte já apontam para otel.
Ordem de execução: Os dicionários GeoIP (Etapa 2a) devem ser criados antes das tabelas de destino (Etapa 2b), pois otel_logs_v2 tem colunas MATERIALIZED que fazem referência a otel.geoip_country e otel.geoip_city. O ClickHouse valida as referências a dicionários durante CREATE TABLE.
# 1. Create the otel database, geoip_data source table, and empty dictionaries# (the table must exist before you can INSERT into it)clickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ < clickhouse/dictionaries.sql# 2. Load sample data into the source table (note: --database otel)clickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --database otel \ --query "INSERT INTO geoip_data FORMAT CSVWithNames" \ < clickhouse/geoip-sample-data.csv# 3. Reload dictionaries — they were created with an empty table; force reload nowclickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --query "SYSTEM RELOAD DICTIONARY otel.geoip_country"clickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --query "SYSTEM RELOAD DICTIONARY otel.geoip_city"# 4. Verifyclickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --query "SELECT dictGet('otel.geoip_country', 'country', toIPv4('8.8.8.8'))"# Expected: United States
Ponto de ensino: No Elasticsearch, o processador geoip é uma caixa-preta integrada — basta habilitá-lo. No ClickHouse, você usa um dicionário baseado nos mesmos dados do MaxMind, com controle total sobre a fonte de dados, o intervalo de atualização e o comportamento das consultas. O layout IP_TRIE foi criado especificamente para consultas de intervalos CIDR: dictGet() faz a correspondência do prefixo mais longo na tabela de intervalos de IP em microssegundos.
Destino de ingestão do OTel Collector; não armazena nada
otel_logs_v2
MergeTree
Onde os dados realmente ficam, com colunas de enriquecimento
otel_logs_mv
View materializada
Encaminha otel_logs → otel_logs_v2 com transformações
otel_traces
MergeTree
Spans de trace do OTel
otel_metrics_gauge
MergeTree
Métricas gauge do OTel (substitui o APM Server como backend de métricas)
otel_metrics_sum
MergeTree
Métricas de soma/contador do OTel
otel_metrics_histogram
MergeTree
Métricas de histograma do OTel
otel_metrics_exponentialhistogram
MergeTree
Métricas de histograma exponencial do OTel
otel_metrics_summary
MergeTree
Métricas de resumo do OTel
Por que usar o padrão Null → MV → destino?
O mecanismo Null aceita inserções, mas descarta os dados imediatamente. A MV anexada é acionada a cada inserção e grava linhas transformadas em otel_logs_v2. Isso evita armazenar os dados duas vezes: o OTel Collector grava o esquema OTel bruto em otel_logs, e somente as linhas enriquecidas e otimizadas chegam a otel_logs_v2.
As colunas materializadas substituem todos os processadores dos pipelines de ingestão do ES:
Processador do ES
Equivalente no ClickHouse
geoip
GeoCountry, GeoCity MATERIALIZED por meio de dictGetOrDefault('otel.geoip_country', ...)
user_agent
BrowserFamily, OSFamily, IsBot MATERIALIZED por meio de regexpExtract/position
script (derivação da severidade)
DerivedSeverity MATERIALIZED por meio de multiIf(StatusCode >= 500, 'critical', ...)
grok/dissect (extração de campos)
RequestType, RequestPath, RequestPage, HostName MATERIALIZED a partir de LogAttributes['key']
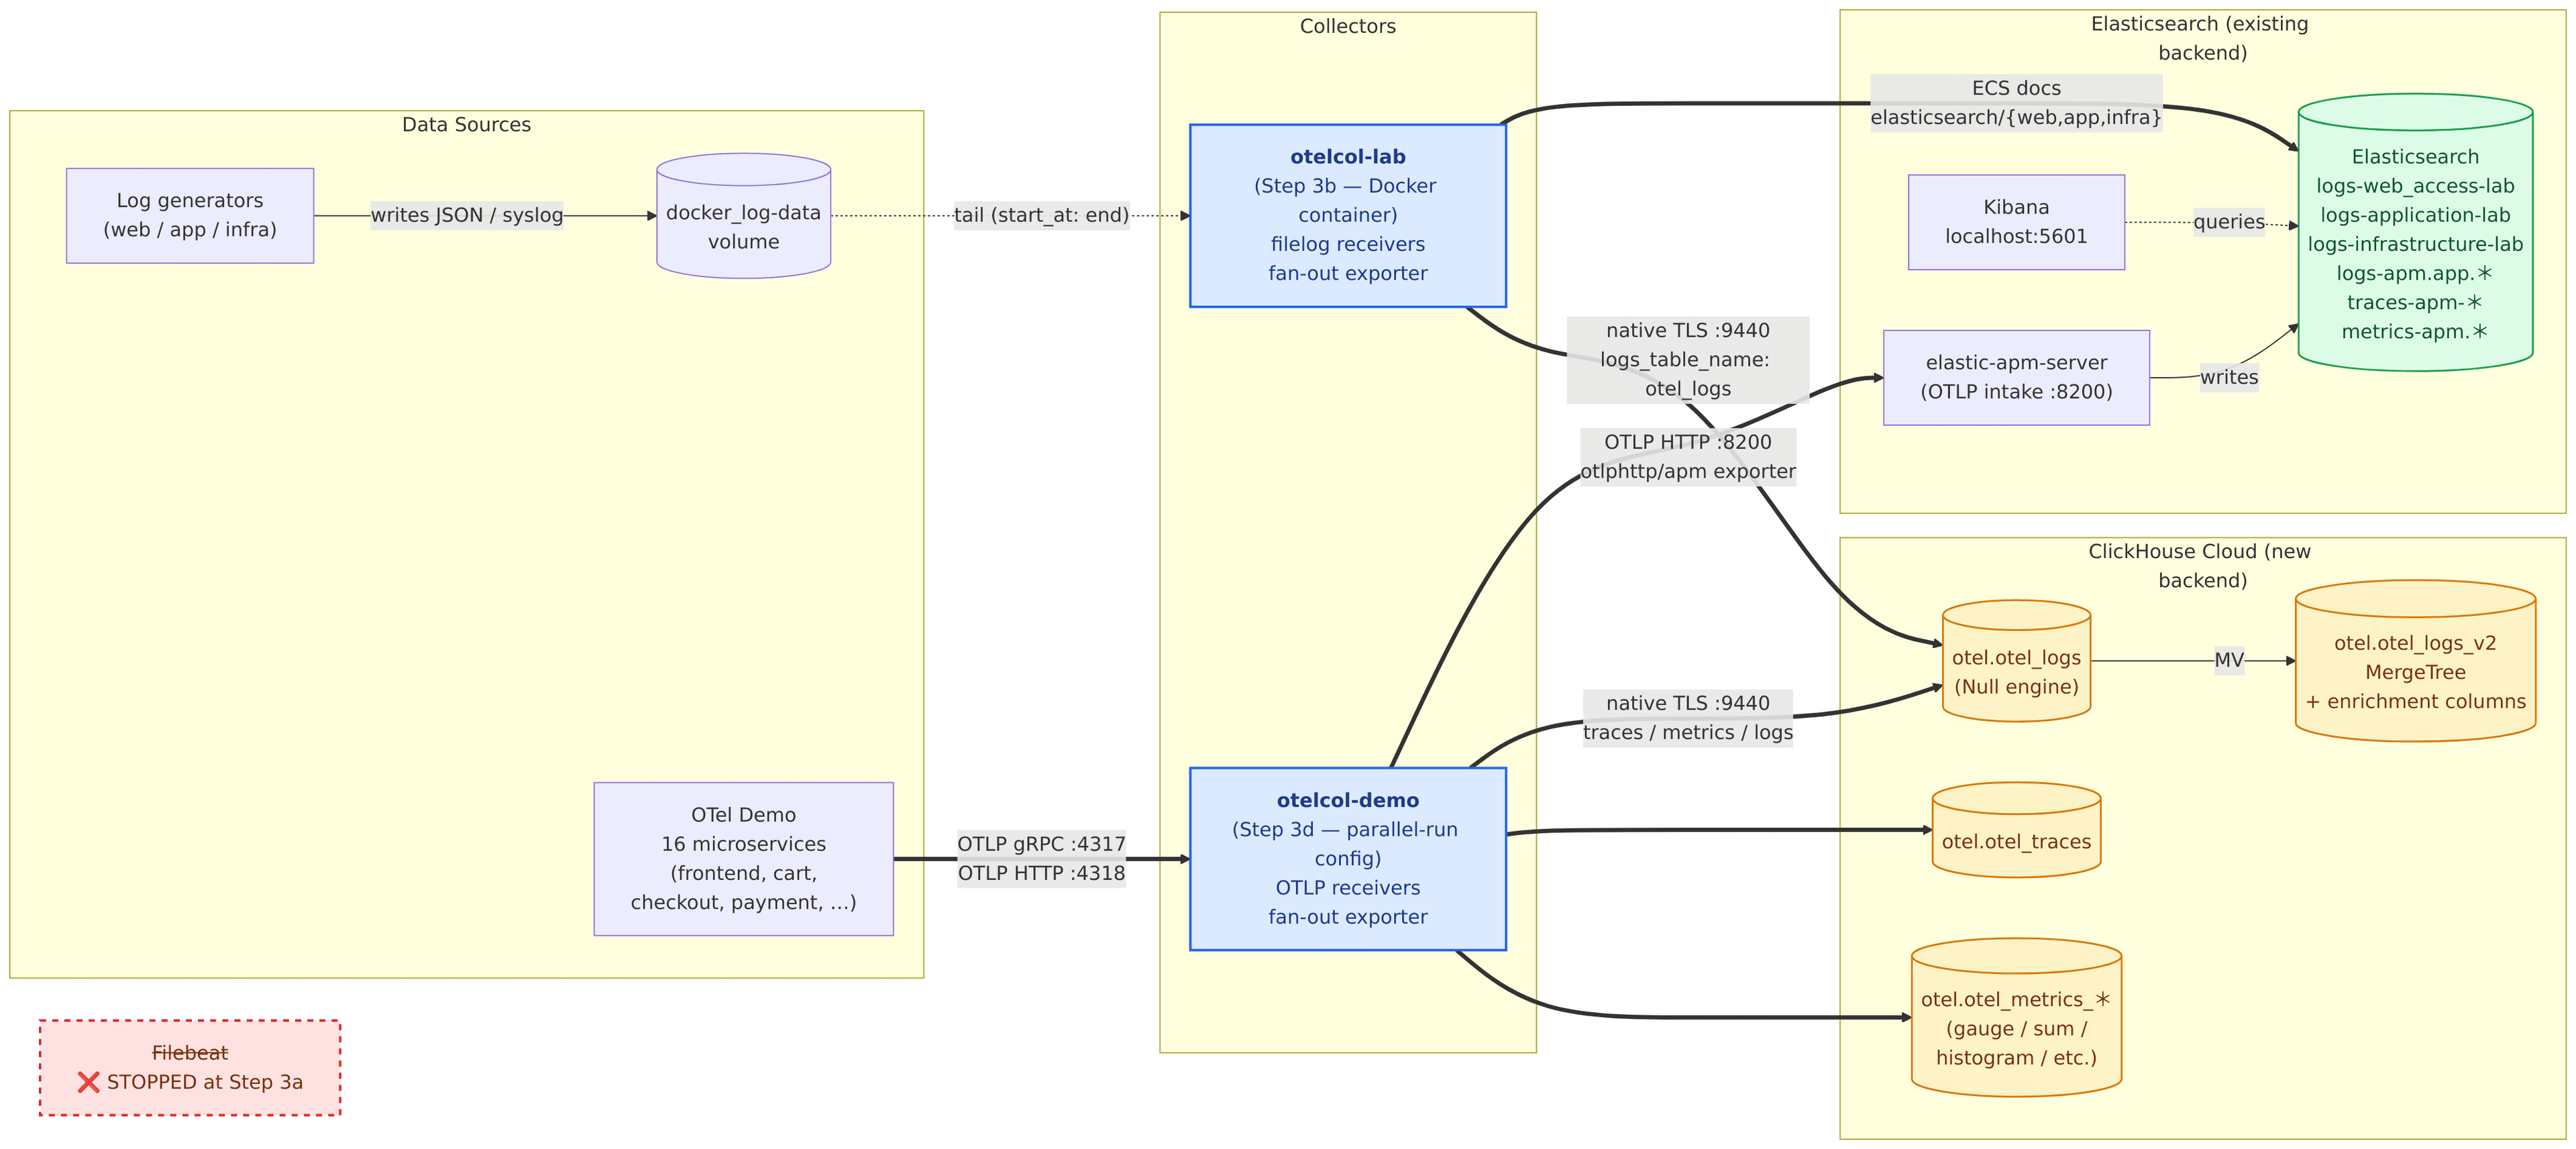
Ao final desta etapa, você terá passado da linha de base da Parte 1 (Filebeat → ES, otelcol-demo → somente APM) para uma execução paralela, na qual dois OTel Collectors distribuem todos os sinais para ambos os destinos: a stack Elasticsearch existente e o ClickHouse Cloud:
O que muda nesta etapa:
3a: parar o Filebeat (em vermelho, no canto inferior esquerdo do diagrama).
3b–3c: iniciar otelcol-lab (collector baseado em arquivos) — ele acompanha os mesmos arquivos de log que o Filebeat lia e faz gravação dupla no ES (logs-{web_access,application,infrastructure}-lab) e no ClickHouse (otel.otel_logs → MV → otel.otel_logs_v2).
3d: trocar a configuração de otelcol-demo pela versão de execução paralela, para que o tráfego OTLP dos 16 serviços do OTel Demo também seja distribuído aos dois backends (APM Server + ClickHouse).
Fonte do diagrama: diagrams/step3-architecture.mmd. Para renderizar novamente após alterações, execute bash diagrams/render.sh (usa minlag/mermaid-cli por meio do Docker; Node/npm não são necessários).
O OTel Collector que você está prestes a iniciar acompanha os mesmos arquivos de log que o Filebeat e grava nos mesmos fluxos de dados do ES (logs-web_access-lab, logs-application-lab, logs-infrastructure-lab), além de no ClickHouse. Se o Filebeat e o OTel Collector estiverem em execução, cada linha de log será indexada duas vezes no ES — literalmente o problema de "gravação dupla no mesmo destino".
Pare o Filebeat para que o OTel Collector se torne o único produtor desses fluxos de dados:
O Elasticsearch, Kibana, os geradores de logs e o APM Server permanecem em execução. Somente o Filebeat para. O OTel Collector assume os dois backends: ele envia cada linha de log ao ClickHouse (o novo backend) e ao Elasticsearch (os fluxos de dados existentes), mantendo as comparações de paridade significativas durante toda a execução paralela. Na transição (Etapa 10a), os exporters do ES são removidos da configuração.
Os arquivos de log ficam no volume nomeado do Docker docker_log-data. No macOS (e em qualquer ambiente em que os arquivos de log estejam em volumes do Docker), execute o collector como um contêiner Docker para que ele possa acessar o volume diretamente:
Observação sobre dial_timeout: Tanto otel-collector-config.parallel.yaml quanto otel-collector-config.cutover.yaml definem dial_timeout=60s no URI do endpoint do ClickHouse para que o handshake da inicialização a frio tenha tempo suficiente antes da primeira reinicialização. Em um CH auto-hospedado com inicialização imediata, você pode reduzir esse valor novamente para 10s.
Host Linux com acesso direto ao volume: Se você estiver usando Linux e tiver acesso direto aos arquivos de log no host (fora dos volumes do Docker), poderá usar o binário:
info Everything is ready. Begin running and processing data.info Started watching file path=/var/log/generators/web-access-api-gateway.log
Principais decisões de configuração em configs/otel-collector-config.parallel.yaml (collector de logs baseado em arquivos — variante de execução paralela):
Fan-out de gravação dupla: todos os pipelines listam [clickhouse, elasticsearch/<stream>], portanto cada linha de log é enviada aos dois backends durante a execução paralela. A Etapa 10a remove os exporters do ES na transição.
Um exporter do ES por fluxo de dados (elasticsearch/web → logs-web_access-lab, elasticsearch/app → logs-application-lab, elasticsearch/infra → logs-infrastructure-lab), para que cada pipeline grave no mesmo fluxo de dados em que o Filebeat gravava antes.
mapping.mode: ecs nos exporters do ES — converte registros no formato OTel (Body, Attributes, ...) em documentos no formato ECS compatíveis com os enviados pelo Filebeat, para que os modelos de componentes do fluxo de dados os aceitem.
create_schema: false no exporter do CH — já criamos nossas tabelas otimizadas; o exporter não deve criar seu esquema padrão.
logs_table_name: otel_logs — grava na tabela Null, que aciona a MV para otel_logs_v2.
compress=lz4 no endpoint do CH — compressão LZ4 durante a transmissão; o ClickHouse Cloud descompacta os dados ao recebê-los.
Observação: O collector do laboratório implantado acima trata apenas logs baseados em arquivos (web/aplicação/infraestrutura). Os 16 serviços do OTel Demo emitem OTLP para um segundo collector (otelcol-demo), provisionado na Parte 1, que atualmente encaminha tudo ao APM Server. A Etapa 3d abaixo muda para uma configuração de gravação dupla sem editar o arquivo de linha de base da Parte 1.
O contêiner otelcol-demo iniciado na Parte 1 encaminha traces/métricas/logs OTLP somente ao APM Server. Para executar em paralelo, mude para uma configuração da Parte 3 que distribui os dados ao APM e ao ClickHouse:
source ../common/env.sh # CH_HOST, CH_PASSWORD must be setbash scripts/swap-otelcol-demo-config.sh parallel
Isso recria o contêiner usando docker compose -f ... -f docker/docker-compose.otel-demo.parallel.yml up -d --force-recreate --no-deps otelcol-demo. O arquivo de configuração da Parte 1 não é modificado — a substituição monta uma configuração da Parte 3 em outro caminho do contêiner e substitui command: para carregá-la.
Verifique se ele iniciou sem erros:
docker logs "$(docker ps -qf name=otelcol-demo)" --tail=10# Expected: "Everything is ready. Begin running and processing data."# No "Failed to start component" or "connection refused" errors.
Por que trocar em vez de editar o arquivo da Parte 1 diretamente? Editar part1/docker/configs/otelcol-demo-config.yml alteraria a linha de base; assim, um futuro cleanup.sh && start from Part 1 levaria a uma configuração que já exige CH_HOST/CH_PASSWORD. O padrão de troca mantém a Parte 1 autocontida e reproduzível.
O HyperDX é a interface de observabilidade integrada do ClickStack — incluída em todos os serviços do ClickHouse Cloud. Nesta etapa, você iniciará o HyperDX, conectará a interface ao banco de dados otel e confirmará que logs/traces/métricas podem ser consultados pela interface.
→ Siga o guia passo a passo com capturas de tela: hyperdx-guide.md
O guia aborda:
A. Iniciar o ClickStack
Abrir o HyperDX na barra lateral do console do Cloud
B. Criar três fontes de dados
Conectar o HyperDX a otel.otel_traces, otel.otel_logs_v2 e às cinco tabelas otel.otel_metrics_*
C. Pesquisar logs em tempo real
Confirmar que os dados estão fluindo e usar facetas e pesquisa de texto completo
D. Criar um gráfico com o AI Assistant
Traduzir linguagem natural ("Contagem de erros por serviço nas últimas 2 horas") em um gráfico funcional
Ponto de ensino: O Service Map, a pesquisa de texto completo e o AI Assistant do HyperDX são executados diretamente nas tabelas MergeTree otel.* — sem índice separado, rollups ou resharding. Os mesmos casos de uso operacionais abordados nos dashboards do Kibana da Parte 1 estão disponíveis aqui, mas as consultas subjacentes também podem ser escritas ad hoc como SQL (consulte os exercícios de SQL da Etapa 9) — algo que o Kibana nunca ofereceu.
O TTL já está configurado no DDL schema.sql. Verifique se ele está presente:
SELECT name, extractAll(create_table_query, 'TTL[^\\n]+') AS ttl_clausesFROM system.tablesWHERE database = 'otel' AND name IN ('otel_logs_v2', 'otel_traces', 'otel_metrics_gauge', 'otel_metrics_sum', 'otel_metrics_histogram', 'otel_metrics_exponentialhistogram', 'otel_metrics_summary');
Verifique os tamanhos e as idades das partições:
SELECT partition, sum(rows) AS total_rows, formatReadableSize(sum(bytes_on_disk)) AS disk_size, min(min_time) AS oldest_data, max(max_time) AS newest_dataFROM system.partsWHERE database = 'otel' AND table = 'otel_logs_v2' AND activeGROUP BY partitionORDER BY partition;
Ponto de ensino: por que o ILM se torna uma linha de DDL
Na Parte 1, você configurou uma política de ILM de 3 fases: rollover em 5 GB/1 dia (hot), shrink + forcemerge em 2 dias (warm) e exclusão em 30 dias. Isso exigiu funções de nós hot/warm, conhecimento da alocação de shards e JSON da política de ILM.
No ClickHouse Cloud, todo esse mecanismo se resume a uma cláusula em CREATE TABLE:
TTL TimestampDate + INTERVAL 30 DAY DELETESETTINGS ttl_only_drop_parts = 1
Rollover: desnecessário. O ClickHouse usa uma única tabela com partições baseadas em data.
Fase warm (shrink + forcemerge): desnecessária. O mecanismo MergeTree mescla as partes automaticamente.
Camadas hot/warm/cold: desnecessárias. O ClickHouse Cloud armazena todos os dados em armazenamento de objetos com cache automático. Não há funções de nós.
Fase de exclusão: reproduzida exatamente por TTL ... DELETE. ttl_only_drop_parts = 1 descarta partições inteiras (o limite da partição é um dia) — muito mais eficiente do que excluir linha por linha.
A tabela logs_summary_1min (criada na Etapa 2c) é uma AggregatingMergeTree que armazena estados parciais de agregação. Consulte-a com combinadores -Merge:
SELECT minute, ServiceName, SeverityText, countMerge(count) AS total_events, avgMerge(avg_run_time) AS avg_run_time_ms, quantileMerge(0.99)(p99_run_time) AS p99_run_time_ms, uniqMerge(uniq_remote_addr) AS unique_ipsFROM logs_summary_1minWHERE minute >= now() - INTERVAL 1 HOURGROUP BY minute, ServiceName, SeverityTextORDER BY minute DESC;
Ponto de ensino: padrão de combinadores State/Merge
A tabela de resumo armazena estados parciais de agregação, não valores finais. countState() armazena uma contagem parcial serializada; avgState() armazena a soma + a contagem necessárias para calcular uma média. Ao consultar com countMerge(), o ClickHouse combina os estados parciais e calcula o valor final.
Esta é a principal diferença em relação às transformações do Elasticsearch: as transformações do ES reagregam os dados brutos periodicamente. O AggregatingMergeTree do ClickHouse acumula novos dados de forma incremental, sem reler registros históricos — fundamentalmente mais eficiente em escala.
O HyperDX tem uma visualização integrada de Alerts (na barra lateral esquerda, entre Chart Explorer e Client Sessions). Os alertas são associados a pesquisas salvas ou blocos de gráficos: você define uma consulta, um limite, uma janela de avaliação e um canal de notificação. Como as fontes de dados configuradas na Etapa 5 já apontam para o banco de dados otel, nenhuma integração adicional é necessária.
Para conhecer o fluxo exato da interface, siga a documentação oficial:Alertas do ClickStack — clickhouse.com/docs. Use a tabela abaixo para os dois alertas exigidos neste laboratório; a documentação orienta o fluxo Save Search → Create Alert → Configure threshold → Notify de cada um.
#
Nome do alerta
Fonte do HyperDX
Critérios de pesquisa (cole na barra Search antes de salvar)
Condição do alerta
Janela
Regra do Kibana substituída
1
web-5xx-errors
log
RequestType:* AND StatusCode:>=500
count() > 0 (absoluto) — dispara para qualquer 5xx na janela. Como alternativa, para um limite de taxa, crie um gráfico cujo eixo Y seja countIf(StatusCode >= 500) / count() e dispare o alerta quando value > 0.05.
5 minutos, avaliado a cada 1 minuto
"Taxa de 5xx > 5% em 5 minutos"
2
heartbeat-<service>
log
ServiceName:"<service-name>" (uma pesquisa salva por serviço relevante, por exemplo, payment-service, order-service)
count() == 0 — dispara quando a pesquisa salva retorna zero linhas na janela
3 minutos, avaliado a cada 1 minuto
"O serviço ficou silencioso por mais de 3 minutos"
Atenção ao alerta nº 2: Os alertas de pesquisas salvas do HyperDX avaliam uma consulta; portanto, detectar o silêncio por serviço exige uma pesquisa salva + um alerta para cada serviço. Para mais de cerca de 5 serviços, a Opção B abaixo (padrão SQL NOT IN em uma única MV) é mais adequada.
A tabela alert_error_rate e a alert_error_rate_mv (criadas na Etapa 2c) pré-calculam a taxa de 5xx no momento da inserção. Um poller externo verifica a pequena tabela pré-agregada em vez de examinar milhões de linhas brutas:
-- Poll this every 1 minute (via cron or any scheduler)SELECT minute, error_rateFROM alert_error_rateWHERE minute >= now() - INTERVAL 5 MINUTE AND error_rate > 0.05ORDER BY minute DESC;
Se esta consulta retornar alguma linha, o alerta será disparado.
Ponto de ensino: Os alertas do Elasticsearch reagregam os dados brutos em todos os intervalos de verificação. A abordagem baseada em MV transfere a agregação dispendiosa para o momento da inserção — a consulta de polling do alerta examina uma pequena tabela com cerca de 1 linha/minuto, não milhões de linhas de logs brutos.
O laboratório inclui o arquivo dedicado configs/otel-collector-config.cutover.yaml, que remove os três exporters do ES e deixa o ClickHouse como único destino. Recrie o contêiner otelcol-lab com esse arquivo montado no lugar da versão de execução paralela — não é necessário editar nada diretamente:
Todas as verificações do ClickHouse ainda devem passar. As verificações de contagem do ES falharão (como esperado — o ES não recebe mais dados); portanto, confirme se as contagens do ClickHouse continuam crescendo.
Depois que a Etapa 10d para elastic-apm-server, o exporter de APM do collector do OTel Demo começa a registrar erros de fila cheia e aplica contrapressão a todo o pipeline — inclusive ao exporter do ClickHouse distribuído ao lado dele. Mude para uma configuração de transição sem exporter de APM:
Isso monta configs/otelcol-demo-config.cutover.yml (somente ClickHouse) e recria o contêiner. O arquivo de linha de base da Parte 1 permanece intacto, portanto um novo cleanup.sh && start from Part 1 sempre resulta em um estado limpo e exclusivo de APM.
Verifique se as métricas estão fluindo para o ClickHouse:
SELECT table, count() AS rowsFROM system.partsWHERE database = 'otel' AND table LIKE 'otel_metrics%' AND activeGROUP BY table ORDER BY table;
Esperado: otel_metrics_gauge, otel_metrics_sum e otel_metrics_histogram, todos exibindo linhas.
Verifique se CH_HOST está definido e acessível: nc -zv ${CH_HOST} 9440
Verifique create_schema: false — se o exporter tentar criar seu esquema padrão, ele poderá entrar em conflito com o nosso
Verifique se a configuração do collector tem database: otel e se o banco de dados otel realmente existe: SHOW DATABASES
Verifique se a tabela otel_logs existe no banco de dados otel: SHOW TABLES FROM otel LIKE 'otel_logs'
O OTel Collector é encerrado com schema detection: ... i/o timeout (inicialização a frio do CH Cloud):
Isso significa que a sondagem de detecção de esquema realizada na inicialização do ClickHouse Cloud demorou mais do que dial_timeout. É mais comum em serviços CH da camada Basic que ficaram ociosos.
Reinicie o contêiner — agora o CH está aquecido: docker start otelcol-lab && sleep 10 && docker logs otelcol-lab --tail=15
O docker run da Etapa 3b inclui --restart unless-stopped, portanto a recuperação é automática. Se você iniciou sem essa opção, recrie o contêiner.
Pré-aqueça o CH antes da próxima inicialização: clickhouse client --host "$CH_HOST" --port 9440 --user default --password "$CH_PASSWORD" --secure --query "SELECT 1"
GeoCountry está vazio em todas as linhas:
Verifique se o dicionário foi carregado: SELECT status FROM system.dictionaries WHERE database = 'otel' AND name = 'geoip_country'
Se estiver NOT_LOADED ou FAILED, verifique se geoip_data contém linhas: SELECT count() FROM otel.geoip_data
Execute SYSTEM RELOAD DICTIONARY otel.geoip_country e SYSTEM RELOAD DICTIONARY otel.geoip_city após carregar o CSV — os dicionários são criados antes do carregamento do CSV, portanto começam vazios e precisam de uma recarga explícita (a Etapa 2b faz isso por você)
As contagens de linhas no CH são muito menores do que no ES:
Verifique se o contêiner do OTel Collector está em execução: docker ps | grep otelcol
Consulte os logs do collector em busca de erros: docker logs otelcol-lab --tail=30
Verifique as métricas do Collector: curl http://localhost:8888/metrics | grep otelcol_exporter
Procure erros de inserção nos logs do Collector (busque failed to send)
logs_summary_1min está vazia:
A MV é acionada por inserções em otel.otel_logs (a tabela Null), não em otel.otel_logs_v2
Verifique se os dados estão fluindo por otel.otel_logs: em um novo terminal, execute clickhouse client --database otel --query "SELECT count() FROM otel_logs_v2" a cada 30 segundos e confirme se a contagem aumenta
A Search do HyperDX não mostra dados:
Confirme se cada fonte de dados do HyperDX tem Database = otel e aponta para a tabela correta (otel_logs_v2 para logs, otel_traces para traces e as cinco tabelas otel_metrics_* para OTEL Metrics)
Para a fonte de logs, Timestamp Column deve ser TimestampTime (não Timestamp) — consulte hyperdx-guide.md para entender o motivo
Verifique o seletor de intervalo de tempo — tente "Last 24 hours"
Verifique se otel_logs_v2 contém linhas: clickhouse client --database otel --query "SELECT count() FROM otel_logs_v2"