Provisionnez ClickHouse Cloud, mettez en place la double écriture avec OpenTelemetry, validez l'équivalence, explorez ClickStack et effectuez la bascule.
Exécutez ce module depuis le répertoire des ressources de l'atelier :
cd "$(git rev-parse --show-toplevel)/workshops/elasticsearch_migration_lab/part3"
Objectif : exécuter le plan de migration élaboré dans la partie 2. Déployez un OTel Collector, créez des tables ClickHouse optimisées, configurez l'enrichissement avec des dictionnaires, validez l'équivalence avec l'environnement Elasticsearch actif, puis effectuez la bascule.
Durée estimée : 120 à 180 minutes
Prérequis : les parties 1 et 2 sont terminées ; l'environnement Docker de la partie 1 est actif (Elasticsearch, Kibana, générateurs de journaux et APM Server). Vous disposez des identifiants de votre compte ClickHouse Cloud.
Fichiers :
part3/├── exercises/│ ├── setup-checklist.md ← Fill in as you work through each step│ └── sql-exercises.md ← 6 SQL exercises (attempt before checking solutions)├── clickhouse/│ ├── schema.sql ← All DDL (run first)│ ├── dictionaries.sql ← GeoIP dictionary DDL│ ├── geoip-sample-data.csv ← ~400 CIDR rows (no MaxMind account needed)│ ├── alert-tables.sql ← Alert pre-computation + summary MVs│ └── validation-queries.sql ← Spot-checks and parity queries├── configs/│ ├── otel-collector-config.parallel.yaml ← File-based log collector — parallel run (CH + ES dual-write)│ ├── otel-collector-config.cutover.yaml ← File-based log collector — cutover (CH only)│ ├── otelcol-demo-config.parallel.yml ← OTel Demo collector — parallel run (APM + CH)│ └── otelcol-demo-config.cutover.yml ← OTel Demo collector — cutover (CH only)├── docker/│ ├── docker-compose.otel-demo.parallel.yml ← Compose override for parallel-run swap│ └── docker-compose.otel-demo.cutover.yml ← Compose override for cutover swap├── diagrams/│ ├── step3-architecture.mmd ← Mermaid source — post-Step-3 architecture│ ├── step3-architecture.png ← Rendered PNG embedded in Step 3│ └── render.sh ← Re-render *.mmd → *.png via Docker (mermaid-cli)├── images/│ └── *.png ← Screenshots referenced by hyperdx-guide.md└── scripts/ ├── swap-otelcol-demo-config.sh ← Swap otelcol-demo config (parallel|cutover) ├── validate_migration.sh ← Automated parity check └── validate_enrichment.sh ← Enrichment column verification
Remarque sur l'architecture de ClickHouse Cloud : contrairement à Elasticsearch, ClickHouse Cloud stocke toutes les données sur un stockage objet (S3/GCS), assorti d'un cache local automatique. Il n'existe pas de niveaux de nœuds chaud/tiède/froid : le moteur de requête récupère et met en cache les données de façon transparente. L'ensemble du mécanisme Elasticsearch ILM chaud→tiède→froid n'a donc pas d'équivalent dans ClickHouse Cloud. Seule la suppression fondée sur le TTL est nécessaire ; vous la configurerez à l'étape 2.
Définissez les variables d'environnement pour la suite de l'atelier :
# Copy and fill in once, then source before every sessioncp ../common/env.sh.example ../common/env.sh# edit ../common/env.sh with your CH_HOST and CH_PASSWORD (from Cloud console → Connect → Native protocol)source ../common/env.sh
Base de données : tous les objets de la partie 3 (tables, dictionnaires et vues matérialisées) résident dans une base de données dédiée, otel, créée automatiquement par dictionaries.sql et schema.sql au moyen de CREATE DATABASE IF NOT EXISTS otel. Les tables de l'atelier restent ainsi isolées de tout autre élément de votre service. Chaque configuration de collecteur, script de validation et source HyperDX de cette partie est préconfiguré pour pointer vers otel.
Ordre d'exécution : les dictionnaires GeoIP (étape 2a) doivent être créés avant les tables cibles (étape 2b), car otel_logs_v2 comporte des colonnes MATERIALIZED qui référencent otel.geoip_country et otel.geoip_city. ClickHouse valide les références aux dictionnaires lors de CREATE TABLE.
# 1. Create the otel database, geoip_data source table, and empty dictionaries# (the table must exist before you can INSERT into it)clickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ < clickhouse/dictionaries.sql# 2. Load sample data into the source table (note: --database otel)clickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --database otel \ --query "INSERT INTO geoip_data FORMAT CSVWithNames" \ < clickhouse/geoip-sample-data.csv# 3. Reload dictionaries — they were created with an empty table; force reload nowclickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --query "SYSTEM RELOAD DICTIONARY otel.geoip_country"clickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --query "SYSTEM RELOAD DICTIONARY otel.geoip_city"# 4. Verifyclickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --query "SELECT dictGet('otel.geoip_country', 'country', toIPv4('8.8.8.8'))"# Expected: United States
Point pédagogique : dans Elasticsearch, le processeur geoip est une boîte noire intégrée : il suffit de l'activer. Dans ClickHouse, un dictionnaire adossé aux mêmes données MaxMind vous donne la maîtrise de la source des données, de l'intervalle de rafraîchissement et du comportement de recherche. La disposition IP_TRIE est conçue pour les recherches de plages CIDR : dictGet() effectue en quelques microsecondes une correspondance selon le préfixe le plus long dans la table des plages d'adresses IP.
Cible d'ingestion de l'OTel Collector ; ne stocke rien
otel_logs_v2
MergeTree
Stockage effectif des données, avec les colonnes d'enrichissement
otel_logs_mv
Vue matérialisée
Achemine otel_logs → otel_logs_v2 en appliquant les transformations
otel_traces
MergeTree
Spans de traces OTel
otel_metrics_gauge
MergeTree
Métriques de jauge OTel (remplace APM Server en tant que système cible des métriques)
otel_metrics_sum
MergeTree
Métriques OTel de somme/compteur
otel_metrics_histogram
MergeTree
Métriques d'histogramme OTel
otel_metrics_exponentialhistogram
MergeTree
Métriques d'histogramme exponentiel OTel
otel_metrics_summary
MergeTree
Métriques de synthèse OTel
Pourquoi le motif Null → MV → cible ?
Le moteur Null accepte les insertions, mais élimine immédiatement les données. La MV associée se déclenche à chaque insertion et écrit les lignes transformées dans otel_logs_v2. Les données ne sont donc pas stockées deux fois : l'OTel Collector écrit le schéma OTel brut dans otel_logs, et seules les lignes enrichies et optimisées arrivent dans otel_logs_v2.
Les colonnes matérialisées remplacent tous les processeurs des pipelines d'ingestion ES :
Processeur ES
Équivalent ClickHouse
geoip
GeoCountry, GeoCity MATERIALIZED avec dictGetOrDefault('otel.geoip_country', ...)
user_agent
BrowserFamily, OSFamily, IsBot MATERIALIZED avec regexpExtract / position
script (dérivation de la gravité)
DerivedSeverity MATERIALIZED avec multiIf(StatusCode >= 500, 'critical', ...)
grok/dissect (extraction de champs)
RequestType, RequestPath, RequestPage, HostName MATERIALIZED depuis LogAttributes['key']
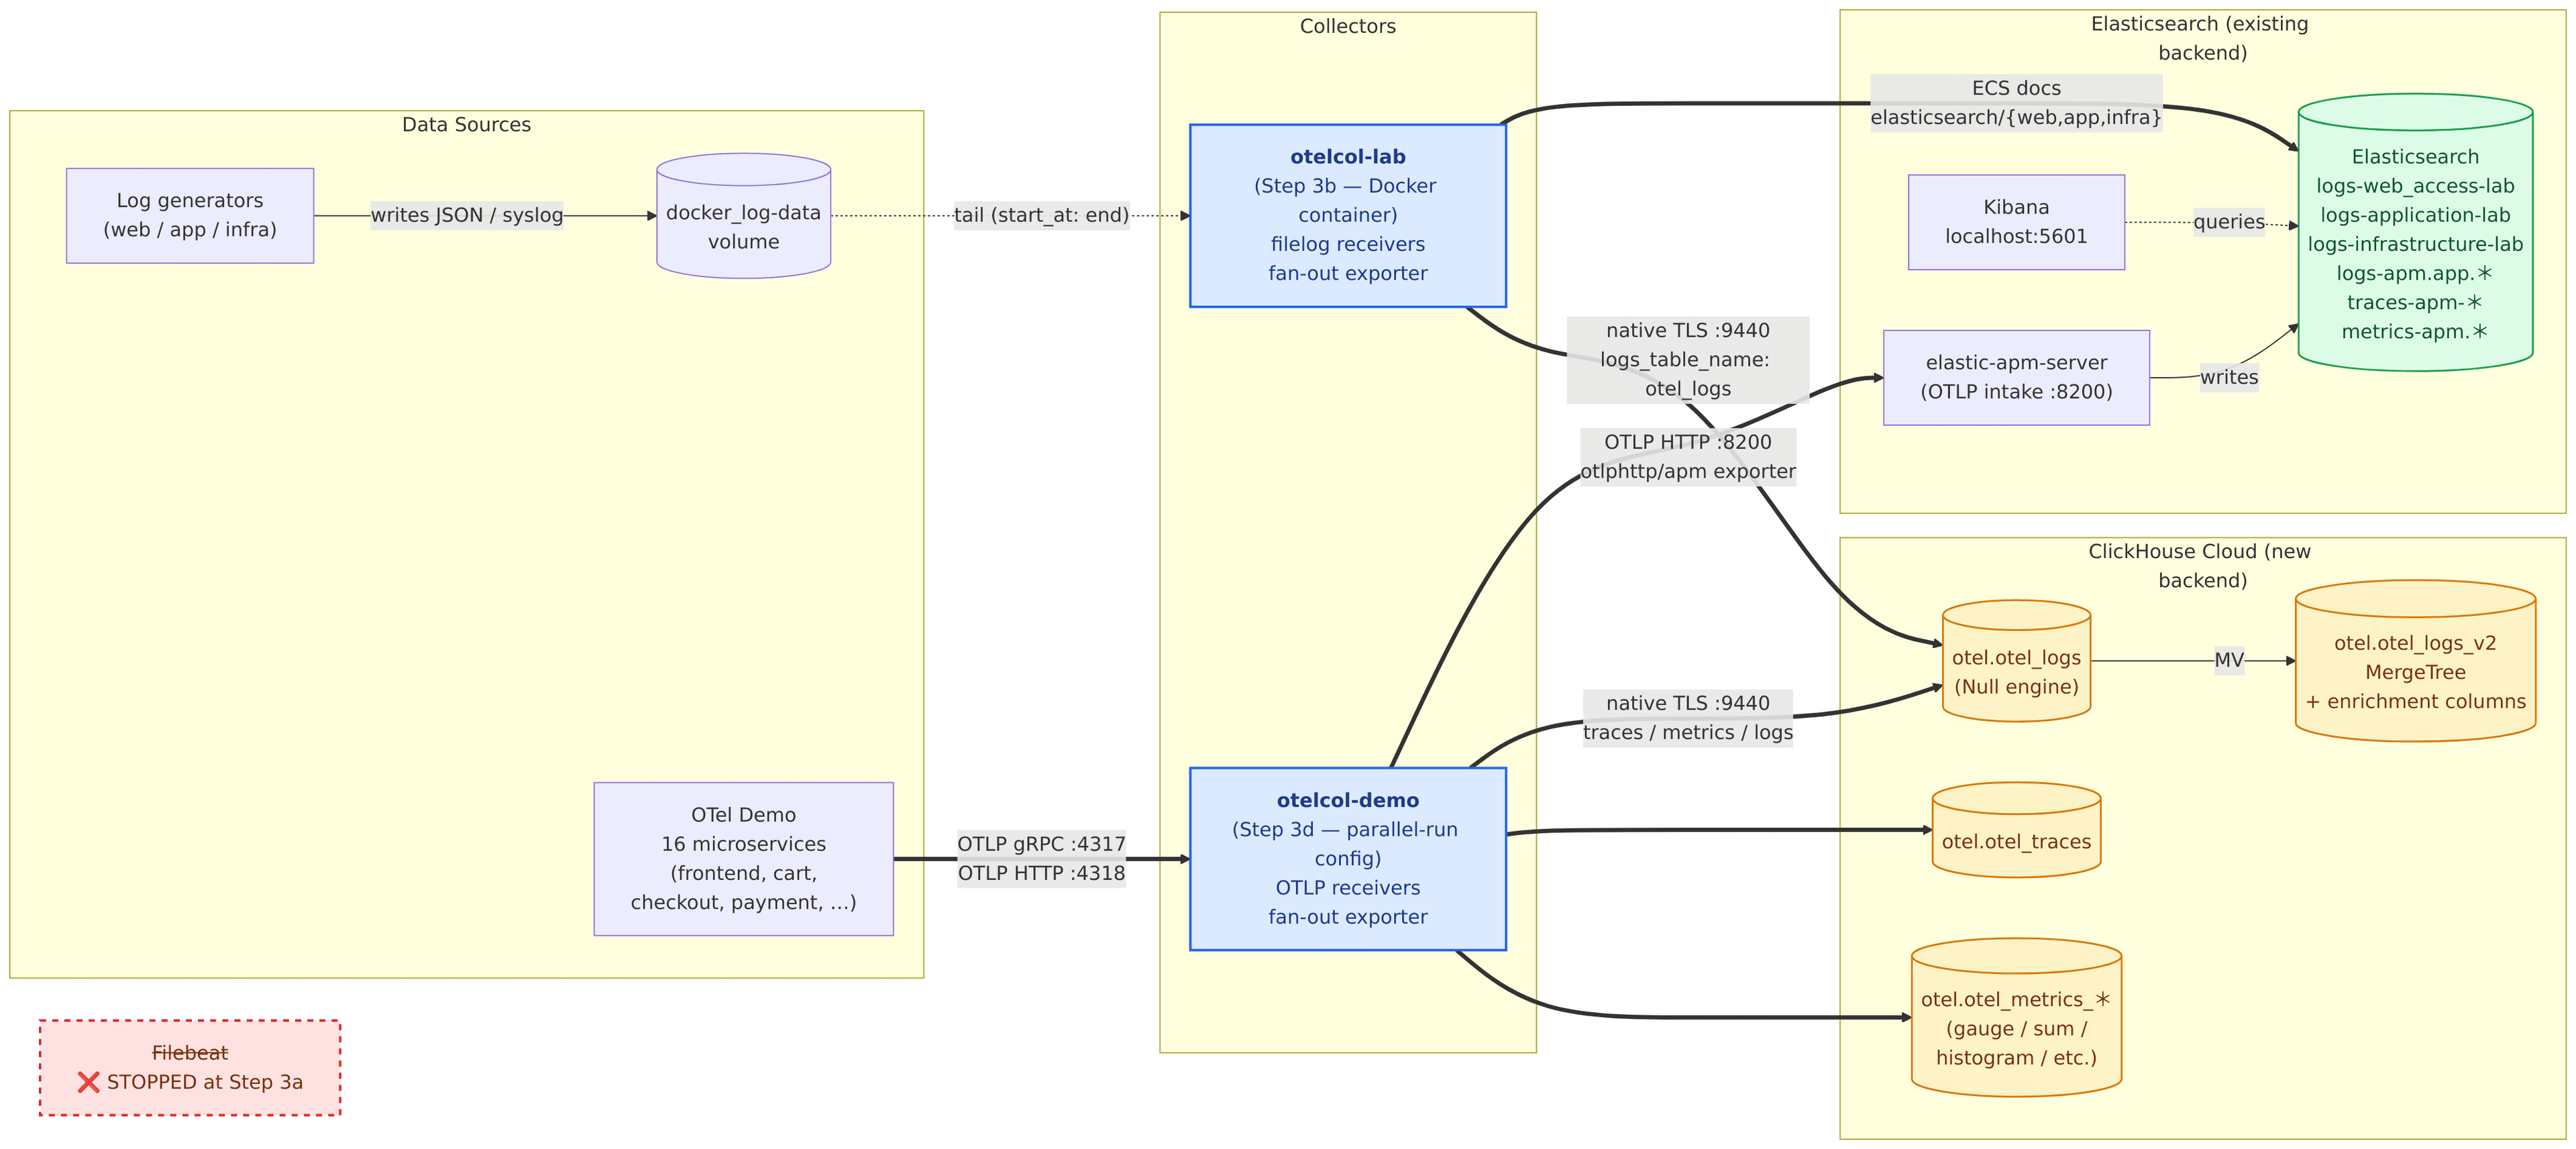
À la fin de cette étape, vous serez passé de l'état de référence de la partie 1 (Filebeat → ES, otelcol-demo → APM uniquement) à une exécution parallèle dans laquelle deux OTel Collectors distribuent chaque signal à la fois vers l'environnement Elasticsearch existant et vers ClickHouse Cloud :
Modifications apportées pendant cette étape :
3a : arrêt de Filebeat (en rouge, en bas à gauche du schéma).
3b–3c : démarrage de otelcol-lab (collecteur de fichiers) — il suit les mêmes fichiers de journaux que Filebeat et les écrit à la fois dans ES (logs-{web_access,application,infrastructure}-lab) et ClickHouse (otel.otel_logs → MV → otel.otel_logs_v2).
3d : remplacement de la configuration de otelcol-demo par celle de l'exécution parallèle, de sorte que le trafic OTLP des 16 services OTel Demo soit également distribué aux deux systèmes cibles (APM Server + ClickHouse).
Source du schéma : diagrams/step3-architecture.mmd. Pour générer à nouveau l'image après une modification, exécutez bash diagrams/render.sh (utilise minlag/mermaid-cli avec Docker ; Node/npm n'est pas nécessaire).
L'OTel Collector que vous allez démarrer suit les mêmes fichiers de journaux que Filebeat et écrit dans les mêmes flux de données ES (logs-web_access-lab, logs-application-lab, logs-infrastructure-lab), ainsi que dans ClickHouse. Si Filebeat et l'OTel Collector fonctionnent en même temps, chaque ligne de journal est indexée deux fois dans ES : c'est littéralement une « double écriture vers la même destination ».
Arrêtez Filebeat afin que l'OTel Collector devienne l'unique producteur de ces flux de données :
Elasticsearch, Kibana, les générateurs de journaux et APM Server restent actifs. Seul Filebeat s'arrête. L'OTel Collector prend en charge les deux systèmes cibles : il expédie chaque ligne de journal vers ClickHouse (le nouveau système) et vers Elasticsearch (les flux de données existants), de sorte que les comparaisons d'équivalence restent valables pendant toute l'exécution parallèle. Lors de la bascule (étape 10a), les exportateurs ES sont retirés de la configuration.
Les fichiers de journaux résident dans le volume Docker nommé docker_log-data. Sous macOS (et dans tout environnement où les fichiers de journaux se trouvent dans des volumes Docker), exécutez le collecteur dans un conteneur Docker afin qu'il puisse accéder directement à ce volume :
Remarque concernant dial_timeout :otel-collector-config.parallel.yaml et otel-collector-config.cutover.yaml définissent tous deux dial_timeout=60s dans l'URI du point de terminaison ClickHouse. Le démarrage à froid dispose ainsi d'un délai suffisant pour établir la connexion avant le premier redémarrage. Sur une installation CH auto-hébergée dont le démarrage est instantané, vous pouvez ramener cette valeur à 10s.
Hôte Linux avec accès direct au volume : si vous travaillez sous Linux et accédez directement aux fichiers de journaux sur l'hôte (et non dans des volumes Docker), vous pouvez utiliser le binaire à la place :
info Everything is ready. Begin running and processing data.info Started watching file path=/var/log/generators/web-access-api-gateway.log
Décisions essentielles de configs/otel-collector-config.parallel.yaml (collecteur de journaux sur fichiers — variante d'exécution parallèle) :
Distribution en double écriture : chaque pipeline répertorie [clickhouse, elasticsearch/<stream>], de sorte que chaque ligne de journal est expédiée vers les deux systèmes cibles pendant l'exécution parallèle. L'étape 10a retire les exportateurs ES lors de la bascule.
Un exportateur ES par flux de données (elasticsearch/web → logs-web_access-lab, elasticsearch/app → logs-application-lab, elasticsearch/infra → logs-infrastructure-lab) afin que chaque pipeline écrive dans le flux de données qu'utilisait auparavant Filebeat.
mapping.mode: ecs sur les exportateurs ES — convertit les enregistrements au format OTel (Body, Attributes, etc.) en documents structurés selon ECS, semblables à ceux qu'envoyait Filebeat, afin qu'ils soient acceptés par les modèles de composants du flux de données.
create_schema: false sur l'exportateur CH — nous avons déjà créé nos propres tables optimisées ; ne laissez pas l'exportateur créer son schéma par défaut.
logs_table_name: otel_logs — écrit dans la table Null, qui déclenche la MV vers otel_logs_v2.
compress=lz4 dans le point de terminaison CH — compression LZ4 sur le réseau ; ClickHouse Cloud décompresse les données à la réception.
Remarque : le collecteur de l'atelier déployé ci-dessus ne traite que les journaux issus des fichiers (web/application/infrastructure). Les 16 services OTel Demo émettent leurs données OTLP vers un deuxième collecteur (otelcol-demo), provisionné dans la partie 1 et qui transmet actuellement tout à APM Server. L'étape 3d ci-dessous remplace sa configuration par une configuration à double écriture, sans modifier le fichier de référence de la partie 1.
Le conteneur otelcol-demo démarré dans la partie 1 transmet uniquement les traces, métriques et journaux OTLP à APM Server. Pour l'exécuter en parallèle, adoptez une configuration de la partie 3 qui distribue les données à la fois à APM et à ClickHouse :
source ../common/env.sh # CH_HOST, CH_PASSWORD must be setbash scripts/swap-otelcol-demo-config.sh parallel
Cette commande recrée le conteneur avec docker compose -f ... -f docker/docker-compose.otel-demo.parallel.yml up -d --force-recreate --no-deps otelcol-demo. Le fichier de configuration de la partie 1 n'est pas modifié : la surcharge monte une configuration de la partie 3 dans un autre chemin du conteneur et remplace command: pour la charger.
Vérifiez que son démarrage s'est effectué sans erreur :
docker logs "$(docker ps -qf name=otelcol-demo)" --tail=10# Expected: "Everything is ready. Begin running and processing data."# No "Failed to start component" or "connection refused" errors.
Pourquoi remplacer la configuration au lieu de modifier directement le fichier de la partie 1 ? La modification directe de part1/docker/configs/otelcol-demo-config.yml altérerait l'état de référence : à l'avenir, un cleanup.sh && start from Part 1 aboutirait à une configuration qui nécessite déjà CH_HOST/CH_PASSWORD. Ce mécanisme de remplacement préserve l'autonomie et la reproductibilité de la partie 1.
HyperDX est l'interface d'observabilité intégrée à ClickStack, fournie avec chaque service ClickHouse Cloud. Dans cette étape, vous allez lancer HyperDX, le relier à la base de données otel et confirmer que les journaux, les traces et les métriques peuvent être interrogés dans l'interface.
Ouvrir HyperDX depuis la barre latérale de la console Cloud
B. Créer trois sources de données
Relier HyperDX à otel.otel_traces, otel.otel_logs_v2 et aux cinq tables otel.otel_metrics_*
C. Rechercher les journaux en temps réel
Confirmer l'arrivée des données, utiliser les facettes et la recherche plein texte
D. Construire un graphique avec l'assistant IA
Convertir une demande en langage naturel (« Error count by services for past 2 hours ») en graphique opérationnel
Point pédagogique : la carte des services, la recherche plein texte et l'assistant IA d'HyperDX interrogent directement les tables MergeTree otel.* : aucun index, aucune agrégation ni aucun repartitionnement distinct n'est nécessaire. Les mêmes cas d'usage opérationnels que ceux des tableaux de bord Kibana de la partie 1 sont disponibles ici, mais les requêtes sous-jacentes peuvent également être écrites à la volée en SQL (voir les exercices SQL de l'étape 9), ce que Kibana n'a jamais proposé.
Le TTL est déjà configuré dans le DDL de schema.sql. Vérifiez sa présence :
SELECT name, extractAll(create_table_query, 'TTL[^\\n]+') AS ttl_clausesFROM system.tablesWHERE database = 'otel' AND name IN ('otel_logs_v2', 'otel_traces', 'otel_metrics_gauge', 'otel_metrics_sum', 'otel_metrics_histogram', 'otel_metrics_exponentialhistogram', 'otel_metrics_summary');
Vérifiez la taille et l'âge des partitions :
SELECT partition, sum(rows) AS total_rows, formatReadableSize(sum(bytes_on_disk)) AS disk_size, min(min_time) AS oldest_data, max(max_time) AS newest_dataFROM system.partsWHERE database = 'otel' AND table = 'otel_logs_v2' AND activeGROUP BY partitionORDER BY partition;
Point pédagogique : pourquoi ILM se réduit à une ligne de DDL
Dans la partie 1, vous avez configuré une politique ILM en 3 phases : roulement à 5 Go/1 j (chaud), réduction + fusion forcée à 2 j (tiède), puis suppression à 30 j. Cela nécessitait des rôles de nœuds chaud/tiède, la prise en compte de l'allocation des shards et une politique ILM au format JSON.
Dans ClickHouse Cloud, tout ce mécanisme se résume à une clause de CREATE TABLE :
TTL TimestampDate + INTERVAL 30 DAY DELETESETTINGS ttl_only_drop_parts = 1
Roulement : inutile. ClickHouse utilise une seule table avec des partitions fondées sur la date.
Phase tiède (réduction + fusion forcée) : inutile. Le moteur MergeTree fusionne automatiquement les parties.
Niveaux chaud/tiède/froid : inutiles. ClickHouse Cloud stocke toutes les données sur un stockage objet avec une mise en cache automatique. Il n'existe aucun rôle de nœud.
Phase de suppression : reproduite à l'identique par TTL ... DELETE. ttl_only_drop_parts = 1 élimine des partitions entières (la limite de partition est d'une journée), ce qui est bien plus efficace qu'une suppression ligne par ligne.
La table logs_summary_1min (créée à l'étape 2c) est une AggregatingMergeTree qui stocke des états d'agrégation partiels. Interrogez-la avec les combinateurs -Merge :
SELECT minute, ServiceName, SeverityText, countMerge(count) AS total_events, avgMerge(avg_run_time) AS avg_run_time_ms, quantileMerge(0.99)(p99_run_time) AS p99_run_time_ms, uniqMerge(uniq_remote_addr) AS unique_ipsFROM logs_summary_1minWHERE minute >= now() - INTERVAL 1 HOURGROUP BY minute, ServiceName, SeverityTextORDER BY minute DESC;
Point pédagogique : motif de combinateurs State / Merge
La table de synthèse stocke des états d'agrégation partiels, et non les valeurs finales. countState() stocke un comptage partiel sérialisé ; avgState() stocke la somme et le nombre nécessaires au calcul d'une moyenne. Lorsque vous exécutez une requête avec countMerge(), ClickHouse combine les états partiels et calcule la valeur finale.
C'est la différence essentielle avec les transformations Elasticsearch : celles-ci réagrègent périodiquement les données brutes. AggregatingMergeTree de ClickHouse accumule les nouvelles données de manière incrémentale, sans jamais relire les enregistrements historiques ; cette approche est fondamentalement plus efficace à grande échelle.
HyperDX comporte une vue Alerts intégrée (dans la barre latérale gauche, entre Chart Explorer et Client Sessions). Les alertes s'associent à des recherches enregistrées ou à des vignettes de graphique : vous définissez une requête, un seuil, une fenêtre d'évaluation et un canal de notification. Comme les sources de données configurées à l'étape 5 pointent déjà vers la base de données otel, aucun raccordement supplémentaire n'est nécessaire.
Pour suivre précisément le parcours dans l'interface, consultez la documentation officielle :ClickStack Alerts — clickhouse.com/docs. Utilisez le tableau ci-dessous pour les deux alertes requises dans cet atelier ; la documentation vous guide dans le parcours Save Search → Create Alert → Configure threshold → Notify pour chacune d'elles.
N°
Nom de l'alerte
Source HyperDX
Critères de recherche (à coller dans la barre de recherche avant l'enregistrement)
Condition de l'alerte
Fenêtre
Règle Kibana remplacée
1
web-5xx-errors
log
RequestType:* AND StatusCode:>=500
count() > 0 (absolu) — se déclenche pour toute réponse 5xx dans la fenêtre. Pour utiliser plutôt un seuil de taux, construisez un graphique dont l'axe Y est countIf(StatusCode >= 500) / count(), puis déclenchez l'alerte lorsque value > 0.05.
5 minutes, évaluation toutes les minutes
« Taux de réponses 5xx > 5 % sur 5 minutes »
2
heartbeat-<service>
log
ServiceName:"<service-name>" (une recherche enregistrée par service à surveiller, par exemple payment-service, order-service)
count() == 0 — se déclenche lorsque la recherche enregistrée ne renvoie aucune ligne pendant la fenêtre
3 minutes, évaluation toutes les minutes
« Service silencieux depuis au moins 3 minutes »
Attention pour l'alerte n° 2 : les alertes de recherche enregistrée d'HyperDX évaluent une seule requête ; la détection du silence par service nécessite donc une recherche enregistrée et une alerte par service. Au-delà d'environ 5 services, l'option B ci-dessous (motif SQL NOT IN dans une seule MV) est plus adaptée.
La table alert_error_rate et alert_error_rate_mv (créées à l'étape 2c) précalculent le taux de réponses 5xx lors de l'insertion. Un outil externe interroge la petite table préagrégée au lieu d'analyser des millions de lignes brutes :
-- Poll this every 1 minute (via cron or any scheduler)SELECT minute, error_rateFROM alert_error_rateWHERE minute >= now() - INTERVAL 5 MINUTE AND error_rate > 0.05ORDER BY minute DESC;
Si cette requête renvoie au moins une ligne, l'alerte se déclenche.
Point pédagogique : le système d'alerte d'Elasticsearch réagrège les données brutes à chaque intervalle de contrôle. L'approche fondée sur une MV déplace l'agrégation coûteuse au moment de l'insertion : la requête de contrôle de l'alerte analyse une table minuscule d'environ 1 ligne par minute, et non des millions de lignes de journaux brutes.
Ouvrez exercises/sql-exercises.md et réalisez les 6 exercices. Ils illustrent des possibilités du SQL ClickHouse qui n'ont pas d'équivalent dans Elasticsearch.
Exercice
Concept
Limite d'ES
1
JOIN entre signaux (journaux + traces)
Aucune JOIN dans le DSL ES
2
Fonction de fenêtre LAG() (détection d'anomalies)
Aucune fonction de fenêtre dans ES
3
GROUP BY sans limite (inventaire complet des points de terminaison)
L'atelier fournit un fichier configs/otel-collector-config.cutover.yaml dédié, qui retire les trois exportateurs ES et conserve ClickHouse comme unique destination. Recréez le conteneur otelcol-lab en montant ce fichier à la place de celui de l'exécution parallèle ; aucune modification sur place n'est nécessaire :
Tous les contrôles ClickHouse doivent encore réussir. Les contrôles de décompte ES échoueront (c'est attendu, car ES ne reçoit plus de données) : confirmez donc que les décomptes ClickHouse continuent d'augmenter.
Les données ES expireront naturellement selon leur politique ILM. Vous pouvez également supprimer immédiatement les volumes si aucune conservation n'est nécessaire.
Après l'arrêt d'elastic-apm-server à l'étape 10d, l'exportateur APM du collecteur OTel Demo commence à consigner des erreurs de file d'attente pleine et applique une contre-pression à l'ensemble du pipeline, y compris à l'exportateur ClickHouse qui opère à ses côtés. Passez à une configuration de bascule sans exportateur APM :
Cette commande monte configs/otelcol-demo-config.cutover.yml (ClickHouse uniquement) et recrée le conteneur. Le fichier de référence de la partie 1 reste intact : un nouveau cleanup.sh && start from Part 1 aboutit donc toujours à un état initial propre où seul APM est utilisé.
Vérifiez que les métriques arrivent dans ClickHouse :
SELECT table, count() AS rowsFROM system.partsWHERE database = 'otel' AND table LIKE 'otel_metrics%' AND activeGROUP BY table ORDER BY table;
Résultat attendu : otel_metrics_gauge, otel_metrics_sum et otel_metrics_histogram contiennent tous des lignes.
Vérifiez que CH_HOST est défini et accessible : nc -zv ${CH_HOST} 9440
Vérifiez create_schema: false : si l'exportateur essaie de créer son schéma par défaut, il peut entrer en conflit avec le nôtre
Vérifiez que la configuration du collecteur contient database: otel et que la base de données otel existe réellement : SHOW DATABASES
Vérifiez que la table otel_logs existe dans la base de données otel : SHOW TABLES FROM otel LIKE 'otel_logs'
L'OTel Collector s'arrête avec schema detection: ... i/o timeout (démarrage à froid de CH Cloud) :
Cela signifie que la sonde de détection du schéma exécutée au démarrage vers ClickHouse Cloud a dépassé le délai dial_timeout. Le cas se présente surtout avec les services CH de niveau Basic restés inactifs.
Redémarrez le conteneur, car CH est désormais chaud : docker start otelcol-lab && sleep 10 && docker logs otelcol-lab --tail=15
La commande docker run de l'étape 3b inclut --restart unless-stopped, ce qui permet une récupération automatique. Si vous l'avez lancée sans cette option, recréez le conteneur.
Vérifiez que le dictionnaire est chargé : SELECT status FROM system.dictionaries WHERE database = 'otel' AND name = 'geoip_country'
S'il indique NOT_LOADED ou FAILED, vérifiez que geoip_data contient des lignes : SELECT count() FROM otel.geoip_data
Exécutez SYSTEM RELOAD DICTIONARY otel.geoip_country et SYSTEM RELOAD DICTIONARY otel.geoip_city après le chargement du CSV : les dictionnaires sont créés avant le chargement de ce fichier, ils sont donc initialement vides et nécessitent un rechargement explicite (l'étape 2b le fait pour vous)
Le nombre de lignes dans CH est bien inférieur à celui d'ES :
Vérifiez que le conteneur OTel Collector est actif : docker ps | grep otelcol
Consultez les journaux du collecteur pour rechercher des erreurs : docker logs otelcol-lab --tail=30
Vérifiez les métriques du collecteur : curl http://localhost:8888/metrics | grep otelcol_exporter
Recherchez les erreurs d'insertion dans ses journaux (failed to send)
logs_summary_1min est vide :
La MV se déclenche lors des insertions dans otel.otel_logs (la table Null), et non dans otel.otel_logs_v2
Vérifiez que des données transitent par otel.otel_logs : dans un nouveau terminal, exécutez clickhouse client --database otel --query "SELECT count() FROM otel_logs_v2" toutes les 30 secondes et confirmez que le nombre augmente
La recherche HyperDX ne renvoie aucune donnée :
Vérifiez que chacune des sources de données HyperDX a pour Database la valeur otel et pointe vers la bonne table (otel_logs_v2 pour les journaux, otel_traces pour les traces et les cinq tables otel_metrics_* pour OTEL Metrics)
Pour la source Log, la Timestamp Column doit être TimestampTime (et non Timestamp) ; consultez hyperdx-guide.md pour comprendre pourquoi
Vérifiez le sélecteur de période ; essayez « Last 24 hours »
Vérifiez que otel_logs_v2 contient des lignes : clickhouse client --database otel --query "SELECT count() FROM otel_logs_v2"