Aprovisiona ClickHouse Cloud, escribe en ambos destinos mediante OpenTelemetry, valida la paridad, explora ClickStack y realiza la transición.
Ejecuta este módulo desde el directorio de artefactos del taller:
cd "$(git rev-parse --show-toplevel)/workshops/elasticsearch_migration_lab/part3"
Objetivo: Ejecuta el plan elaborado en la Parte 2. Despliega un OTel Collector, crea tablas de ClickHouse optimizadas, configura el enriquecimiento con diccionarios, valida la paridad con Elasticsearch y realiza la transición.
Tiempo estimado: 120–180 minutos
Requisitos previos: Partes 1 y 2 completadas; el entorno Docker de la Parte 1 está en ejecución (Elasticsearch, Kibana, generadores de logs y APM Server). Tienes las credenciales de ClickHouse Cloud.
Archivos:
part3/├── exercises/│ ├── setup-checklist.md ← Fill in as you work through each step│ └── sql-exercises.md ← 6 SQL exercises (attempt before checking solutions)├── clickhouse/│ ├── schema.sql ← All DDL (run first)│ ├── dictionaries.sql ← GeoIP dictionary DDL│ ├── geoip-sample-data.csv ← ~400 CIDR rows (no MaxMind account needed)│ ├── alert-tables.sql ← Alert pre-computation + summary MVs│ └── validation-queries.sql ← Spot-checks and parity queries├── configs/│ ├── otel-collector-config.parallel.yaml ← File-based log collector — parallel run (CH + ES dual-write)│ ├── otel-collector-config.cutover.yaml ← File-based log collector — cutover (CH only)│ ├── otelcol-demo-config.parallel.yml ← OTel Demo collector — parallel run (APM + CH)│ └── otelcol-demo-config.cutover.yml ← OTel Demo collector — cutover (CH only)├── docker/│ ├── docker-compose.otel-demo.parallel.yml ← Compose override for parallel-run swap│ └── docker-compose.otel-demo.cutover.yml ← Compose override for cutover swap├── diagrams/│ ├── step3-architecture.mmd ← Mermaid source — post-Step-3 architecture│ ├── step3-architecture.png ← Rendered PNG embedded in Step 3│ └── render.sh ← Re-render *.mmd → *.png via Docker (mermaid-cli)├── images/│ └── *.png ← Screenshots referenced by hyperdx-guide.md└── scripts/ ├── swap-otelcol-demo-config.sh ← Swap otelcol-demo config (parallel|cutover) ├── validate_migration.sh ← Automated parity check └── validate_enrichment.sh ← Enrichment column verification
Arquitectura de ClickHouse Cloud: A diferencia de Elasticsearch, ClickHouse Cloud almacena todos los datos en almacenamiento de objetos (S3/GCS) con caché local automática. No existen capas de nodos hot/warm/cold: el motor obtiene y guarda en caché los datos de forma transparente. Toda la maquinaria ILM hot→warm→cold de ES carece de equivalente. Solo necesitas eliminación por TTL, que configurarás en el Paso 2.
Define las variables de entorno para el resto del laboratorio:
# Copy and fill in once, then source before every sessioncp ../common/env.sh.example ../common/env.sh# edit ../common/env.sh with your CH_HOST and CH_PASSWORD (from Cloud console → Connect → Native protocol)source ../common/env.sh
Base de datos: Todos los objetos de la Parte 3 viven en una base dedicada otel, creada automáticamente por dictionaries.sql y schema.sql mediante CREATE DATABASE IF NOT EXISTS otel. Así quedan aislados. Todas las configuraciones del collector, scripts y fuentes de HyperDX ya apuntan a otel.
Orden de ejecución: Los diccionarios GeoIP (Paso 2a) deben crearse antes que las tablas (Paso 2b), porque otel_logs_v2 tiene columnas MATERIALIZED que hacen referencia a otel.geoip_country y otel.geoip_city. ClickHouse valida estas referencias al ejecutar CREATE TABLE.
# 1. Create the otel database, geoip_data source table, and empty dictionaries# (the table must exist before you can INSERT into it)clickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ < clickhouse/dictionaries.sql# 2. Load sample data into the source table (note: --database otel)clickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --database otel \ --query "INSERT INTO geoip_data FORMAT CSVWithNames" \ < clickhouse/geoip-sample-data.csv# 3. Reload dictionaries — they were created with an empty table; force reload nowclickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --query "SYSTEM RELOAD DICTIONARY otel.geoip_country"clickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --query "SYSTEM RELOAD DICTIONARY otel.geoip_city"# 4. Verifyclickhouse client \ --host ${CH_HOST} --port 9440 \ --user default --password ${CH_PASSWORD} --secure \ --query "SELECT dictGet('otel.geoip_country', 'country', toIPv4('8.8.8.8'))"# Expected: United States
Punto didáctico: En Elasticsearch, el procesador geoip es una caja negra integrada. En ClickHouse utilizas un diccionario basado en los mismos datos MaxMind y controlas el origen, el intervalo de actualización y la búsqueda. El diseño IP_TRIE está optimizado para rangos CIDR: dictGet() realiza una coincidencia por el prefijo más largo en microsegundos.
Destino de ingesta del OTel Collector; no almacena nada
otel_logs_v2
MergeTree
Almacena realmente los datos, con columnas enriquecidas
otel_logs_mv
Vista materializada
Dirige otel_logs → otel_logs_v2 con transformaciones
otel_traces
MergeTree
Spans de trazas OTel
otel_metrics_gauge
MergeTree
Métricas gauge de OTel (sustituye APM Server como backend de métricas)
otel_metrics_sum
MergeTree
Métricas de suma/contador de OTel
otel_metrics_histogram
MergeTree
Métricas de histograma de OTel
otel_metrics_exponentialhistogram
MergeTree
Métricas de histograma exponencial de OTel
otel_metrics_summary
MergeTree
Métricas de resumen de OTel
¿Por qué el patrón Null → MV → destino?
El motor Null acepta inserciones y descarta los datos inmediatamente. La MV adjunta se dispara en cada inserción y escribe filas transformadas en otel_logs_v2. Así no se almacenan dos veces: el collector escribe el esquema OTel bruto en otel_logs y solo las filas enriquecidas y optimizadas llegan a otel_logs_v2.
Las columnas materializadas sustituyen todos los procesadores de ingesta de ES:
Procesador ES
Equivalente de ClickHouse
geoip
GeoCountry, GeoCity MATERIALIZED mediante dictGetOrDefault('otel.geoip_country', ...)
user_agent
BrowserFamily, OSFamily, IsBot MATERIALIZED mediante regexpExtract / position
script (derivación de severidad)
DerivedSeverity MATERIALIZED mediante multiIf(StatusCode >= 500, 'critical', ...)
grok/dissect (extracción de campos)
RequestType, RequestPath, RequestPage, HostName MATERIALIZED desde LogAttributes['key']
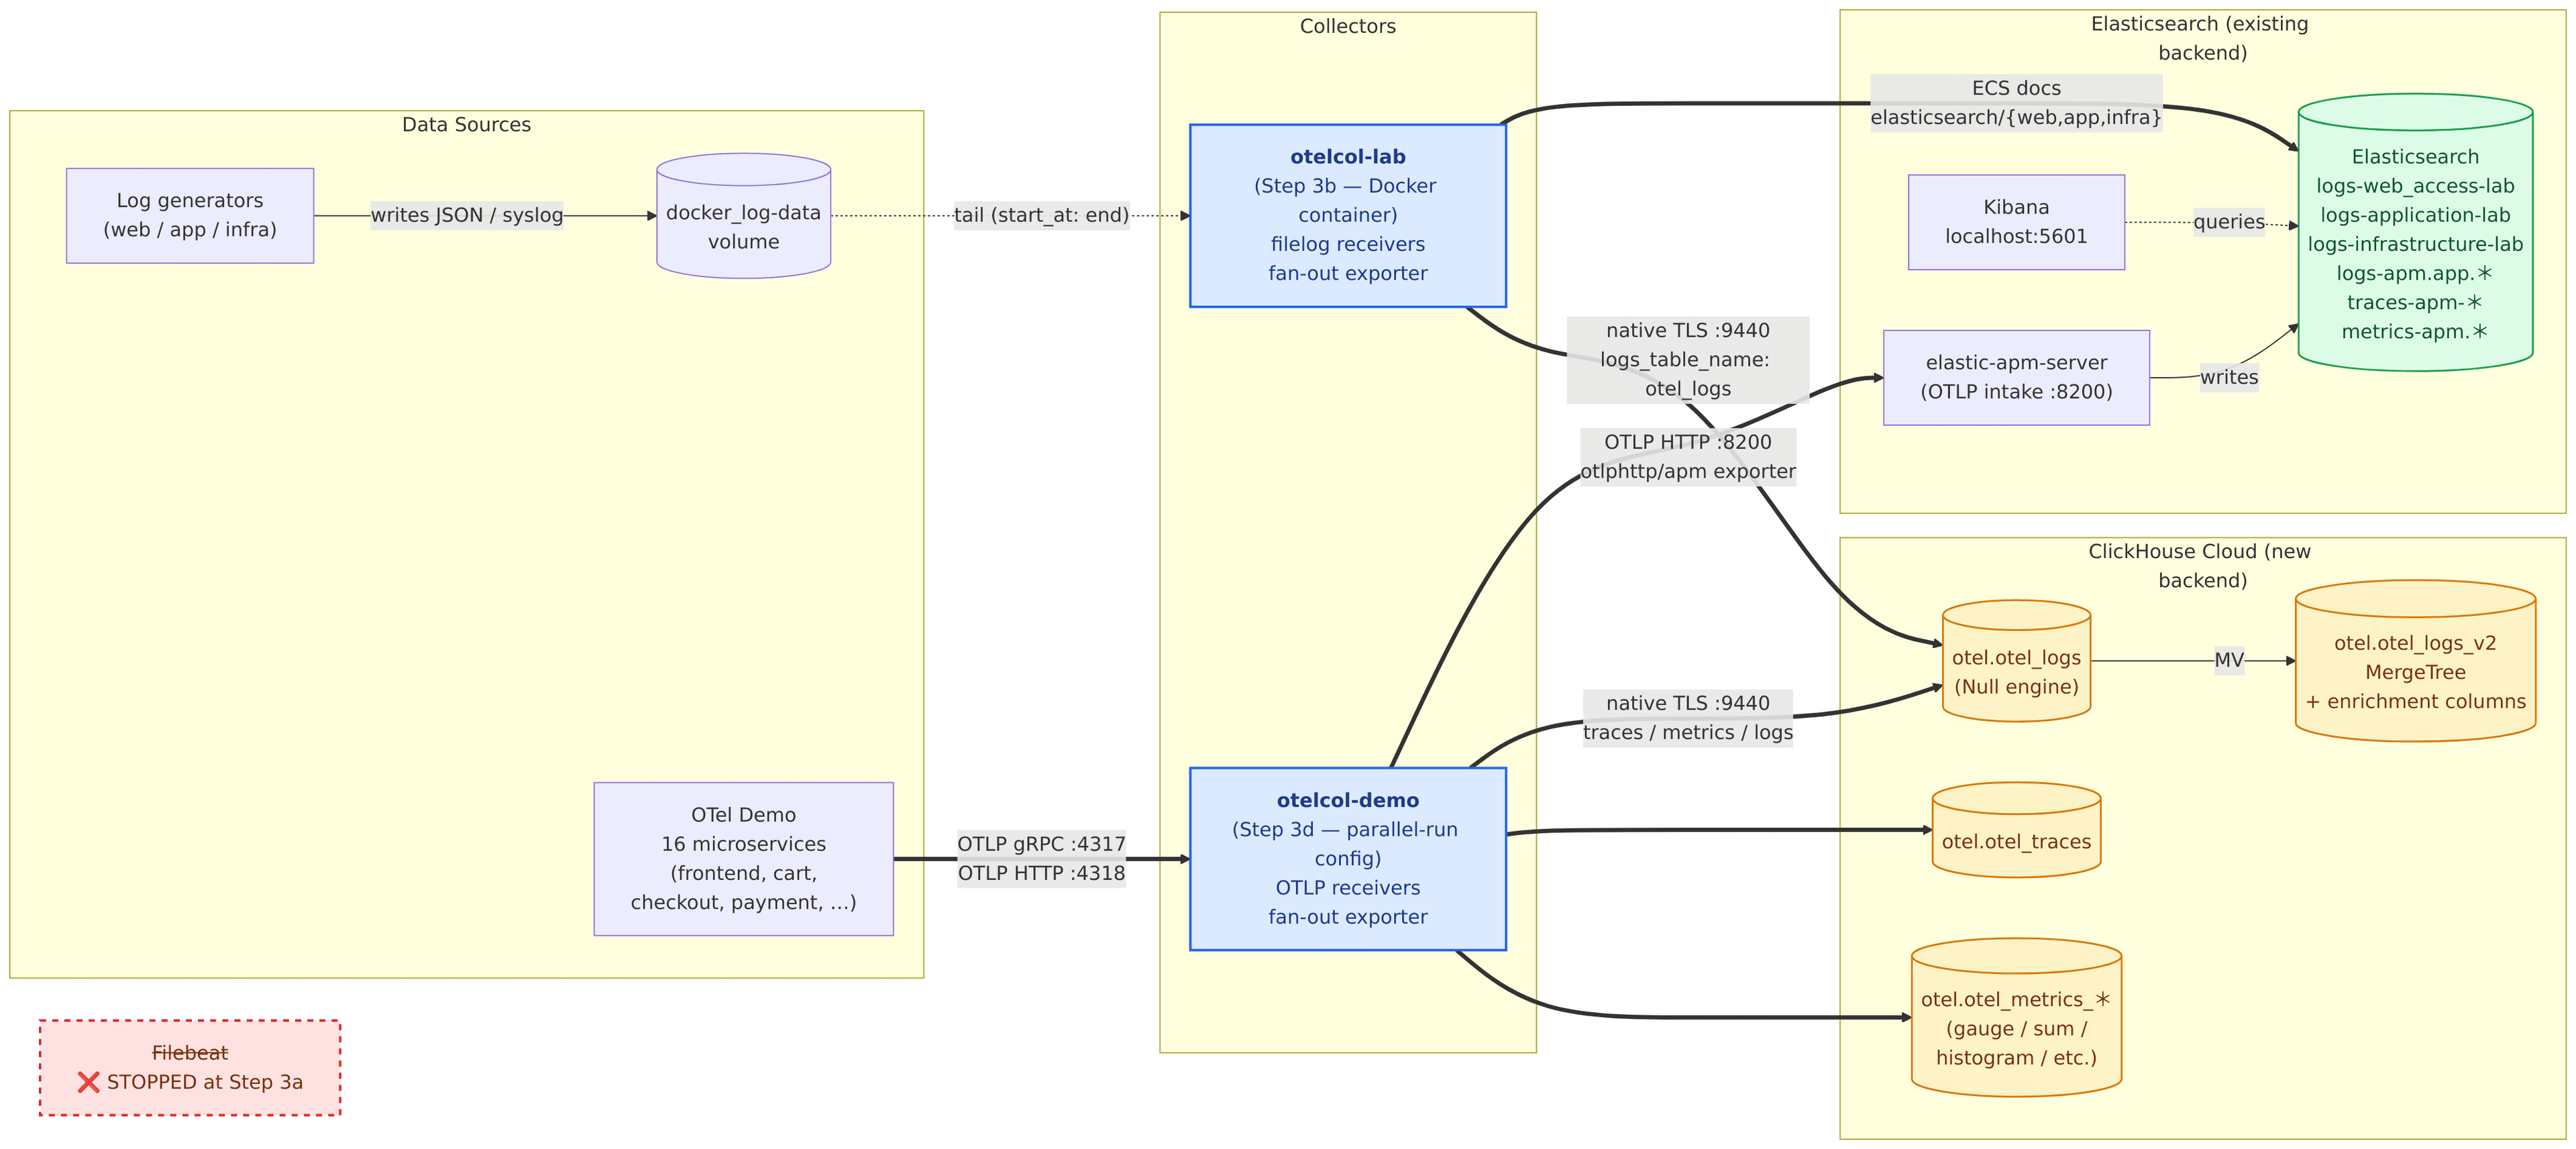
Al finalizar, habrás pasado de la referencia de la Parte 1 (Filebeat → ES, otelcol-demo → solo APM) a una ejecución paralela en la que dos OTel Collectors distribuyen cada señal al Elasticsearch existente y a ClickHouse Cloud:
Cambios de este paso:
3a: detener Filebeat (en rojo, abajo a la izquierda).
3b–3c: iniciar otelcol-lab (collector basado en archivos): sigue los mismos logs y escribe tanto en ES (logs-{web_access,application,infrastructure}-lab) como en ClickHouse (otel.otel_logs → MV → otel.otel_logs_v2).
3d: cambiar otelcol-demo a la configuración paralela para que el tráfico OTLP de los 16 servicios también se distribuya a APM Server y ClickHouse.
Fuente del diagrama: diagrams/step3-architecture.mmd. Para volver a renderizarlo, ejecuta bash diagrams/render.sh (usa minlag/mermaid-cli mediante Docker; no requiere Node/npm).
El OTel Collector seguirá los mismos archivos y escribirá en los mismos flujos ES (logs-web_access-lab, logs-application-lab, logs-infrastructure-lab), además de ClickHouse. Si ambos se ejecutan, cada línea se indexa dos veces en ES.
Detén Filebeat para que el collector sea el único productor:
Elasticsearch, Kibana, los generadores y APM Server siguen activos. Solo se detiene Filebeat. OTel Collector toma el control de ambos backends y conserva comparaciones significativas. En la transición (Paso 10a) se eliminan los exportadores ES.
Los logs están en el volumen Docker docker_log-data. En macOS y donde estén dentro de volúmenes, ejecuta el collector como contenedor para acceder directamente:
info Everything is ready. Begin running and processing data.info Started watching file path=/var/log/generators/web-access-api-gateway.log
Decisiones clave de configs/otel-collector-config.parallel.yaml (collector de logs basado en archivos, variante paralela):
Distribución de escritura doble: cada pipeline enumera [clickhouse, elasticsearch/<stream>] para enviar cada línea a ambos backends. El Paso 10a elimina ES.
Un exportador ES por flujo (elasticsearch/web → logs-web_access-lab, elasticsearch/app → logs-application-lab, elasticsearch/infra → logs-infrastructure-lab) para mantener los destinos de Filebeat.
mapping.mode: ecs en los exportadores ES: convierte registros OTel (Body, Attributes, ...) en documentos ECS compatibles con las plantillas.
create_schema: false en el exportador CH: ya creamos tablas optimizadas.
logs_table_name: otel_logs: escribe en la tabla Null, que activa la MV hacia otel_logs_v2.
compress=lz4 en el endpoint CH: compresión LZ4 por la red.
Nota: Este collector solo procesa logs de archivos. Los 16 servicios OTel Demo envían OTLP a un segundo collector (otelcol-demo), aprovisionado en la Parte 1 y que ahora solo reenvía a APM Server. El Paso 3d cambia su configuración sin modificar el archivo de referencia.
source ../common/env.sh # CH_HOST, CH_PASSWORD must be setbash scripts/swap-otelcol-demo-config.sh parallel
Esto recrea el contenedor mediante docker compose -f ... -f docker/docker-compose.otel-demo.parallel.yml up -d --force-recreate --no-deps otelcol-demo. El archivo de la Parte 1 no se modifica; el override monta una configuración distinta y sustituye command:.
Verifica que se inició correctamente:
docker logs "$(docker ps -qf name=otelcol-demo)" --tail=10# Expected: "Everything is ready. Begin running and processing data."# No "Failed to start component" or "connection refused" errors.
¿Por qué cambiar en lugar de editar la Parte 1? Editar part1/docker/configs/otelcol-demo-config.yml alteraría la referencia y haría que un futuro cleanup.sh && start from Part 1 necesitase ya CH_HOST/CH_PASSWORD. El cambio mantiene la Parte 1 independiente y reproducible.
HyperDX es la interfaz de observabilidad integrada en ClickStack. Iníciala, conéctala a otel y confirma que logs, trazas y métricas pueden consultarse.
Abrir HyperDX desde la barra lateral del console de Cloud
B. Crear tres fuentes
Conectar otel.otel_traces, otel.otel_logs_v2 y las cinco tablas otel.otel_metrics_*
C. Buscar logs en tiempo real
Confirmar el flujo y usar facetas y búsqueda de texto completo
D. Crear un gráfico con AI Assistant
Traducir lenguaje natural ("Error count by services for past 2 hours") en un gráfico
Punto didáctico: Service Map, la búsqueda y AI Assistant consultan directamente las tablas MergeTree otel.*: sin índice aparte, rollups ni redistribución de shards. Los casos de uso de Kibana están disponibles y también pueden escribirse ad hoc en SQL (Paso 9), algo que Kibana no ofrecía.
SELECT name, extractAll(create_table_query, 'TTL[^\\n]+') AS ttl_clausesFROM system.tablesWHERE database = 'otel' AND name IN ('otel_logs_v2', 'otel_traces', 'otel_metrics_gauge', 'otel_metrics_sum', 'otel_metrics_histogram', 'otel_metrics_exponentialhistogram', 'otel_metrics_summary');
Comprueba tamaño y edad de particiones:
SELECT partition, sum(rows) AS total_rows, formatReadableSize(sum(bytes_on_disk)) AS disk_size, min(min_time) AS oldest_data, max(max_time) AS newest_dataFROM system.partsWHERE database = 'otel' AND table = 'otel_logs_v2' AND activeGROUP BY partitionORDER BY partition;
Punto didáctico: por qué ILM se convierte en una línea de DDL
En la Parte 1 configuraste tres fases: rollover a 5GB/1d (hot), shrink + forcemerge a los 2d (warm) y delete a los 30d. Exigía roles de nodos, conocimiento de shards y JSON de políticas.
En ClickHouse Cloud todo se reduce a una cláusula:
TTL TimestampDate + INTERVAL 30 DAY DELETESETTINGS ttl_only_drop_parts = 1
Rollover: innecesario. ClickHouse usa una tabla con particiones por fecha.
Fase warm (shrink + forcemerge): innecesaria. MergeTree combina partes automáticamente.
Capas hot/warm/cold: innecesarias. Los datos están en almacenamiento de objetos con caché automática.
Fase delete:TTL ... DELETE la reproduce. ttl_only_drop_parts = 1 elimina particiones enteras, mucho más eficientemente.
logs_summary_1min, creada en el Paso 2c, es un AggregatingMergeTree que guarda estados parciales. Consúltala con combinadores -Merge:
SELECT minute, ServiceName, SeverityText, countMerge(count) AS total_events, avgMerge(avg_run_time) AS avg_run_time_ms, quantileMerge(0.99)(p99_run_time) AS p99_run_time_ms, uniqMerge(uniq_remote_addr) AS unique_ipsFROM logs_summary_1minWHERE minute >= now() - INTERVAL 1 HOURGROUP BY minute, ServiceName, SeverityTextORDER BY minute DESC;
Punto didáctico: patrón de combinadores State / Merge
La tabla guarda estados parciales, no valores finales. countState() guarda un recuento parcial serializado; avgState() guarda suma + recuento. countMerge() combina estados y calcula el valor final.
A diferencia de las transformaciones de ES, que vuelven a agregar datos brutos periódicamente, AggregatingMergeTree acumula datos nuevos sin releer registros históricos, lo que escala mejor.
HyperDX tiene una vista Alerts integrada (barra lateral, entre Chart Explorer y Client Sessions). Las alertas se asocian a búsquedas guardadas o gráficos: defines consulta, umbral, ventana y canal. Las fuentes del Paso 5 ya apuntan a otel.
Flujo exacto: consulta ClickStack Alerts — clickhouse.com/docs. La tabla siguiente contiene los valores del laboratorio; la documentación guía por Save Search → Create Alert → Configure threshold → Notify.
#
Nombre
Fuente HyperDX
Criterio de búsqueda
Condición
Ventana
Regla de Kibana sustituida
1
web-5xx-errors
log
RequestType:* AND StatusCode:>=500
count() > 0 (absoluto). Para una tasa, crea un gráfico con countIf(StatusCode >= 500) / count() y alerta si value > 0.05.
5 minutos, cada 1 minuto
"5xx rate > 5% over 5 minutes"
2
heartbeat-<service>
log
ServiceName:"<service-name>" (una búsqueda por servicio, por ejemplo payment-service, order-service)
count() == 0
3 minutos, cada 1 minuto
"Service went silent for 3+ minutes"
Aviso sobre la alerta nº 2: Las alertas de búsquedas guardadas evalúan una consulta; detectar silencio por servicio exige una búsqueda y alerta por servicio. Para más de ~5 servicios, la Opción B (patrón SQL NOT IN en una MV) es más adecuada.
alert_error_rate y alert_error_rate_mv (Paso 2c) precalculan la tasa de 5xx al insertar. Un proceso externo consulta una tabla diminuta:
-- Poll this every 1 minute (via cron or any scheduler)SELECT minute, error_rateFROM alert_error_rateWHERE minute >= now() - INTERVAL 5 MINUTE AND error_rate > 0.05ORDER BY minute DESC;
Si devuelve filas, se dispara la alerta.
Punto didáctico: Las alertas de Elasticsearch vuelven a agregar datos brutos en cada intervalo. La MV desplaza el coste a la inserción y la consulta lee ~1 fila/minuto, no millones de logs.
Tras detener elastic-apm-server, su exportador empieza a llenar la cola y ejerce contrapresión sobre todo el pipeline, incluido ClickHouse. Cambia a una configuración sin APM:
Esto monta configs/otelcol-demo-config.cutover.yml y recrea el contenedor. La referencia de la Parte 1 queda intacta, por lo que cleanup.sh && start from Part 1 siempre vuelve a un estado APM limpio.
Verifica que las métricas fluyen:
SELECT table, count() AS rowsFROM system.partsWHERE database = 'otel' AND table LIKE 'otel_metrics%' AND activeGROUP BY table ORDER BY table;
Resultado esperado: otel_metrics_gauge, otel_metrics_sum y otel_metrics_histogram muestran filas.
Comprueba el diccionario: SELECT status FROM system.dictionaries WHERE database = 'otel' AND name = 'geoip_country'
Si está NOT_LOADED o FAILED, comprueba que geoip_data contiene datos: SELECT count() FROM otel.geoip_data
Ejecuta SYSTEM RELOAD DICTIONARY otel.geoip_country y SYSTEM RELOAD DICTIONARY otel.geoip_city tras cargar el CSV; los diccionarios se crean vacíos y necesitan recarga explícita (el Paso 2b lo hace)
Los recuentos de CH son mucho menores que los de ES: